


Seguimiento del ciclo de vida de las transacciones, la gestión de fallos y los mecanismos de recuperación en las redes Rayls.
Una transferencia entre cadenas puede parecer engañosamente sencilla.
Eliges un token, introduces una dirección de destino, confirmas la transacción y esperas a que lleguen los fondos.
Pero ¿qué ocurre después de hacer clic en «Confirmar»?
El libro mayor de origen debe procesar la transacción. Los servicios de soporte deben preparar y transmitir el mensaje. El destino debe verificar y ejecutar la operación correspondiente. Si algo falla durante el proceso, el sistema necesita una respuesta definida.
Eso plantea una pregunta que quise investigar en la documentación de Rayls:
Si una transferencia entre cadenas falla después de que la transacción de origen se haya realizado correctamente, ¿qué ocurre realmente con los tokens?
La respuesta es más interesante que un simple estado de éxito o fallo. Rayls documenta comportamientos distintos para la teleportación estándar, la teleportación atómica y las transferencias entre un libro mayor Rayls Sovereign y la Rayls Public Chain.
Entender esas diferencias también revela un principio importante de la ingeniería entre cadenas: una transacción puede completarse correctamente en una etapa sin que la transferencia en su conjunto haya finalizado.
1. Una transferencia entre cadenas es una secuencia, no una sola transacción
Empecemos con una transferencia estándar entre dos instituciones dentro de una Rayls Private Network.
A grandes rasgos, la ruta es la siguiente:
Libro mayor Sovereign emisor → Relayer → Private Network Hub → Relayer receptor → Libro mayor Sovereign de destino
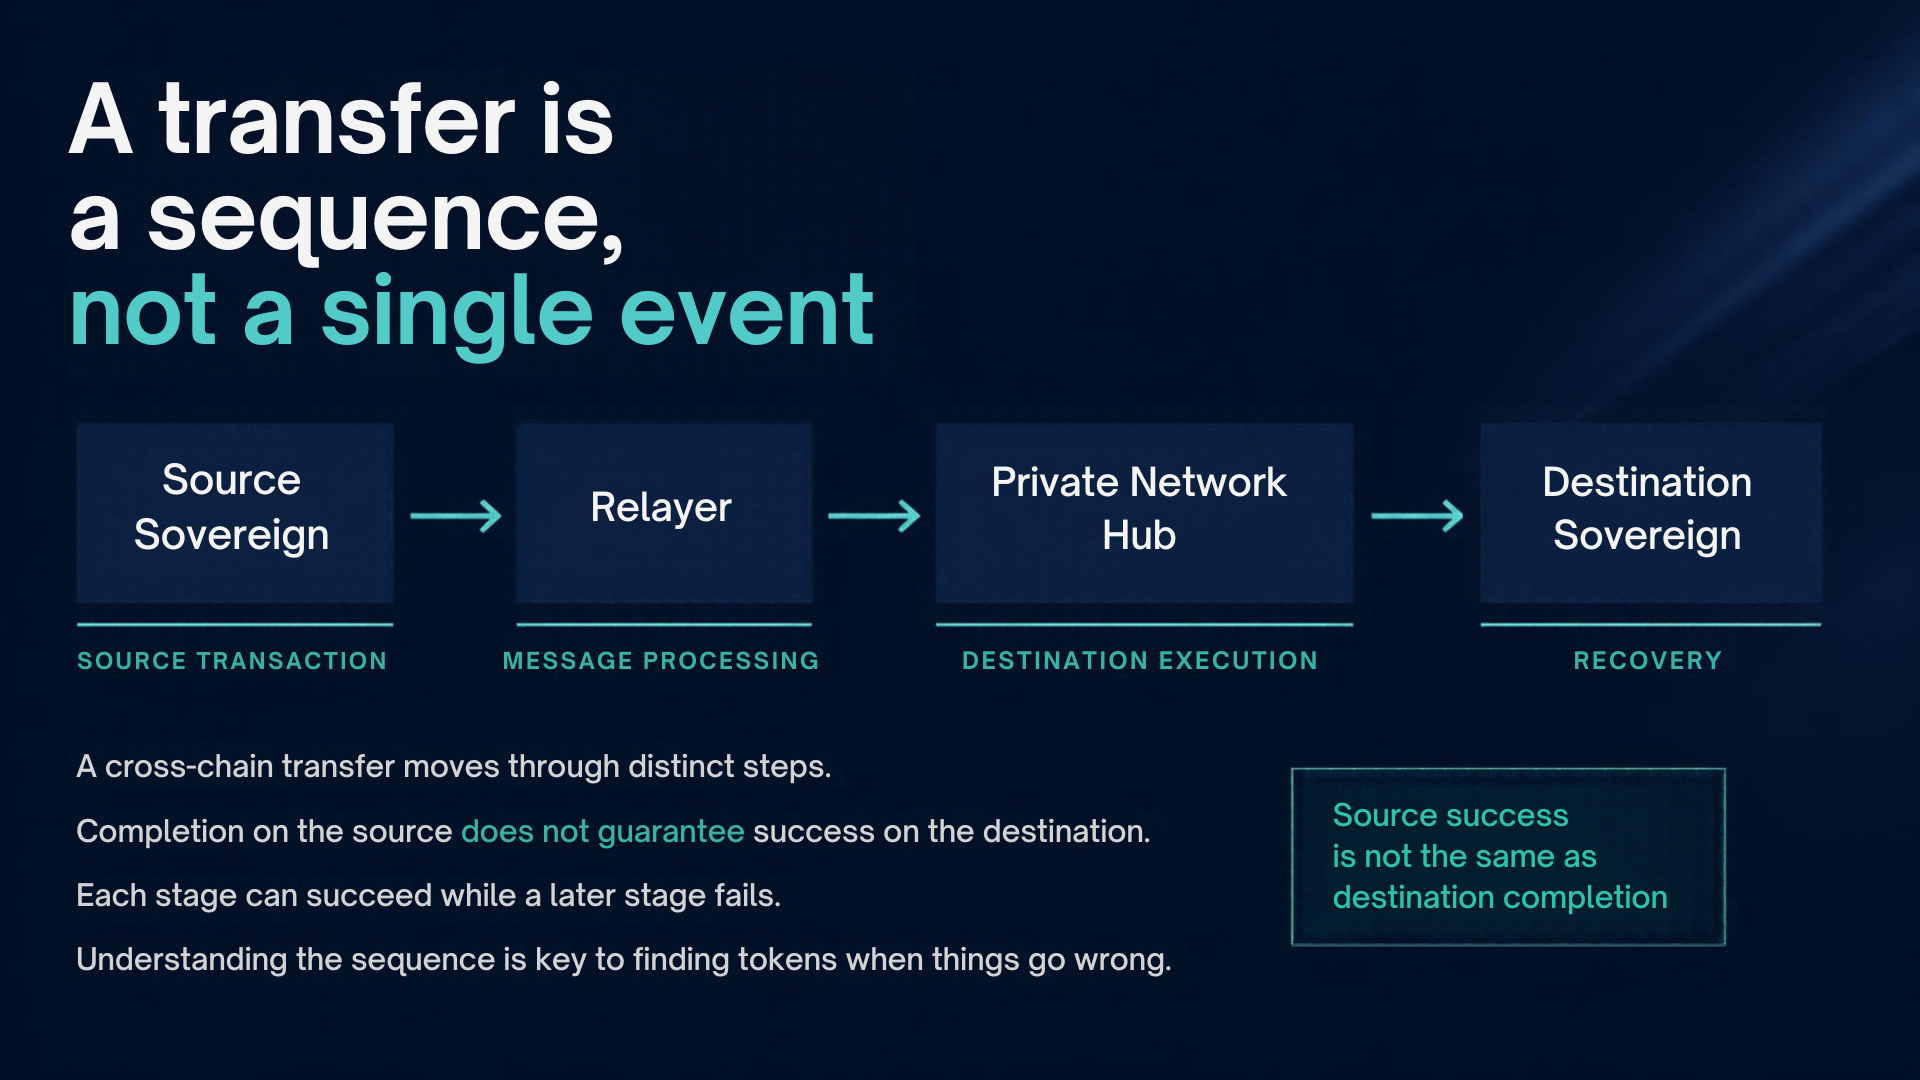
Cada componente tiene una responsabilidad específica.
El libro mayor emisor procesa la transferencia y quema los tokens de origen. Su endpoint emite un evento MessageDispatched.
El Relayer del remitente detecta ese evento, prepara una prueba de Merkle y cifra el mensaje para la institución de destino. A continuación, el mensaje se envía al Private Network Hub, que valida la prueba y almacena el mensaje.
En el lado receptor, el Relayer de destino detecta el mensaje, descifra la carga útil y envía la operación correspondiente al libro mayor de destino. El endpoint de destino comprueba que el mensaje no se haya ejecutado ya, y el gestor de tokens acuña los tokens para el destinatario.
No se trata simplemente de que un token pase de un saldo a otro. Es un proceso coordinado que implica la ejecución en origen, la preparación del mensaje, su verificación y entrega, y la ejecución en destino.
La quema en origen y la acuñación en destino son especialmente importantes. Ayudan a evitar que el mismo activo siga siendo gastable de forma independiente en ambos lados de la transferencia.
Pero también plantean una pregunta sobre la recuperación: ¿qué ocurre si la quema en origen se realiza correctamente y la operación en destino no?
Referencia técnica oficial:
2. ¿Cuánto tarda realmente una transferencia normal?
Un detalle de la documentación oficial me llamó la atención: el tiempo de extremo a extremo indicado para una teleportación estándar de Private Network es de aproximadamente 30–60 segundos.
Esto recuerda que la velocidad de una transacción individual de blockchain no determina el tiempo que tarda en completarse toda la operación entre cadenas.
El proceso documentado incluye varias etapas:
Envío de la transacción de origen y ejecución local.
Detección del evento por parte del Relayer.
Generación de la prueba de Merkle.
Cifrado del mensaje.
Envío al Private Network Hub.
Detección del evento en destino.
Descifrado y ejecución en destino.
El tiempo de bloque del Hub y los intervalos de sondeo que usan los Relayers contribuyen significativamente a la duración total.
Se necesita trabajo adicional para flujos como Enygma y la liquidación contra entrega (DvP), que pueden requerir la generación de pruebas de conocimiento cero.
Para un desarrollador de aplicaciones, esta distinción cambia la forma en que debe presentarse el estado de la transacción.
Un recibo de la transacción de origen confirma que esta se ejecutó. Por sí solo, no demuestra que el destino haya completado su parte de la transferencia.
Por lo tanto, una interfaz útil debería distinguir entre la confirmación en origen, el procesamiento entre cadenas, la ejecución en destino y la recuperación.
Los tiempos exactos son expectativas documentadas, no una garantía de que todas las transacciones se completen dentro del mismo intervalo.
Fuente:
https://docs.rayls.com/docs/how-a-cross-chain-transaction-works
3. Cuatro puntos de fallo y por qué son diferentes
Para entender la recuperación, dividí el proceso en cuatro escenarios prácticos de fallo.
Escenario A: La transacción de origen se revierte
Si la transacción se revierte en el libro mayor Sovereign emisor, el mensaje entre cadenas no se envía.
La transferencia no ha avanzado al proceso normal de entrega entre cadenas. El remitente puede investigar el motivo de la reversión y volver a intentarlo después de resolver el problema.
Esto es fundamentalmente distinto de una transferencia en la que los tokens de origen ya se han quemado y han entrado en el proceso de mensajería.
Escenario B: Un servicio de soporte falla temporalmente
El Relayer depende de servicios de soporte para preparar y procesar mensajes.
La documentación describe el comportamiento de reintento cuando falla la generación de pruebas de Merkle, cuando la Cryptographic Trust Suite no está disponible y cuando se agota el tiempo de espera de la API de generación de pruebas.
Estos son ejemplos de fallos que pueden gestionarse repitiendo una operación, en lugar de abandonar la transferencia de inmediato.
Un problema temporal del servicio y una transacción permanentemente inválida no son lo mismo.
Escenario C: El Private Network Hub rechaza una prueba
El Private Network Hub valida la prueba que acompaña al mensaje entre cadenas.
Si la validación de la prueba falla, la transacción se rechaza y se registra para su investigación.
La ruta de recuperación documentada para la teleportación atómica permite al Relayer iniciar una transacción de reversión en el libro mayor de origen, devolviendo los tokens al remitente.
Esto ilustra la diferencia entre detectar una operación inválida y recuperar el estado del activo después de que dicha operación no pueda continuar.
Escenario D: Falla la operación en el destino
Una transferencia puede llegar al lado receptor y aun así fallar durante la ejecución en destino.
El comportamiento de recuperación depende del protocolo de transferencia.
Para la teleportación estándar, la documentación indica que un fallo de ejecución en destino se marca como fallido y requiere un reintento manual.
Para la teleportación atómica, un fallo de ejecución en destino activa el flujo de reversión automática documentado, que devuelve los fondos al origen.
Esta distinción es fundamental. Sería inexacto afirmar que todas las transferencias entre cadenas de Rayls se revierten automáticamente después de cualquier fallo.
La garantía de recuperación depende de la ruta que se utilice.
Fuente:
https://docs.rayls.com/docs/how-a-cross-chain-transaction-works
4. Estos dos términos pueden parecer intercambiables, pero representan acciones diferentes.
Reintentar significa volver a intentar una operación. Es útil cuando un fallo temporal puede desaparecer; por ejemplo, cuando un servicio de soporte vuelve a estar disponible o se puede repetir un intento de generación de pruebas.
En los flujos documentados de recuperación entre cadenas, revertir significa iniciar una transacción compensatoria que restaura el estado del activo en el lado de origen.
Veamos un ejemplo simplificado.
Una institución inicia una transferencia de 100 tokens. La transacción de origen se realiza correctamente y los tokens del lado de origen se queman. Sin embargo, el libro mayor receptor no puede completar la operación en destino.
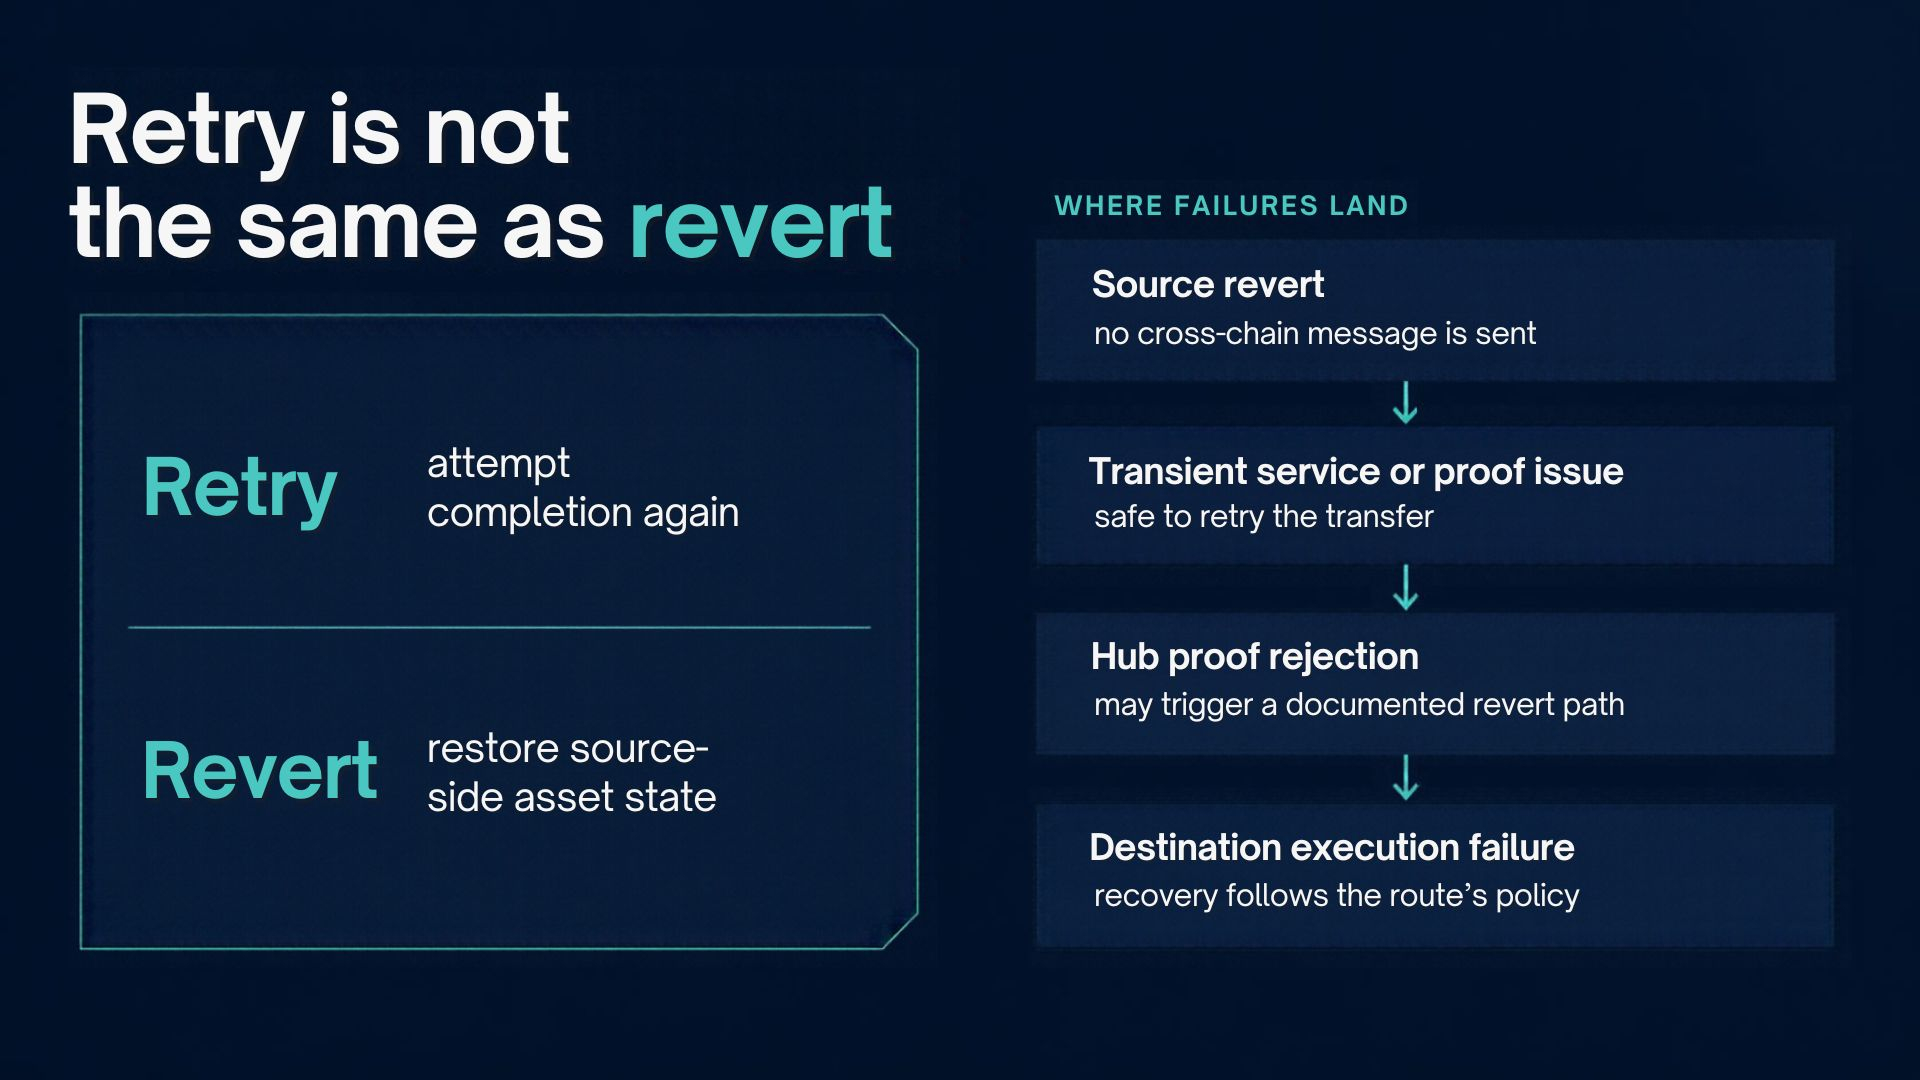
Con la teleportación estándar, la operación fallida en destino se marca como fallida y la documentación especifica que se requiere un reintento manual.
Con la teleportación atómica, el protocolo incorpora coordinación y una ruta de devolución. Si la transacción falla dentro del flujo atómico documentado, los tokens del lado de origen pueden restaurarse mediante el proceso de reversión.
La diferencia clave no es simplemente cómo se informa del fallo, sino qué hace el protocolo con el activo después del fallo.
También hay una salvedad importante: la reversión es, en sí misma, una transacción. El mecanismo de recuperación debe enviarse y procesarse. No debe confundirse una ruta de recuperación automática documentada con la afirmación de que todos los fallos operativos se resuelven de forma instantánea o sin supervisión.
Fuente:
https://docs.rayls.com/docs/sending-teleports
5. Teleportación estándar frente a teleportación atómica
Esta es la distinción más importante de la investigación.
La teleportación estándar y la teleportación atómica comparten la arquitectura general entre cadenas, pero gestionan los fallos de manera distinta.
Teleportación estándar
Los tokens de origen se queman.
Se procesa el mensaje entre cadenas.
El destino intenta ejecutar la transferencia.
Si la ejecución en destino falla, la transacción se marca como fallida y se requiere un reintento manual.
Teleportación atómica
Se incorporan fases adicionales de coordinación y bloqueo/desbloqueo.
El lado receptor sigue el proceso de finalización del protocolo.
Si se dan las condiciones de fallo documentadas, la transferencia entra en el flujo de reversión automática.
El activo del lado de origen puede restaurarse, en lugar de dejar la recuperación supeditada a un reintento manual.
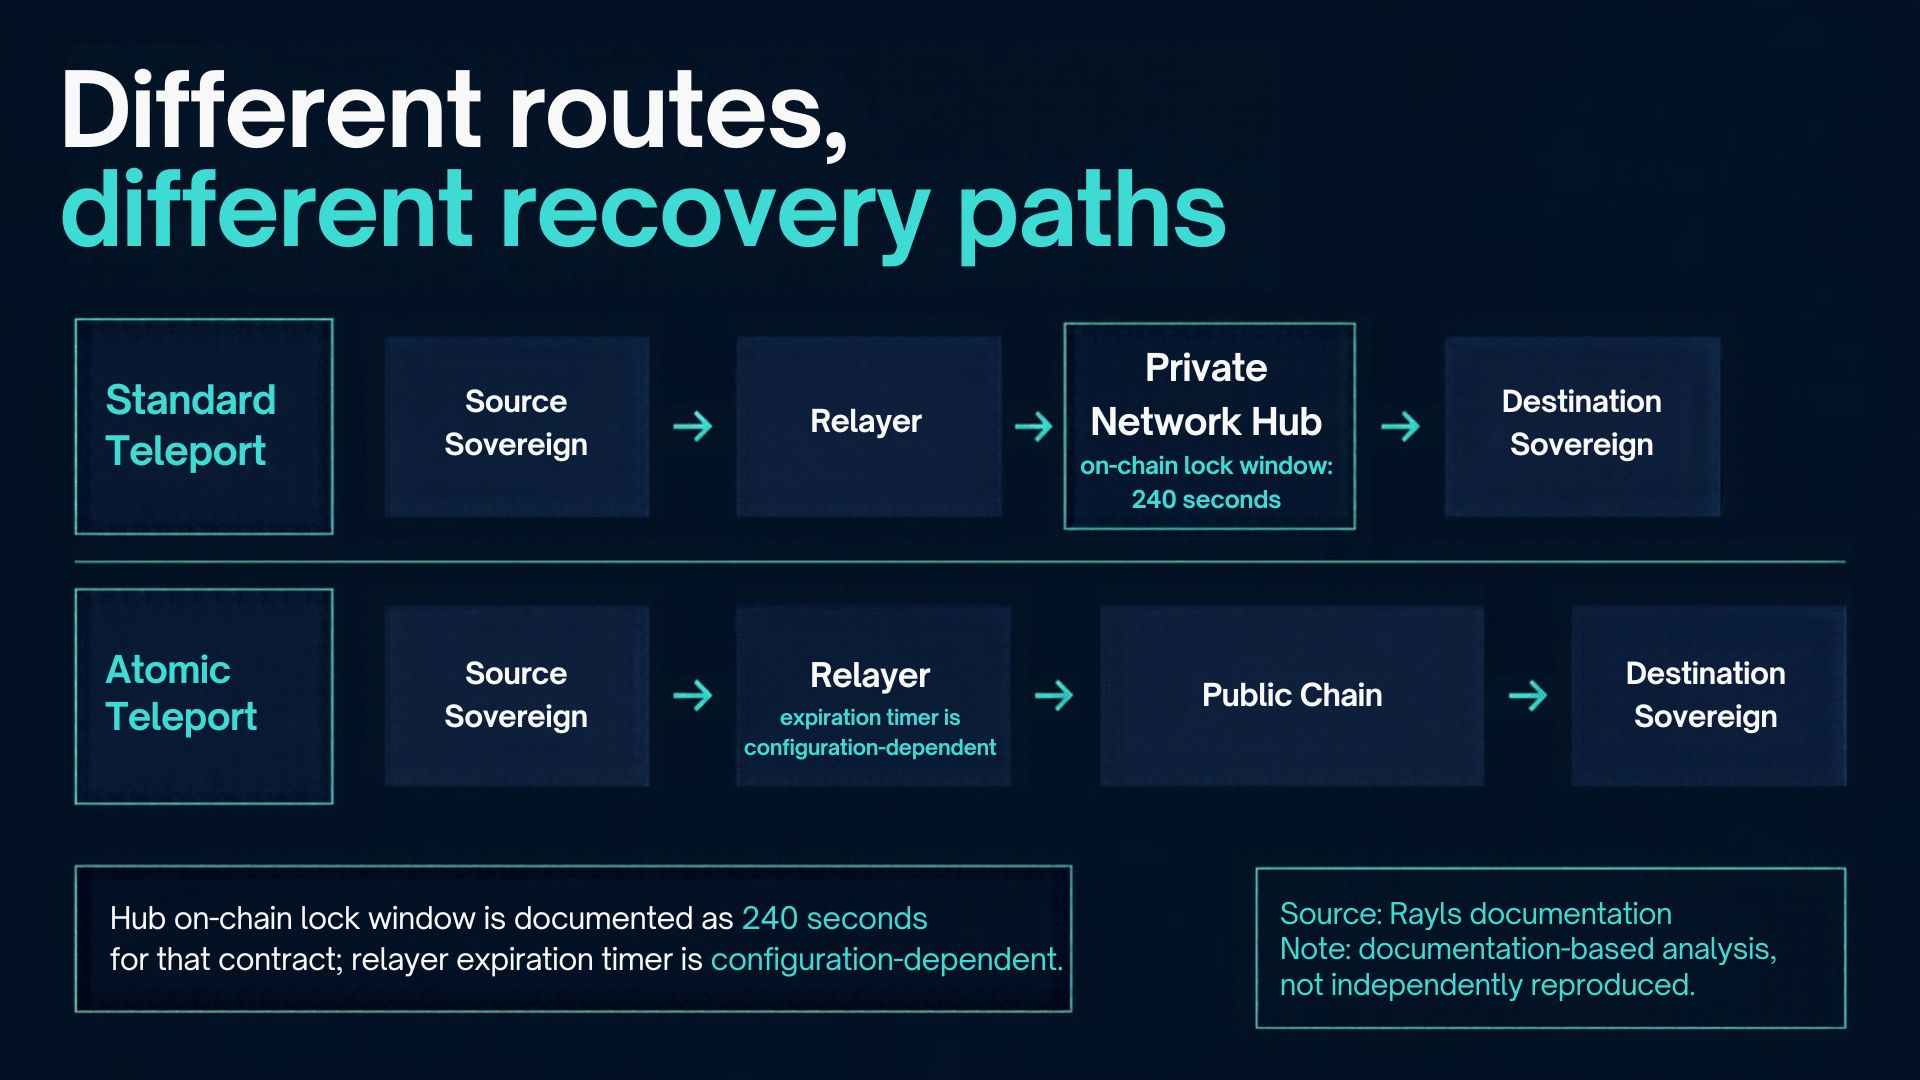
El contrato Teleport del Private Network Hub documenta una ventana de bloqueo en cadena de 240 segundos para el flujo atómico. El Relayer también tiene un temporizador de reversión por expiración fuera de cadena, pero ese temporizador se configura en cada implementación y no es un valor fijo universal del protocolo.
Son mecanismos distintos y no deben tratarse como un solo temporizador.
La conclusión práctica es sencilla: si una aplicación necesita un comportamiento de reversión automática, debe entender qué protocolo de teleportación está usando realmente. El nombre de la red por sí solo no basta para determinar el comportamiento de recuperación.
Referencia oficial:
https://docs.rayls.com/docs/sending-teleports
6. ¿Qué cambia cuando el destino es la Rayls Public Chain?
La ruta directa entre Rayls Sovereign y la Rayls Public Chain tiene una arquitectura distinta de la ruta de Private Network.
Según la documentación oficial, esta conexión no pasa por el Private Network Hub. Utiliza un conjunto distinto de contratos y un proceso de Relayer público independiente.
La mecánica de los activos también varía según la dirección.
Cuando los tokens se mueven de un libro mayor Sovereign a la Public Chain, los tokens de origen se bloquean y se acuñan los tokens espejo correspondientes en el lado público.
Cuando los tokens se mueven de la Public Chain a un libro mayor Sovereign, los tokens públicos se queman y se desbloquean los tokens correspondientes en el libro mayor Sovereign.
El Relayer público supervisa ambos lados. La implementación documentada prepara y almacena una carga útil de reversión al crear la transacción de avance. Si la transacción de destino falla, el servicio de reversión puede recuperar la carga útil almacenada y enviar la transacción de recuperación a la cadena de origen.
El resultado documentado es que una transferencia fallida devuelve el activo a su lado original: si falla una transferencia de Sovereign a la cadena pública, se desbloquean los tokens de origen; si falla una transferencia de la cadena pública a Sovereign, se restauran los tokens en el lado público.
Esta implementación es distinta del flujo de Private Network Hub, aunque ambas rutas buscan coordinar el movimiento de activos entre libros mayores.
Por lo tanto, es importante no dar por sentado que las mismas reglas de contratos, el mismo Relayer o el mismo proceso de gestión de fallos se aplican a todas las conexiones de Rayls.
Referencia oficial:
https://docs.rayls.com/docs/connecting-rayls-sovereign-to-the-public-chain
7. Qué implica esto para desarrolladores y usuarios
Esta investigación apunta a tres lecciones prácticas.
Primero, hay que hacer seguimiento de toda la transferencia, no solo del recibo de origen.
Una aplicación debería hacer seguimiento de la transacción de origen, el procesamiento del mensaje entre cadenas, la ejecución en destino y cualquier transacción de recuperación. De lo contrario, podría mostrar una transferencia como completada demasiado pronto o impedir que los usuarios entiendan por qué se ha quedado atascada.
Segundo, hay que hacer visible el comportamiento de recuperación.
Una operación fallida que requiere un reintento manual no debería mostrarse como si se estuviera recuperando automáticamente. Del mismo modo, una aplicación no debería indicar al usuario que se han devuelto los fondos hasta que se haya confirmado la transacción de recuperación.
Tercero, hay que entender el protocolo antes de hacer promesas.
La teleportación estándar, la teleportación atómica y la ruta directa a la Public Chain tienen mecánicas documentadas diferentes. Una aplicación debería basarse en las garantías de recuperación correspondientes a la ruta que realmente utiliza, en lugar de hacer una promesa general sobre todas las transferencias de Rayls.
Estas son implicaciones de diseño deducidas de la arquitectura documentada. No son afirmaciones de que haya probado de forma independiente todas las rutas de fallo.
8. Qué verifiqué y qué no
La documentación oficial describe las etapas de la transacción, el comportamiento de reintento, el rechazo de pruebas, la gestión de fallos en destino y las rutas de reversión automática.
He utilizado esas descripciones para comparar los comportamientos documentados y deducir las implicaciones prácticas para el seguimiento del estado en una aplicación.
No he desplegado de forma independiente un entorno Rayls, provocado fallos en una transferencia en vivo ni verificado el comportamiento de recuperación mediante trazas de transacciones. Este es un análisis técnico basado en la documentación, no un experimento reproducido de forma independiente.
Un experimento útil a continuación sería realizar una transferencia controlada, provocar un fallo de ejecución en destino y registrar la transacción de origen, el recibo de destino, la transacción de reversión y los saldos finales. Repetir el experimento con la teleportación estándar y la atómica ayudaría a verificar la diferencia entre las rutas de recuperación documentadas.
Eso convertiría una comparación arquitectónica en un hallazgo reproducible de forma independiente.
Reflexiones finales
La infraestructura entre cadenas no debería evaluarse únicamente por si una transferencia puede completarse correctamente.
También debería evaluarse por la claridad con la que se comporta el sistema cuando una transferencia no puede completarse.
La documentación de Rayls describe mecanismos distintos para reintentar fallos temporales, rechazar operaciones inválidas, reintentar manualmente una teleportación estándar fallida y revertir automáticamente una teleportación atómica o una transferencia fallida a través de la ruta directa a la Public Chain.
La lección más útil es que «transacción fallida» no explica por completo qué ocurrió con el activo.
Para entender el resultado, hay que saber dónde se produjo el fallo, qué protocolo de transferencia se utilizó y si el proceso de recuperación documentado se ha completado realmente.
Ese es el nivel de detalle que necesitan los desarrolladores antes de convertir la infraestructura entre cadenas en una experiencia de usuario fiable.
Referencias técnicas oficiales
Cómo funciona una transacción entre cadenas
https://docs.rayls.com/docs/how-a-cross-chain-transaction-works
Envío de teleportaciones
https://docs.rayls.com/docs/sending-teleports
Conexión de Rayls Sovereign con la Rayls Public Chain
https://docs.rayls.com/docs/connecting-rayls-sovereign-to-the-public-chain
#Rayls #TheRail #Blockchain #Web3 #CrossChain #Infrastructure