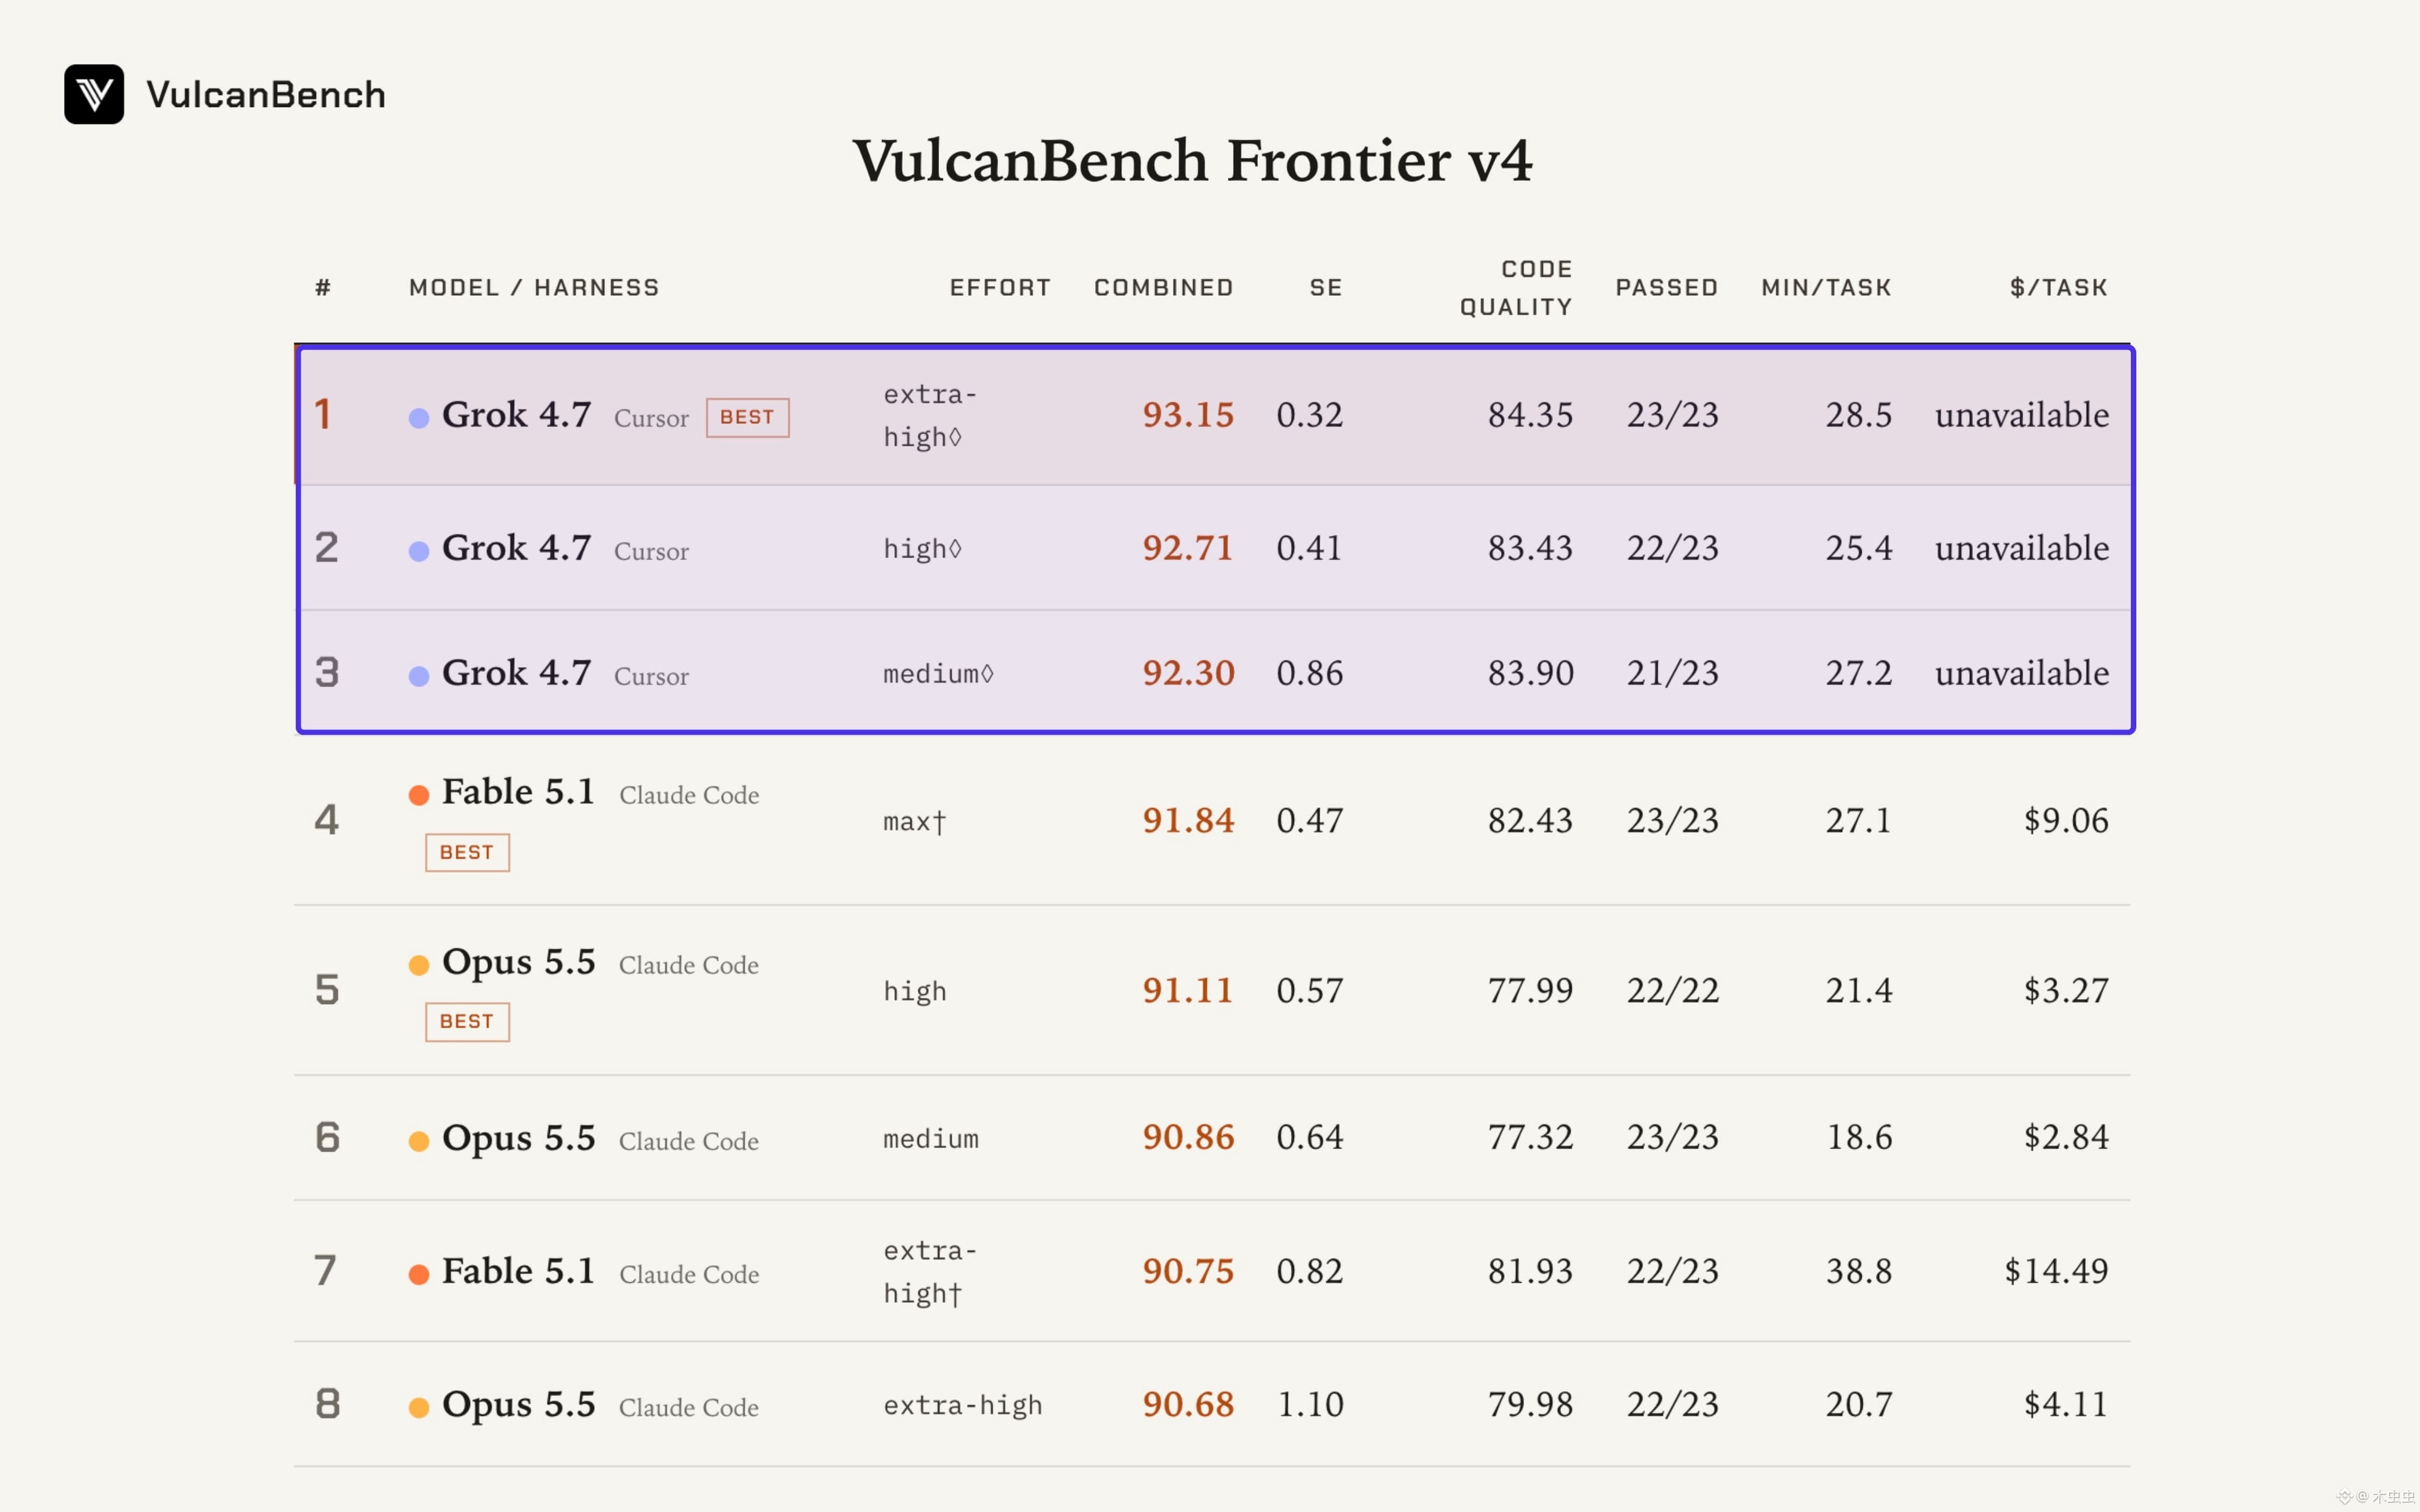
Grok 4.7 ocupa los 3 PRIMEROS puestos en VulcanBench Frontier v4, superando a Fable 5.1, Opus 5.5, GPT-6 Astra, GPT-6.1 Sol y otros modelos de frontera líderes
• Grok 4.7 xHigh - 93.15
• Grok 4.7 High - 92.71
• Grok 4.7 Medium - 92.30
VulcanBench Frontier v4 evalúa si los modelos de IA pueden afrontar tareas difíciles de ingeniería de software a nivel de repositorio, en lugar de limitarse a generar fragmentos de código aislados
El benchmark incluye 23 tareas de reconstrucción del comportamiento en las que los modelos deben reconstruir software heredado para que coincida con su comportamiento real. La corrección funcional se evalúa mediante pruebas ocultas, junto con la seguridad, el lint y la complejidad, y la calidad del código
Y los resultados de las tareas son igual de impresionantes:
• Grok 4.7 xHigh - 23/23 superadas
• Grok 4.7 High - 22/23 superadas
• Grok 4.7 Medium - 21/23 superadas
Grok 4.7 ocupó los puestos n.º 1, n.º 2 y n.º 3