$NVDA
Vaya, ¿esto también funciona? NVDA esta vez sí que tiene algo
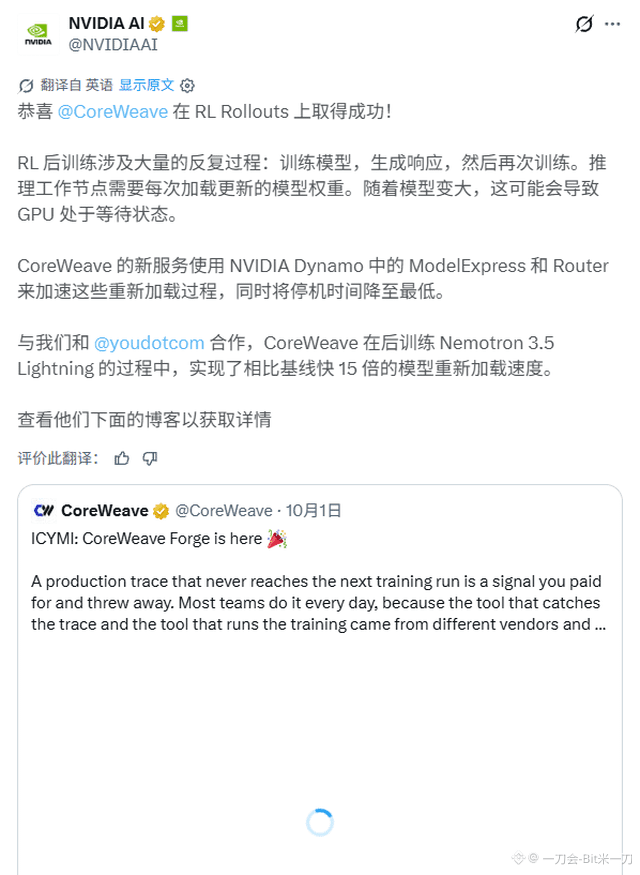
CoreWeave, tras ponerse a hacer RL con su entrenamiento, se dedicaba a tirar y aflojar: antes, con que hubiera un modelo grande en una GPU, el resto se quedaba al lado en modo “mirar sin hacer nada”, completamente desperdiciados
El resultado: ellos usan ModelExpress y Router dentro de la plataforma Dynamo de NVDA, y dejan la velocidad de recarga del Nemotron 3.5 Lightning a 15 veces más
Por fin las GPU ya no tienen que aguantar este agravio
$NVDA