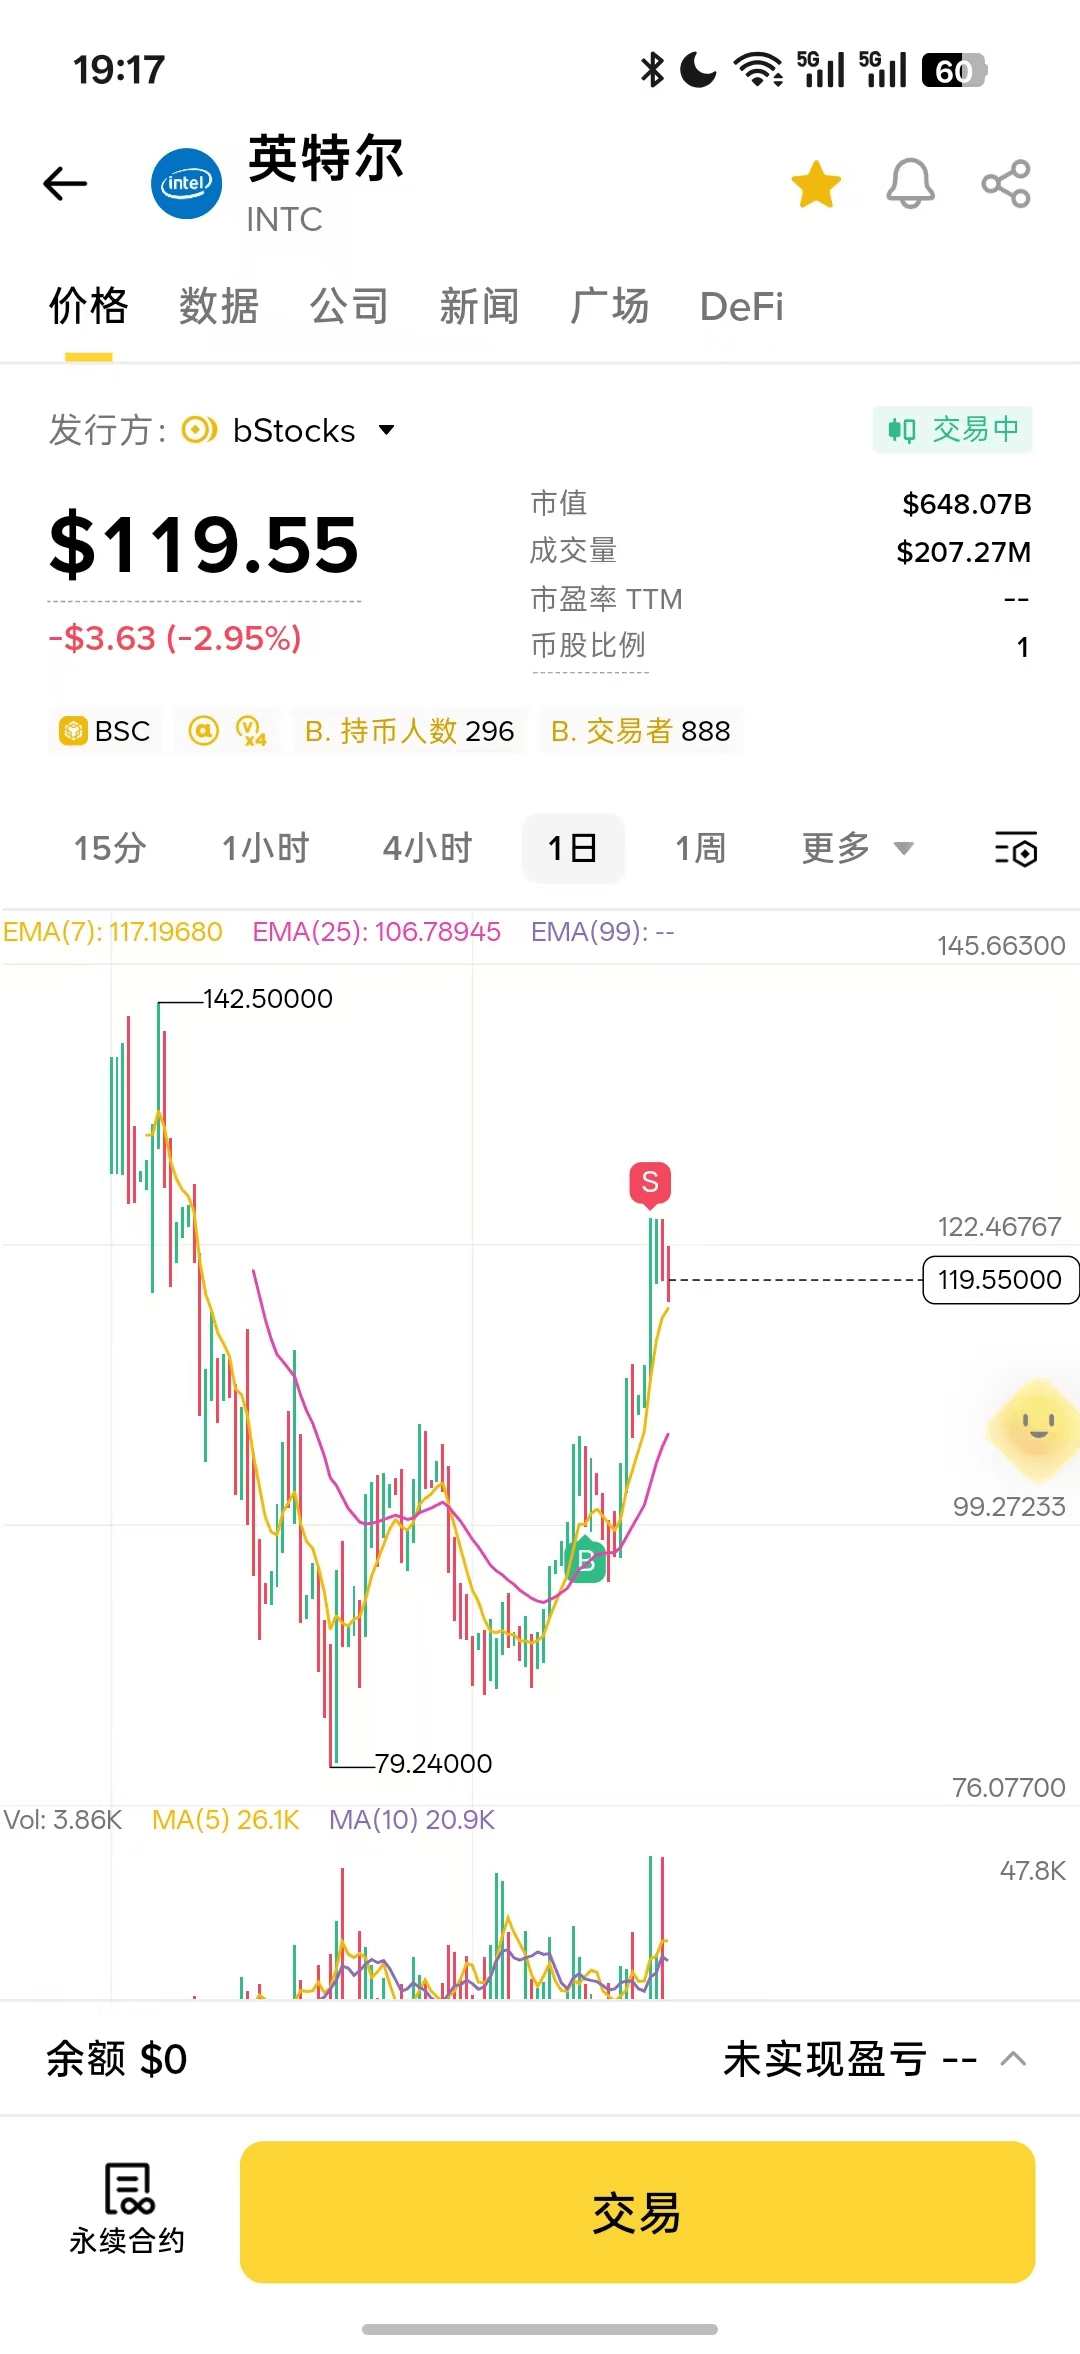

Todavía hay otra buena noticia para $INTCB . La he observado durante unos días y ahora se la explico a todos con claridad.
Esta buena noticia es sobre Muse. Muse hace que la gente descubra que la adopción a gran escala de los agentes no es solo un negocio de GPU; también es un negocio de CPU. Hay que saber que los agentes y la IA no son lo mismo. Hoy en día, la mayoría de la IA funciona así: le haces una pregunta y responde.
Pero los agentes son distintos. Por ejemplo, si le pides a Muse: “Ayúdame a reservar un billete de avión”, necesita abrir el navegador por sí mismo, buscar, comparar precios, iniciar sesión, completar la información, esperar la respuesta de la página y, con base en los resultados, decidir el siguiente paso. Detrás de esto no solo está la inferencia del modelo. La GPU se encarga de “pensar”; la CPU, la memoria, las máquinas virtuales y la red se encargan de “hacer”. Además, el agente no termina después de ejecutar una sola vez. Puede ser: inferir → ejecutar → esperar → leer el estado → volver a inferir → volver a ejecutar… un proceso repetido de inferencia y ejecución hasta completar la tarea.
Y en el futuro es posible que todo el mundo necesite su propio agente. Así que, una vez que el agente pase de ser una “curiosidad” de moda a una herramienta de uso cotidiano y frecuente, lo que se quedará “atascado” ya no será solo la GPU; también se necesitará una gran cantidad de CPU.
Esa es la otra gran buena noticia para $INTCB que yo he estado considerando recientemente.
Esta buena noticia es sobre Muse. Muse hace que la gente descubra que la adopción a gran escala de los agentes no es solo un negocio de GPU; también es un negocio de CPU. Hay que saber que los agentes y la IA no son lo mismo. Hoy en día, la mayoría de la IA funciona así: le haces una pregunta y responde.
Pero los agentes son distintos. Por ejemplo, si le pides a Muse: “Ayúdame a reservar un billete de avión”, necesita abrir el navegador por sí mismo, buscar, comparar precios, iniciar sesión, completar la información, esperar la respuesta de la página y, con base en los resultados, decidir el siguiente paso. Detrás de esto no solo está la inferencia del modelo. La GPU se encarga de “pensar”; la CPU, la memoria, las máquinas virtuales y la red se encargan de “hacer”. Además, el agente no termina después de ejecutar una sola vez. Puede ser: inferir → ejecutar → esperar → leer el estado → volver a inferir → volver a ejecutar… un proceso repetido de inferencia y ejecución hasta completar la tarea.
Y en el futuro es posible que todo el mundo necesite su propio agente. Así que, una vez que el agente pase de ser una “curiosidad” de moda a una herramienta de uso cotidiano y frecuente, lo que se quedará “atascado” ya no será solo la GPU; también se necesitará una gran cantidad de CPU.
Esa es la otra gran buena noticia para $INTCB que yo he estado considerando recientemente.