Casi desistí de actualizar mi saldo dos veces antes de entender exactamente qué estaba esperando.
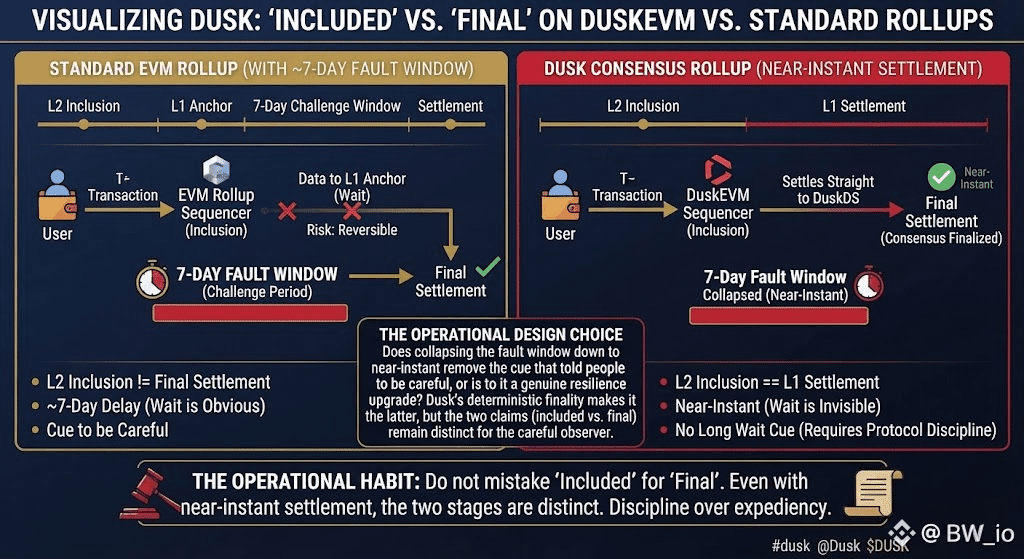
El crepúsculo no trata una transacción puenteada como un único momento. Primero, el secuenciador incluye una transacción en un bloque de L2; luego, el publicador de lotes vuelve a publicar esos datos en DuskDS, y solo cuando allí se anclan las confirmaciones de estado y las pruebas de fallos, la transferencia en realidad se liquida.
Esta fue la parte que cambió mi forma de leerlo: la mayoría de los rollups EVM te hacen esperar una ventana de desafío de aproximadamente siete días antes de que un retiro sea verdaderamente final, porque alguien tiene que tener tiempo para disputar un estado incorrecto. DuskEVM se liquida directamente en DuskDS, en lugar de una ventana de fallos de siete días. Así que la brecha entre la inclusión y la liquidación no son días: es algo que podrías parpadear y ya. Esa es una elección de diseño real, no solo fontanería.
Y casi hace que sea peor de alguna manera. Si el retraso fuera largo, esperarías tener que aguardarlo y planificar en torno a ello. Como es rápido, es fácil confundir "incluida" con "final" y no darte cuenta de que se están haciendo dos reclamaciones separadas.
Me gusta que el protocolo aún mantenga esas reclamaciones distintas incluso cuando la separación entre ellas es lo bastante pequeña como para ignorarla.
Entonces, ¿reducir la ventana de fallos a casi instantánea es una mejora real de resiliencia sobre el modelo estándar de rollup, o al eliminar la espera larga simplemente se elimina la señal que le decía a la gente que tuviera cuidado?
#dusk @Dusk $DUSK $PENGU $TUT
El crepúsculo no trata una transacción puenteada como un único momento. Primero, el secuenciador incluye una transacción en un bloque de L2; luego, el publicador de lotes vuelve a publicar esos datos en DuskDS, y solo cuando allí se anclan las confirmaciones de estado y las pruebas de fallos, la transferencia en realidad se liquida.
Esta fue la parte que cambió mi forma de leerlo: la mayoría de los rollups EVM te hacen esperar una ventana de desafío de aproximadamente siete días antes de que un retiro sea verdaderamente final, porque alguien tiene que tener tiempo para disputar un estado incorrecto. DuskEVM se liquida directamente en DuskDS, en lugar de una ventana de fallos de siete días. Así que la brecha entre la inclusión y la liquidación no son días: es algo que podrías parpadear y ya. Esa es una elección de diseño real, no solo fontanería.
Y casi hace que sea peor de alguna manera. Si el retraso fuera largo, esperarías tener que aguardarlo y planificar en torno a ello. Como es rápido, es fácil confundir "incluida" con "final" y no darte cuenta de que se están haciendo dos reclamaciones separadas.
Me gusta que el protocolo aún mantenga esas reclamaciones distintas incluso cuando la separación entre ellas es lo bastante pequeña como para ignorarla.
Entonces, ¿reducir la ventana de fallos a casi instantánea es una mejora real de resiliencia sobre el modelo estándar de rollup, o al eliminar la espera larga simplemente se elimina la señal que le decía a la gente que tuviera cuidado?
#dusk @Dusk $DUSK $PENGU $TUT