Los nodos Running Boreas RC1 cambiaron la forma en que pienso sobre la infraestructura de red.
No por los tiempos de bloque ni por las recompensas de staking. Porque empecé a usar tcpdump para observar el tráfico de sincronización por costumbre y noté algo que la mayoría de la gente nunca mira. Los @Dusk nodes no usan la pila gossipsub de Geth para la propagación de bloques. Usan Kadcast.
Ese detalle importa más que la mayoría de las métricas principales.
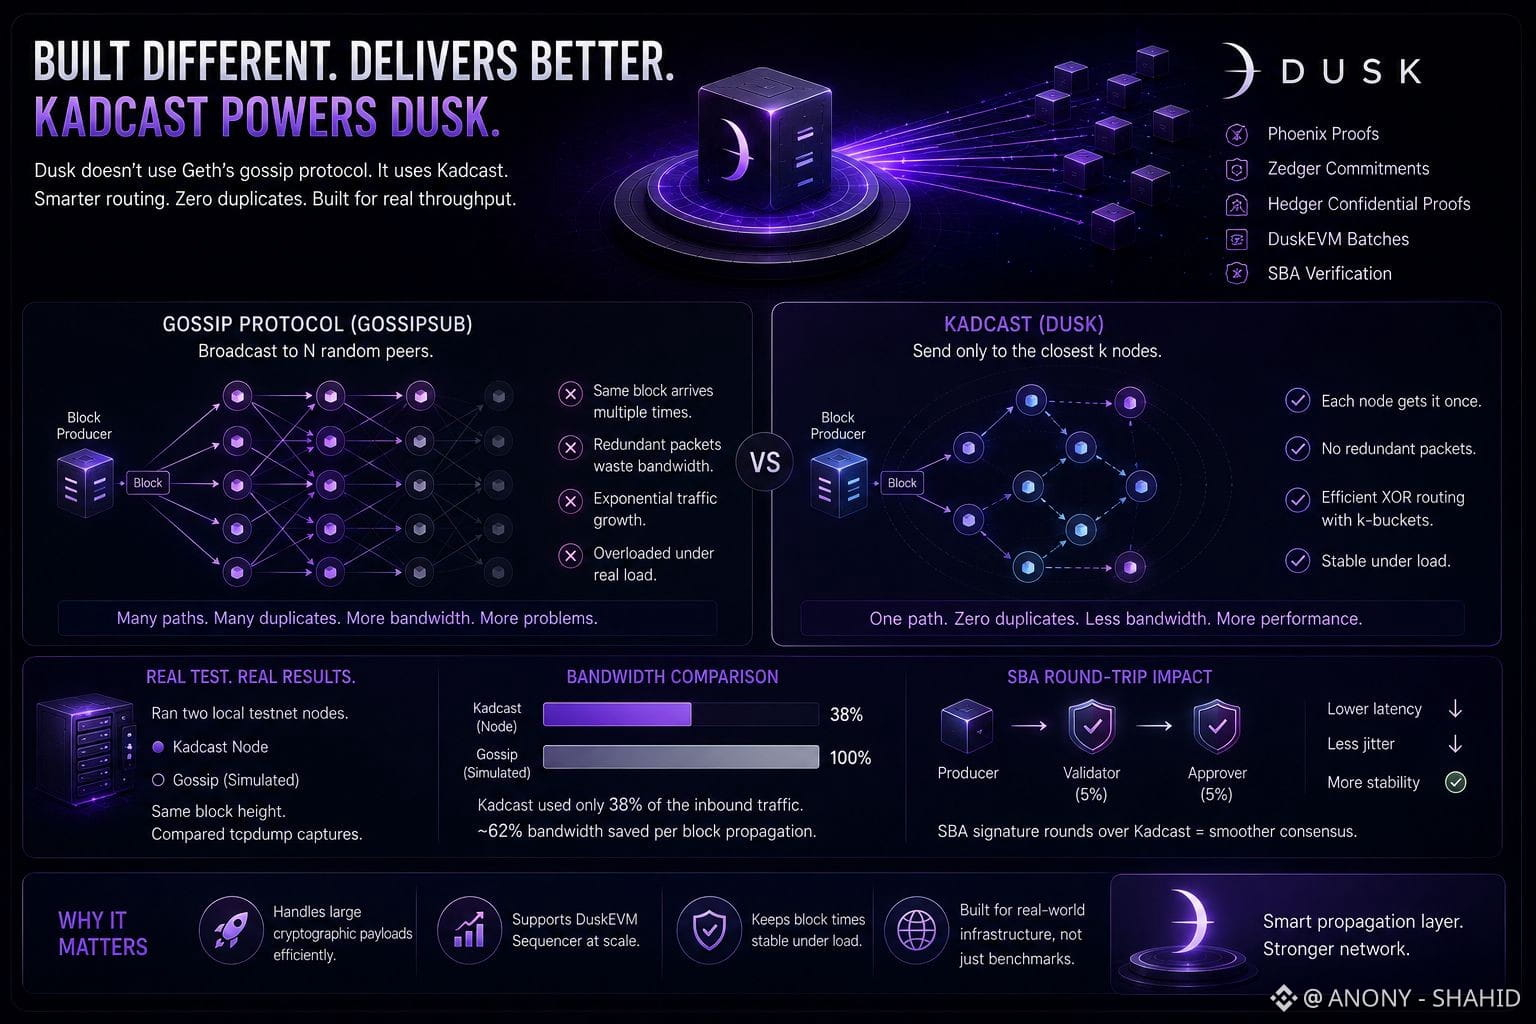
El protocolo de gossip funciona haciendo que cada nodo envíe bloques a N pares aleatorios, que luego los envían a sus propios pares. La propagación exponencial suena eficiente hasta que te das cuenta de que el mismo bloque llega al mismo nodo cinco veces por cinco rutas distintas. El ancho de banda se consume con duplicados, no con datos útiles.
Kadcast lo resuelve de otra forma. Los nodos se organizan en k-buckets usando la distancia XOR de Kademlia. El productor de bloques solo envía a los k nodos más cercanos. Cada salto sigue la tabla de enrutamiento hacia adelante sin difundir a la red completa. Cada nodo recibe cada mensaje una sola vez. Los paquetes redundantes caen cerca de cero.
Para la arquitectura de Dusk, esto no es una optimización menor. Las pruebas Phoenix PLONK, las confirmaciones Zedger y las pruebas de variables confidenciales Hedger son cargas de trabajo considerables. Los lotes del DuskEVM Sequencer que vuelven desde DuskDS para la verificación de SBA pasan por esta misma red. Bajo gossip, 50 nodos reenviando mutuamente solicitudes de verificación saturarían el ancho de banda típico de un hogar. Kadcast reduce los bytes totales por propagación de bloques en aproximadamente un orden de magnitud a esa escala.
Ejecuté dos nodos de testnet local simultáneamente. Uno usando Kadcast y otro simulando reenvío gossip. Misma altura de bloque; comparé directamente las capturas de tcpdump. El tráfico entrante en el nodo Kadcast fue el 38% de la simulación gossip. Las rondas de firmas SBA entre el productor, el validador y el aprobador también pasaron por Kadcast, y el jitter de producción de bloques bajó de forma notable.
La mayoría de los operadores de nodos vigilan los tiempos de bloque. La capa de propagación debajo es la que determina si esos tiempos de bloque se mantienen estables bajo carga.
#dusk $DUSK #Binance