


Título original: (DeepSeek publica un modelo de comprensión visual; los “ojos” que llegaron tarde, como el Gran Pez Azul)
Autor original: Dongcha Beating
El 21 de agosto de 2026, DeepSeek lanzó un nuevo modelo de comprensión visual, deepseek-v4-flash-vision-exp, y la API multimodal se abrió oficialmente. Por primera vez, los desarrolladores pueden enviar imágenes directamente a la interfaz oficial de DeepSeek.
El modelo conserva el contexto de 1 millón de tokens y la salida máxima de 384.000 tokens de V4 Flash, admite JSON Output, Tool Calls y Responses API, y también es compatible con la API de Anthropic.
El precio también se mantiene completamente con V4 Flash. Por cada millón de tokens de entrada, cuando hay fallo de caché, en horario de máxima demanda cuesta 3 yuanes, y en horario de baja demanda 1,5 yuanes; cuando hay acierto de caché, es de 0,1 yuanes y 0,05 yuanes, respectivamente. La salida cuesta 9 yuanes en horario de máxima demanda y 4,5 yuanes en horario de baja demanda. Pekín considera como horario de máxima demanda todos los días de 9:00 a 12:00 y de 14:00 a 18:00; las otras 17 horas tienen un 50% de descuento.
Las imágenes también se cobran por tokens. Antes de entrar en el modelo, cada imagen se redimensiona automáticamente según su tamaño: las que son menores de aproximadamente 384×384 píxeles se amplían, y las grandes se comprimen hasta una cantidad total de píxeles de aproximadamente 800×800. Una sola imagen ocupa como máximo 384 tokens. Una imagen de 2000×2000 y una de 5000×5000 pueden terminar consumiendo exactamente los mismos tokens.
Con un límite de 384 tokens, durante las horas pico y cuando no hay fallo de caché, el coste de entrada de una imagen es de aproximadamente 0.001152 yuanes. Procesar mil imágenes de este tipo supone que, solo la entrada de la imagen cuesta aproximadamente 1.152 yuanes; el texto y la salida del modelo se calculan por separado.
También se lanzó junto con Files API. Los desarrolladores pueden cargar imágenes con antelación y, luego, poner el file_id en la solicitud. Para una misma imagen solo se necesita enviarla una vez; después, puede reutilizarse repetidamente en distintas solicitudes. En una sola solicitud, como máximo también se pueden incluir 600 imágenes. Al usar enlaces externos o Base64, el límite de una imagen es de 32 MiB; tras referenciarla mediante Files API, puede llegar a 64 MiB.
Este API en sí no tiene coste. Un archivo máximo pesa 64 MiB; por usuario, como máximo 25 GiB y 10000 archivos. Los archivos pueden configurarse para expirar entre 1 hora y 30 días; si no se establece un periodo de vigencia, pueden conservarse indefinidamente. Actualmente, la oficina oficial tampoco ofrece una interfaz para descargar el contenido de los archivos. Los desarrolladores pueden subir, consultar y eliminar; el modelo puede leerlos. Es más como un repositorio gratuito de imágenes preparado para la inferencia, no como un almacenamiento en la nube normal.
Pero lo extraño no es que DeepSeek empezara a ver imágenes solo hasta hoy.
Dos líneas de tiempo
Si solo miras la investigación, la visión de DeepSeek no llegó tarde.
Si solo miras el producto y la API, también es cierto que llegó mucho más tarde.
El 11 de marzo de 2024, DeepSeek-VL se hizo código abierto.
Tiene dos versiones, 1.3B y 7B; puede ver imágenes naturales, páginas web, fórmulas, gráficos y documentos. Para octubre, apareció Janus, integrando comprensión y generación de imágenes en el mismo marco auto-regresivo. El 13 de noviembre, siguió JanusFlow. En diciembre, se publicó DeepSeek-VL2, que cambia a una arquitectura de expertos híbridos; el total de parámetros se divide en tres rangos: 3B, 16B y 27B.
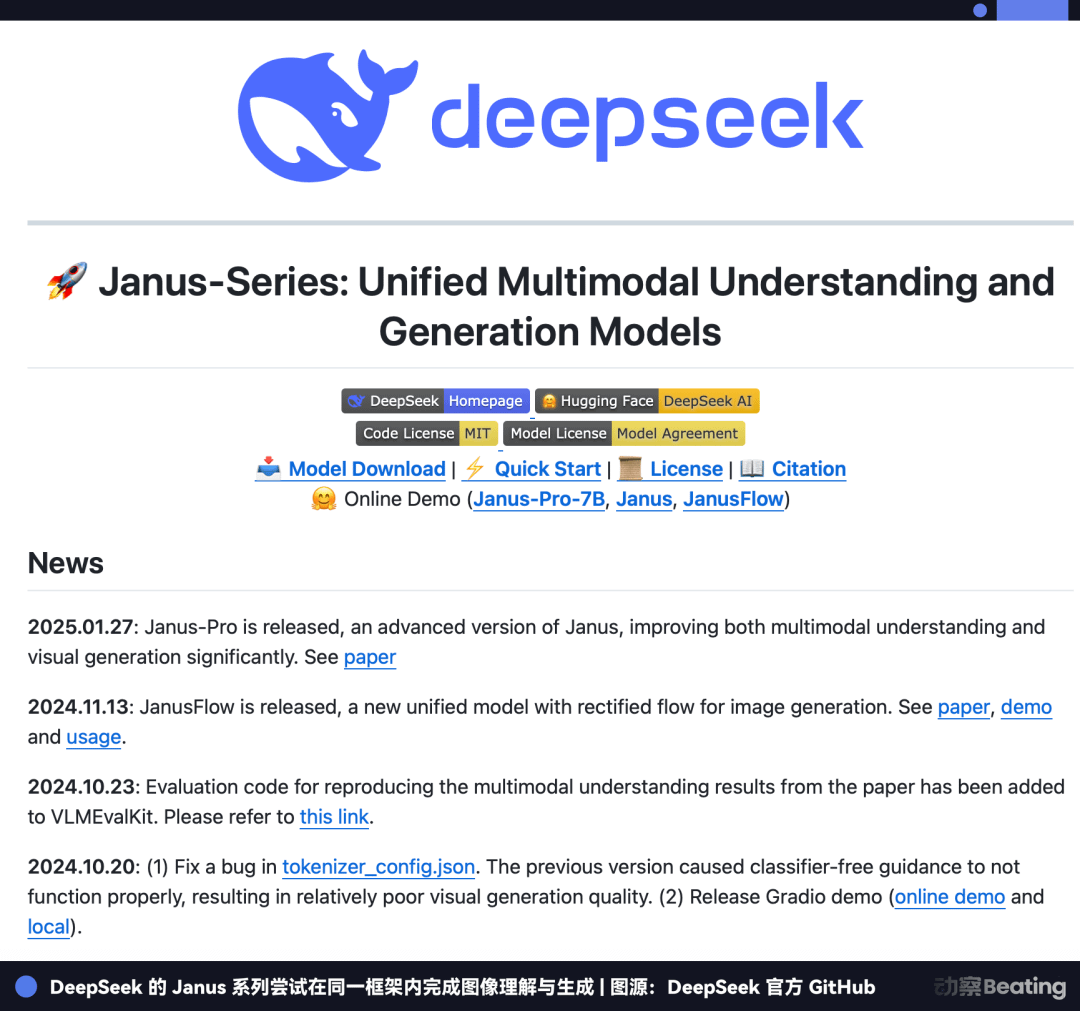
A la madrugada del 28 de enero de 2025, en Nochevieja, Janus-Pro se hizo código abierto. El repositorio oficial lo registra el 27 de enero en UTC.
La versión de 7B logra 0.80 en la evaluación de seguimiento de instrucciones para generar imágenes en GenEval, superando el 0.67 de DALL-E 3 listado en el paper. Tiene pesos de código abierto, puede implementarse localmente y también cuenta con demostraciones públicas.
DeepSeek no lo integró en su API alojada.
Justo la semana anterior, R1 ya había puesto a DeepSeek bajo los reflectores. Janus se quedó en GitHub y Hugging Face. Para la gran mayoría de usuarios comunes, en poco tiempo volvió a desaparecer de su campo de visión.
El 20 de octubre de 2025, DeepSeek-OCR se hizo código abierto, comprimiendo documentos largos con tokens visuales. El 27 de enero de 2026, se publicó OCR 2.
Contando desde DeepSeek-VL, en los dos años al menos se pueden encontrar siete registros públicos: DeepSeek-VL, Janus, JanusFlow, VL2, Janus-Pro, OCR y OCR 2.
La investigación de visión siempre se ha estado haciendo y siempre se ha ido compartiendo hacia afuera.
Pero a los desarrolladores normales les seguía faltando ese acceso.
Por otro lado, para marzo de 2024, las interfaces de los principales competidores ya podían aceptar imágenes. OpenAI abrió GPT-4 Turbo with Vision en noviembre de 2023: las imágenes podían entrar directamente en la API de Chat Completions; un mes después, Google lanzó la Gemini Pro Vision API; en marzo de 2024, Claude 3 (toda la gama) incorporó capacidades de visión.
El 25 de abril de 2025, Li Yanhong dijo en el evento Baidu Create: «DeepSeek tampoco es todopoderoso». Entre los varios problemas enumerados, también estaba uno de modalidad única.
Su juicio es que el multimodal se convertirá en un elemento estándar del modelo base y que el mercado de modelos puramente de texto será cada vez más pequeño.
En aquel entonces, DeepSeek ya llevaba un año investigando visión.
Al amanecer.
Los días 7 y 8 de abril de 2026, algunos usuarios abrieron DeepSeek y, de repente, en la interfaz aparecieron tres accesos directos adicionales.
«Rápido», «experto», «visión».
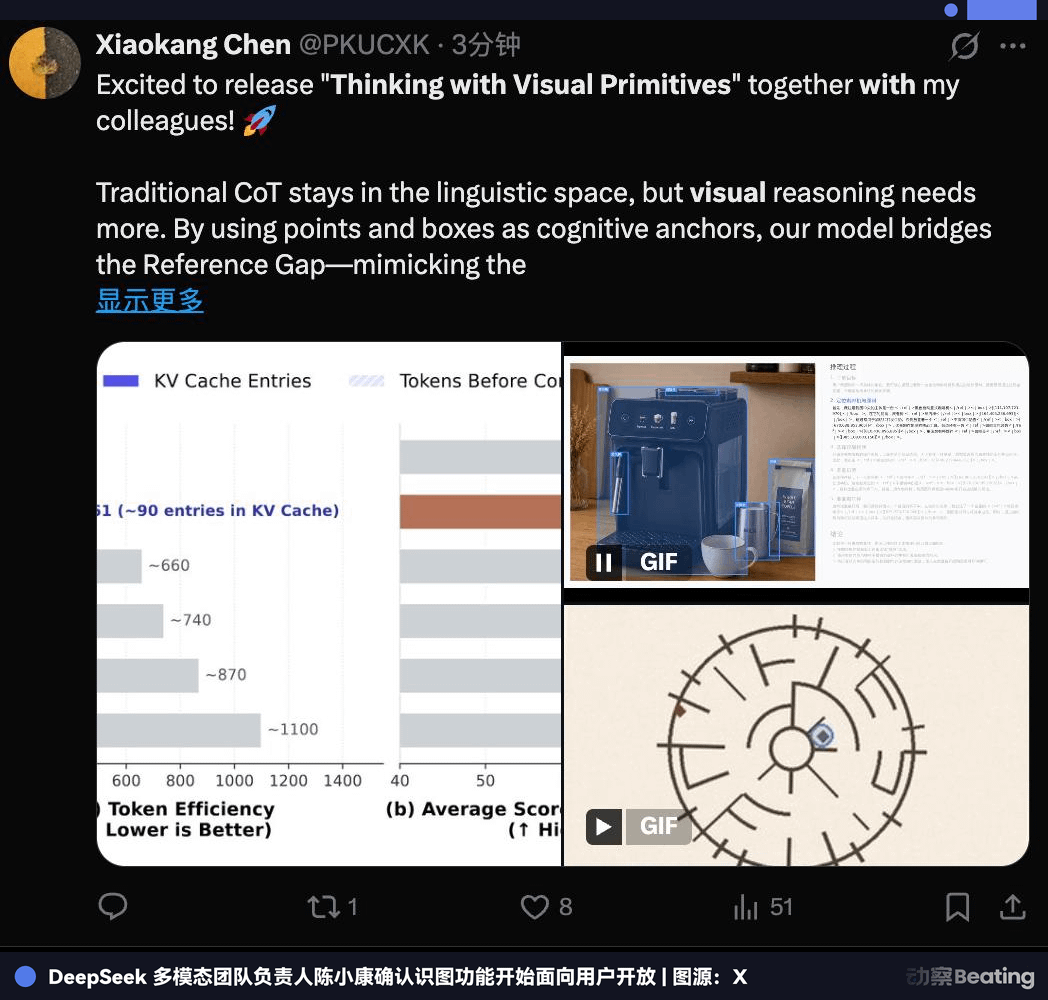
El 29 de abril, el responsable del equipo de multimodal de DeepSeek, Chen Xiaokang, confirmó que la función de reconocimiento de imágenes empezaba a implementarse gradualmente para algunos usuarios. Después, un investigador senior de DeepSeek escribió: «El pequeño tiburón ya puede ver». South China Morning Post puso esa frase directamente en el título.
Los ojos de DeepSeek por primera vez se asomaron realmente desde la interfaz del producto.
Al día siguiente, DeepSeek subió (Thinking with Visual Primitives) a GitHub. Unas horas después, tanto el repositorio como el documento fueron retirados. Para el 1 de mayo, la dirección original ya devolvía 404. DeepSeek no explicó nada; en internet solo quedaron los espejos del documento y las transcripciones de los medios.
El documento de investigación trata un problema muy específico.
Después de ver una imagen muy concurrida, a menudo el modelo sabe de qué está hablando, pero no puede aclarar cuál de las personas ni cuál de las líneas es exactamente. El equipo insertó directamente las coordenadas de los puntos y los cuadros delimitadores en el proceso de inferencia para que el modelo señale la posición mientras sigue pensando hacia adelante.
Una imagen de 756×756 pasa primero por un codificador visual y se convierte en 2916 tokens de bloques de imagen; luego, mediante una compresión espacial 3×3, se reduce a 324 tokens. La atención dispersa de V4 Flash sigue comprimiendo el caché y, al final, solo quedan 81 entradas de KV visuales.
El equipo también generó más de 40 millones de muestras de entrenamiento para este método, incluyendo datos entrenados específicamente para navegación por laberintos y seguimiento de trayectorias.
Lo que esa tesis empleó un gran esfuerzo en resolver, en realidad era «señalar aquí».
Primero, el modelo tiene que ver; luego, tiene que saber dónde está mirando. Solo así puede seguir inferiendo hacia adelante.
En esta ocasión, DeepSeek no aclaró si Vision Exp conserva por completo esta solución de Visual Primitives. Pero lo más importante es que este trabajo, por primera vez, sacó a la vista cómo entiende DeepSeek la «inferencia visual».
El 18 de junio se lanzó oficialmente el modo de reconocimiento de imágenes para la web y la app. Al día siguiente, un medio subió una prueba con la foto de Liang Wenfeng; DeepSeek lo reconoció dos veces seguidas como Zhang Yiming. Con otra conversación, volvió a reconocer a Zhang Yiming como el fundador de Holochip, Chen Tianshi.
Ya puede leer capturas de pantalla en inglés y también convertir páginas web en código.
Pero cuando se presenta ante una cara, ni siquiera puede reconocer a su propio jefe.
El 19 de agosto, DeepSeek Harness dejó una nota técnica con una fecha claramente definida. Los adaptadores oficiales ya pueden serializar una secuencia de imágenes como image_url; además, la documentación indica que, por el momento, el directorio de modelos predeterminado no mostrará deepseek-v4-flash-vision-exp, y habrá que esperar a que estén disponibles los endpoints de la API correspondientes.
El 20 de agosto, también hubo desarrolladores que probaron en la práctica: si subes una imagen con el nombre del modelo que aún no se había abierto, solo recibes un error 400.
El 21 de agosto, se eliminó esta limitación. Harness añadió deepseek-v4-flash-vision-exp al directorio de modelo predeterminado; el envío de la fusión correspondiente decía directamente «publish the vision model». Después, el API oficial de DeepSeek y su cuenta en WeChat anunciaron simultáneamente el lanzamiento de Vision Exp.
Por fin, las dos líneas se encontraron.
Agent
En una grabación transcrita de una reunión con inversores en mayo de este año, Liang Wenfeng ordenó su propia ruta hacia AGI en varios niveles: modelos de lenguaje, cadena de pensamiento, Agent, aprendizaje continuo, autoiteración y, finalmente, inteligencia encarnada.
Él colocó el multimodal en el lugar de los componentes, más o menos como en la búsqueda.
Al hablar de generación de video, hay una frase en la transcripción:
En lo comercial, es un buen negocio. Pero eso no tiene nada que ver con la inteligencia.
Su juicio es que, en la etapa actual, la relación entre generación de video, modelos del mundo y el límite de inteligencia no es tan grande; lo más urgente ahora es el entrenamiento de la IA y, después del entrenamiento, el aprendizaje continuo.
La diferencia con el multimodal es que, aunque también se coloca en el lugar de los «componentes», es un componente que DeepSeek ha dicho claramente que haría. Liang Wenfeng también lo mencionó: V4 y las versiones posteriores admitirán multimodal nativo.
La visión siempre tuvo un lugar en la ruta de DeepSeek; solo que no se colocó tan al frente.
Cuando la ruta llega al tercer paso, el escenario empieza a ser un poco distinto.
DeepSeek no ha dicho públicamente que este API de visión saliera «para Agent». Pero si pones la valoración de Liang Wenfeng sobre la ruta junto con el anuncio de hoy, ya es muy difícil separar completamente ambas líneas.
Agent tiene que leer la pantalla, mirar gráficos y procesar capturas de pantalla que le devuelven las herramientas. No puede vivir para siempre en el puro texto. Todas esas capacidades de visión que lleva dos años desarrollando, finalmente llegaron desde el paper, los repositorios y las páginas de pruebas hasta la API.
Los tres ejemplos que DeepSeek mostró hoy para Vision Exp tampoco son los tradicionales «mirar una imagen y hablar»: uno es un Agent que prepara una presentación de PPT de viaje en coche por Tíbet para clientes de alto nivel; otro rediseña el sitio web oficial de DeepSeek Harness; y el tercero crea una demo de frontend con efectos dinámicos según requisitos visuales.
Todas necesitan que el modelo procese repetidamente información visual en tareas de larga duración.
El diseño de la API también se orienta en esa dirección. La API de Responses también acepta input_image; después, un Agent del navegador, una vez que obtiene una captura de la página, puede volver a enviarla a la siguiente ronda de inferencia. Un Agent de código puede revisar el resultado del renderizado; los gráficos, escaneos e incluso interfaces de software también pueden convertirse directamente en contexto.
Files API resuelve otra cosa: que una misma imagen no tenga que volver a subirse en cada ronda de solicitudes. Un archivo puede permanecer allí durante mucho tiempo y el Agent solo tiene que enviar una y otra vez el file_id. En una sola solicitud, además, se pueden incluir hasta 600 imágenes. Al usar enlaces externos o Base64, el límite por imagen es de 32 MiB; usando Files API, el límite puede llegar a 64 MiB.
Esto ya no se parece a añadir un botón de «subir imagen» al cuadro de chat.
Se parece más a estar completando la infraestructura que Agent necesita para usar visión.
En la comparación de agentes multimodales de cuatro puntos publicada por DeepSeek, también se ve muy poco lo típico de «mirar una imagen y hablar».
ApexBench se centra en tareas de larga duración en banca de inversión, consultoría y derecho. Agents' Last Exam proviene de trabajo real en 55 dominios profesionales. Chartography evalúa específicamente curvas Kaplan-Meier, velas, curvas de nivel, diagramas de Sankey y gráficos de Pareto. ZeroBench, en cambio, prueba razonamiento visual paso a paso usando 100 desafíos diseñados manualmente.
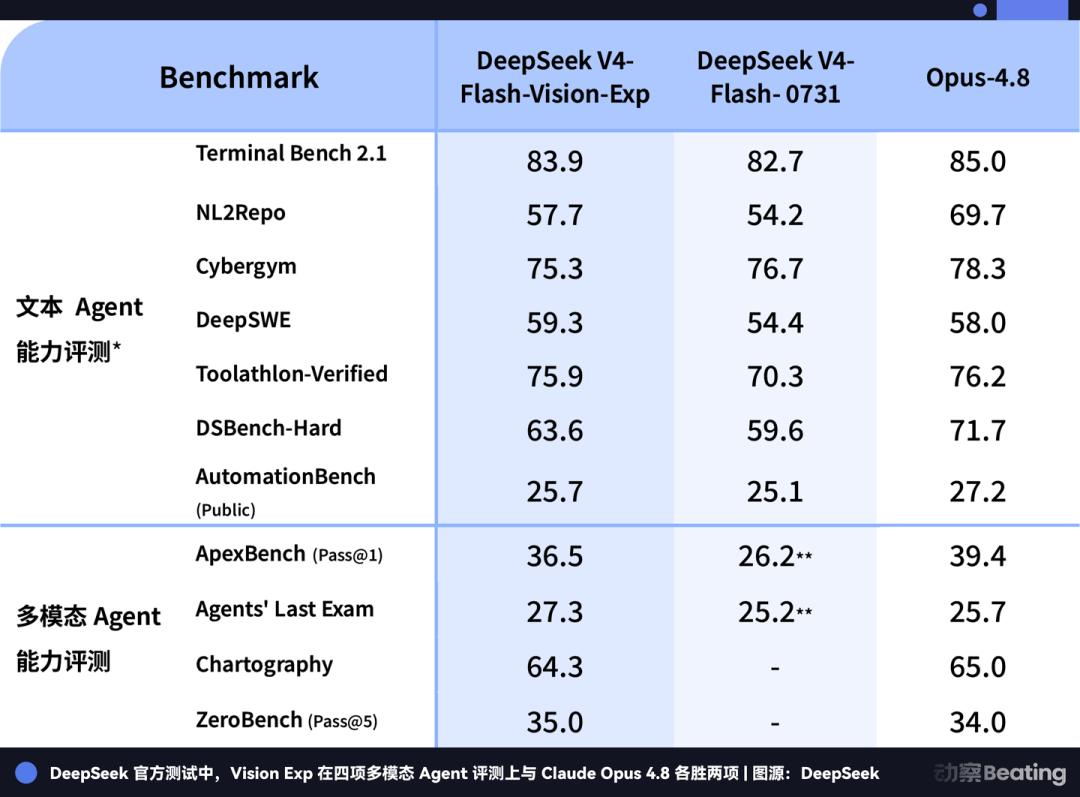
Vision Exp obtuvo dos victorias y dos derrotas contra Claude Opus 4.8.
Agents' Last Exam es 27.3 contra 25.7; ZeroBench es 35.0 contra 34.0. ApexBench es 36.5 contra 39.4, Chartography es 64.3 contra 65.0. Las cuatro diferencias no superan los 3 puntos.
Lo más interesante es que, al añadir visión, la capacidad del agente de texto original no cae de forma evidente.
Comparándolo punto por punto con el puro texto V4 Flash publicado el 31 de julio, la web también mostró un aumento total en las cinco evaluaciones de texto para agentes, tanto antes como después, en las métricas.
Terminal Bench 2.1 sube de 82.7 a 83.9; NL2Repo de 54.2 a 57.7; DeepSWE de 54.4 a 59.3; DSBench-Hard de 59.6 a 63.6; AutomationBench de 25.1 a 25.7. El 59.3 de DeepSWE también supera el 58.0 de Opus 4.8 en la imagen.
Sin embargo, estos números proceden de las propias pruebas de DeepSeek. Según la nota oficial, los modelos de la serie DeepSeek usados en tareas de texto de Code Agent público utilizan el modo ultra minimalista de DeepSeek Harness y la configuración de inferencia está en max. Son más adecuados para observar los cambios de Vision Exp en comparación con el propio V4 Flash, en lugar de tomarlos directamente como ranking independiente de un tercero.
La exp detrás del nombre del modelo tampoco se ha retirado todavía.
DeepSeek lo marcó explícitamente como un modelo experimental, y la versión aún podría seguir cambiando. Ahora la interfaz solo hace comprensión de imágenes; la salida sigue siendo texto. La generación de imágenes y video no se ha abierto; Files API también solo acepta JPEG, PNG, GIF y WebP; no se pueden insertar directamente archivos PDF.
En 2024, los desarrolladores querían enviarle una imagen a DeepSeek, pero la API oficial aún no lo podía recibir.
Para el 21 de agosto de 2026, por fin esta imagen entró.
Los ojos de DeepSeek, en efecto, se abrieron tarde.
Cuando por fin realmente abra los ojos, el camino que había delante ya no le permitirá seguir caminando con ellos cerrados.
Enlace original