

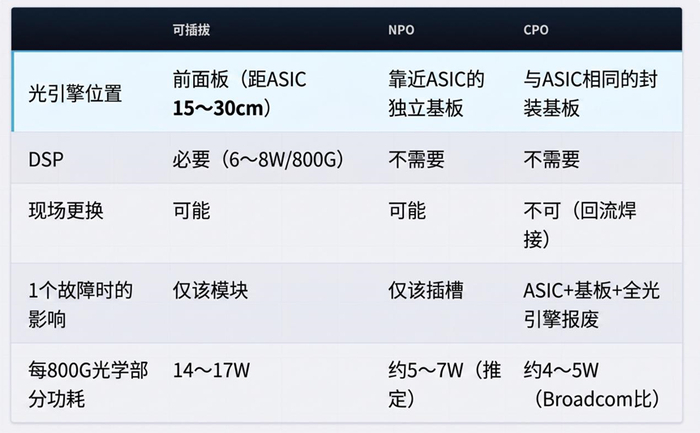
Abra el rack del centro de datos y verá una fila de transceptores ópticos dispuestos en el panel frontal del switch. En los clústeres de inteligencia artificial, es una configuración común que un switch esté equipado con 144 módulos QSFP-DD compatibles con 800G. Sin embargo, esta configuración presenta problemas estructurales de baja eficiencia. La distancia entre los transceptores del panel frontal y el chip ASIC del switch es de 15 a 30 centímetros. Cuando las señales de 200G por canal se transmiten a lo largo de este cable de cobre, experimentan una atenuación significativa, por lo que en el extremo receptor se necesita un chip DSP (procesamiento digital de señales) para recuperar la señal. El consumo de energía de un módulo 800G es de 14 a 17 vatios, de los cuales 6 a 8 vatios se consumen en el chip DSP. Es decir, en los módulos ópticos enchufables tradicionales, una parte considerable de la energía no se usa directamente para la conversión optoeléctrica, sino para la acondicionamiento, ecualización y transmisión de señales eléctricas de alta velocidad.
Acortar esta distancia elimina la necesidad de usar DSP. Esta idea ya surgió a mediados de la década de 2010. Los dispositivos ópticos integrados en un mismo encapsulado (CPO) integran el motor óptico (un conjunto de componentes que convierten señales eléctricas en señales ópticas) y el encapsulado del ASIC del switch en la misma placa; este diseño reduce de forma significativa la distancia de conexión eléctrica de alta velocidad entre el ASIC y el motor óptico, disminuyendo así de manera notable las pérdidas causadas por las interconexiones de cobre. Broadcom anunció que el CPO puede reducir el consumo de energía del sistema óptico en 65-70%. El consumo de energía del enlace de 1,6T de NVIDIA bajó de aproximadamente 30 vatios por enlace a 9 vatios.
En teoría, CPO parece ser la solución óptima. El problema es que existe una brecha entre la teoría y la producción a gran escala.
Una tasa de rendimiento del 9% revela la verdad
Durante la fabricación de CPO, el motor óptico se instala sobre el sustrato de encapsulado del ASIC mediante soldadura por reflujo (soldadura térmica). La precisión de alineación de las fibras ópticas alcanza el nivel submicrométrico. Si se desea reinstalar un motor óptico ya instalado, habría que recalentarlo de nuevo hasta 220-260°C; el punto de calentamiento está a varios milímetros del ASIC, y la precisión de alineación de las fibras no puede soportar el daño térmico de una segunda vez. En otras palabras, si uno de los 32 motores ópticos presenta un defecto, tanto el ASIC, el sustrato y todos los motores ópticos restantes tendrían que descartarse.
En su informe de investigación de junio de 2026 (Powered Down, Lights Off), SemiAnalysis asumió una tasa de implementación (yield) de 95% para cada motor óptico y calculó un yield compuesto de 0,9532≈0,1932. En otras palabras, bajo un modelo simplificado extremo en el que 32 motores ópticos son independientes entre sí y cada uno tiene un yield de 95%, la tasa combinada de que los 32 motores pasen es de aproximadamente 19,3%. Esto significa que solo una quinta parte de los motores puede funcionar correctamente. Esta cifra tuvo un impacto significativo en el mercado. El 9 de junio, en el mercado estadounidense, las acciones de Applied Optoelectronics (AAOI) cayeron cerca de 17% en un día, Lumentum bajó alrededor de 8%, Coherent alrededor de 11% y Marvell alrededor de 7,6%.
GlobalSemiResearch emitió de inmediato una declaración de réplica, señalando que ese análisis ignora las mejoras de rendimiento logradas por el filtrado, la clasificación (binning) y los motores redundantes diseñados por NVIDIA para Spectrum-X. Morgan Stanley también indicó en un informe del 10 de junio que no cuestiona la hoja de ruta técnica de CPO; simplemente redujo su pronóstico de envíos de motores ópticos para 2027 de 20 a 30 millones de unidades a 6 a 7 millones de unidades.
El foco de este debate no es “¿es malo el CPO?”, sino “¿cuándo y bajo qué nivel de escala puede usarse el CPO?”. SemiAnalysis ha retrasado el volumen de envíos de CPO para su ampliación horizontal hasta 2027 y también ha retrasado la producción a volumen completo hasta 2028-2029. Este ajuste de calendario abre una ventana para explorar otras arquitecturas.
NPO lo tiene todo cubierto
Los dispositivos ópticos cercanos al encapsulado (NPO) se sitúan entre los dispositivos ópticos de encapsulado (CPO) y los diseños enchufables. El motor óptico se monta en una placa de motor independiente, no en el sustrato de encapsulado del ASIC, y se encuentra muy cerca del ASIC. Cuando el enlace eléctrico es lo suficientemente corto y la pérdida lo suficientemente baja, se puede reducir e incluso eliminar, en parte de las arquitecturas, el DSP usado en los módulos ópticos enchufables tradicionales para compensar las pérdidas del enlace eléctrico a larga distancia. Sin embargo, una diferencia clave frente a CPO es que el motor se conecta mediante un zócalo y puede intercambiarse in situ.
El 10 de agosto, SemiAnalysis resumió en el foro X-thread tres ventajas de NPO: mantenimiento in situ, la propagación de fallas (área afectada) queda limitada a un solo zócalo y el proceso de ensamblaje se simplifica gracias a que el motor óptico y el ASIC usan encapsulados independientes. Esta estructura evita desafíos en producción y confiabilidad, a la vez que conserva la mayor parte de las ventajas de rendimiento del CPO.
En la exhibición OFC de marzo de 2026, Broadcom lanzó su línea de productos NPO basada en 3,2T VCSEL. Según el blog de la empresa, la eficiencia energética del motor NPO es de aproximadamente 1 pJ/bit; frente al método de fotónica de silicio con eficiencia energética típica de 5 a 10 pJ/bit, la eficiencia mejora de 5 a 10 veces. Después de desplegar 18 motores, la densidad de ancho de banda de escape supera 0,6 Tbps/mm y el ancho de banda de escape total alcanza 73,7 Tbps (128 Gbps /canal). El VCSEL cuenta con décadas de experiencia en producción masiva, y su tasa de fallas validada en campo (FIT) es inferior a 0,1.
Los engranajes de la estandarización y la producción a gran escala empiezan a girar
Aunque se tenga una arquitectura sobresaliente, no se puede lograr una adopción amplia sin el apoyo del ecosistema. El 12 de marzo de 2026, coincidiendo con la celebración de la conferencia OFC, seis empresas—Ciena, Coherent, Marvell, Molex, Samtec y TeraHop—firmaron conjuntamente el Open CPX MSA (acuerdo multifuente de encapsulado de interconexión). Este acuerdo pretende establecer especificaciones comunes para las interfaces enchufables de motores ópticos que cubran NPO y CPO. Esto estandariza la estructura mecánica de los conectores, el diseño térmico, el arreglo de pines eléctricos y las interfaces de gestión, asegurando así la interoperabilidad entre productos de diferentes fabricantes.
El CEO de LightCounting, Vladimir Kozlov, al anunciar el lanzamiento de la compañía, dijo: “Se prevé que el volumen de envíos anual superará los 100 millones de unidades en cinco años”, mientras que se espera que para 2025 el volumen de envíos de CPO/NPO sea inferior a 1 millón de unidades. Sin estandarización, un crecimiento tan grande (incluso más de 100 veces) no sería posible.
La demanda también sigue cambiando. En un seminario web de IPEC celebrado en mayo de 2026, Alibaba reveló su plan para completar las pruebas beta de su NPO 3,2T y comenzar operaciones piloto en el tercer trimestre de ese mismo año. Su objetivo es finalizar la depuración a nivel de sistema de muestras alpha de NPO 6,4T antes de septiembre de 2027. Tencent también ya completó la validación de su NPO 3,2T con VCSEL y de su NPO de fotónica de silicio, y planea realizar despliegues piloto en el cuarto trimestre de 2026. Ranovus ha entregado módulos NPO a empresas de nube en EE. UU., pero se espera que espere hasta la feria OFC de 2027 para anunciarlo oficialmente.
En la cadena de suministro, la tecnología de interconexión de Foxconn comenzó en mayo de 2025 a producir a gran escala para Broadcom los zócalos sin soldadura LGA-to-LGA de Bailly y las jaulas de fuentes de láser enchufables. Los láseres se diseñan principalmente para colocarse fuera del encapsulado, ya sea en CPO o NPO, mientras que el estándar ELSFP (módulo de láser externo enchufable en caliente) definido por OIF en agosto de 2023 sirve como base común.
¿Por qué el CPO de Nvidia presenta características de NPO?
El switch de conmutación NVIDIA Quantum-X Photonics InfiniBand ya ha anunciado el inicio de despliegues en producción masiva. Ofrece 144 puertos de 800G, con 18 motores de fotónica de silicio y 18 módulos externos de láser desmontables para proporcionar la fuente de luz. NVIDIA lo denomina “CPO”.
Sin embargo, el motor puede desmontarse fácilmente del encapsulado y el láser puede deslizarse desde el panel frontal; ahí es precisamente donde SemiAnalysis ve la ventaja de mantenibilidad de NPO. Un informe de investigación de LightCounting en julio de 2026 confirma la opinión general de la industria de que CPO y NPO coexistirán, y señala que si NVIDIA adopta NPO como una opción, el ciclo de desarrollo se acortará y, como muy pronto, el próximo año podrían verse despliegues iniciales.
Broadcom implementará en paralelo ambas arquitecturas. El switch de 51,2T Bailly CPO ya se encuentra en producción masiva en Micas Networks desde 2024. El switch de 102,4T Tomahawk 6 Davisson comenzó a enviar a clientes en octubre de 2025. Además, Broadcom proporcionará por separado un switch NPO de 3,2T VCSEL para satisfacer a los clientes que necesitan switches de alta densidad pero no quieren realizar soldaduras.
La validación de confiabilidad de Meta también avanza de manera constante. En el entorno de laboratorio de altas temperaturas de Meta, el sistema CPO de Broadcom registró cero jitter de enlace (interrupciones instantáneas) durante un funcionamiento acumulado de 1 millón de horas (equivalente a 400G de tiempo de puerto). Broadcom anunció este resultado en octubre de 2025 y publicó los detalles en el mismo año en ECOC y en 2026 en OFC. En OFC 2026, Meta propuso que para que la tecnología óptica resulte atractiva debe igualar o superar las soluciones eléctricas en términos de costo y eficiencia energética, manteniendo a la vez confiabilidad y rendimiento.
COUPLE de TSMC desempeña un papel clave
El final de la “fase de transición” de NPO depende en gran medida del avance de la plataforma de TSMC COUPE (motor óptico universal compacto).
Como se mencionó anteriormente, se sabe que la capacidad de cómputo de los chips de IA ya es extremadamente potente; sin embargo, cuando los datos se transmiten entre chips, todavía se depende de la conducción por cables de cobre. La velocidad y el consumo energético de la transmisión por cobre no siguen, de manera gradual, el ritmo de crecimiento del cómputo. La idea central de COUPE es cambiar a señales ópticas para transmitir datos y trasladar la conversión electro-óptica desde los módulos ópticos del extremo remoto hacia el interior del encapsulado del chip, reduciendo drásticamente la distancia por la que la señal tiene que recorrer un camino inevitablemente eléctrico.
COUPE integra dos tipos de chips: uno encargado de procesar señales eléctricas (chip electrónico EIC) y otro de procesar señales ópticas (chip fotónico PIC). Ambos se apilan directamente de arriba a abajo mediante la tecnología de apilamiento 3D de TSMC, para conectarse cara a cara y evitar las pérdidas por desvío de señales a través del circuito de la placa en soluciones tradicionales.
Taiwan Semiconductor Manufacturing Co. (TSMC) señala que, en comparación con las soluciones enchufables en placas, al integrar directamente el motor óptico COUPE en el sustrato de encapsulado se puede lograr una eficiencia energética 4 veces mayor y reducir el retardo en un 90%; si además se coloca el COUPE en una capa intermedia (Interposer), el rendimiento puede elevarse hasta 10 veces en eficiencia energética y reducir el retardo en un 95%.
La tecnología COUPE utiliza un apilamiento tipo SOIC para apilar directamente el chip electrónico y el chip fotónico, reduciendo al máximo la impedancia entre chips. La primera generación de COUPE enchufable entrará en producción en masa en 2026. La segunda generación de COUPE usa un encapsulado CPO de 6,4T y se espera que entre en producción masiva alrededor de 2027. El producto de tercera generación integrará completamente los componentes ópticos dentro del encapsulado del procesador.
El mapa de ruta de densidad de ancho de banda del COUPE de TSMC predice que, en cuatro años, la densidad de ancho de banda aumentará ocho veces: de 0,5 Tbps/mm en 2026 a 4 Tbps/mm en 2030. Si este plan se concreta, la función de NPO se limitará a un periodo de transición de solo dos a tres años.
Sin embargo, si el escenario de producción masiva completa en 2029 que predice SemiAnalysis se acerca a la realidad, NPO seguirá satisfaciendo la demanda del mercado hasta finales de la década de 2020. En ese caso, esto supondría una presión adicional para la cadena de suministro de fotónica, que ya está ajustada en cuanto a capacidad de láseres y encapsulados. En la cumbre OCP Asia Pacífico, Nicole Tien de JN (ASE) indicó que actualmente no existen estándares de prueba a nivel de oblea ni infraestructura de simulación para expandir CPO a un mercado de múltiples fabricantes. La producción masiva de CPO de NVIDIA es el resultado de una investigación y desarrollo de colaboración bilateral profunda con TSMC; aún no se cuenta con las condiciones para llevar esos logros a toda la industria.
En la industria se considera ampliamente que la forma definitiva de las interconexiones ópticas es el CPO. El problema es: ¿quién elegirá esa ruta, cuándo se logrará y cómo se escalará? Al menos, según las rutas de producto actuales y la situación de validación con clientes, NPO está pasando rápidamente de la validación tecnológica al despliegue a escala, convirtiéndose en una respuesta más segura.