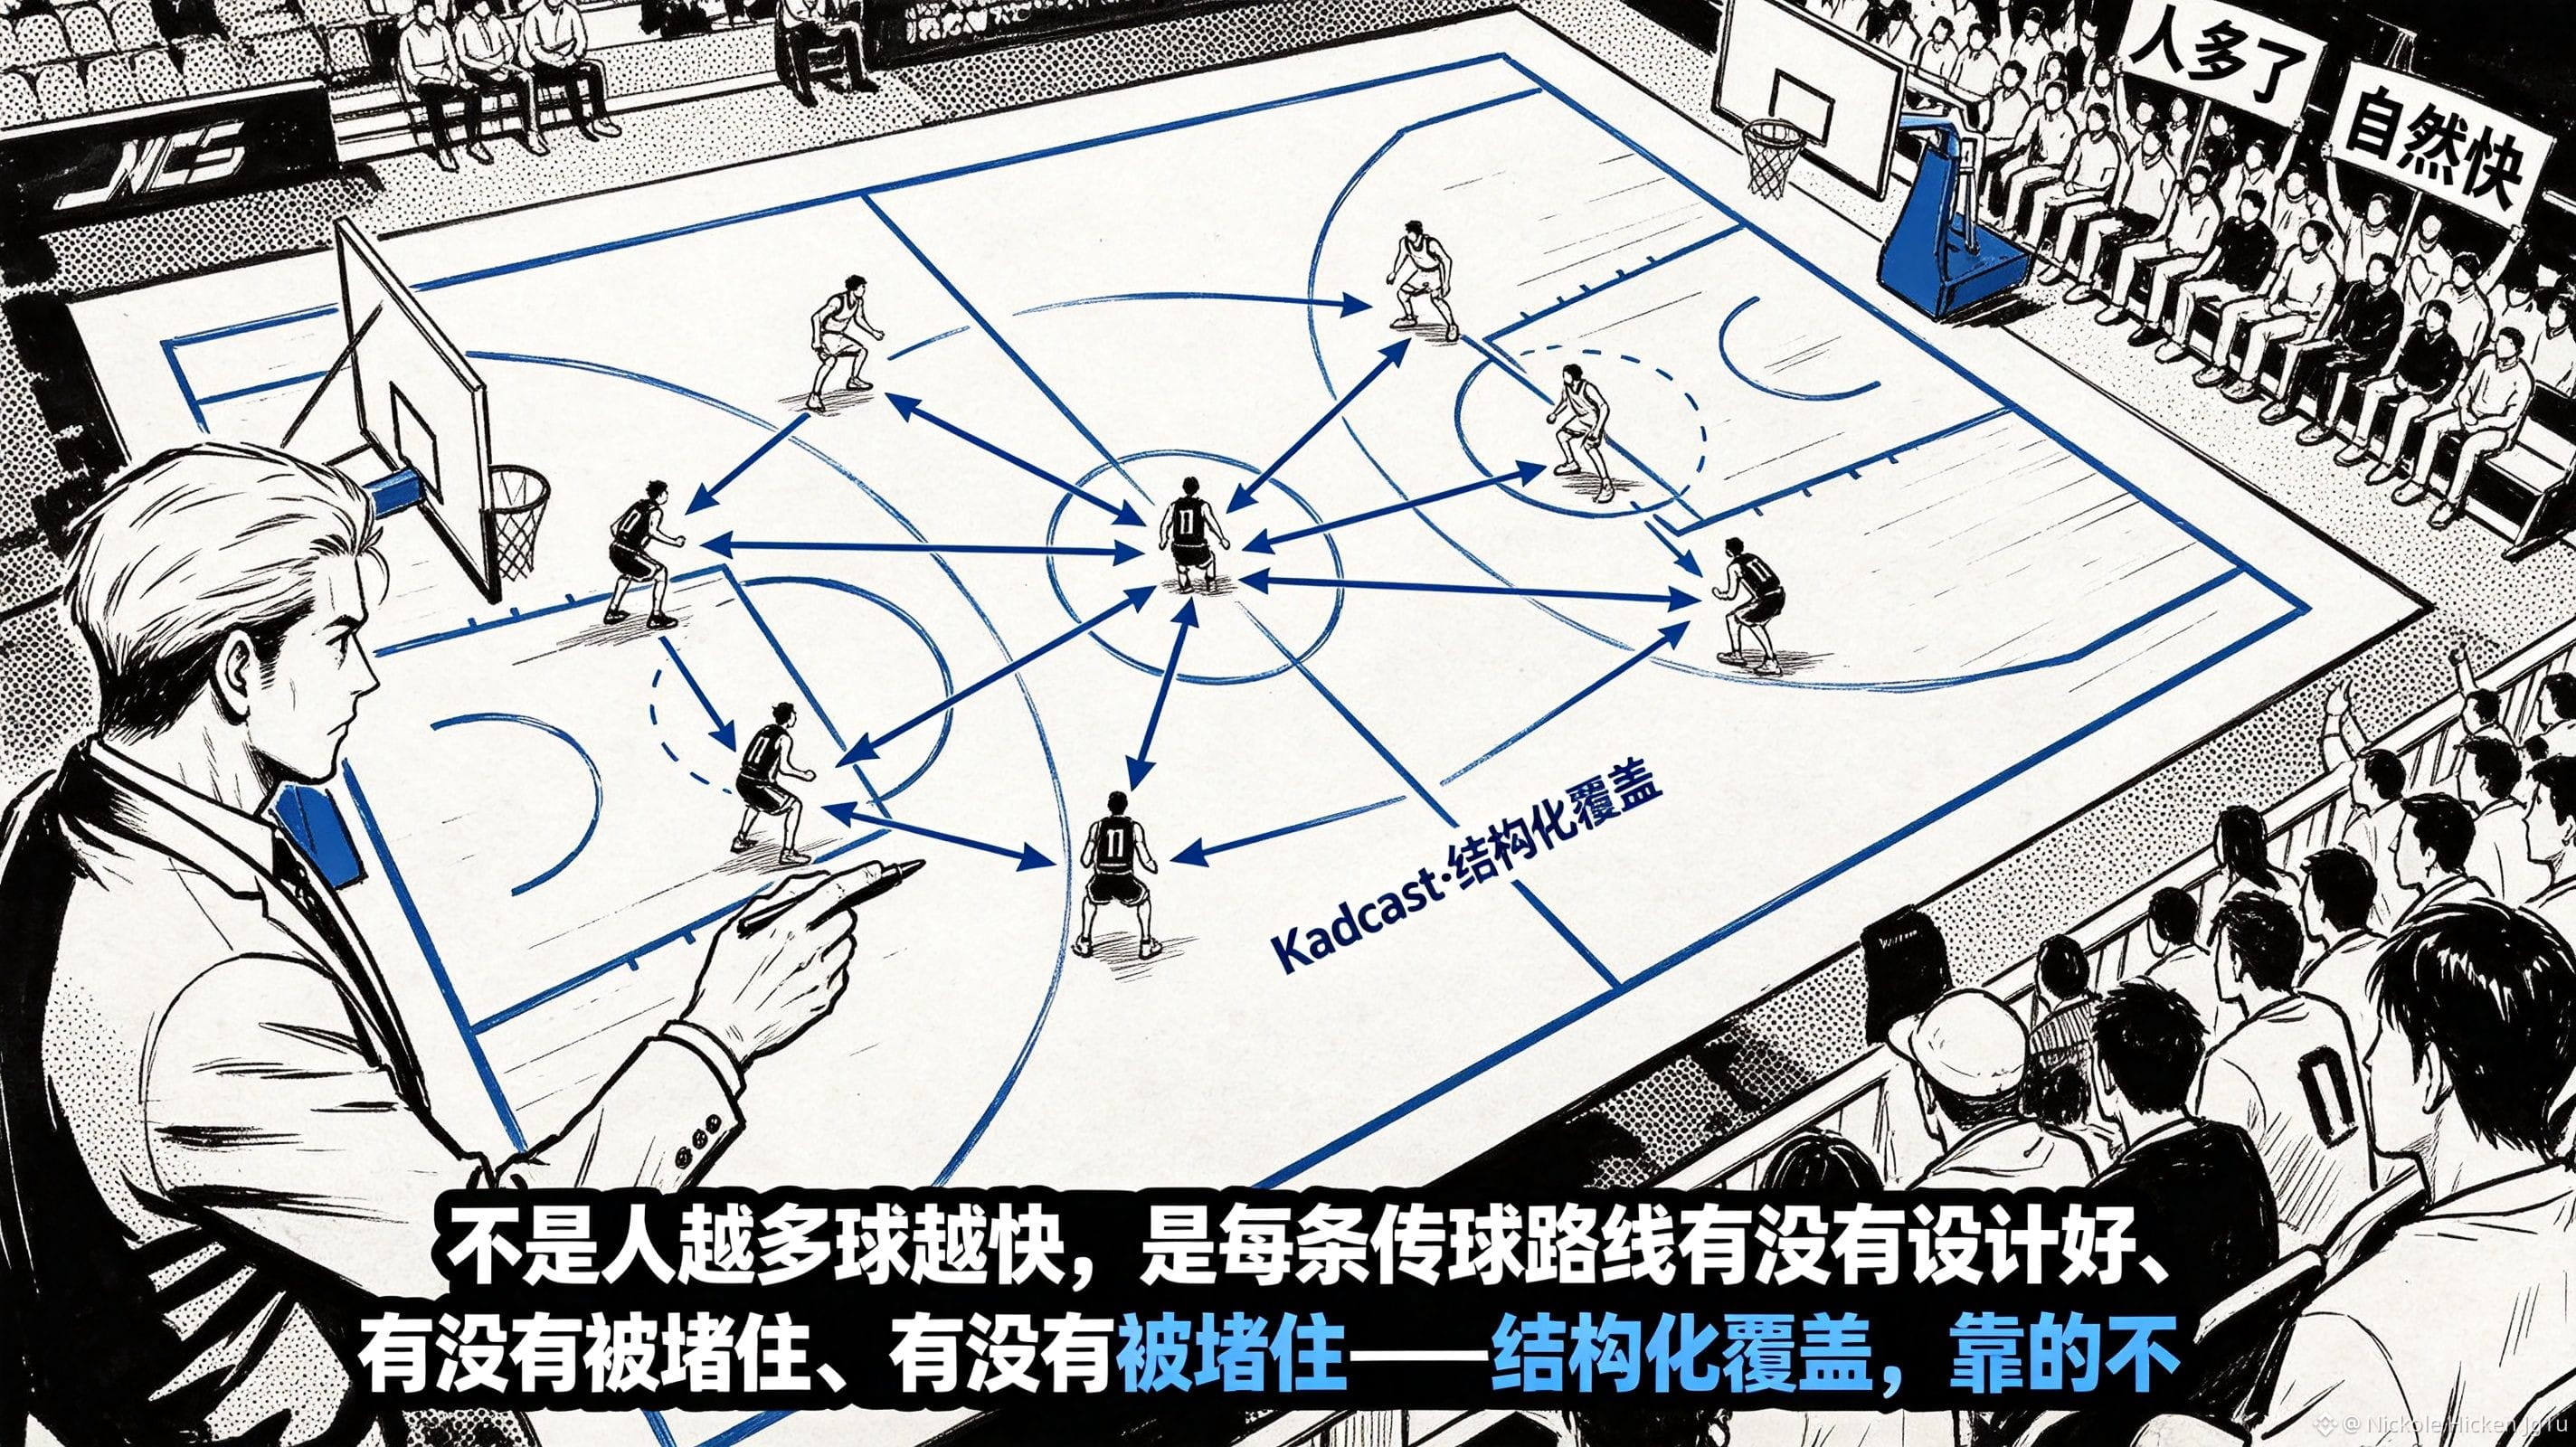
@Dusk Mucha gente dice que las redes P2P solo se vuelven más rápidas si hay suficientes nodos, pero nunca he confiado del todo en esa afirmación. Hasta que leí los $DUSK Core Components, noté que Kadcast no utiliza gossip aleatorio, sino un overlay estructurado: su objetivo es reducir el consumo de ancho de banda y hacer que la latencia sea más predecible. Esta elección me hizo cambiar de opinión. La eficiencia de la red no depende únicamente de la cantidad de nodos, sino también de qué relaciones de conexión sigue un mensaje para llegar al objetivo.
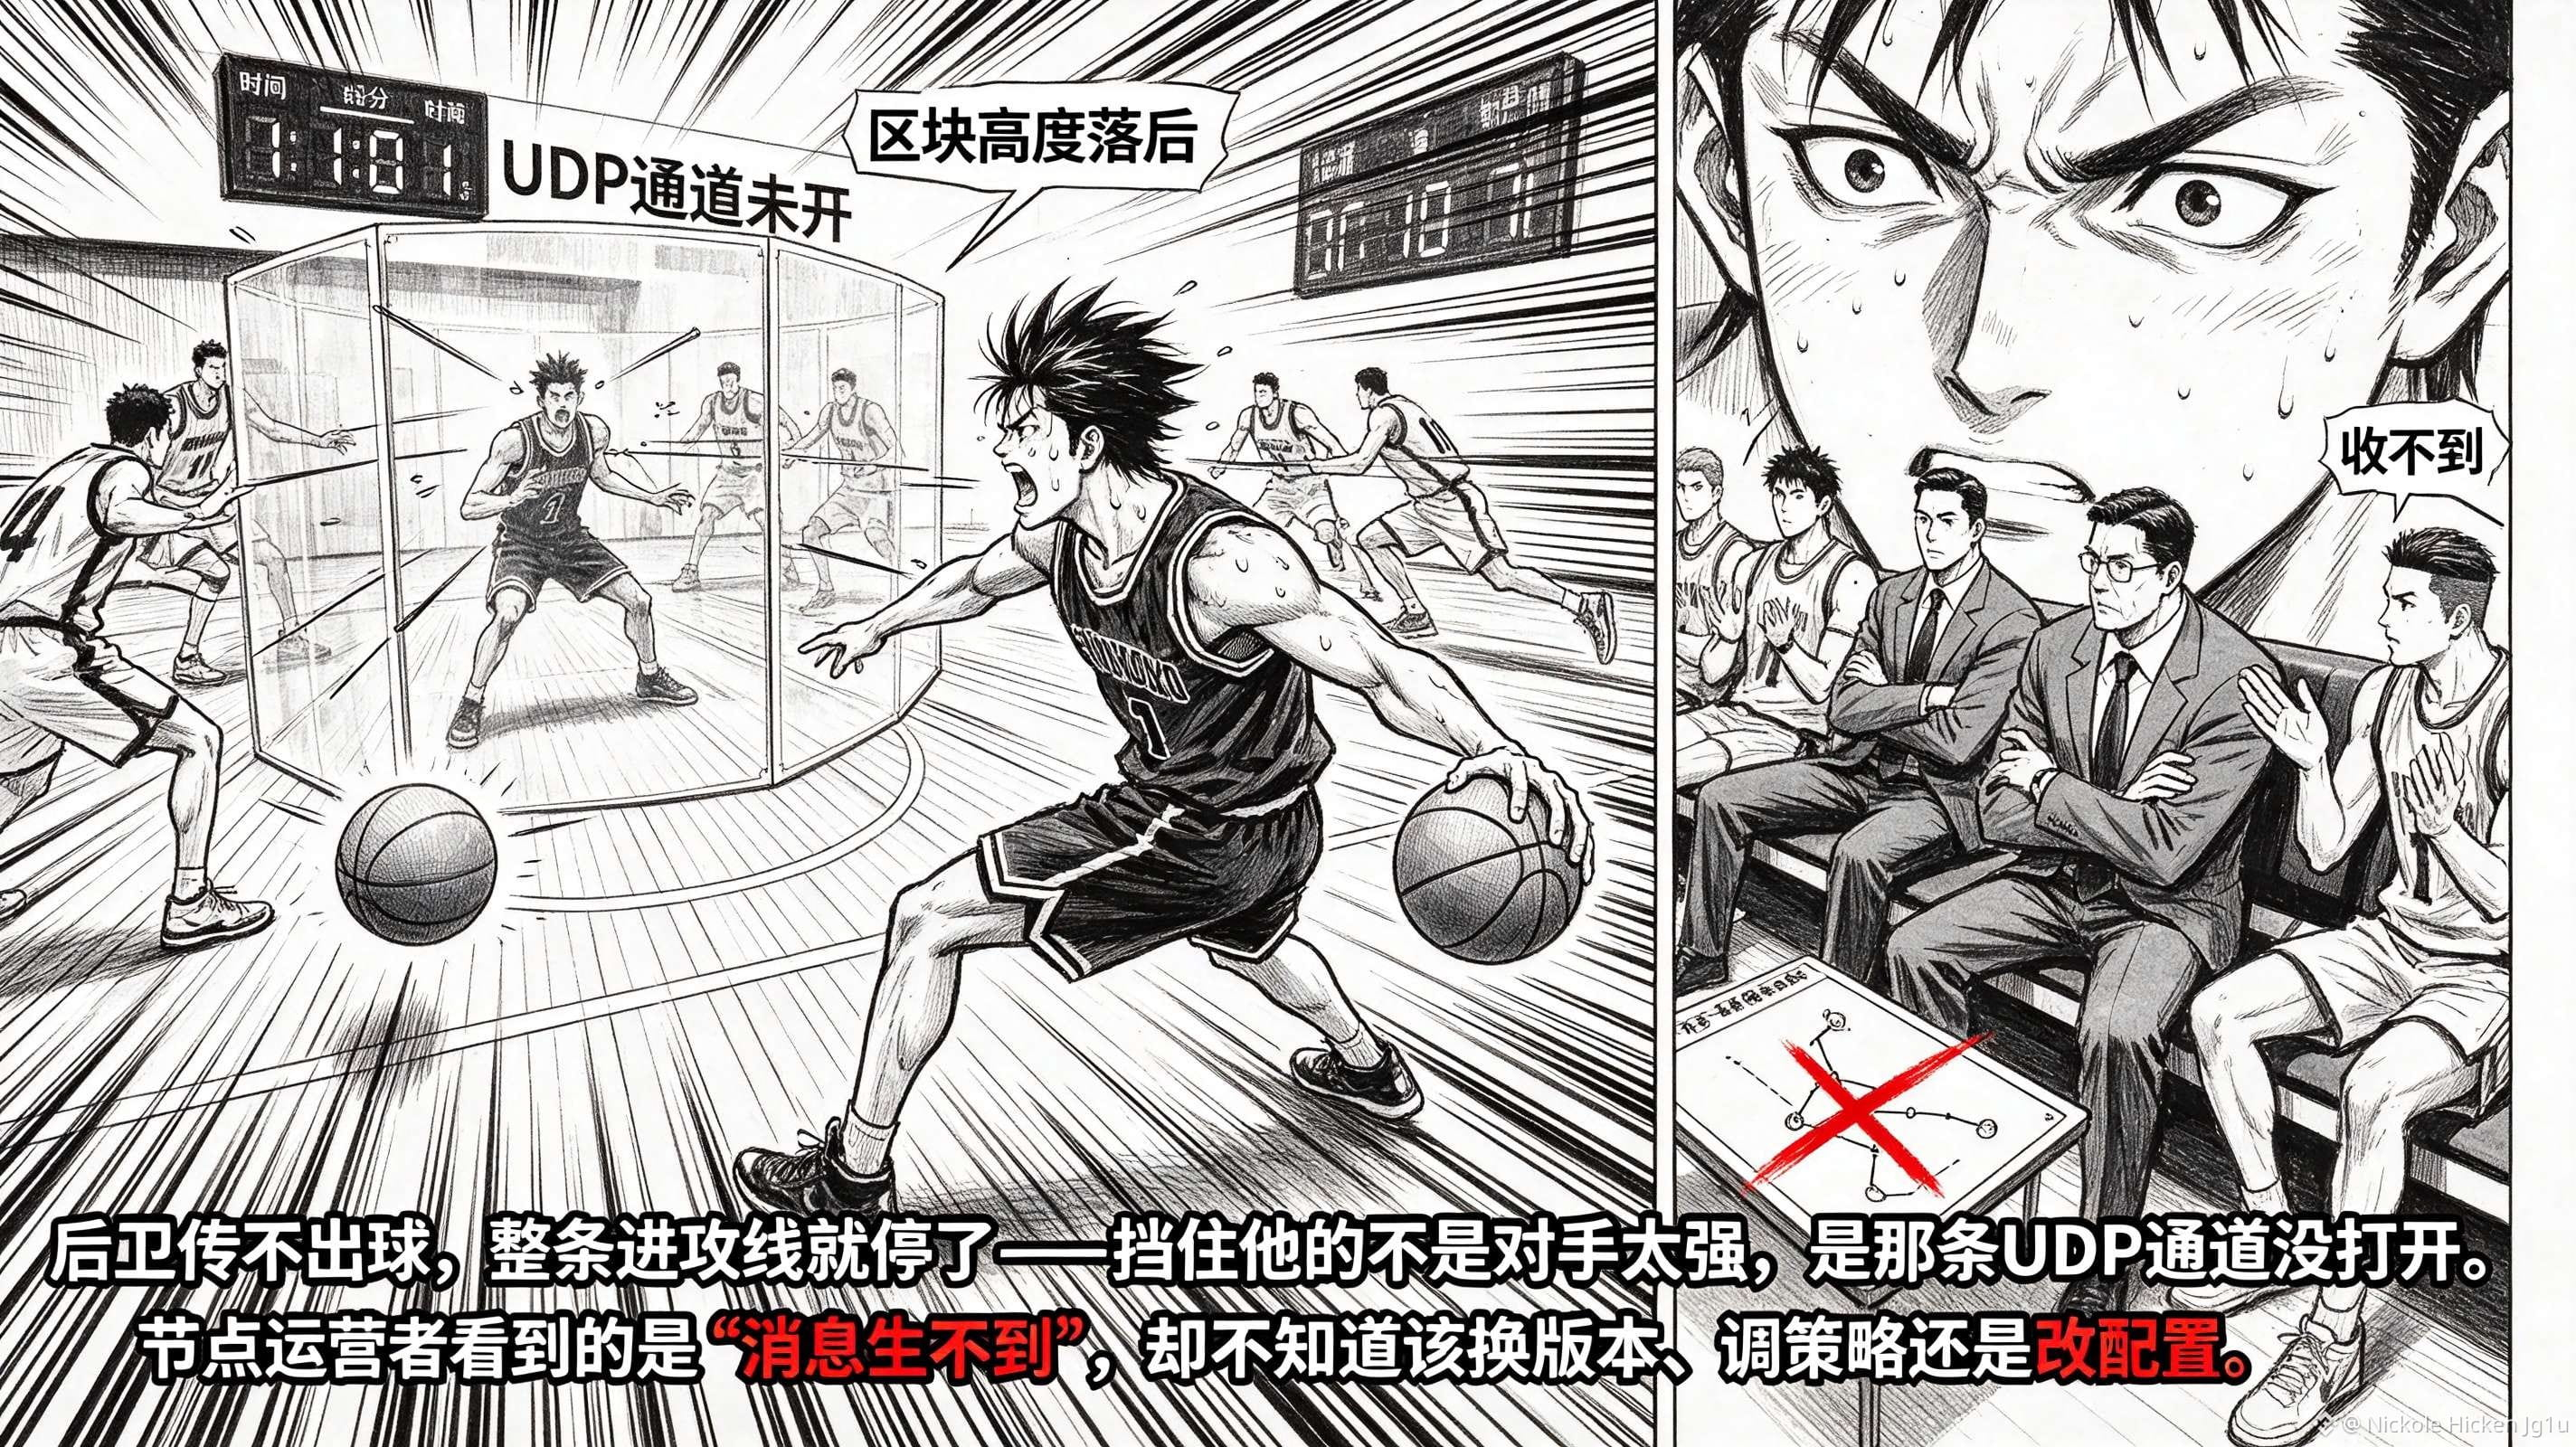
Para los operadores de nodos, esto no es un concepto abstracto. Cuando las rutas son más estructuradas, los nodos dependen aún más de la calidad del descubrimiento de vecinos y de la conectividad de la red. Y en cuanto el entorno de operación bloquea los canales UDP o las direcciones de Kadcast, en teoría la latencia predecible no se convierte automáticamente en un rendimiento de red realmente utilizable. Lo que el operador ve puede ser simplemente que los mensajes no llegan o que los bloques van atrasados; pero aun así tiene que decidir por su cuenta si es un problema de versión, de estrategia de red o una configuración que salió mal.
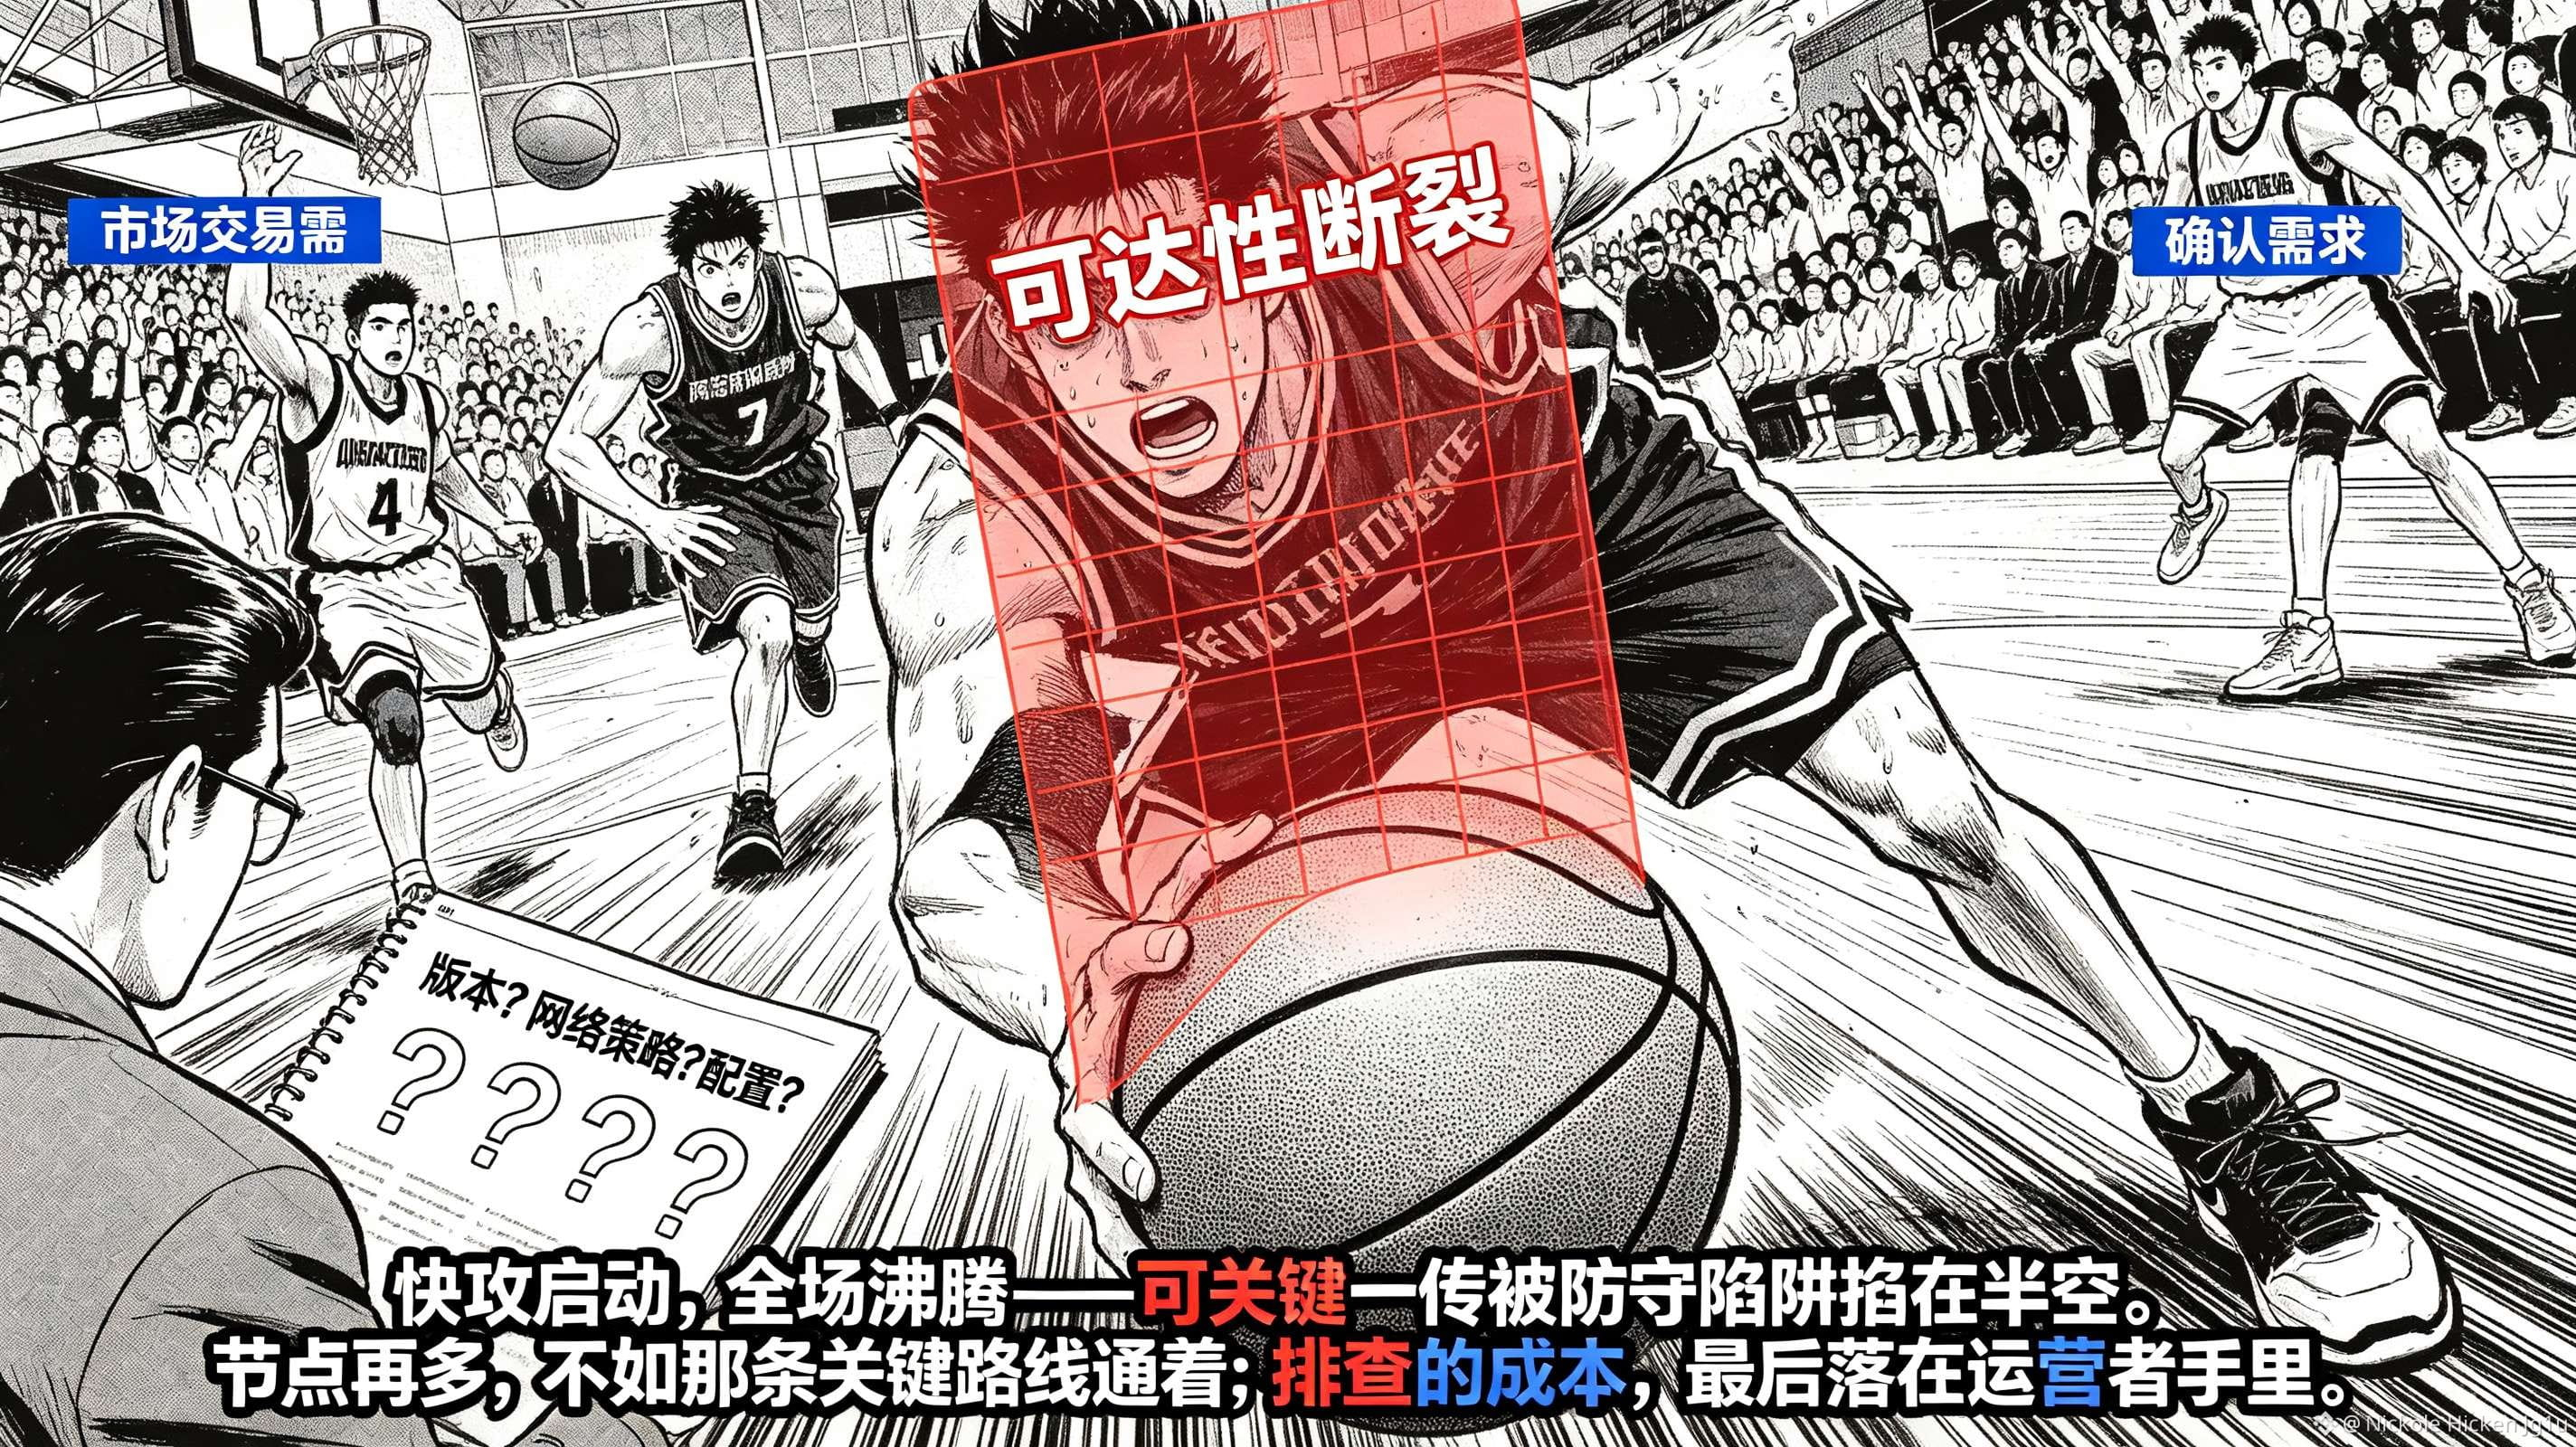
Los escenarios de presión también son muy concretos. Cuando aumentan las actividades del mercado, la aplicación espera que las transacciones se confirmen más rápido, pero algún nodo clave queda bloqueado por un firewall. Este sistema no es tan simple como “cuantos más nodos, más seguro”. La capacidad de acceso/reachability de los nodos también puede determinar si los mensajes pueden propagarse como se diseñó, y el costo de la depuración termina recayendo en la persona que opera los nodos. Por eso, cuando hoy evalúo el rendimiento de la red de DUSK, no solo observo el tiempo de los bloques ni la cantidad de nodos: también quiero verificar las relaciones de vecinos de Kadcast, los puertos de comunicación y si los nodos atrasados tienen señales de monitoreo intuitivas con las que guiarse. @Dusk eligió la propagación estructurada; que pueda entregar esa previsibilidad de verdad a los operadores es precisamente la parte que la red #dusk necesita demostrar.