


Título original: (Después del cierre de una empresa, ¿cómo ganar dinero vendiendo datos de los empleados)
Autor del texto original: Observación Beating
Correos, chats, documentación de proyectos, tickets de soporte: antes, solo eran un “legado digital” que la empresa cerrada guardaba mientras se encargaba de limpiarlo. Ahora, empiezan a revalorizarse, empaquetarse, venderse y enviarse a los pipelines de entrenamiento de empresas de IA.
Un preparador funerario vela por que los muertos conserven el último decoro. El decoro después de la muerte de una empresa es demostrar que lo que dejó atrás aún tiene valor.
El 17 de agosto, en una subasta de activos en quiebra, Google ofertó 10 millones de dólares y compró todos los datos empresariales de Spirit Airlines. Había otro postor, llamado Mercor, que ofertó 7,5 millones; perdió por 2,5 millones.
El lote se dividió en tres partes. La primera, unos 100 millones de correos electrónicos de empleados. La segunda, 500 millones de mensajes de Microsoft Teams. Entre ambas, 600 millones de registros. La tercera, calendarios, hojas de cálculo, bases de datos financieras, archivos de proyectos, registros operativos y un conjunto de software interno. Los expedientes de pasajeros y la información de viajeros frecuentes no estaban incluidos.
600 millones de mensajes: si una persona dijera 100 frases al día, tendría que hablar sin parar durante más de 16.000 años.
Si se calcula, un mensaje se vendió por 1,67 centavos. Los estadounidenses llaman penny a la moneda de 1 centavo, y ni siquiera se molestan en recogerla del suelo. Es decir, una frase que un empleado de Spirit dijo en Teams vale un centavo y medio.
Volvamos a 1980: Spirit Airlines nació en Detroit, con origen en una empresa de camiones llamada Charter One, que después se reconvirtió en aerolínea. En 1992 cambió su nombre a Spirit, que significa alma. Desde entonces, durante 34 años, convirtió el modelo de la aviación ultrabarata estadounidense en un referente que toda la industria imitó.
Su base no era pequeña: 205 aviones, todos Airbus, unos 300 vuelos al día, e ingresos de unos 5.000 millones de dólares en 2024. Pero ese mismo año registró una pérdida neta de unos 1.200 millones y, cuando pidió la quiebra, arrastraba una deuda de unos 9.000 millones.
Una noche de mayo de 2026, la empresa anunció la suspensión de vuelos. Al día siguiente, unos 17.000 empleados se enteraron por las noticias de que habían perdido su trabajo.
El proceso todavía seguía su curso, y la transacción debía esperar la aprobación del juez de quiebras. Spirit siguió un cierre de liquidación bajo el Capítulo 11, sin que un administrador concursal asumiera el control; la propia empresa, bajo supervisión judicial, fue vendiendo uno por uno los activos que le quedaban. Los datos sensibles, como correos de empleados y mensajes de Teams, primero tenían que ser tratados por una entidad independiente para borrar nombres, correos y otra información que permitiera identificar a las personas; esa entidad fue elegida por Google y los costes también corrieron a cargo de Google.
Además, revisando los reportajes públicos, no se encuentra ningún precedente de que una empresa en quiebra vendiera sus datos internos a una empresa de IA. Esta operación probablemente sea la primera de la historia.
El veterano medio tecnológico estadounidense Gizmodo tituló así esta transacción: Spirit murió, pero sus datos vagarán por generaciones en los servidores de Google.
Un nuevo negocio
Siempre ha habido gente que se encarga de recoger los cadáveres de las empresas muertas. Abogados, liquidadores, casas de subastas: llevan décadas haciéndolo. Aviones, sillas, marcas, patentes; todo lo que se podía vender ya se vendió hace tiempo.
Lo verdaderamente nuevo es que, desde este año, incluso los datos internos de los empleados de una empresa se han puesto a la venta.
Que este negocio haya surgido responde a dos razones.
La primera cosa es que hay más empresas muertas.
En el primer trimestre de 2024, la tasa de fracaso de las startups estadounidenses subió un 58% interanual, y el número de firmas activas de capital riesgo fue un 62% menor que en el pico.
En realidad el dinero no ha disminuido, solo se ha concentrado cada vez más en la IA. En 2024, las startups de IA en Estados Unidos absorbieron 97.000 millones de dólares de financiación, un récord histórico. En los mercados de capital sigue habiendo dinero, pero cada vez hay menos voluntad de gastarlo en algo que no sea IA.
El resultado fue que un lote de empresas que antes aún podían seguir viviendo gracias a la financiación empezó a chocar con el muro antes de tiempo. En agosto de 2024, la fintech Tally, respaldada por a16z, anunció su cierre. Había levantado en total 172 millones de dólares, alcanzado una valoración máxima de 855 millones, llegado hasta la Serie D y, aun así, no logró conseguir la siguiente ronda.
La segunda cosa es que los datos se han encarecido.
El consumo de datos en el entrenamiento de modelos de gran escala ya ha alcanzado una magnitud descomunal. Los datos de entrenamiento de GPT-4 fueron de unos 13 billones de tokens. Como referencia, Google Books escaneó durante más de cuarenta años unos 40 millones de libros, lo que se traduce en unos 4 billones de tokens. Es decir, una sola ronda de entrenamiento de GPT-4 utilizó una cantidad de datos equivalente a más de tres veces Google Books.
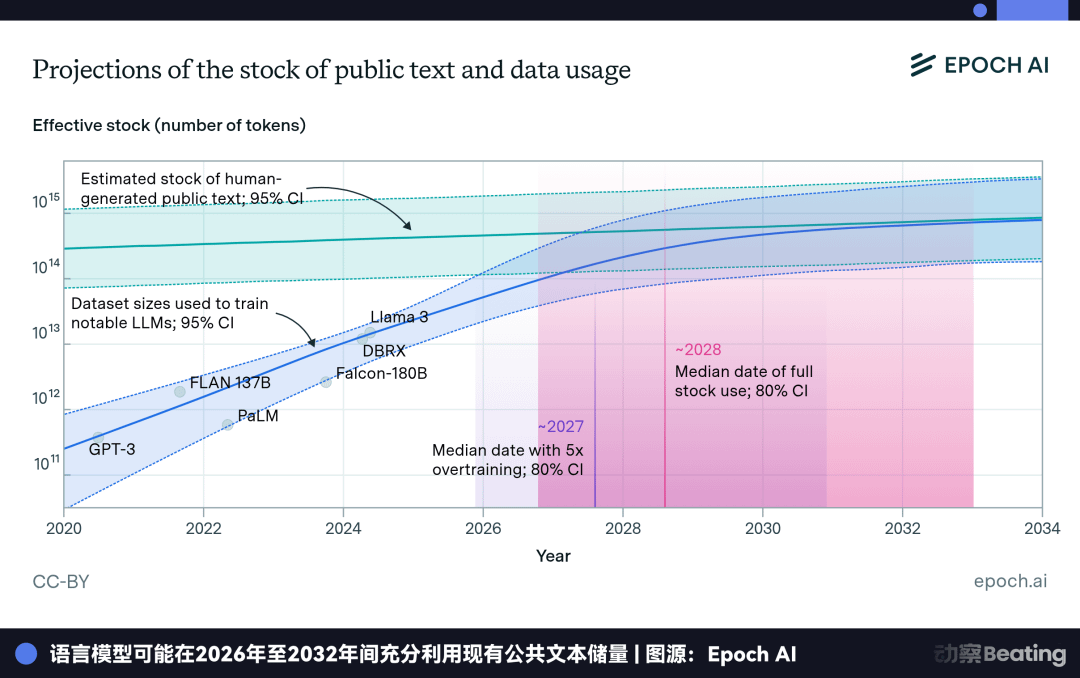
Epoch AI hizo un cálculo: los datos lingüísticos de alta calidad —libros, noticias, Wikipedia— se agotarán hacia 2026. El texto de alta calidad disponible en Internet para entrenar modelos se está agotando rápidamente, y la proporción de datos sintéticos es cada vez mayor. A partir de ahora, los nuevos datos que las empresas de IA buscan tendrán que salir cada vez más del Internet público. Los correos, chats y documentos de trabajo acumulados durante años en las empresas han entrado así en el radar.
Y el mercado de conjuntos de datos para entrenamiento de IA, según estimaciones de instituciones de investigación, podría alcanzar los 9.700 millones de dólares en 2030. Si se incluyen todo tipo de licencias, el tamaño total del pastel podría llegar a 67.500 millones de dólares.
Por un lado, cada vez más empresas entran en procesos de cierre y liquidación, dejando tras de sí una gran cantidad de datos internos que antes no tenían precio; por otro, la demanda de datos fuera del Internet público por parte de las empresas de IA no deja de crecer. La aparición simultánea de ambos factores es lo que, por primera vez, ha dado a los datos internos de empresa la posibilidad de negociarse a gran escala.
Lo que realmente ha aumentado el valor de este tipo de datos es el desarrollo de los agentes empresariales. Gartner prevé que, para 2026, el 40% de las aplicaciones empresariales incorporarán agentes de IA orientados a tareas, cuando el año anterior esa proporción era inferior al 5%.
Los materiales de entrenamiento que necesita un agente empresarial no son exactamente los mismos que los de un modelo grande normal. Las páginas web públicas pueden proporcionar conocimiento, lenguaje y contenido terminado, pero es difícil reconstruir el proceso real de trabajo de una empresa. La comunicación y la colaboración, llevadas a la práctica, incluyen muchos detalles reales: cómo se plantea un requisito, cómo lo discuten varias personas, cómo se asignan las tareas, cómo se corrige un problema y cómo se entrega finalmente.
Estos procesos quedan almacenados en gran medida en los correos, chats, tickets y documentos de proyecto internos de la empresa.
Cuando este tipo de datos empieza a tener compradores y usos claros, aquello que antes se borraba directamente al cerrar una empresa pasa a tener valor como una partida que puede venderse por separado.
recogedor de cadáveres
Antes, este trabajo lo hacían los abogados de liquidación; ahora hay tres tipos de personas más.
La primera se llama proveedor de disolución, y el representante es SimpleClosure.
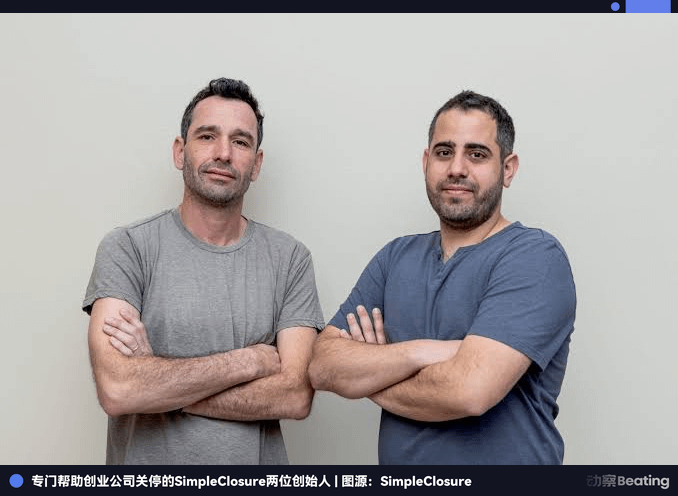
Esta empresa solo hace una cosa: ayudar a las startups a morir con dignidad. En 2023, cuando apenas empezaba, consiguió 1,5 millones de dólares en pre-seed; en mayo de 2025, obtuvo otros 15 millones en una ronda Serie A, liderada por TTV Capital. Incluso Carta, que gestiona capital y asuntos corporativos para muchas startups estadounidenses, suspendió su propio servicio de cierre, pasó a invertir en SimpleClosure y le entregó esa parte de la demanda de clientes.
En octubre de 2025, SimpleClosure ya había celebrado el funeral de más de mil empresas. Crunchbase le puso un nombre: «A Better Way To Fail», una mejor manera de fracasar. A los emprendedores estadounidenses les gusta decir fail fast, fracasar rápido. SimpleClosure dice que fracasar rápido no basta; además hay que hacerlo con dignidad. En su web incluso tiene una calculadora de precios: introduces la situación de la empresa y te calcula cuánto cuesta morir una vez.
Los funerales no eran gratis. En abril de 2026, SimpleClosure lanzó Asset Hub, dedicado a gestionar los activos intangibles que quedan tras el cierre de una empresa. Además de marca, software y listas de clientes, también aparecieron por primera vez en el escaparate los registros de Slack, los correos electrónicos y los tickets de Jira, ese tipo de datos internos de trabajo.
Esto demuestra que, antes de Spirit, el mercado ya había empezado a intentar poner precio a los datos internos de empresas muertas; solo que entonces se trataba de startups, transacciones pequeñas y acuerdos privados.
Hay un caso ya existente. Cuando cerró la empresa de transcripción y subtitulado cielo24, vendió a través de SimpleClosure los mensajes de Slack, los correos internos y los tickets de Jira acumulados durante 13 años. Más tarde, la CEO Shanna Johnson dijo a Forbes que este lote de datos acabó vendiéndose por cientos de miles de dólares.
Para una empresa que ya ha decidido echar el cierre, esto era originalmente un lote de datos que había que limpiar, pero al final se convirtió en un activo que podía recuperarse durante la liquidación.
La parte de la venta de datos la dejó SimpleClosure en manos de Protege. Se trata de un mercado de datos especializado en licencias de datos de entrenamiento para IA; en enero de 2026 acababa de levantar 30 millones de dólares liderados por a16z, y su fundador se llama Bobby Samuels. El primer nicho de Protege fue la imagen médica, y en 30 días logró reunir para el comprador varios millones de imágenes para el preentrenamiento.
Ahora, Protege está empezando a aplicar esta capacidad de licenciar y comercializar datos a las comunicaciones internas de empresas cerradas. SimpleClosure se encarga del cierre de la empresa y de organizar los activos; Protege, de encontrar compradores y completar la licitación y la transacción de los datos.
La segunda clase de participantes son los tribunales de quiebras y los abogados de liquidación. Durante décadas inventariaban aviones, sillas, marcas y patentes. Ahora, en la lista empiezan a aparecer correos electrónicos, registros de Slack y otros datos internos.
Según la ley de quiebras estadounidense, estos datos pueden incluirse como activos intangibles dentro de la masa concursal y venderse bajo supervisión del tribunal. Algunos despachos de abogados también han empezado a crear equipos especializados para gestionar la preservación, el descubrimiento y la organización de datos en casos de quiebra. Redgrave LLP tiene precisamente un área de reorganización y forensia para ello.
La tercera clase son los proveedores de e-discovery encargados de la ejecución técnica. Empresas como KLDiscovery, Epiq y Consilio ya se dedican habitualmente a recopilar, organizar, alojar y revisar datos empresariales. El contenido de correo, Teams y SharePoint primero debe ser exportado y archivado por ellos, y luego organizado en un paquete de datos que pueda entrar en el flujo de la transacción.
Este sector ya cuenta con un sistema de tarifas bastante maduro. EDRM publica periódicamente estudios de precios, y las unidades de cobro habituales incluyen la recopilación de datos por GB, el alojamiento por GB al mes y las tarifas de revisión documental.
Los 600 millones de mensajes de Spirit pudieron acabar convirtiéndose en un lote de subasta gracias precisamente a este tipo de trabajo básico. Pero, en comparación con los documentos judiciales y las ofertas de subasta, esa parte rara vez aparece en los reportajes públicos; quién la procesa y cómo la procesa, normalmente no se ve desde fuera.
Lista de autopsia
Para un agente empresarial, no solo necesita aprender conocimiento y respuestas correctas, sino también el juicio, la colaboración, la corrección de errores y el proceso de ejecución en un entorno de trabajo real.
El producto terminado le dice al modelo qué se consiguió al final; los registros internos le dicen cómo se consiguió exactamente.
Este cambio ya se refleja en los datos de entrenamiento para agentes. Antes, una muestra de entrenamiento de código podía tener solo unos pocos cientos de tokens, con contenido de unas pocas líneas modificadas; ahora, una muestra de entrenamiento para agentes suele tener que incluir el proceso completo de comprensión del requisito, localización de archivos, modificación del código y verificación con pruebas.
Los datos de entrenamiento están pasando de respuestas aisladas a registros completos de ejecución de tareas. Para un agente, el resultado final, por supuesto, importa, pero lo que más valor tiene para entrenarlo es el juicio, las operaciones y los comentarios que quedan durante la ejecución de la tarea.
En comparación con una empresa en funcionamiento normal, los datos de una compañía en cierre entran más fácilmente en el proceso de transacción. Mientras la empresa sigue operando, vender comunicaciones internas implica secretos comerciales, privacidad de los empleados, riesgos de competencia desleal y relaciones con clientes, por lo que el departamento legal y la dirección suelen ser muy prudentes. Una vez en liquidación, el objetivo principal de la empresa pasa a ser recuperar al máximo los activos restantes y conseguir más valor para los acreedores.
Por eso mismo, el mismo lote de datos internos, cuando la empresa está viva, es difícil de vender; pero cuando entra en fase de cierre, puede volver a valorarse como un activo.
El valor de los datos internos de la empresa ya había sido reconocido por el sector desde hace tiempo. Salesforce siempre ha considerado las comunicaciones empresariales acumuladas en Slack como un activo de datos importante, y Satya Nadella, CEO de Microsoft, también ha subrayado en múltiples ocasiones que, al usar IA en la empresa, la parte realmente valiosa son los datos propios y el contexto de trabajo.
En el pasado, estos datos servían principalmente a la propia empresa. Ahora, a medida que las empresas de IA empiezan a buscar activamente datos internos corporativos, por primera vez cuentan con compradores externos más claros.
El arte de fijar precios
Aunque este negocio apenas empieza a formarse, ya han aparecido algunos precios de referencia en el mercado.
Los datos de startups cerradas que gestionan SimpleClosure y Protege suelen cerrar en transacciones de entre 10.000 y 100.000 dólares. Las ofertas que Mercor hace por los chats y correos de empleados de startups adquiridas pueden llegar hasta los 300.000 dólares.
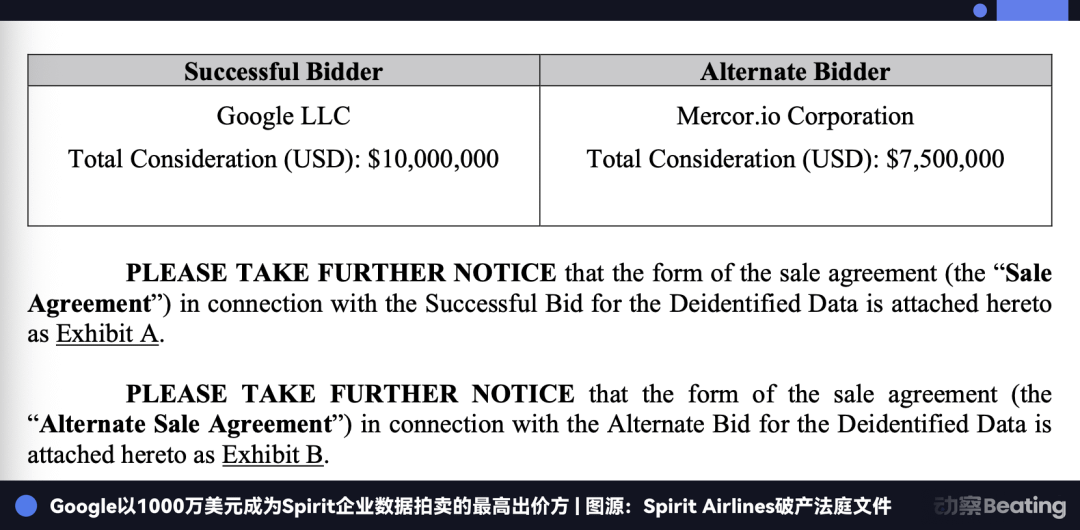
Spirit elevó el precio de golpe a la escala de los millones. Mercor ofertó 7,5 millones de dólares y Google acabó ofreciendo 10 millones, disputándose unos 600 millones de comunicaciones internas y otros datos empresariales. Solo calculando esos 600 millones de mensajes, sale un promedio de unos 1,67 centavos por mensaje.
El precio unitario no es alto. Reuters informó en 2024 que Photobucket había llevado unos 13.000 millones de fotos y vídeos a conversaciones de licencias con empresas de IA; las fotos se cotizaban aproximadamente entre 5 centavos y 1 dólar cada una, y los vídeos por encima de 1 dólar por pieza. En el mercado de datos B2B, una sola información de contacto también puede venderse por unos pocos centavos o por varios dólares, según su completitud y exactitud.
Pero estos precios aún no bastan para formar un estándar unificado. Cuánto valen exactamente los datos internos de una empresa en cierre sigue siendo, sobre todo, una cuestión caso por caso. El volumen de datos, el sector, el alcance temporal, la integridad, la singularidad y el uso que planea darle el comprador influyen en la oferta final. Los 10 millones de dólares de Spirit son más bien una de las pocas muestras grandes visibles públicamente por ahora.
Si se compara con un mercado de licencias de datos ya maduro, la diferencia es aún más clara. Reddit licencia publicaciones y comentarios de usuarios a Google por unos 60 millones de dólares al año; el acuerdo de licencias de contenido entre News Corp y OpenAI ronda los 250 millones de dólares a cinco años; la colaboración entre xAI y Telegram alcanza los 300 millones de dólares; y la compra de licencias de imágenes de Shutterstock por parte de Apple se sitúa entre 25 y 50 millones de dólares.
Estos mercados ya tienen compradores estables, formas de licenciamiento y experiencia en fijación de precios. La compraventa de datos internos de empresas en cierre apenas está empezando; qué datos valen más, si conviene valorar por mensaje, por volumen o por paquete completo, todavía no tiene reglas claras.
Los 10 millones de dólares de Spirit, vistos dentro del tamaño de la propia empresa, son otra historia. En 2024, los ingresos anuales de Spirit rozaron los 5.000 millones de dólares, lo que equivale a unos 13,7 millones al día de media. El dinero que Google pagó por estos datos fue menos que lo que la empresa ingresaba en un solo día cuando operaba con normalidad.
Para la liquidación concursal, esto no es más que una recuperación más dentro de los activos sobrantes; para las empresas de IA, en cambio, lo que compran es un lote de datos que no se había hecho público durante mucho tiempo y que contiene procesos reales de funcionamiento empresarial.
Limpieza y transferencia
Una vez cerrada la venta de datos, no pueden entregarse directamente al comprador. Antes de la transferencia formal, normalmente hay que pasar por varios pasos: exportación, desidentificación, organización y empaquetado, aprobación judicial y entrega final.
El primer paso es la exportación. Los datos empresariales de Slack suelen exportarse en un archivo ZIP, que incluye archivos JSON organizados por canal, información de miembros y adjuntos.
Microsoft 365, por su parte, puede exportar correos y mensajes de Teams mediante herramientas de forensia. Spirit implica unas 600 millones de comunicaciones internas, una cantidad enorme, por lo que en la práctica hay que procesarlas en lotes. Si lo hará un proveedor de e-discovery o el equipo de ingeniería del comprador, los documentos públicos no lo han revelado.
A continuación viene la desidentificación, es decir, eliminar en la medida de lo posible la información que pueda señalar a empleados concretos. Los métodos habituales incluyen identificar y ocultar nombres, teléfonos, direcciones y otros datos personales, o sustituir campos sensibles por números que no puedan vincularse directamente con una persona. En algunos escenarios de estadística y entrenamiento, además se añade ruido aleatorio para reducir aún más la posibilidad de reidentificación.
Pero desidentificar no equivale a anonimato absoluto. Aunque ya se hayan eliminado el nombre y el correo electrónico, mientras el texto conserve suficientes rasgos profesionales, temporales, geográficos o de comportamiento, sigue existiendo la posibilidad de reidentificar a la persona a través de otra información.
Por eso, en esta operación de Spirit, importa mucho quién se encarga de este paso. Según el acuerdo actual, los datos serán desidentificados por un tercero independiente, pero esa entidad ha sido elegida por Google y los costes también correrán a cargo de Google. Google también se compromete a no usar este lote de datos para reidentificar a nadie.
La venta de datos por parte de empresas en quiebra no es algo tan nuevo. En las últimas dos décadas, desde Toysmart, Borders y RadioShack hasta 23andMe, ha habido casos en los que se trataron o vendieron datos de clientes durante procesos de quiebra. Este tipo de transacciones afecta a la privacidad del consumidor y suele estar sometido a un escrutinio más estricto por parte de los tribunales, los reguladores y los gobiernos estatales.
La diferencia de Spirit es que, en esta ocasión, el núcleo de la venta no eran las listas de pasajeros, sino los correos de los empleados, los mensajes de Teams y otros datos internos de trabajo. El tratamiento de este tipo de datos en los procedimientos de quiebra actuales no ha formado todavía unas reglas maduras como las que existen para la información de consumidores.
La controversia ya había surgido. El sindicato de auxiliares de vuelo de Spirit impugnó la transacción, y por ello el tribunal retrasó la aprobación. Los datos empresariales que originalmente se iban a vender como activos de la quiebra empezaron a involucrar derechos de los empleados y los límites del uso de la IA.
Si la transacción recibe finalmente la aprobación, los datos entrarán en la fase final de entrega. Pero entre el paquete de datos ya organizado y los sistemas de Google se ha revelado muy poco en los documentos públicos. Cómo se transfieren los datos, si seguirán limpiándose y en qué forma exacta entrarán finalmente en el desarrollo de productos o en el entrenamiento de modelos, por ahora no puede confirmarse.
A partir de aquí, el proceso solo entonces completa realmente la transformación de activo de quiebra a activo de IA.
Comprador
Los compradores más claros de este tipo de datos son empresas de modelos como Google y proveedores de datos de entrenamiento como Mercor.
La explicación oficial que Google dio sobre la transacción de Spirit fue que servía para mejorar productos y desarrollar IA. Para Google, el valor de este lote de datos reside en que registra el funcionamiento real de una gran empresa, por ejemplo, la planificación de turnos, la colaboración, la comunicación interna, el avance de proyectos, la gestión de problemas y las decisiones de dirección.
Estos contenidos son difíciles de obtener de la web pública. Especialmente para un agente empresarial, más importante que el resultado final es cómo se impulsa y completa realmente una tarea dentro de una organización real. Los registros internos que dejó Spirit contienen justamente una gran cantidad de este tipo de datos de proceso.
El otro postor, Mercor, muestra aún mejor hacia dónde se está moviendo este negocio.
Mercor se fundó en 2023, y sus tres fundadores —Brendan Foody, Adarsh Hiremath y Surya Midha— habían sido compañeros de equipo en el club de debate desde el instituto. La empresa empezó dedicándose a la contratación con IA, usando modelos para ayudar a las empresas a filtrar y entrevistar candidatos. Para septiembre de 2024, Mercor ya había evaluado a unas 300.000 personas que buscaban empleo y su valoración había alcanzado los 250 millones de dólares.
Después de eso, el foco de la empresa se fue desplazando gradualmente hacia los datos de entrenamiento para IA. En noviembre de 2025, los tres fundadores tenían solo 22 años y, con el aumento de la valoración, se convirtieron en una de las cohortes más jóvenes del mundo de multimillonarios hechos a sí mismos. En el primer semestre de 2026, Mercor superó los 614 millones de dólares en ingresos, de los cuales alrededor del 90% procedían de laboratorios de IA de primer nivel como OpenAI. En julio, la empresa buscaba una valoración de unos 20.000 millones de dólares y había adquirido Deeptune, una firma especializada en construir entornos de entrenamiento para agentes de IA.
Mercor obtiene datos de entrenamiento principalmente por dos vías.
Una es comprar directamente los registros internos de la empresa. Ha hecho ofertas a startups adquiridas o cerradas para comprar los historiales de chats de los empleados y sus correos electrónicos, con una oferta máxima de unos 300.000 dólares por empresa.
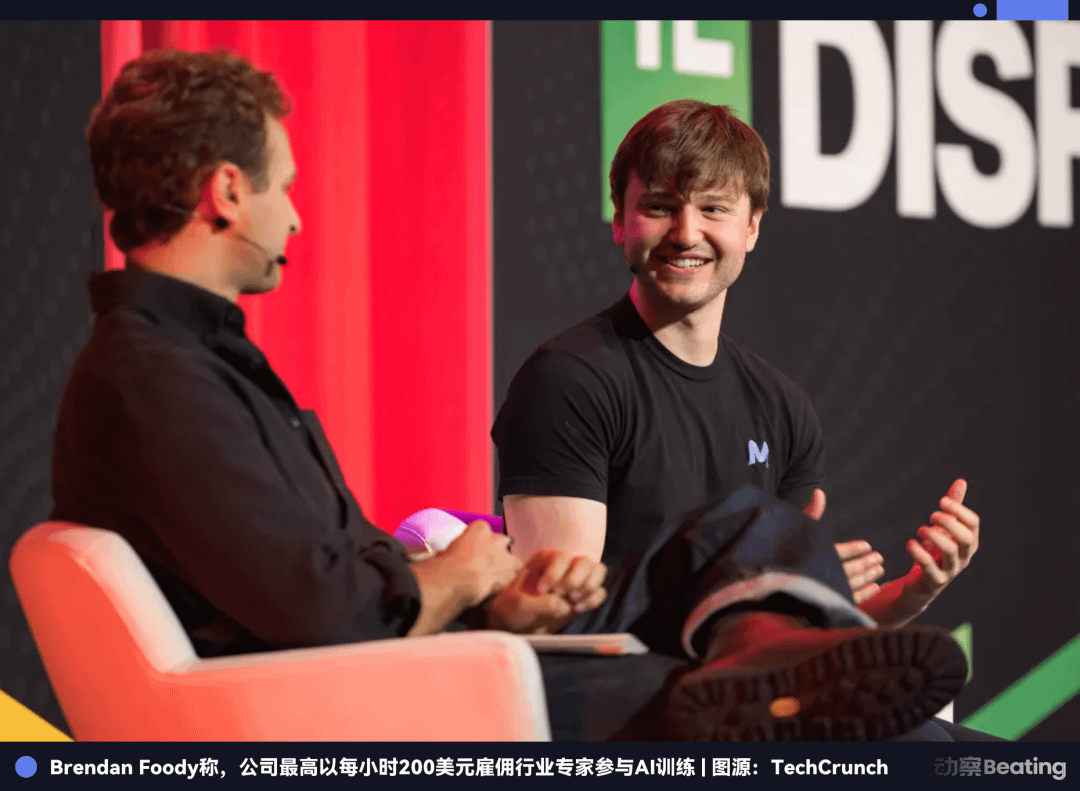
La otra consiste en contratar a personas con experiencia laboral real. TechCrunch informó en octubre de 2025 que laboratorios de IA habían reclutado a exempleados de empresas a través de Mercor para convertir su experiencia en tareas de entrenamiento y feedback, con un pago por hora de unos 200 dólares. El CEO de Mercor llegó a decir que la empresa pagaba cada día más de 1,5 millones de dólares en remuneraciones a quienes participaban en el entrenamiento de IA.
Por un lado compran los registros de trabajo que dejan las empresas; por otro, compran la experiencia laboral que poseen los empleados. Los activos centrales de Mercor son, en esencia, los procesos de trabajo del mundo real.
Eso también explica por qué apareció en la subasta de Spirit. Para Mercor, 600 millones de comunicaciones internas representan otra fuente de datos de entrenamiento de mayor escala.
Este tipo de negocio también conlleva riesgos. En 2025, Scale AI demandó a Mercor, acusando a un exempleado de llevarse secretos comerciales; después, la empresa también sufrió filtraciones de información relacionada con el entrenamiento y suspensión de colaboraciones. Los datos son al mismo tiempo el negocio de Mercor y el activo que más necesita defender.
Y al final hay un contraste en cifras. Spirit operó durante 34 años con ese nombre, mientras que los tres fundadores de Mercor, que participaron en la puja por sus datos internos, tenían entonces solo 22 años.
El banco roto
La operación de Spirit aún no se ha completado; el tribunal no ha firmado y Google todavía no ha recibido esos datos. Todavía quedan objeciones sindicales, audiencias y muchos trámites por delante.
Pero esta subasta ya ha hecho concreto algo de lo que antes se hablaba muy poco.
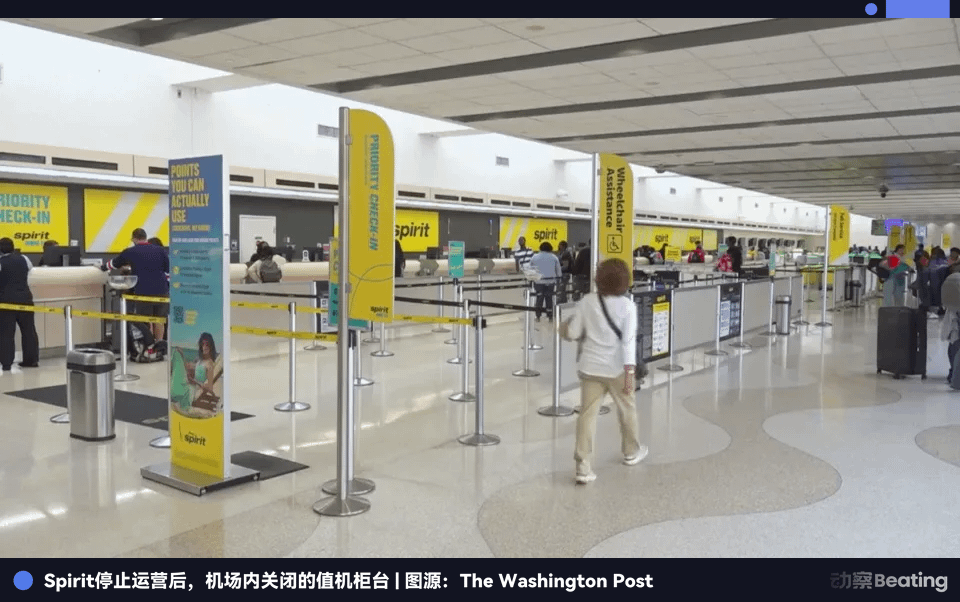
Antes, cuando una empresa cerraba, muchas cosas desaparecían de verdad. Los estados financieros quedaban, las marcas quedaban, las patentes quedaban. Pero la experiencia cotidiana de una empresa normalmente no quedaba. Cómo se reunía un departamento, cómo decidía un jefe, cómo se coordinaban decenas de personas tras un retraso, por qué un proceso acababa cambiándose a lo que es hoy: esas cosas rara vez se registraban formalmente.
La empresa se disuelve, la gente se va, los correos dejan de usarse, los grupos de chat se cierran y también desaparecen con ellos.
Así que una empresa siempre ha sido una organización bastante extraña.
Puede sobrevivir durante décadas y acumular la experiencia de decenas de miles de personas, pero lo que realmente se hereda suele ser solo una parte muy pequeña. La siguiente empresa tendrá que volver a contratar, volver a cometer errores y volver a aprender muchas cosas desde cero.
La IA puede estar cambiando precisamente eso. Si los correos, reuniones, tickets, cambios de código y discusiones internas pueden organizarse de verdad como datos de entrenamiento, entonces por primera vez la experiencia que antes solo podía llevarse una empresa por medio de las personas tiene otra forma de conservación.
A dónde acabará llegando esto es algo que todavía resulta difícil de juzgar. Tal vez en el futuro las empresas conserven estos datos de forma proactiva, tal vez vuelvan a reescribirse los contratos de los empleados, tal vez la ley de quiebras añada nuevas restricciones, o tal vez en las rondas de financiación y fusiones y adquisiciones incluso los registros internos de trabajo se valoren por separado.
Spirit puso el problema sobre la mesa antes de tiempo.
La palabra quiebra tiene una explicación etimológica muy difundida. En la Italia medieval, los comerciantes hacían negocios sentados detrás de un banco. Si se volvían insolventes, el banco se rompía en público. Banca rotta, el banco roto.
Durante siglos, cuando el banco se rompía, todo acababa ahí.
El banco de Spirit ya está hecho añicos. Sus 600 millones de mensajes han empezado a revalorizarse.
Un penique y medio por mensaje.
Enlace al texto original