
Un contrato de DuskVM puede sobrevivir al failover de nodos mientras mi aplicación de repente olvida cómo comunicarse con él.
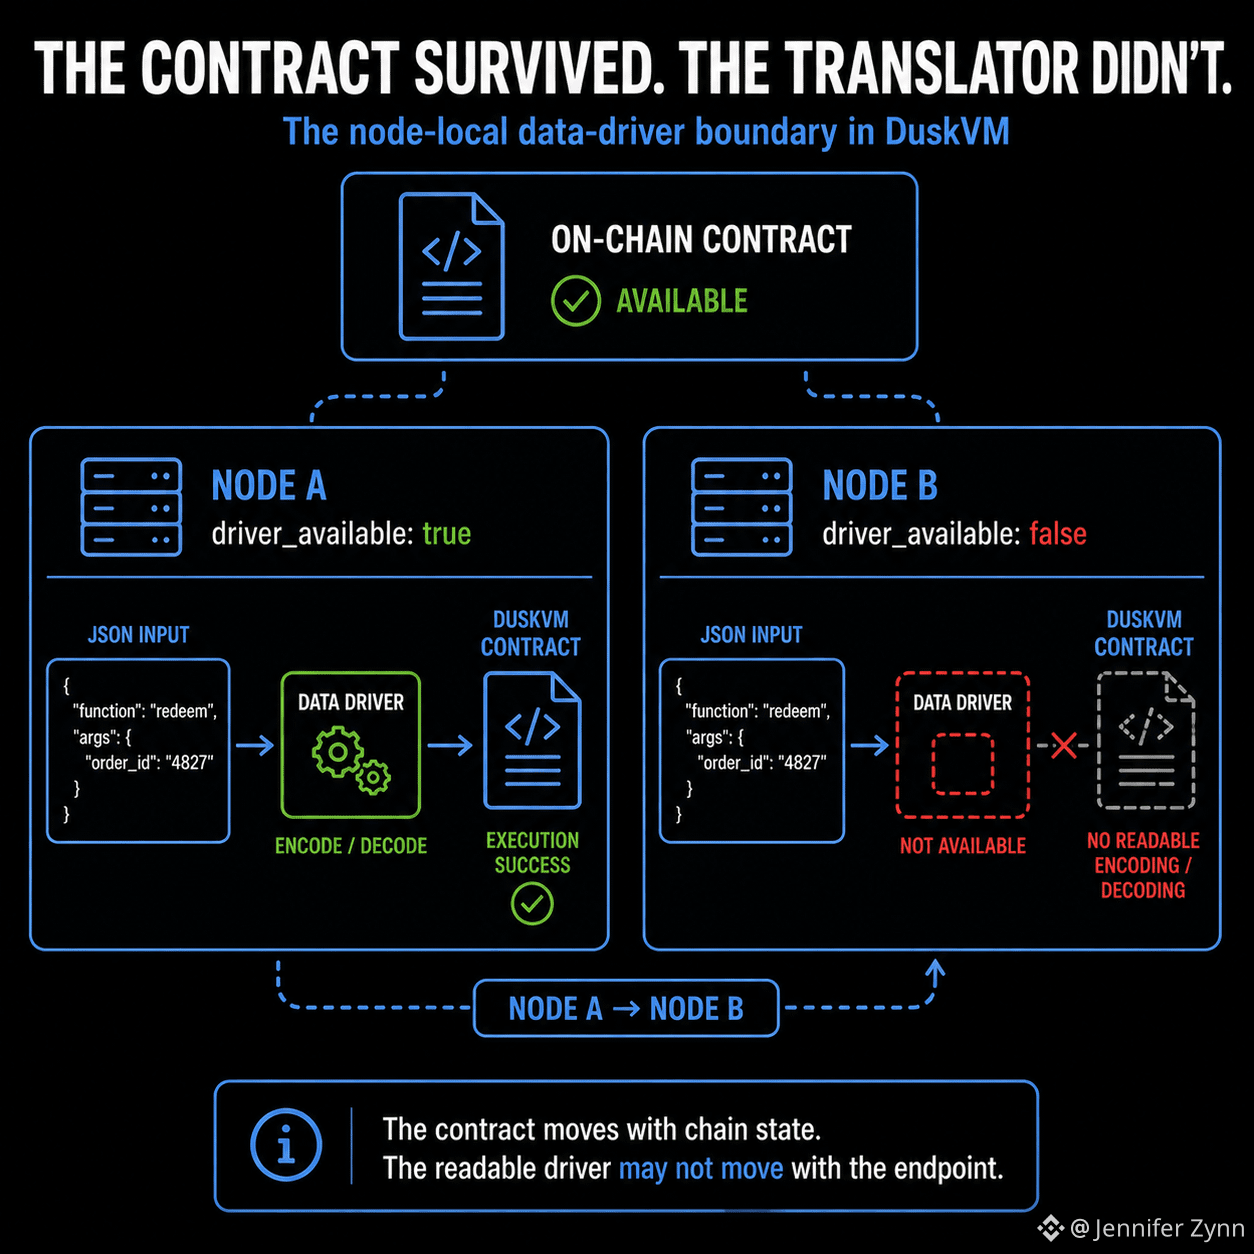
La razón está fuera de la cadena. Forge crea dos artefactos WASM a partir de la misma fuente: el contrato que se ejecuta en DuskVM y un controlador de datos que gestiona JSON legible para la codificación y decodificación con rkyv. Ese controlador no se despliega como parte del contrato on-chain.
Si quiero que las rutas del contrato JSON de Rusk hagan esa traducción, el propietario del contrato registra el controlador con ese nodo.
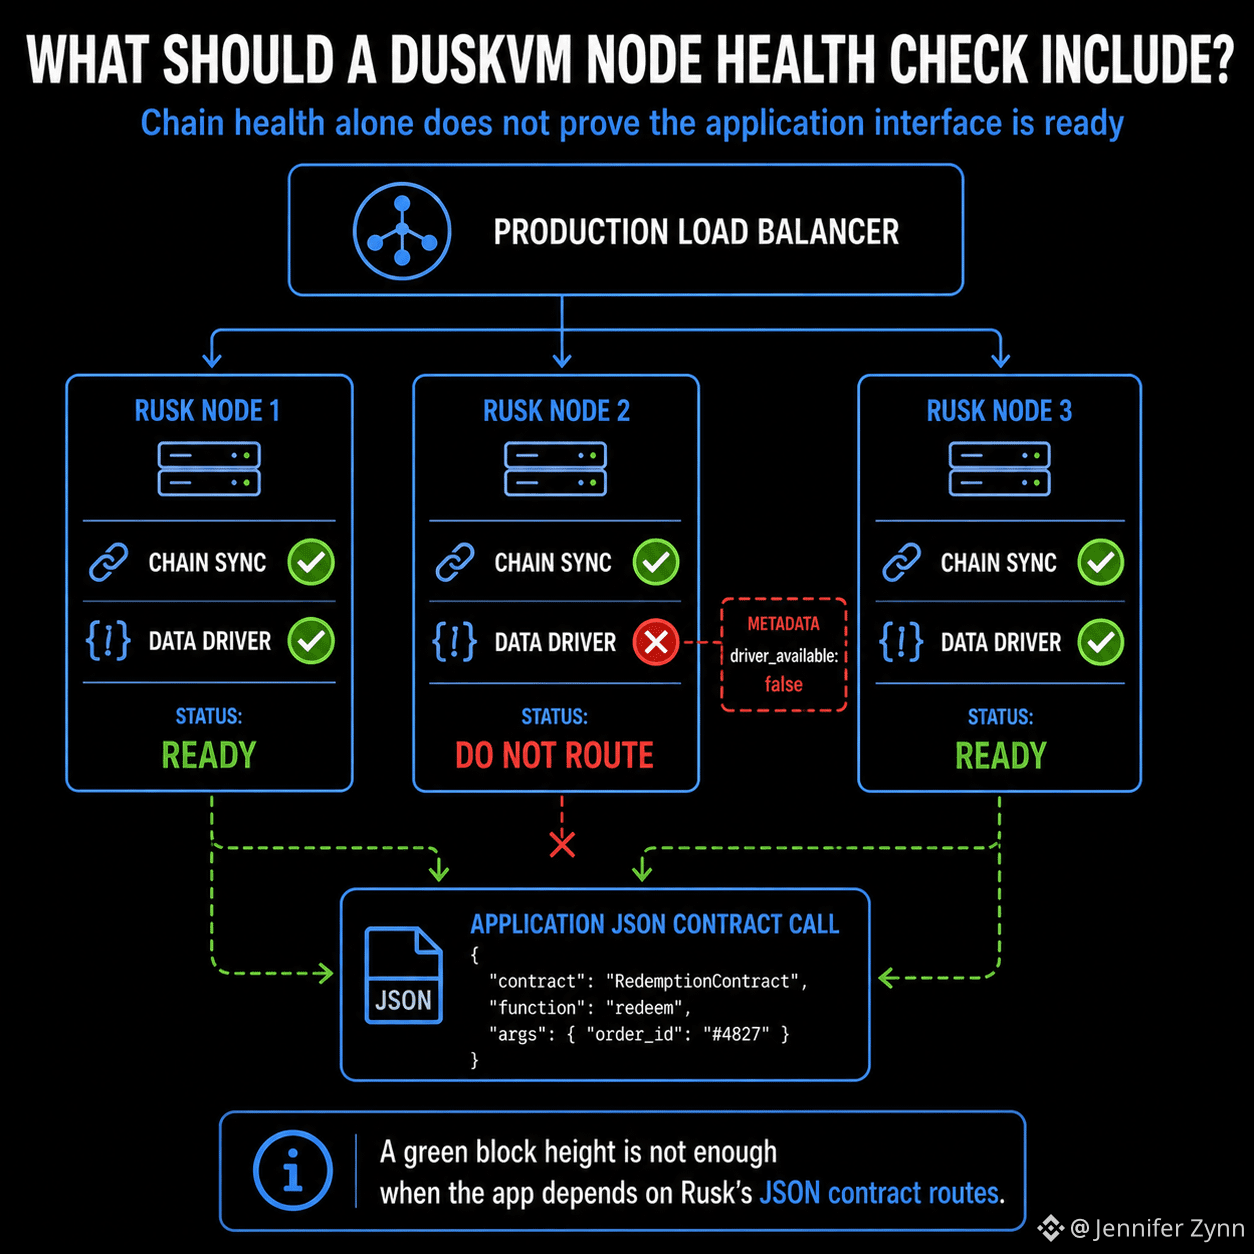
Así que puedo desplegar una vez, probar contra el Nodo A, ver llamadas legibles y limpias, y luego hacer failover al Nodo B y entrar en un estado extraño. El contrato está ahí. La cadena está sana. Pero driver_available puede ser false, así que la aplicación pierde la superficie de decodificación en la que se había apoyado.
Ese es el riesgo en producción para mí. La consen su s no falló. El contrato no falló. Mi failover cambió una dependencia fuera de la cadena que yo había tratado como si viajara con el contrato.
Yo haría que la disponibilidad del controlador forme parte de la preparación (readiness) del nodo y la verificaría en cada endpoint de Rusk antes de que el tráfico llegue a él.
En DuskVM, el contrato puede sobrevivir al failover mientras su traductor no.
#dusk $DUSK @Dusk