

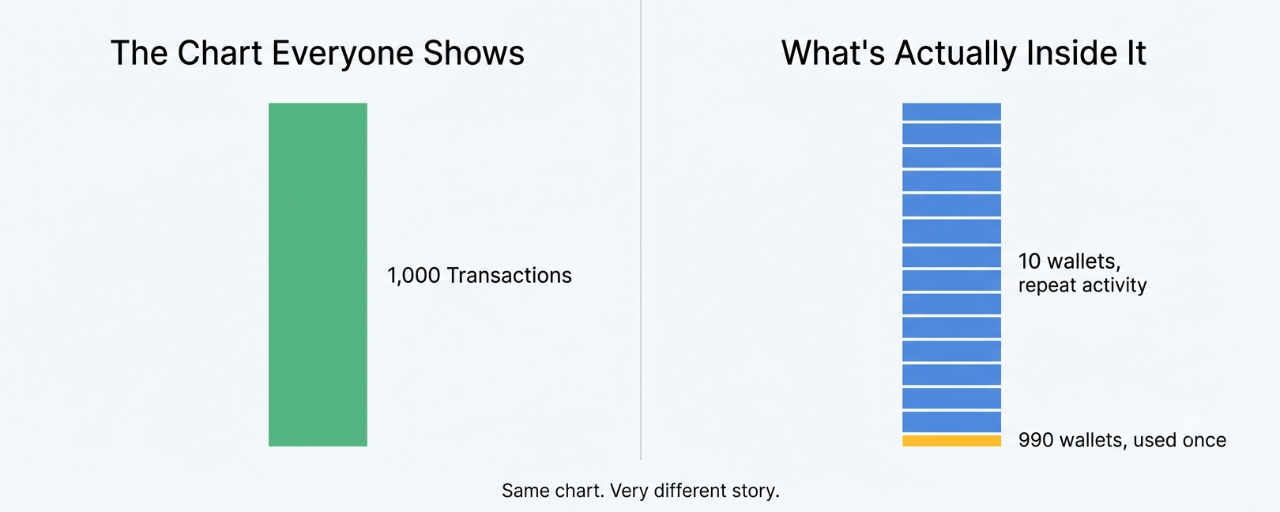

Antes estuve refrescando un agregador de DEX para ver si mejoraba el deslizamiento en un intercambio que había estado posponiendo, y me distraje leyendo un hilo que discutía qué proyectos de “cripto con IA” tienen “utilidad real”. Todos lanzaban gráficas de uso como si eso zanjara el debate. Cerré esa pestaña también, sinceramente.
Así que, por curiosidad, consulté yo mismo la actividad on-chain del Newton Protocol, solo para ver cómo se ve la “utilidad” en números reales, en bruto, en lugar de lo que muestra la gráfica de un tuitero.
Y algo hizo clic en mí que no esperaba: el recuento de transacciones se ve saludable, de verdad. Pero cuando empecé a revisar qué direcciones estaban generando ese volumen, resulta que es un conjunto mucho más pequeño de wallets que lo que sugiere el titular. No es falso, no está vacío, solo que… está concentrado. Un puñado de direcciones haciendo muchísima actividad repetida, y una cola mucho más larga de direcciones que tocaron el protocolo una vez y nunca volvieron.
Lo que la gente asume cuando dice que "la utilidad decidirá al ganador" es que la utilidad equivale al volumen de transacciones, punto final: más actividad significa más uso real en el mundo, y eso indica más resistencia. Lo que en realidad parece estar pasando es que una parte de ese volumen es un grupo pequeño de billeteras — posiblemente bots, posiblemente usuarios con mucho poder, posiblemente la infraestructura de pruebas del propio equipo; desde fuera, no se puede saber con certeza — que están ciclando transacciones repetidamente, lo que infla el número de "uso" sin necesariamente reflejar una adopción orgánica amplia. Diez billeteras haciendo mil transacciones cada una se ve idéntico en un gráfico de barras a mil billeteras haciendo diez cada una. Pero no son lo mismo en absoluto.
No estoy del todo convencido de que esto sea exclusivo de Newton; para ser claro, esto es básicamente cierto de la mayoría de cadenas y protocolos en sus primeras etapas. Pero esta es la parte que me molesta: si la "utilidad" es el criterio que todo el mundo usa para elegir ganadores, y la utilidad actualmente es indistinguible entre "demanda genuina y amplia" y "uso repetido concentrado de un grupo pequeño", entonces todo el marco que la gente está usando para clasificar estos proyectos podría estar midiendo lo incorrecto. O, al menos, midiendo algo que parece ser lo correcto sin serlo realmente.
Pensé que el crecimiento de la billetera única podría aclararlo: si las direcciones nuevas crecen de forma constante, eso es un buen indicador de una adopción amplia, independientemente de lo que estén haciendo las billeteras principales. Pero al verificarlo específicamente, las nuevas direcciones únicas están creciendo, sí, pero a una tasa notablemente menor que el conteo bruto de transacciones. Así que la imagen no es de "crecimiento falso"; es más bien que el crecimiento ocurre en dos vías diferentes con dos ritmos distintos, y solo una de ellas es la que aparece en la cifra principal.
Esto importa para cualquiera que intente realmente clasificar proyectos de "cripto con IA" por utilidad en lugar de por narrativa, porque si la métrica estándar no puede distinguir la diferencia entre un protocolo con demanda distribuida real y otro con un grupo más pequeño de usuarios pesados, entonces la mayoría de las comparaciones que se están haciendo ahora mismo — Newton frente a sus pares, esta generación de proyectos entre sí — probablemente son menos significativas de lo que parecen. No es que la utilidad no importe. Es que la "utilidad" tal como se mide actualmente podría no estar midiendo la utilidad.
A quién afecta esto en concreto: a cualquiera que asigne capital basándose en comparaciones de gráficos de uso entre proyectos de cripto con IA, suponiendo que esos gráficos son comparables. Podrían no serlo, proyecto por proyecto, dependiendo de qué tan concentrada esté la actividad de las billeteras subyacentes.
¿Cuándo dejaría de importar? Probablemente cuando alguien construya una forma razonable de separar el "uso único y significativo" del "uso repetido por un conjunto pequeño de direcciones" como una métrica pública y comparable. Todavía no he visto que se haga bien, ni para Newton ni realmente para nadie en este sector. Tal vez ya exista en algún lugar y simplemente no lo he encontrado.
@NewtonProtocol #Newt $NEWT