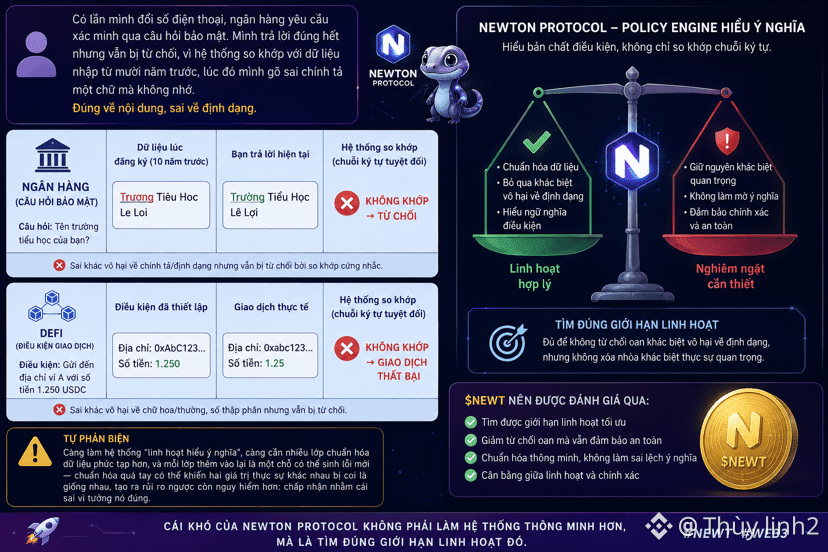
Cuando cambié mi número de teléfono, el banco exigió que verificara a través de una pregunta de seguridad. Respondí correctamente todo, pero aun así me rechazaron, porque el sistema hace coincidir con los datos introducidos hace diez años; en ese entonces escribí mal una letra y no lo recordaba. Correcto en el contenido, incorrecto en el formato, y el sistema no distingue entre esos dos tipos de error.
DeFi también tiene un tipo de confusión exactamente igual: una dirección de billetera en mayúsculas/minúsculas distintas, un número redondeado distinto de los dígitos decimales, todo ello puede hacer que una condición que en esencia es correcta se considere “no coincidente”, solo porque se compara la cadena de caracteres de forma absoluta en lugar de entender el significado.
@NewtonProtocol Si un policy engine entendiera el significado de las condiciones en vez de hacer solo coincidencias rígidas, se reducirían muchos casos de rechazos injustificados como este.
Autorrebatimiento: pero cuanto más se hace al sistema “flexible y que entienda el significado”, más capas de normalización complejas se requieren, y cada capa añadida es otro lugar donde puede aparecer un error nuevo. Normalizar demasiado puede hacer que dos valores que en realidad son diferentes se consideren iguales, creando un riesgo inverso y aún más peligroso: aceptar como válido un error porque se creyó que estaba bien.
Lo difícil de @NewtonProtocol no es hacer el sistema más inteligente, sino encontrar el límite correcto de flexibilidad: lo bastante para no rechazar injustamente diferencias inofensivas de formato, pero sin borrar también las diferencias realmente importantes.
$NEWT Por eso debería evaluarse según si se logra encontrar en qué punto está ese límite, y no solo según si se ha aplicado o no tecnología que entienda el lenguaje.
#newt $LAB $SAROS