Un trader compara dos proyectos de IA.
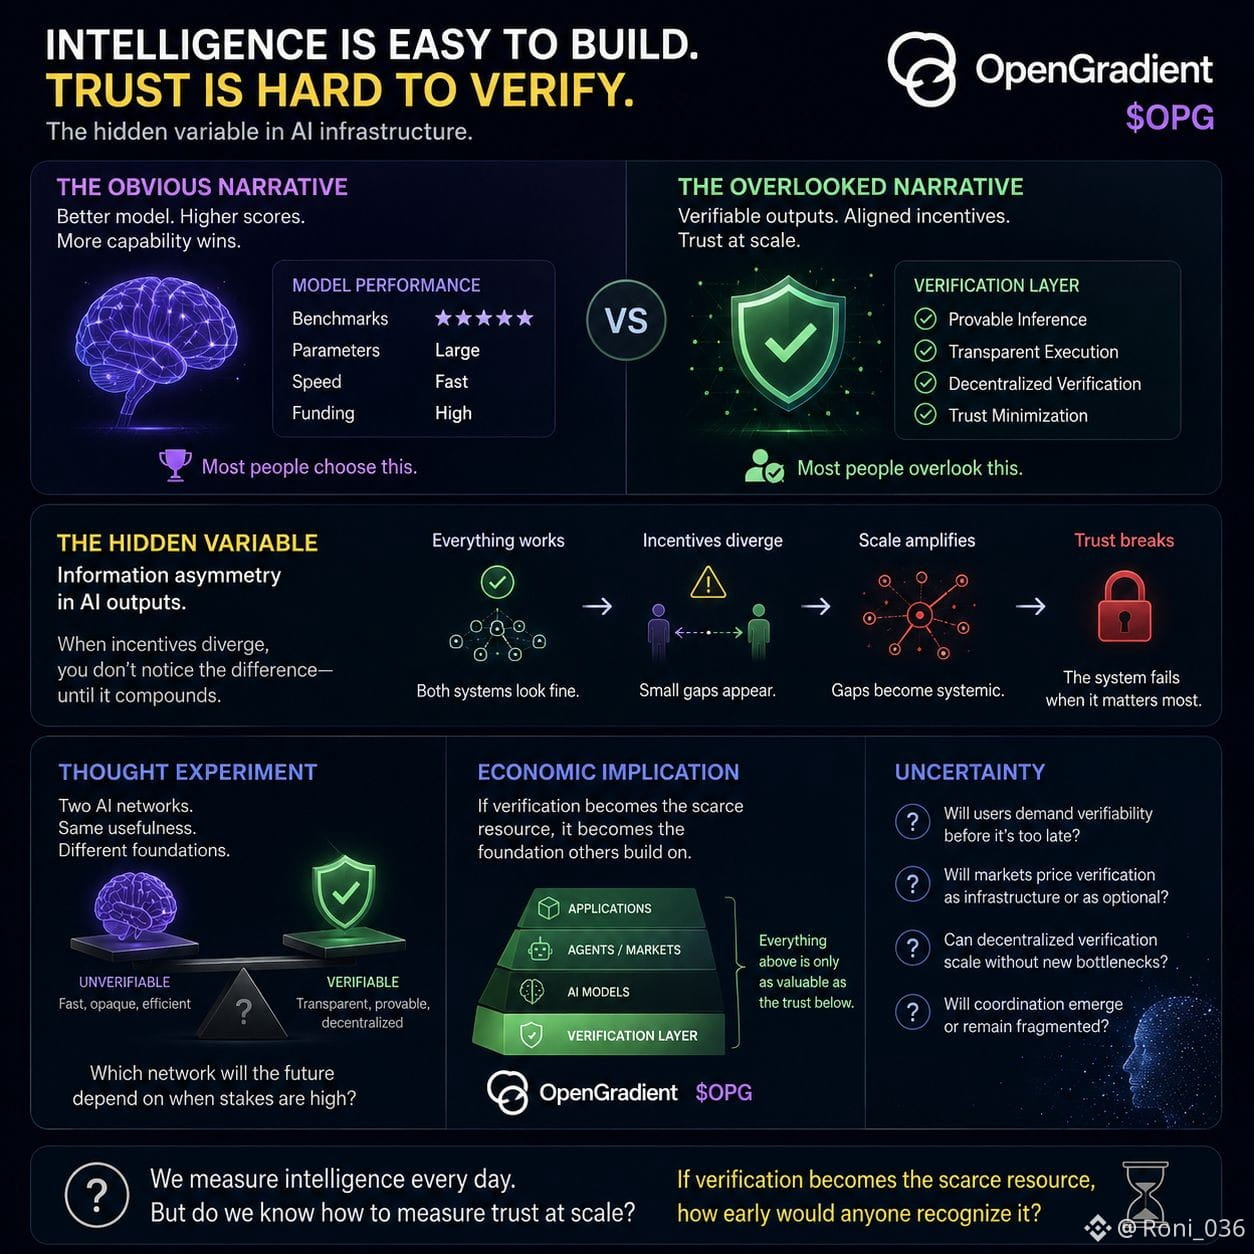
Uno tiene un modelo más grande, más financiamiento y puntajes de referencia más altos.
El otro gasta la mayor parte de su esfuerzo en hacer que los resultados del modelo sean verificables.
La mayoría de la gente probablemente elegiría el primero.
Esa parece ser la narrativa obvia sobre la infraestructura de IA también. Mejores modelos ganan. Más inteligencia gana. Más capacidad atrae a más usuarios.
Al principio pensé lo mismo.
Pero cuanto más lo pienso, más me pregunto si la inteligencia se está midiendo mientras que la verificación simplemente se está asumiendo.
Imagina dos redes de IA produciendo resultados igualmente útiles.
En una red, los usuarios pueden verificar de manera independiente cómo se generaron los resultados. En la otra, la verificación existe principalmente a través de la reputación y la confianza.
Ambas funcionan normalmente cuando todo va bien.
La diferencia solo aparece cuando los incentivos se desalinean.
Un solo resultado no verificable puede no importar. Miles probablemente tampoco importan. Pero, ¿qué pasa cuando mercados enteros, agentes, aplicaciones y decisiones automatizadas comienzan a depender de información que no puede ser fácilmente verificada?
Visto a través de esa lente, @OpenGradient $OPG se siente menos como una pregunta sobre el rendimiento de la IA y más como una pregunta sobre la asimetría de información.
No si se puede crear inteligencia.
Sino si se puede confiar en la inteligencia a gran escala.
No estoy seguro de que el mercado haya decidido cuál problema es en realidad más difícil aún.
Y si la verificación eventualmente se convierte en el recurso escaso, ¿qué tan temprano podría alguien reconocerlo?
#opg $OPG @OpenGradient
Uno tiene un modelo más grande, más financiamiento y puntajes de referencia más altos.
El otro gasta la mayor parte de su esfuerzo en hacer que los resultados del modelo sean verificables.
La mayoría de la gente probablemente elegiría el primero.
Esa parece ser la narrativa obvia sobre la infraestructura de IA también. Mejores modelos ganan. Más inteligencia gana. Más capacidad atrae a más usuarios.
Al principio pensé lo mismo.
Pero cuanto más lo pienso, más me pregunto si la inteligencia se está midiendo mientras que la verificación simplemente se está asumiendo.
Imagina dos redes de IA produciendo resultados igualmente útiles.
En una red, los usuarios pueden verificar de manera independiente cómo se generaron los resultados. En la otra, la verificación existe principalmente a través de la reputación y la confianza.
Ambas funcionan normalmente cuando todo va bien.
La diferencia solo aparece cuando los incentivos se desalinean.
Un solo resultado no verificable puede no importar. Miles probablemente tampoco importan. Pero, ¿qué pasa cuando mercados enteros, agentes, aplicaciones y decisiones automatizadas comienzan a depender de información que no puede ser fácilmente verificada?
Visto a través de esa lente, @OpenGradient $OPG se siente menos como una pregunta sobre el rendimiento de la IA y más como una pregunta sobre la asimetría de información.
No si se puede crear inteligencia.
Sino si se puede confiar en la inteligencia a gran escala.
No estoy seguro de que el mercado haya decidido cuál problema es en realidad más difícil aún.
Y si la verificación eventualmente se convierte en el recurso escaso, ¿qué tan temprano podría alguien reconocerlo?
#opg $OPG @OpenGradient