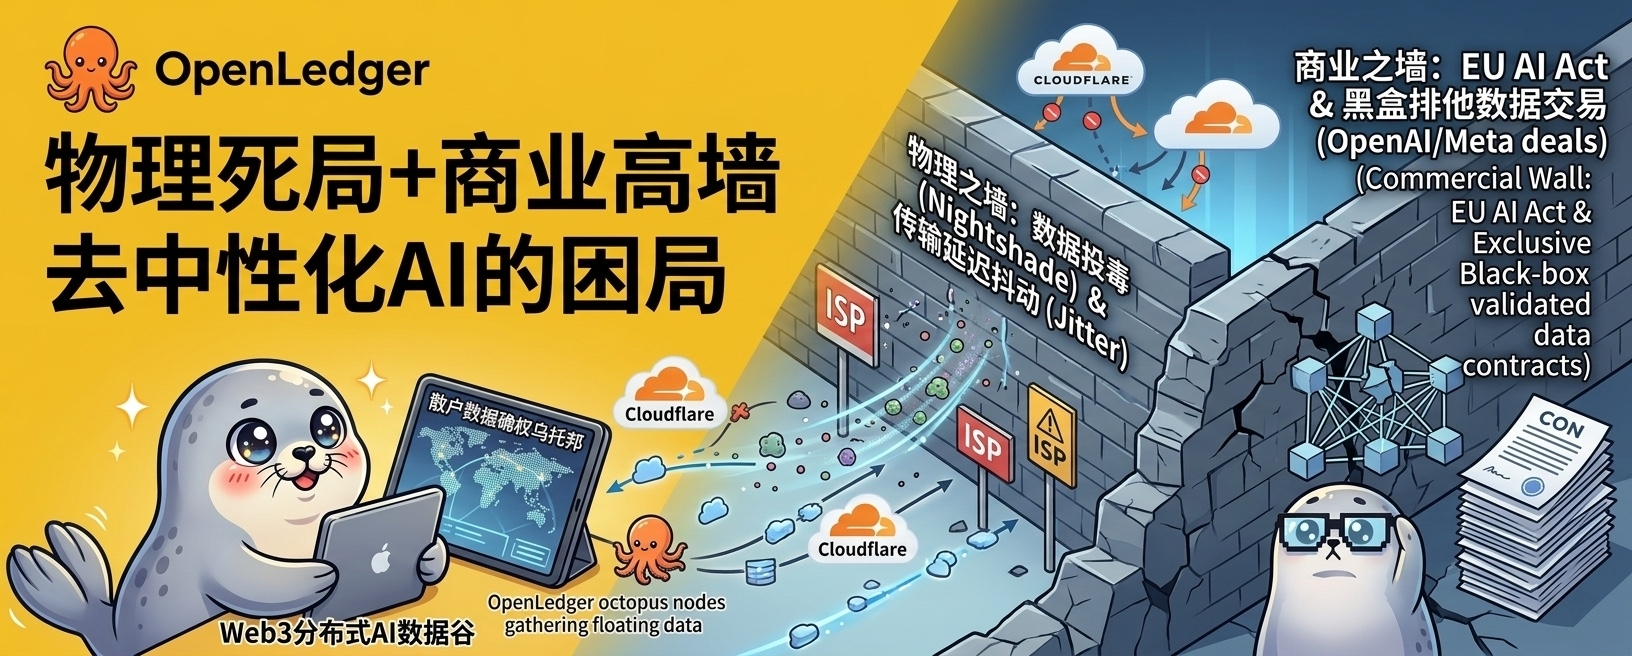

En junio, el noreste está en plena temporada de lluvias, el aire húmedo y la lluvia incesante afuera me ponen inquieto sin razón. Justo hoy es el último momento para la tarea de $OPEN de #CreatorPad , y el aire está impregnado de la urgencia de subirse al tren y de los gritos de 'igualdad de datos en la era de la IA'. Me preparé una taza de café que estaba tan amarga como el desánimo, mirando la pantalla del ordenador donde resonaba la noticia de la colaboración de OpenLedger y Story Protocol para lanzar la 'certificación automática de derechos de autor de IA', y me sumergí en una larga y dolorosa montaña rusa emocional.
Hoy, cuando me forcé a salir de una visión legal única y miré el panorama completo con una mentalidad de ingeniería de redes y lógica de aprendizaje automático, esa primera impresión asombrosa estalló como una burbuja, dejando solo un frío en mi corazón. Descubrí que esta gran narrativa es tan frágil ante las estrictas leyes físicas, la seguridad de datos y las altas murallas del derecho comercial, como un papel empapado en agua.
Un inicio asombroso: alguna vez también me levanté a aplaudir.
Debo admitir que el esquema es extremadamente convincente desde una perspectiva lógica. En la cadena de valor tradicional de la AI, los creadores, los limpiadores de datos y los nodos periféricos siempre están en la parte más baja de la cadena alimentaria. Gigantes como OpenAI y Google, con su enorme potencia de cálculo y equipos legales, extraen sin piedad los datos gratuitos de todo el mundo para entrenar modelos. Sin embargo, lo que propone Story Protocol, los Datanets (conjuntos de datos de propiedad comunitaria) y ModelFactory, aborda precisamente este punto crítico. Su combinación crea un ciclo casi perfecto: los minoristas contribuyen con datos a través de nodos, OpenLedger utiliza Proof of Attribution (Prueba de Atribución) para registrar en la cadena cada contribución que haces al modelo AI; una vez que ese modelo genera una invocación comercial, el protocolo subyacente de Story Protocol se activa automáticamente, liquidando los derechos de autor a través de micropagos en tiempo real a los contribuidores de datos originales mediante el token OPEN.
¿No es esto lo que imaginamos como una utopía de inteligencia artificial distribuida y absolutamente justa en Web3? Para ser sincero, cuando vi por primera vez este diseño, casi me levanté a aplaudir. Pero precisamente esta lógica de coherencia me ha hecho sentir más dolor a medida que descubrí más riesgos en los días siguientes.
La vulnerabilidad mortal bajo la sombra de 'Nightshade': un consenso descentralizado no puede protegerse contra la 'intoxicación de datos'.
OpenLedger ha estado enfatizando que sus Datanets pueden producir materiales de entrenamiento de alta calidad. Pero aquí hay una enorme paradoja lógica, casi sin solución: el mecanismo de consenso de una red descentralizada solo puede verificar si los datos 'alcanzaron un consenso', pero no puede verificar la 'verdad absoluta' de los datos en el mundo físico.
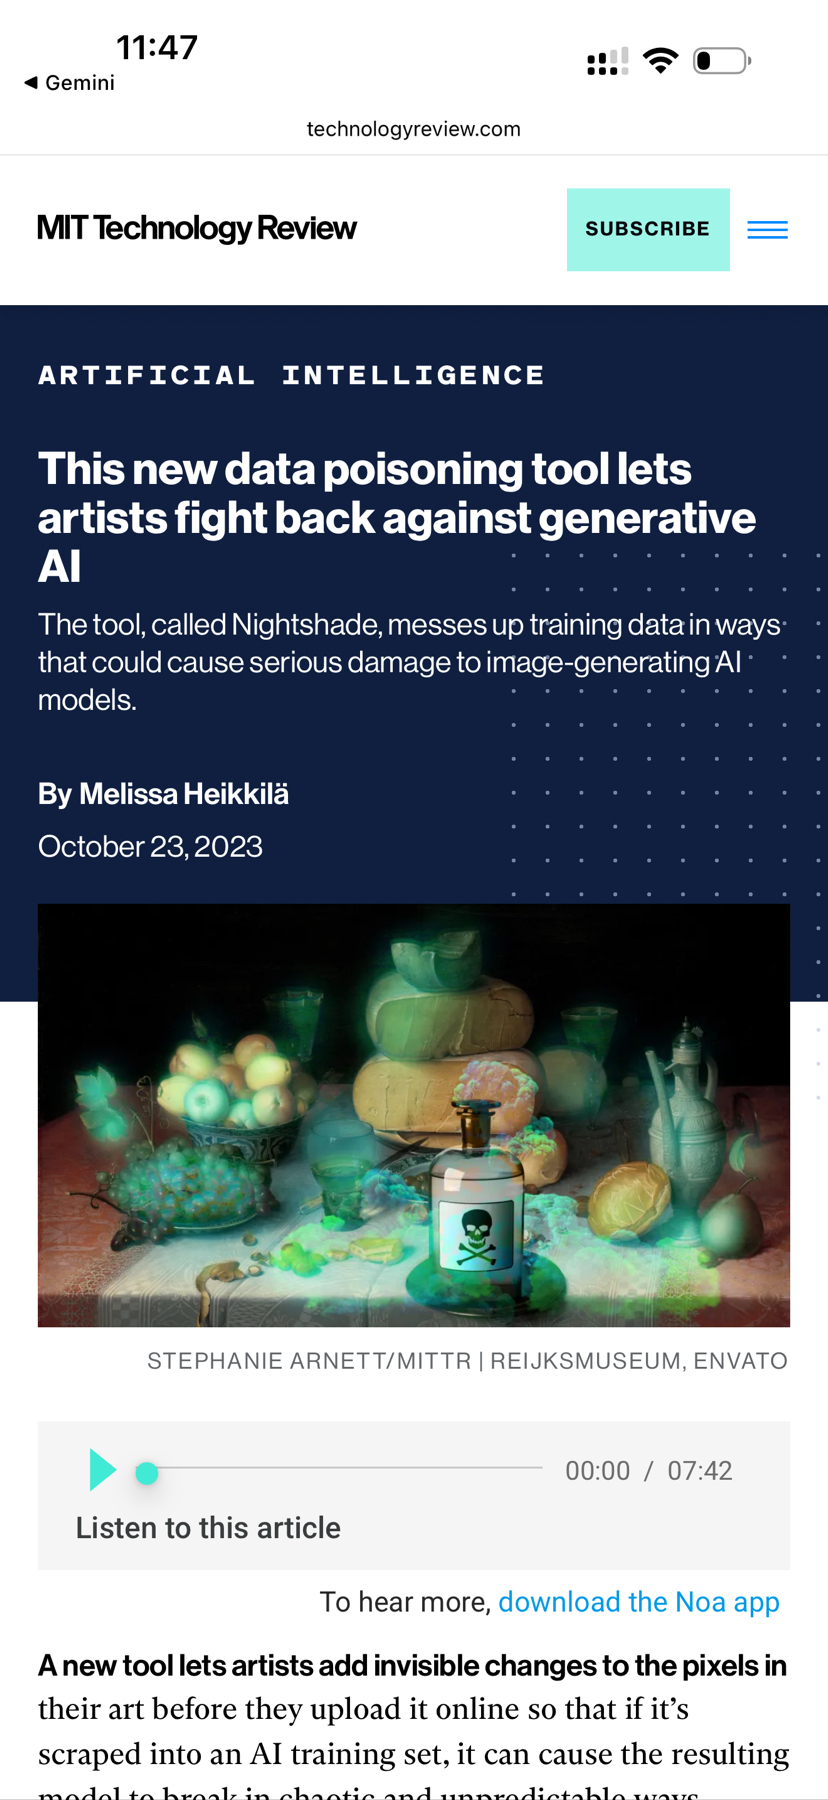
Ya en 2023, se lanzó una herramienta de AI adversaria llamada Nightshade en la Universidad de Chicago, causando revuelo en la comunidad geek. Véase la imagen a continuación. Lo aterrador de esta cosa es que puede alterar imágenes o textos a nivel de píxel de una manera que no es perceptible a simple vista. Tú ves un gato, pero el vector subyacente del modelo AI lo identifica como un perro.
Ahora, ¿qué pasaría si llevamos esta herramienta aterradora a la red distribuida de OpenLedger?
En una red descentralizada sin permisos, cualquier nodo puede enviar datos. Si una organización de hackers maliciosos, o un competidor, utiliza herramientas como Nightshade para realizar 'intoxicación invisible' en grandes cantidades de datos, y luego las distribuye a través de miles de nodos anónimos en la red de OpenLedger, el algoritmo de consenso de la red solo comparará los hash de esos datos o si su formato es conforme. Los nodos incluso podrían votar a favor de esos 'datos tóxicos' debido a intereses comunes. ¿Y cuál es el resultado? Una vez que un modelo AI empresarial adquiere este lote de datos descentralizados contaminados, los pesos de la red neuronal de todo el modelo sufrirán una destrucción devastadora, lo que en el aprendizaje automático se denomina 'colapso del modelo'.
En grandes empresas centralizadas, la limpieza de datos tiene un estricto mecanismo de aislamiento interno y responsabilidad; pero en esta red completamente distribuida, ¿quién se responsabiliza por la 'intoxicación'? Si ni siquiera se puede garantizar un 100% de 'pureza' de los datos en términos de ingeniería, ¿qué empresa valorada en miles de millones se atrevería a confiar su modelo grande y crítico a una red anónima que podría ser contaminada de manera maliciosa en cualquier momento? Al pensar en esto, realmente me quedo helado. Lo que se llama 'derechos de datos' tiene como premisa que los datos sean 'buenos'. No poder protegerse contra la intoxicación adversaria significa que lo que esta red produzca será un montón de basura digital costosa.
La maldición física del jitter: la pesadilla del canal AI empresarial.
El segundo punto que rompió mi defensa psicológica es la extremadamente realista barrera física del hardware. Si has estado siguiendo las noticias de Silicon Valley, sabrás que dispositivos como el LPU (Unidad de Procesamiento de Lenguaje) de Groq, diseñados específicamente para inferencia AI, o la última arquitectura Blackwell de Nvidia, están obsesionados con un indicador: baja latencia y alta coherencia de procesamiento de datos. El canal de procesamiento de datos AI comercial moderno requiere que la latencia de transmisión entre la base de datos de vectores y la unidad de cálculo alcance niveles de microsegundos. ¿Y qué tipo de red está tratando de construir OpenLedger? Pretenden depender de terminales distribuidos globalmente, con entornos de red que varían enormemente, para realizar la limpieza y procesamiento de vectores de datos.
He profundizado en este campo con un colega que tiene experiencia en despliegues en la nube, y ver esta arquitectura es simplemente absurdo. Tus nodos en Japón justo se encuentran con congestión en la red, o los nodos en Medio Oriente están experimentando una reducción en la velocidad de banda ancha hoy, y toda la cadena de procesamiento de datos puede experimentar un 'jitter' de latencia que se dispara instantáneamente. Para aplicaciones AI de nivel empresarial que requieren estabilidad absoluta y retroalimentación en tiempo real, tales retrasos en la transmisión de cientos de milisegundos o incluso segundos son un desastre absolutamente inaceptable. Ellos intentan desafiar las leyes físicas de propagación a la velocidad de la luz y la topología de redes con la 'correctitud política' de la 'descentralización'. Es como si quisieras usar diez mil tractores improvisados para mover un motor de un Boeing 747 que requiere una sincronización extremadamente alta. El concepto es sexy, pero la práctica es dura.
Cuando superpuse estas dos muertes físicas, la sensación inicial de asombro fue reemplazada por una razón casi helada.
El costo invisible de las IP de los minoristas.
En el proceso de que las emociones se enfríen gradualmente, hay otra dimensión que me pone la piel de gallina que debo mencionar: la represión física que ya ha ocurrido en el mundo real contra la recopilación de datos descentralizada.
\u003ca-63\u003e Sobre la función de 'bloqueo de arañas AI con un solo clic' que Cloudflare lanzó en 2024, ya he discutido esto de manera completa en un breve texto anterior.\u003c/a-63\u003e
En pocas palabras, cuando un nodo de banda ancha doméstica, sin saberlo, toca el firewall del sitio objetivo, la IP residencial será instantáneamente marcada por la CDN internacional como 'fuente de ataque malicioso'. Este golpe directo afecta a los capilares sobre los que OpenLedger depende para sobrevivir, y también ha oscurecido la narrativa de 'todos contribuyen, todos se benefician'.
La falta de un circuito comercial: bajo la sombra de la ley de AI de la UE, ¿quién pagará por el 'autoentusiasmo en la cadena'?
Más desesperante aún es la desconexión total de este mecanismo de regalías automáticas frente a la lógica comercial y legal real. Debemos reconocer una realidad extremadamente cruel: la 'propiedad de derechos de autor' y 'regalías' definidas por la red descentralizada no tienen ninguna capacidad de reembolso coercitivo o de cumplimiento en el marco legal de los gigantes AI tradicionales de Web2. En 2026, las estrategias legales centrales de empresas como OpenAI y Meta ya han evolucionado hacia levantar la bandera de 'uso justo' o firmar acuerdos de autorización de datos en caja negra excludente con grandes grupos de medios. Estos gigantes B, que tienen el absoluto control del discurso de la industria, no encuentran ningún incentivo comercial para conectarse a un acuerdo de liquidación de regalías descentralizadas que esté en una zona gris legal, compuesto por minoristas anónimos de todo el mundo. Sin la entrada de estos mayores compradores, el mecanismo de pago automático de regalías de OpenLedger solo podrá convertirse en un 'autoentusiasmo' en la cadena de los desarrolladores internos.
\u003ca-21\u003e Como reportó el Wall Street Journal, OpenAI gastó más de 250 millones de dólares para comprar los derechos exclusivos de News Corp; ya he desglosado este caso en un breve texto anterior.\u003c/a-21\u003e
Por ejemplo, según un informe de Reuters, en 2024 Google y Reddit también alcanzaron un acuerdo de datos de AI de 60 millones de dólares al año.
El telón de acero de la regulación de la UE ha cerrado casi por completo este camino ya estrecho. Con la implementación gradual de la Ley de AI de la UE, la 'pureza' de los datos de entrenamiento de modelos grandes se ha elevado a una altura política y legal sin precedentes. Según los requisitos de implementación por etapas de la ley, a partir de agosto de 2025, los proveedores de modelos AI generales deberán publicar un resumen 'suficientemente detallado' del contenido de los datos de entrenamiento y cumplir estrictamente con las políticas de gobernanza de datos y cumplimiento de derechos de autor; los datos de entrada de sistemas AI de alto riesgo deben ser trazables, sin sesgos y sin infracciones. Recientemente, la Comisión Europea ha exigido a todos los proveedores de modelos básicos que operan dentro de su territorio que proporcionen informes de auditoría sobre fuentes de recopilación de datos y procesos de limpieza, y cualquier dato de origen dudoso o con riesgo de infringir derechos de autor podría llevar a que todo el modelo sea retirado del mercado.
Bajo los exigentes requisitos de 'Data Lineage', los Datanets de OpenLedger prácticamente pisan cada mina. Su canal distribuido depende de miles de nodos no verificados por KYC en todo el mundo para cargar y limpiar datos de forma preliminar; incluso si uno de esos nodos introduce intencionalmente una pequeña cantidad de 'datos tóxicos' protegidos, la conformidad de toda la cadena de datos colapsará instantáneamente. Ninguna empresa AI comercial arriesgaría su modelo grande, en el que ha invertido miles de millones, en la limpieza de los datos de una red anónima. No importa cuán noble sea el ideal de descentralización, ante un informe de auditoría de conformidad frío, cualquier 'consenso comunitario' no puede sustituir la eficacia legal de la verificación en lista blanca.
Conclusión | Mantén la chispa, pero no pagues más por la trampa física y la ilusión comercial.
La lluvia afuera sigue cayendo, y el café en mi taza ya se ha enfriado por completo. No tengo nada en contra del equipo de OpenLedger; de hecho, soy un ferviente defensor de DeAI. Reconozco que la arquitectura de OpenLoRA ha logrado un avance ingenieril en la eficiencia de despliegue en una sola GPU, así como la visión futurista de su fundador Pryce Adade-Yebesi. Pero al despojarme de toda la paja, veo una frágil consensuación que no tiene poder ante la intoxicación de datos adversarios, una infraestructura subyacente que no puede soportar las demandas de latencia extrema en AI a nivel empresarial, y un modelo comercial que no encuentra ninguna base en medio de las leyes de derechos de autor y las estrategias de compra de los gigantes. Esto no proviene de mi desesperación por la pista de DeAI+DePIN, sino más bien, deseo fervientemente que esta pista sobreviva, hasta el punto en que no puedo tolerar que ningún proyecto, sin compradores comerciales, sin exenciones legales y sin una verdadera protección de la propiedad intelectual, haga que los nodos domésticos de los minoristas y los activos de IP enfrenten la ira de los gigantes.
Antes de que la oficialidad pueda presentar un verdadero informe de 'pruebas de presión contra la intoxicación de datos' auditado por una tercera institución de seguridad, que demuestre que su latencia de red puede satisfacer las demandas industriales de búsqueda de vectores, y de presentar un informe financiero real con un pedido de compra de conformidad con un gran fabricante AI de Web2, voy a bajar mis expectativas a cero. Cualquier esquema sobre 'regalías automáticas de billones' en mis ojos debe deducirse del riesgo correspondiente. Mantener una participación mínima, conservar la chispa, pero nunca expandir ciegamente la exposición al riesgo de activos; en este junio lleno de trampas narrativas, mantener una dosis de sarcasmo y racionalidad de ingeniero puede ser lo único que podemos dejar a nuestra dignidad.
Apagué la pantalla, y esa sensación de frío aún no se ha disipado.
\u003cc-59/\u003e