Lo que me molestó a mitad de camino en la tarea de OpenLedger $OPEN #OpenLedger @OpenLedger fue la palabra "colaborativa." Está por todas partes en el marco: conjuntos de datos colaborativos, entrenamiento de modelos colaborativos, inteligencia propiedad de la comunidad. Y luego miras lo que realmente se está construyendo ahora mismo y es una forma completamente diferente.
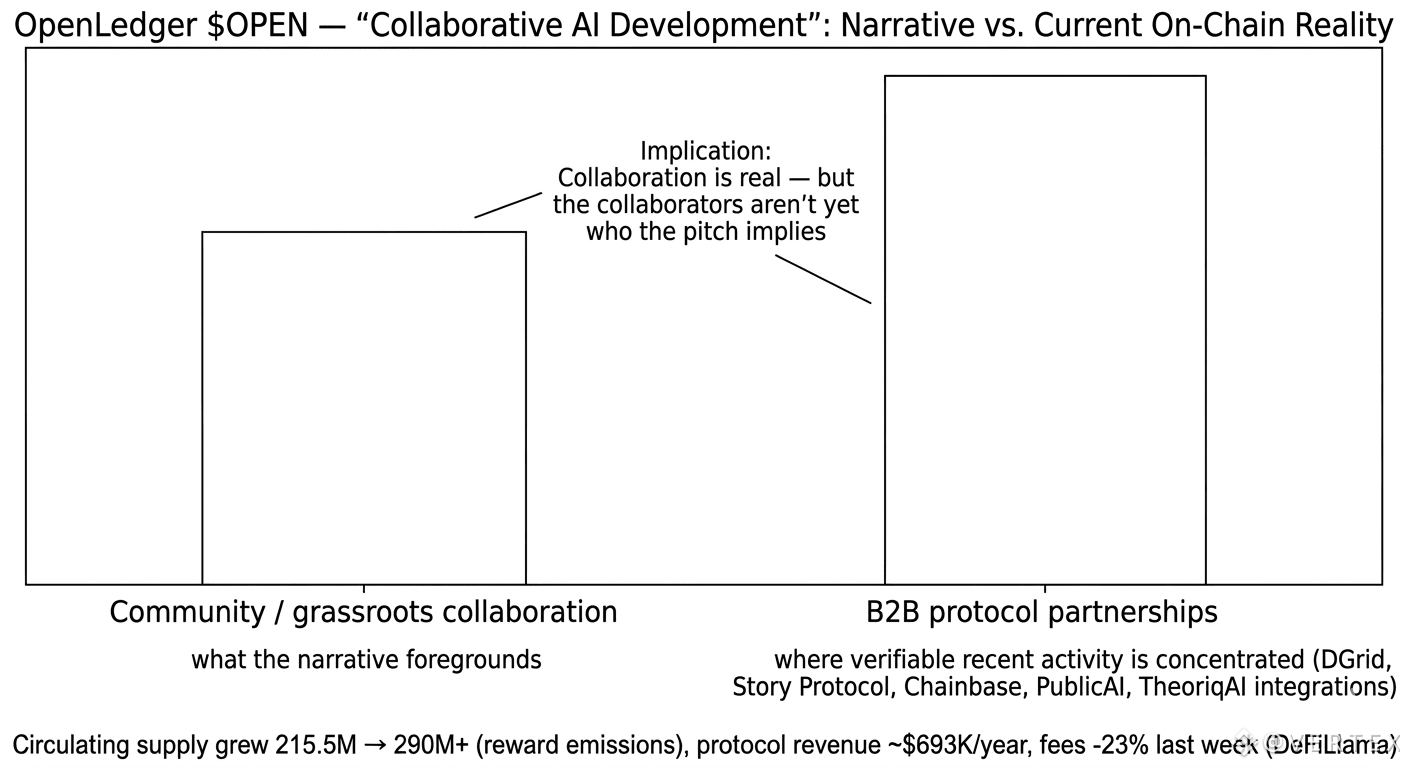
La actividad reciente es casi en su totalidad asociaciones de protocolo bilaterales: DGrid para computación, Story Protocol para licencias de derechos, Chainbase para datos de Web3, PublicAI para etiquetado, TheoriqAI para agentes. Cada uno es un apretón de manos entre dos equipos, no actividad de contribuyentes abiertos. Mientras tanto, CoinMarketCap muestra que la oferta circulante ha crecido de 215.5M a más de 290M OPEN, mayormente a través de emisiones de recompensas comunitarias — sin embargo, los ingresos anuales del protocolo están alrededor de $693K con tarifas bajando un 23% la semana pasada según DeFiLlama. Tokens fuera, uso aún no sigue.
Pensé en esto un rato después de terminar la tarea. El modelo de asociación B2B podría ser en realidad el camino más rápido hacia un pipeline de IA que funcione de verdad. Quizás la colaboración de datos de base necesita andamiaje empresarial antes de que pueda funcionar a gran escala. Esa es una elección de diseño razonable. Pero eso significa que el "colaborativo" en el desarrollo de IA colaborativa está actualmente señalando a un grupo muy específico.
Quién realmente aparece en las Datanets una vez que la infraestructura de asociación está en su lugar… esa parte aún está por escribirse.
La actividad reciente es casi en su totalidad asociaciones de protocolo bilaterales: DGrid para computación, Story Protocol para licencias de derechos, Chainbase para datos de Web3, PublicAI para etiquetado, TheoriqAI para agentes. Cada uno es un apretón de manos entre dos equipos, no actividad de contribuyentes abiertos. Mientras tanto, CoinMarketCap muestra que la oferta circulante ha crecido de 215.5M a más de 290M OPEN, mayormente a través de emisiones de recompensas comunitarias — sin embargo, los ingresos anuales del protocolo están alrededor de $693K con tarifas bajando un 23% la semana pasada según DeFiLlama. Tokens fuera, uso aún no sigue.
Pensé en esto un rato después de terminar la tarea. El modelo de asociación B2B podría ser en realidad el camino más rápido hacia un pipeline de IA que funcione de verdad. Quizás la colaboración de datos de base necesita andamiaje empresarial antes de que pueda funcionar a gran escala. Esa es una elección de diseño razonable. Pero eso significa que el "colaborativo" en el desarrollo de IA colaborativa está actualmente señalando a un grupo muy específico.
Quién realmente aparece en las Datanets una vez que la infraestructura de asociación está en su lugar… esa parte aún está por escribirse.