

Hace unos años, asumí que el recurso más importante en la IA era el procesamiento.
Quien tenga más potencia de procesamiento ganará. Esa suposición parecía obvia en su momento. Sin embargo, últimamente he estado prestando atención a algo mucho menos emocionante. No a la inteligencia. Ni siquiera a la precisión.
O más específicamente, ¿qué pasa cuando la memoria de las máquinas empieza a comportarse de manera diferente a la memoria humana?
Los humanos olvidan cosas todo el tiempo. Olvidamos conversaciones, detalles, nombres, errores. A veces, olvidar es saludable. Sistemas legales enteros están construidos alrededor de limitar cuánto tiempo cierta información persigue a las personas. Pero cuando una economía olvida información importante, las consecuencias pueden ser sorprendentemente costosas.
Esa distinción sigue molestándome cuando miro la infraestructura de IA.
La mayoría de la gente todavía habla de la IA como si el problema central fuera generar mejores respuestas. Sin embargo, cuanto más veo a las empresas experimentar con IA, menos convencido estoy de que mejores respuestas sean el verdadero cuello de botella. En muchos casos, el problema aparece después de que se genera la respuesta.
¿De dónde provino esa información?
¿Quién lo contribuyó?
¿Puede alguien verificarlo?
Y quizás lo más importante, si algo sale mal seis meses después, ¿puede alguien reconstruir lo que sucedió?
Esas preguntas suenan aburridas hasta que se involucra el dinero.
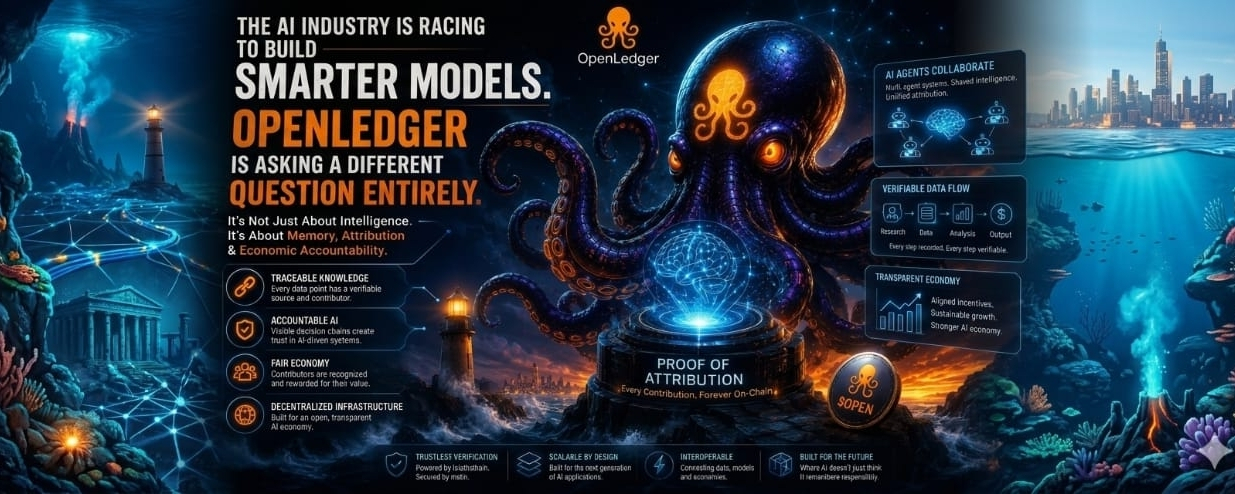
Muchos proyectos de IA están compitiendo en la carrera de inteligencia. Modelos más rápidos. Mejor razonamiento. Entrenamiento más eficiente. @OpenLedger parece estar mirando en otra parte. Casi debajo de la propia IA.
La forma en que lo interpreto, el proyecto está haciendo una pregunta extraña: ¿y si el recurso escaso no es la inteligencia, sino el conocimiento rastreable?
Al principio, pensé que eso sonaba como un ejercicio de marca sobre la propiedad de los datos. Cuanto más reflexionaba sobre ello, menos cómoda me sentía con esa explicación.
Porque una vez que los sistemas de IA comienzan a interactuar entre sí, la cadena de conocimiento se vuelve desordenada muy rápidamente. Imagina diez sistemas de IA contribuyendo a una sola salida. Uno proporciona investigación. Otro proporciona datos del mercado. Otro contribuye con registros históricos. Otros añaden análisis, filtrado o mecanismos de clasificación. Eventualmente aparece una respuesta. Todos ven la respuesta. Casi nadie ve el camino. Ese camino oculto puede terminar siendo más importante que la salida final.
Recuerdo haber leído sobre una institución financiera probando flujos de trabajo asistidos por IA. Lo que me interesó no fue si el modelo producía resultados útiles. Fue la discusión de cumplimiento después. La organización no preguntaba si la IA era inteligente. Preguntaban si podían explicar el proceso de toma de decisiones a los reguladores si era necesario. Eso se siente como una categoría de problema completamente diferente.
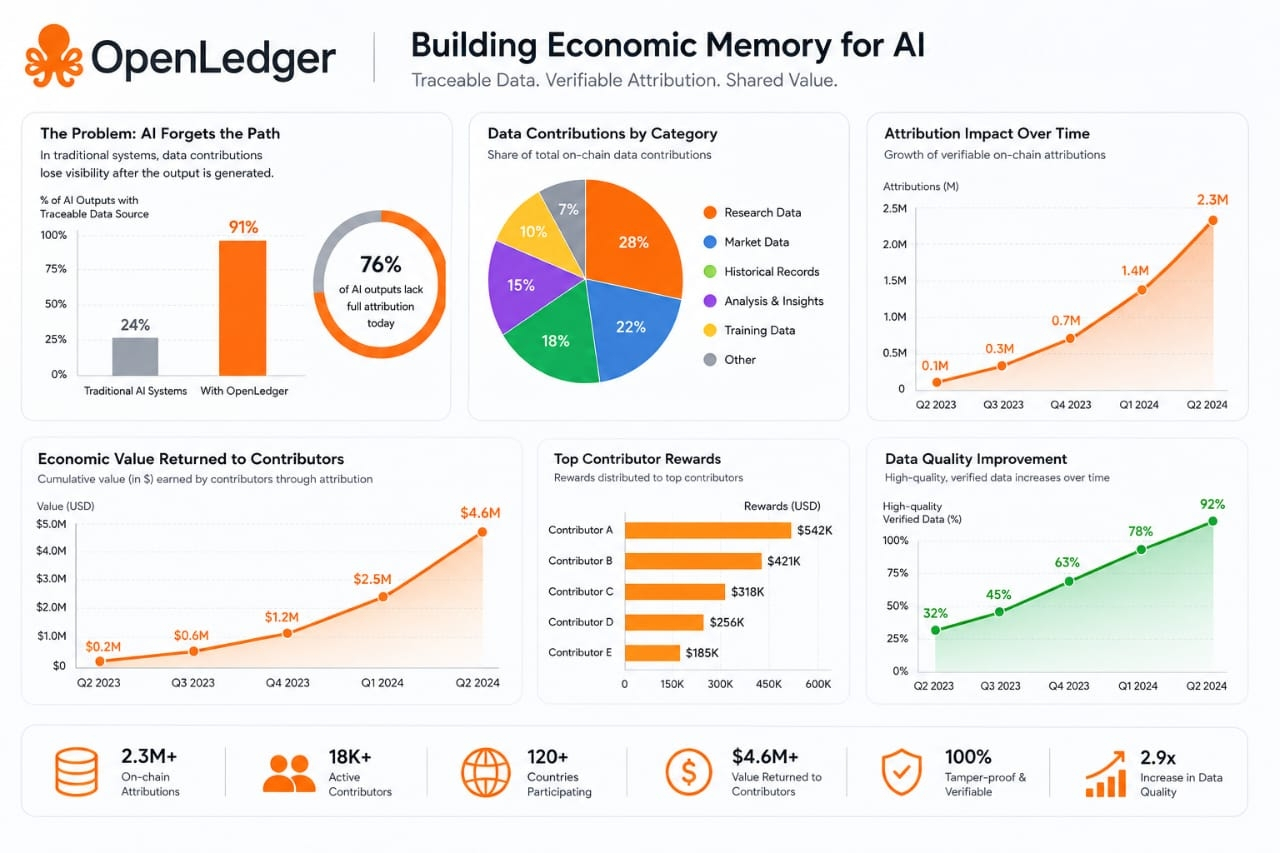
Una economía puede tolerar inteligencia imperfecta durante un tiempo sorprendentemente largo. Lo que le cuesta tolerar es la responsabilidad invisible.
Esa es parte de la razón por la que OpenLedger llamó mi atención.
En las cadenas de suministro, los registros de procedencia importan porque las empresas necesitan saber de dónde provienen los productos. En el cuidado de la salud, la documentación existe porque la memoria no puede ser confiable por sí sola. Sin embargo, gran parte de la IA todavía opera como si la atribución fuera opcional. Eso me parece extraño. Estamos construyendo sistemas que influyen cada vez más en decisiones económicas mientras tratamos la procedencia de la información como infraestructura secundaria. Quizás eso esté bien mientras la IA siga siendo una herramienta de productividad. No estoy tan seguro si la IA se convierte en un participante en la actividad económica en sí.
La tesis de OpenLedger comienza a verse más interesante a través de ese lente.
Si las contribuciones de datos permanecen rastreables, el conocimiento no simplemente entra en un modelo y desaparece. Los contribuyentes pueden potencialmente permanecer conectados a la creación de valor a largo plazo. Más importante aún, las cadenas de decisiones se vuelven observables. Prueba de Atribución, el mecanismo central, registra cada contribución de datos como un cambio de estado permanente y verificable en la cadena. No en la base de datos privada de una empresa. No en un registro que pueda ser revisado en silencio. En un libro mayor donde el registro depende de las matemáticas, no de la buena voluntad institucional.
El problema más grande podría ser la memoria económica.
Cuando un sistema pierde la pista de dónde se originó el conocimiento, gradualmente pierde su capacidad de distinguir la señal del ruido. Los contribuyentes de alta calidad se vuelven más difíciles de identificar. La mala información y la buena información comienzan a competir en condiciones similares. Eventualmente, los incentivos comienzan a desviarse. Ese proceso es lento. Casi invisible. Luego, de repente, todos notan que la calidad está deteriorándose.
He visto patrones similares fuera de la IA. Los mercados financieros a menudo pasan años optimizando la eficiencia antes de descubrir que accidentalmente eliminaron la transparencia. Las plataformas sociales optimizan el compromiso antes de darse cuenta de que debilitaron la credibilidad. Los sistemas rara vez se rompen de una vez. Se desvían. La infraestructura de IA puede enfrentar algo similar.
Aún así, no creo que el camino de OpenLedger sea sencillo. Hay un intercambio aquí de que nadie realmente habla. Todos apoyan la responsabilidad en teoría. El apoyo se vuelve mucho más delgado cuando la responsabilidad crea costos operativos. Por eso no veo a OpenLedger como un ganador garantizado. Lo que encuentro interesante es la dirección de la apuesta en sí.
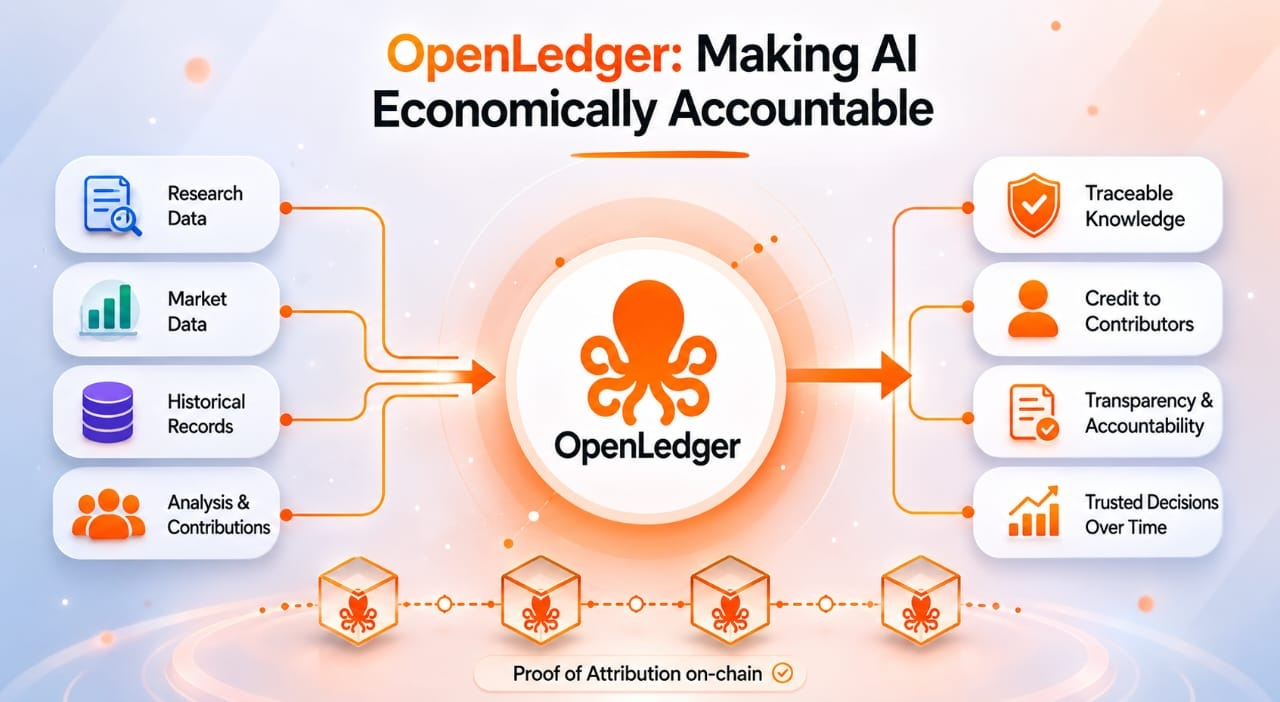
La industria está obsesionada con hacer que la IA sea más inteligente. OpenLedger parece más interesada en hacer que la IA sea económicamente responsable. Esos no son el mismo objetivo. Y sigo preguntándome si el mercado se está enfocando en la escasez equivocada.
El cómputo se vuelve más barato con el tiempo. Los modelos mejoran. Los costos de inferencia caen. Pero los registros confiables tienen una extraña tendencia a volverse más valiosos a medida que los sistemas crecen más complejos.
Quizás el olvido de la IA suena como un inconveniente técnico hoy. Un problema de producto. Algo que los ingenieros eventualmente resuelven. O tal vez el olvido se convierte en la fuente oculta de riesgo que nadie nota hasta que mercados enteros impulsados por IA dependen de recordar quién contribuyó, cuándo y por qué.
Esa es la apuesta que está haciendo OpenLedger.
Me parece más interesante que la mayoría de las apuestas que se están haciendo.
