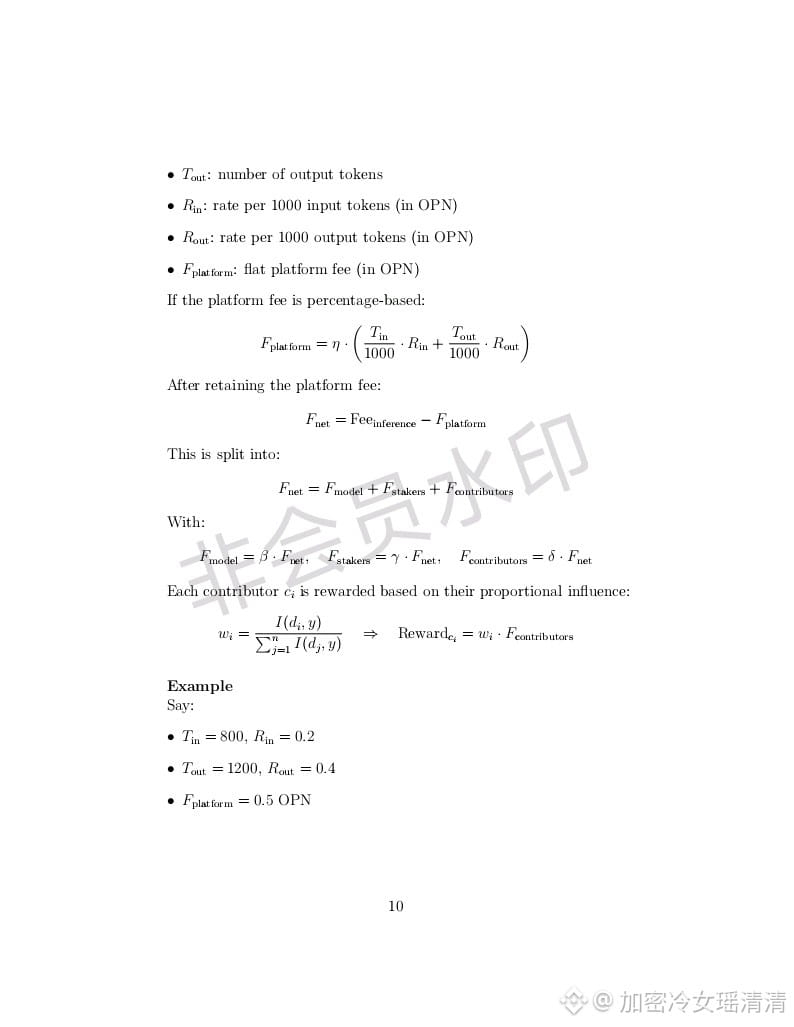
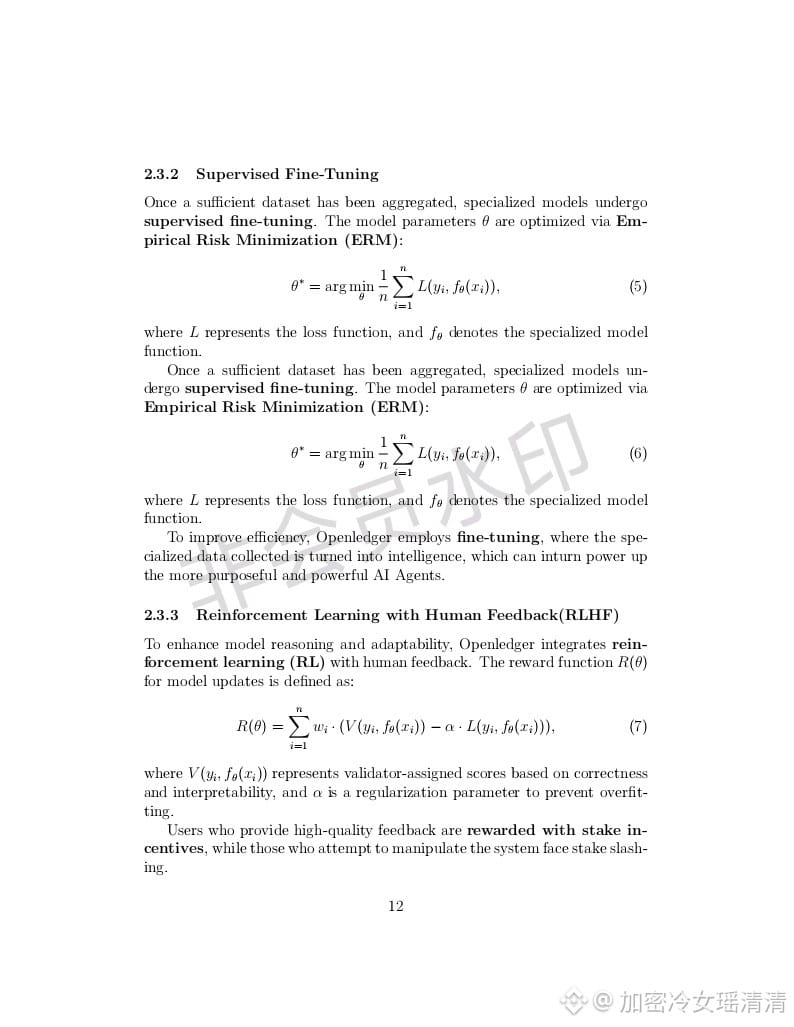
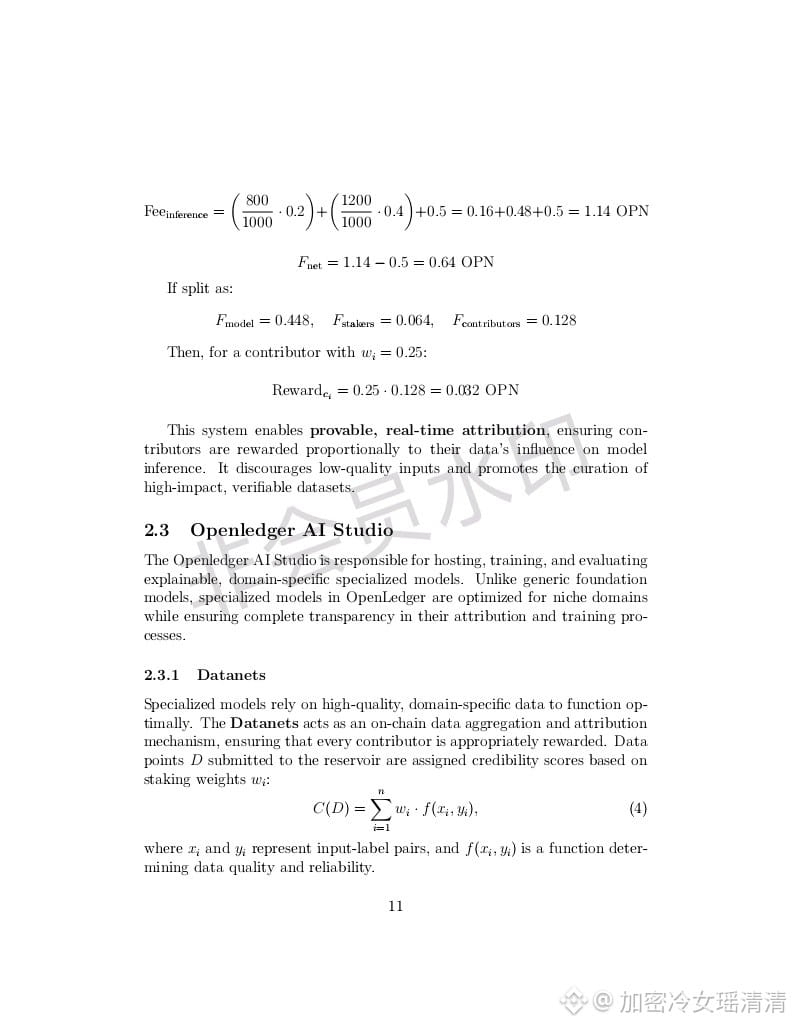
Hermanos, esta vez no revisé el registro de contribuyentes, me enfoqué en los logs de inferencia de OpenLoRA del @OpenLedger . Ese que dice que con una GPU puedes correr miles de modelos. Durante una semana estuve rastreando los registros de solicitudes y encontré un fenómeno interesante. En una misma GPU hay más de trescientos modelos de LoRA, pero más del setenta por ciento de las solicitudes de inferencia se concentran en solo cinco modelos. Los otros trescientos modelos casi no reciben atención. ¿Por qué? Porque aunque OpenLoRA técnicamente puede manejar muchos modelos a la vez, las reglas de distribución de tráfico siguen el peso de los nodos. El tráfico se prioriza hacia los modelos de los nodos que tienen más $OPEN apostados. Tu modelo puede ser excelente, pero si está en un nodo pequeño, las solicitudes de los usuarios nunca llegaran a ti. La arquitectura del #OpenLedger técnicamente tiene sus ventajas, puede correr cientos de modelos en una sola tarjeta sin caerse y controla la latencia bastante bien. Pero el modelo económico entrega todos los beneficios de esta tecnología a los grandes jugadores. Los modelos en nodos pequeños son como tiendas escondidas en callejones, ni siquiera se pueden ver los letreros. Lo más doloroso es que, al llamar al modelo, los usuarios pagan una tarifa de inferencia donde la proporción que se le asigna al creador del modelo es fija. No importa la calidad de tu modelo, si es llamado, recibes la misma proporción. Esto lleva a que nadie quiera invertir tiempo en optimizar modelos menos populares, porque la base de llamadas es demasiado pequeña, y aunque la proporción sea alta, no se gana casi nada. Mientras que esos modelos de cabeza, aunque su calidad sea promedio, ganan muchísimo porque tienen mucho tráfico. Rastreé los datos de un modelo poco popular. Este modelo tiene una precisión quince por ciento superior en un nicho específico, pero en una semana solo fue llamado menos de diez veces. El creador del modelo invirtió tiempo y potencia de cálculo para afinarlo, y al final solo recibe el $OPEN , que no cubre ni el costo del Gas que gastó. Y el creador del modelo de cabeza no hizo nada, simplemente porque está en un nodo grande, cada semana recibe ingresos sin hacer nada. Esta regla no está premiando la innovación técnica, sino que está premiando la unión del capital. El equipo no es que no sepa del problema, pero si cambian las reglas de distribución de tráfico a basarse en la calidad del modelo, los grandes apostadores no lo permitirán, y estarán atentos a cualquier cambio en el peso de los nodos para salir corriendo. Si realmente voy a invertir dinero en el desarrollo de modelos, hermano, prefiero quedarme en Bitcoin y Ethereum esperando el mercado alcista.

Publicación

--
OPEN
Holding
PnL acumuladas (%)
-1,93
-1.95%
Coste promedio
0,1899677
Último precio
0,178
A partir de los holdings de @加密冷女瑶清清
Hora de la captura: 2026-11-08 05:32