

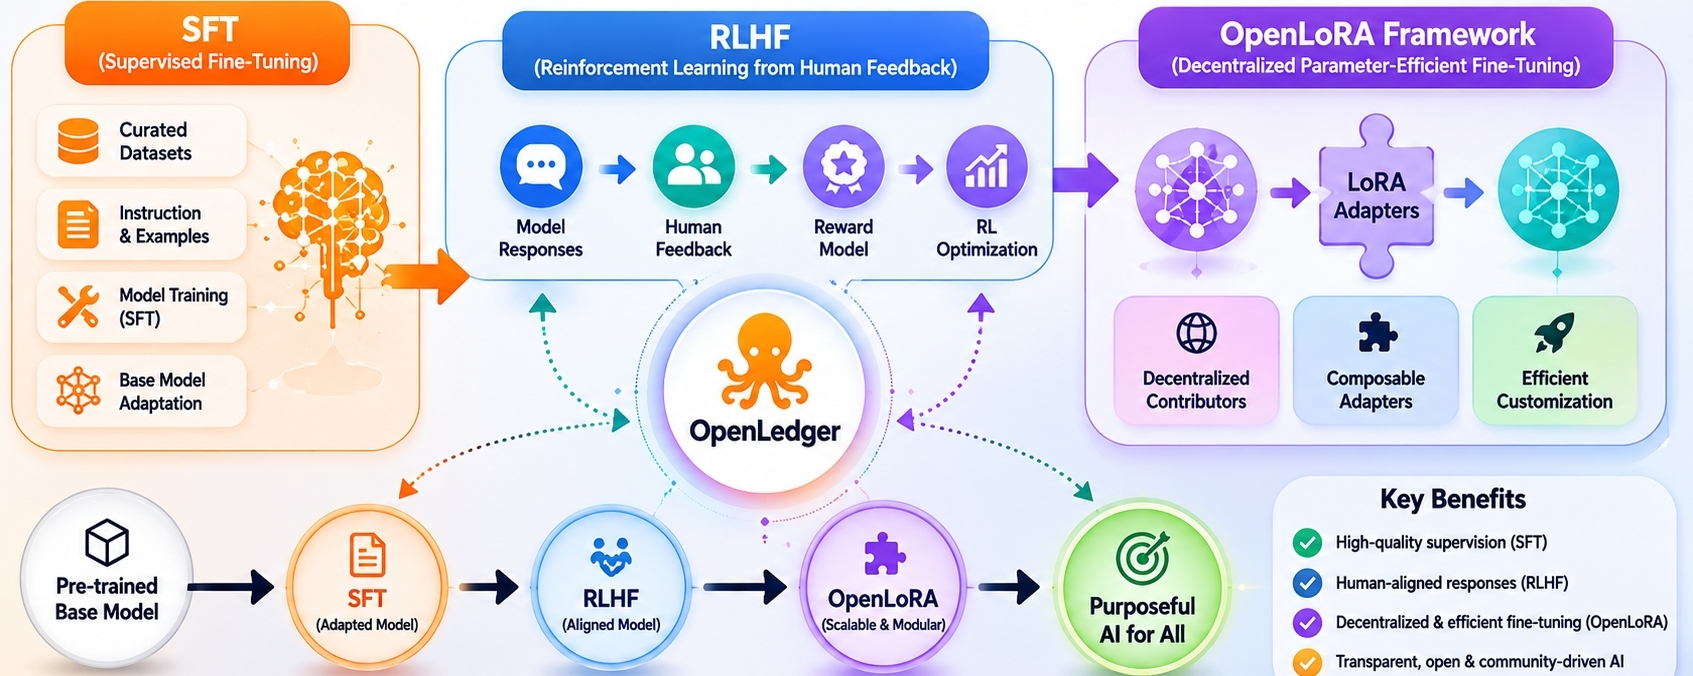
Lo que seguía llamando mi atención de OpenLedger no era la calidad del modelo. Era la pregunta de dónde realmente reside la fricción de alineación una vez que un sistema va más allá de entrenar un solo modelo y comienza a coordinar a contribuyentes, validadores, conjuntos de datos y bucles de retroalimentación a gran escala.
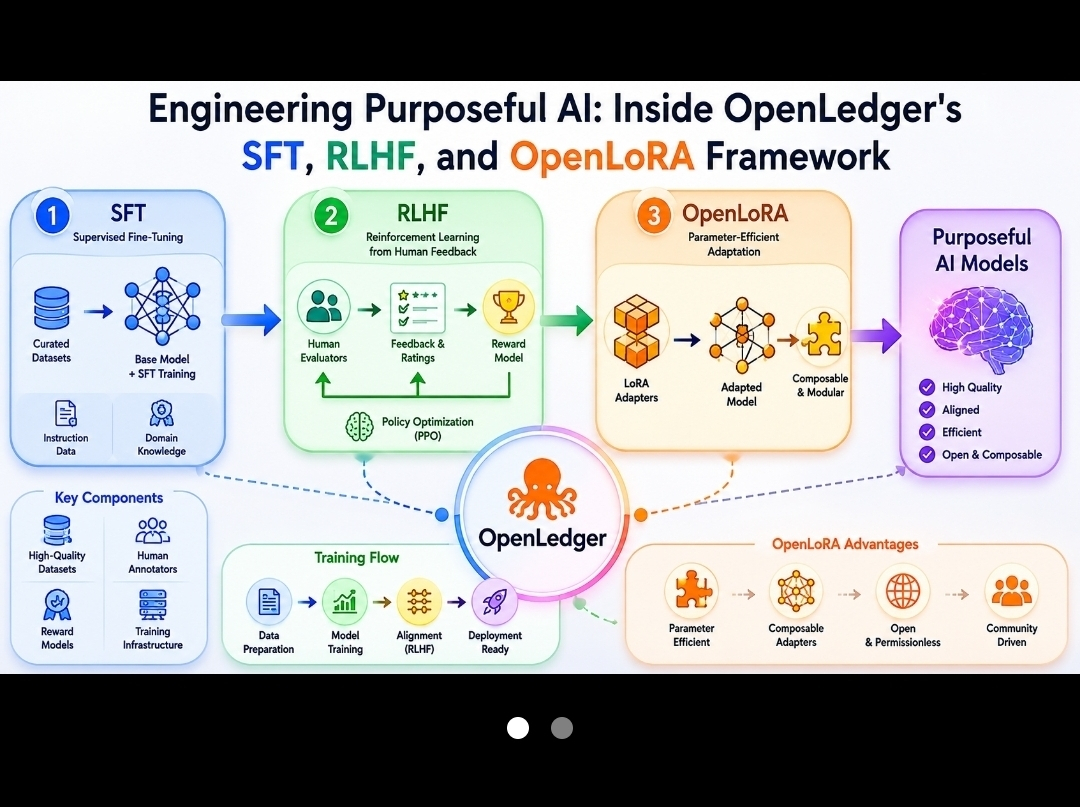
Dentro de OpenLedger, el problema interesante no es si SFT, RLHF o OpenLoRA funcionan individualmente. La mayoría de la gente ya acepta que sí. La pregunta más difícil es qué sucede cuando estos mecanismos se convierten en parte de un entorno de producción compartido donde múltiples actores moldean continuamente el comportamiento del modelo.
Ahí es donde empieza la tensión operativa.
Un modelo puede parecer fiable durante la evaluación y aun así volverse sorprendentemente inestable cuando se multiplican las vías de ajuste. Cada nuevo conjunto de datos introduce preferencias. Cada contribuidor introduce suposiciones. Cada optimización empuja en silencio al modelo hacia una versión distinta de la utilidad.
El reto no es crear inteligencia.
El reto es preservar la intención mientras se modifica la inteligencia.
Me di cuenta de esto al observar cómo OpenLedger combina ajuste supervisado, aprendizaje por refuerzo a partir de retroalimentación humana y adaptación modular mediante OpenLoRA. En el papel, estos componentes parecen complementarios. En la práctica, crean presiones en competencia que deben gestionarse en algún lugar.
Primero, toma SFT.
La mayoría de la gente piensa en el ajuste supervisado como la etapa directa. Entran ejemplos curados. Sale un mejor comportamiento. La realidad es más desordenada. Una vez que varios contribuyentes empiezan a suministrar datos de entrenamiento, el problema deja de ser la calidad y pasa a ser la consistencia.
Imagina dos contribuyentes resolviendo la misma tarea de soporte al cliente. Uno recompensa la brevedad. El otro recompensa las explicaciones exhaustivas.
Ningún conjunto de datos es necesariamente incorrecto.
Pero cuando ambos entran en la canalización de entrenamiento, el modelo empieza a aprender definiciones de éxito en conflicto.
El modo de fallo es sutil. Las salidas siguen siendo técnicamente correctas mientras se vuelven operativamente impredecibles.
Un usuario hace la misma pregunta dos veces y recibe estilos de respuesta dramáticamente diferentes.
No parece haber nada roto.
Aun así, la confianza empieza a erosionarse.
Ahí es donde el énfasis de OpenLedger en la atribución resulta más interesante que el propio entrenamiento. Si aparece un cambio conductual específico después de introducir ciertos conjuntos de datos, rastrear la influencia se vuelve posible en vez de ser especulativo.
El riesgo que se reduce no es la alucinación.
Es una ambigüedad sobre dónde se originó el desvío conductual.
Eso suena pequeño hasta que empieza la depuración.
Sin atribución, cada respuesta inesperada del modelo se convierte en una historia de detectives.
Con la atribución, la investigación se vuelve más estrecha y barata.
Aun así, la atribución introduce su propio costo. Los contribuyentes se vuelven participantes visibles en el comportamiento del modelo. La visibilidad crea rendición de cuentas, pero también crea vacilación. Algunos contribuyentes se vuelven más conservadores porque su influencia puede medirse.
Ese intercambio se siente real.
Una mejor trazabilidad a menudo significa experimentar más despacio.
Entonces entra el RLHF y todo se vuelve todavía menos limpio.
La retroalimentación humana suele presentarse como la capa de alineación. La etapa en la que los modelos aprenden lo que la gente realmente prefiere.
No estoy del todo convencido de que sea tan simple.
La retroalimentación humana a menudo captura la satisfacción inmediata con más eficacia que la utilidad a largo plazo.
Esa distinción importa.
Considera un escenario donde dos respuestas contestan la misma pregunta.
La confianza se convierte en un atajo.
Con el tiempo, la presión de la optimización puede empujar a los modelos hacia respuestas que se sienten mejor antes de volverse más verídicas.
OpenLedger no puede eliminar por completo esa tensión porque ningún marco puede. Lo que sí puede hacer es exponer más del proceso de alineación en lugar de ocultarlo detrás de una canalización centralizada.
Eso crea una prueba interesante.
Si dos grupos de retroalimentación no se ponen de acuerdo de forma constante sobre las salidas preferidas, ¿sus preferencias de quién deberían dominar?
No hay una respuesta obvia.
Sospecho que mucha gente asume que la descentralización resuelve automáticamente este problema.
No estoy seguro de que lo haga.
Simplemente hace visible el desacuerdo.
Y la visibilidad es distinta de la resolución.
Un ejemplo mecánico ilustra esto con claridad.
Supón que un modelo recibe 1.000 eventos de retroalimentación en tareas de razonamiento financiero.
Setecientas recompensan respuestas concisas.
Trescientos recompensan el análisis detallado del riesgo.
La vía de optimización depende por completo de cómo se ponderen esas señales.
La maquinaria técnica importa menos que las suposiciones de gobernanza incrustadas en ella.
Con el tiempo, alguien decide qué significa «mejor».
Incluso si esa decisión surge colectivamente.
La parte que más me interesa es OpenLoRA, porque ahí es donde la fricción de la alineación se vuelve tangible.
El ajuste fino tradicional a menudo se comporta como reemplazar partes de un motor mientras está en funcionamiento. Cada modificación lleva la posibilidad de consecuencias no intencionadas en otra parte.
OpenLoRA cambia la unidad de adaptación.
En lugar de modificar repetidamente modelos fundacionales grandes, los contribuyentes pueden construir adaptaciones especializadas que permanecen más modulares.
Eso suena como una mejora pura hasta que aparece la realidad operativa.
Un sistema modular reduce una categoría de fallos mientras crea otra.
Ahora el reto se convierte en la selección.
¿Qué adaptación debe usarse?
¿Qué versión debería recibir prioridad?
La fricción no desaparece.
Se mueve.
Creo que ese movimiento es una de las dinámicas más subestimadas en la infraestructura de IA.
Los sistemas rara vez eliminan la complejidad.
Lo reubican.
Parece que OpenLoRA traslada la complejidad desde el reentrenamiento del modelo hacia la coordinación del modelo.
Eso suele ser un buen intercambio.
Pero sigue siendo un intercambio.
Imagina dos LoRAs específicos de un dominio.
Uno se especializa en razonamiento legal.
Otro se especializa en soporte al cliente.
Por separado, ambos funcionan bien.
Un flujo de trabajo mixto requiere decisiones repentinas sobre enrutamiento, prioridad, compatibilidad y evaluación.
La capa del modelo se vuelve más fácil de actualizar.
La capa de coordinación se vuelve más difícil de gestionar.
¿Qué carga preferirías llevar?
De verdad creo que personas razonables podrían responder de manera distinta.
Esto también explica por qué la capa económica de OpenLedger termina volviéndose relevante.
No de inmediato.
No como especulación.
Como infraestructura.
Una vez que la atribución, la retroalimentación y la adaptación se vuelven actividades medibles, los incentivos inevitablemente entran en la conversación. Los contribuyentes necesitan razones para mantener conjuntos de datos. Los validadores necesitan razones para evaluar la calidad. Los proveedores de retroalimentación necesitan razones para participar con honestidad.
Con el tiempo, el papel del token OPEN aparece casi por necesidad, porque la coordinación sin incentivos tiende a decaer con la escala.
La pregunta interesante no es si existen incentivos.
La pregunta interesante es si los incentivos siguen recompensando la utilidad cuando llega el crecimiento.
La historia sugiere que ahí es donde muchos sistemas se atascan.
Lo que me hace volver a OpenLedger no es la promesa de un desarrollo de IA abierto. Muchos proyectos prometen apertura.
Es la disposición de revelar dónde se acumulan realmente los costos de la alineación.
No en la arquitectura del modelo.
No en las puntuaciones de los benchmarks.
En el espacio desordenado entre contribuyentes que intentan moldear la misma inteligencia hacia objetivos ligeramente distintos.
Quizá la prueba real sea sorprendentemente simple.
Si dos contribuyentes igualmente capacitados entrenan el sistema hacia definiciones distintas de calidad, ¿puede el marco revelar ese conflicto antes de que los usuarios experimenten las consecuencias?
Y si puede, ¿esa transparencia mejora los resultados o solo hace que el desacuerdo sea más fácil de observar?
No creo que la respuesta esté resuelta todavía.
Cuanto más miro SFT, RLHF y OpenLoRA juntos, menos parecen técnicas de optimización y más parecen mecanismos de negociación.
Una negociación entre conjuntos de datos.
Una negociación entre preferencias.
Una negociación entre apertura y coherencia.
La mayoría de los sistemas de IA ocultan esas negociaciones detrás de la interfaz.
Parece que OpenLedger está decidido a sacarlas a la luz.
Si eso termina produciendo una mejor inteligencia o simplemente más fricción visible sigue siendo algo que me encuentro probando.
