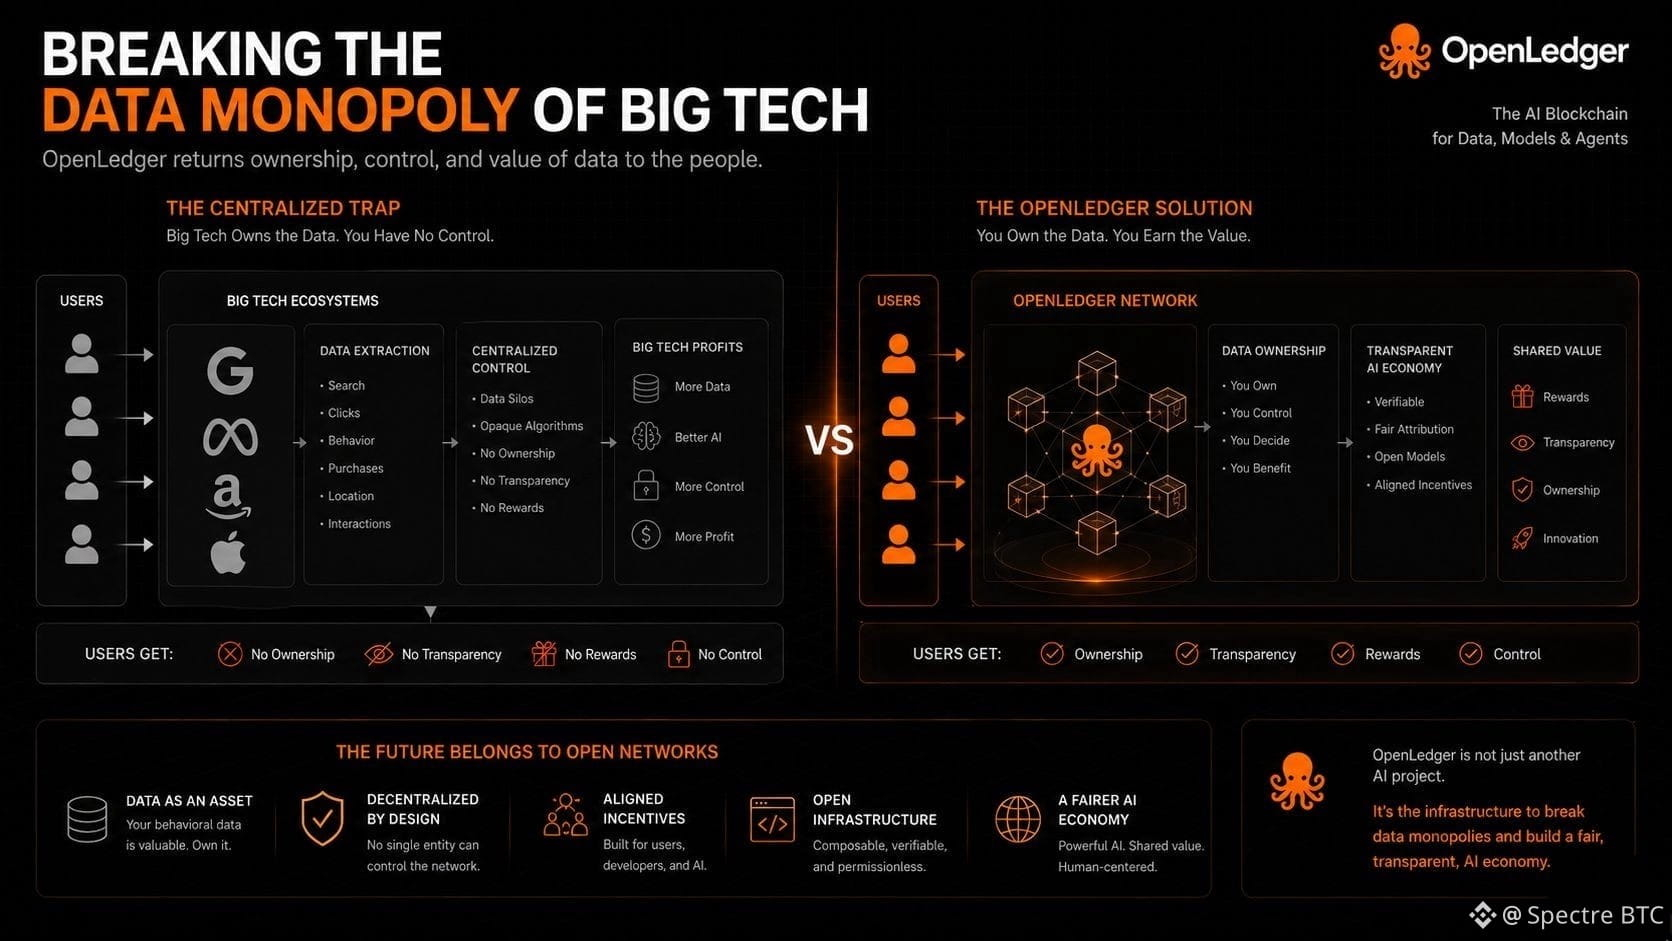
Una cosa que me di cuenta un poco tarde es que en la economía de la IA, el verdadero poder puede no venir de los modelos en sí, sino de los datos detrás de ellos.
La mayoría de la gente todavía ve la IA como una competencia en torno a GPUs, computación, velocidad de inferencia, o modelos cada vez más grandes. Pero con el tiempo, es probable que los modelos se conviertan en algo más commoditizado.
Lo que es mucho más difícil de replicar son los datos de comportamiento.
Cómo buscan las personas.
Cómo reaccionan.
Qué consumen.
Qué captura la atención.
Qué patrones dejan atrás cada día.
Esa es también la razón por la que las grandes tecnológicas han construido una dominancia tan duradera a lo largo de los años.
No solo poseen productos o plataformas.
Controlan el ciclo de retroalimentación.
Más usuarios generan más datos de comportamiento.
Más datos mejoran los algoritmos.
Mejores algoritmos optimizan la atención de manera más efectiva.
Y la atención optimizada mantiene a los usuarios dentro del ecosistema incluso más tiempo.
Un ciclo autorefuerzo que se vuelve extremadamente difícil de competir.
Por eso lo que OpenLedger está intentando me parece interesante.
La parte notable puede no ser simplemente “IA descentralizada,” como muchos lo describen, sino más bien el intento de redistribuir la propiedad de la capa de comportamiento en sí.
En teoría, los datos de los usuarios dejan de ser algo entregado inconscientemente a cambio de conveniencia y empiezan a convertirse en un activo digital reconocido.
Pero la pregunta más grande es si las personas realmente valoran la propiedad lo suficiente como para sacrificar la conveniencia.
Históricamente, la mayoría de los usuarios elige la simplicidad sobre el control.
Lo que me hace pensar que la próxima batalla de la IA puede no ser sobre quién construye el modelo más inteligente.
Puede ser sobre quién controla la infraestructura de comportamiento por debajo de él.
#OpenLedger $OPEN @OpenLedger