

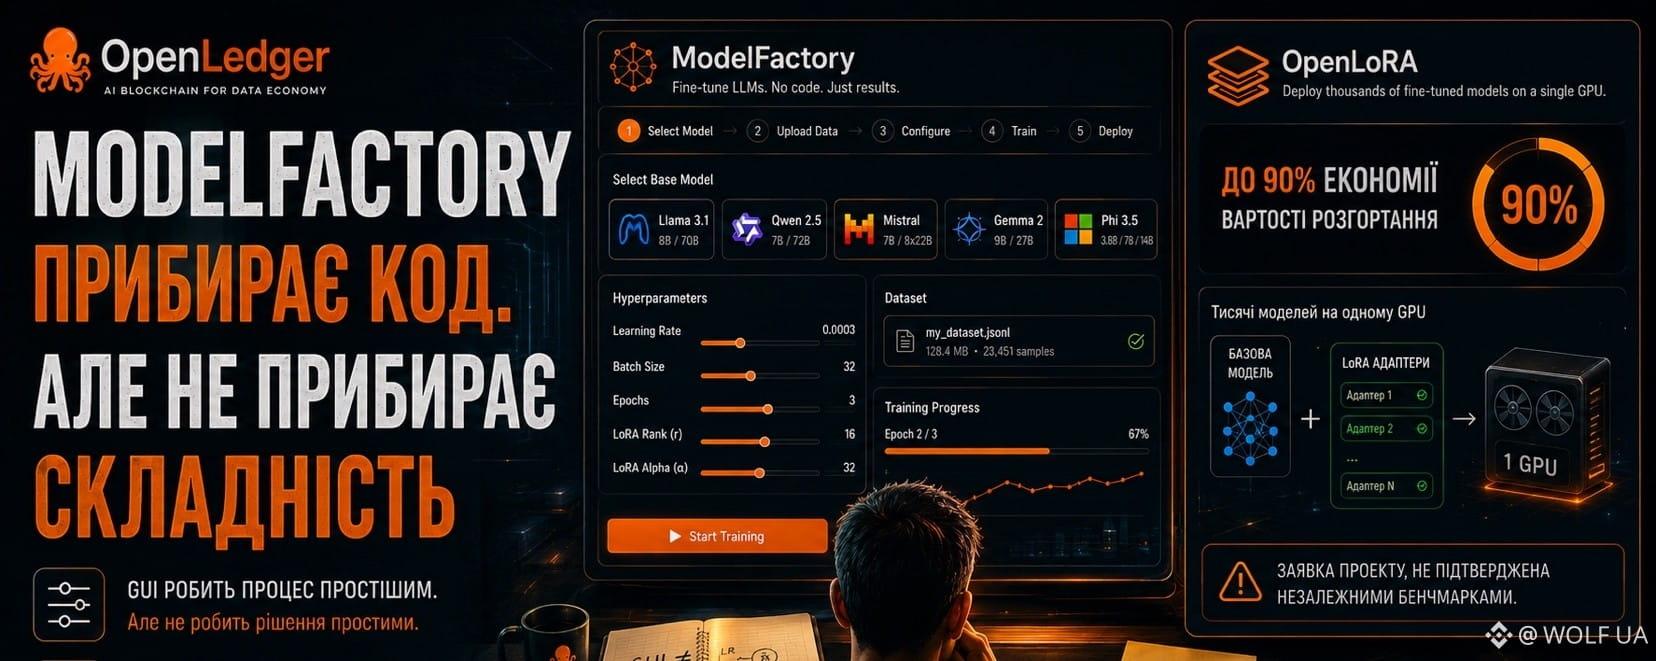

Hoy estuve pensando en qué hacer y decidí meterme con ModelFactory de @OpenLedger no por las descripciones bonitas, sino por una pregunta sencilla: ¿dónde termina el "disponible para todos" y comienza la verdadera complejidad?
La idea en sí es potente. En lugar de escribir código, ejecutar scripts de Python y lidiar con herramientas de ML, el usuario tiene una interfaz gráfica. Selecciona el modelo, carga sus datos, ajusta los parámetros y presiona start.
Para alguien que nunca ha trabajado con fine-tuning, esto realmente puede quitar una gran barrera de entrada.
Pero mientras leía la documentación, me di cuenta de un pensamiento: la interfaz elimina el código, pero no elimina las decisiones.
Los deslizadores para el learning rate, batch size o epochs se ven simples. El problema es que no explican qué valor tiene sentido para tu tarea específica. Si configuras todo al azar, el modelo puede aprender casi nada o, por el contrario, empezar a funcionar peor.
La misma sensación surgió con OpenLoRA. El concepto en sí parece técnicamente adecuado: los adaptadores LoRA ligeros realmente permiten utilizar la GPU de manera más eficiente. Pero cuando se trata de cifras como “hasta un 90% de ahorro”, aquí ya se quiere ver no una presentación, sino mediciones independientes.
Por ahora, la situación se ve así: ya hay una buena idea de ingeniería. La pregunta ahora no es si funciona en absoluto, sino cuánto funciona más allá de las demos y prototipos.
Por cierto, me gustaría escuchar a aquellos que realmente han hecho fine-tuning: ¿en qué momento la GUI deja de ser suficiente y quieres volver al control total a través del código?
