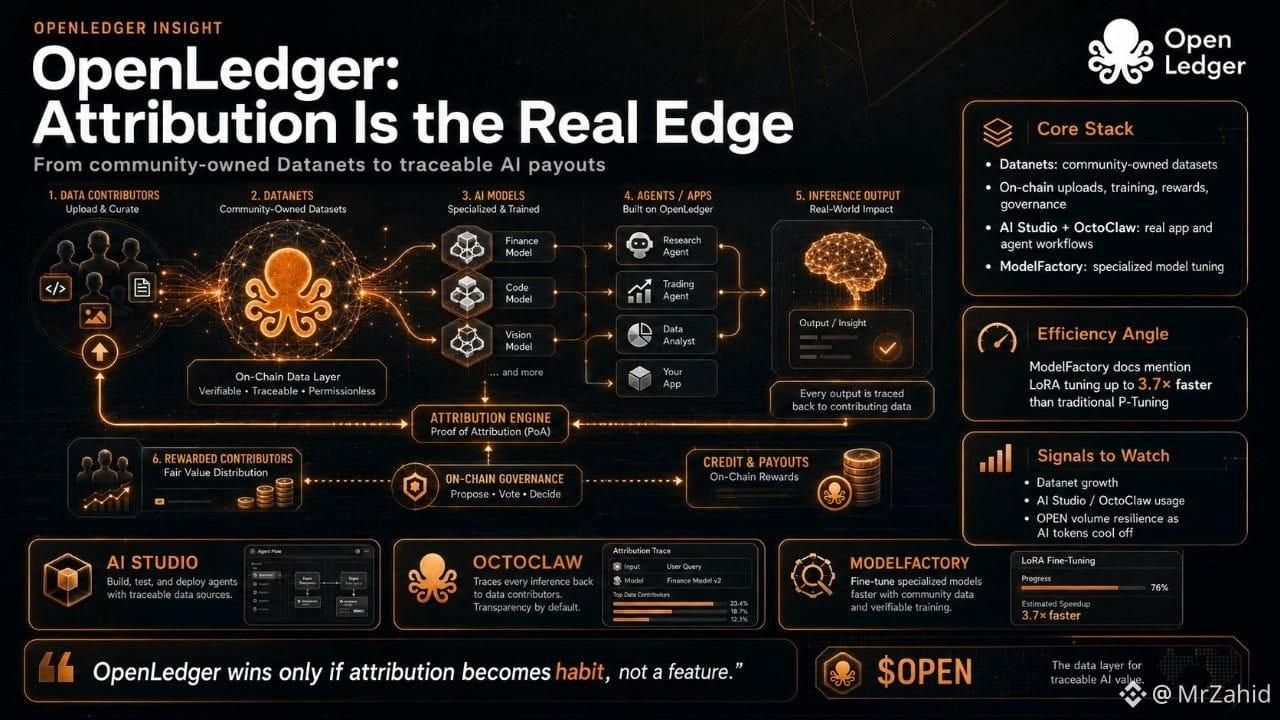
Acabo de terminar de revisar la documentación y el sitio de OpenLedger, y la parte que realmente me llamó la atención no es el típico discurso de “IA x blockchain”. Es la capa de atribución. OpenLedger está construyendo alrededor de Datanets, conjuntos de datos de propiedad comunitaria donde las cargas, el entrenamiento de modelos, los créditos de recompensa y la gobernanza están en la cadena. Eso importa porque el valor de la IA suele filtrarse hacia arriba: los usuarios crean datos, los modelos los absorben, las plataformas los monetizan, y los contribuyentes solo reciben buenas vibras.
Lo que OpenLedger transforma es la lógica de pago. Si la Prueba de Atribución puede rastrear qué datos influyeron en una inferencia, entonces los datos se convierten en un activo productivo negociable, no solo en combustible en bruto. Por eso, miraría a OpenLedger menos como un gráfico de meme y más como una jugada de infraestructura: la demanda debería provenir de constructores que necesiten datos verificados, modelos especializados y flujos de trabajo de agentes, no solo del hype minorista.
Mi lógica de trading es simple: no persigo velas verdes a ciegas. Primero seguiría tres señales: crecimiento de Datanet, uso real de aplicaciones de AI Studio/OctoClaw, y si el volumen de OPEN se mantiene saludable mientras los tokens de IA más amplios se enfrían. La documentación incluso afirma que la afinación LoRA de ModelFactory puede ser hasta 3.7x más rápida que el P-Tuning tradicional, lo cual es un verdadero ángulo de eficiencia.
Opinión caliente: OpenLedger gana solo si la atribución se convierte en un hábito, no en una función. 🚀
Fuentes utilizadas: La documentación de OpenLedger describe Datanets, acciones en la cadena, atribución y gobernanza; el sitio también destaca OctoClaw y AI Studio, mientras que los benchmarks de ModelFactory mencionan una afinación LoRA hasta 3.7x más rápida.
@OpenLedger $OPEN #OpenLedger