
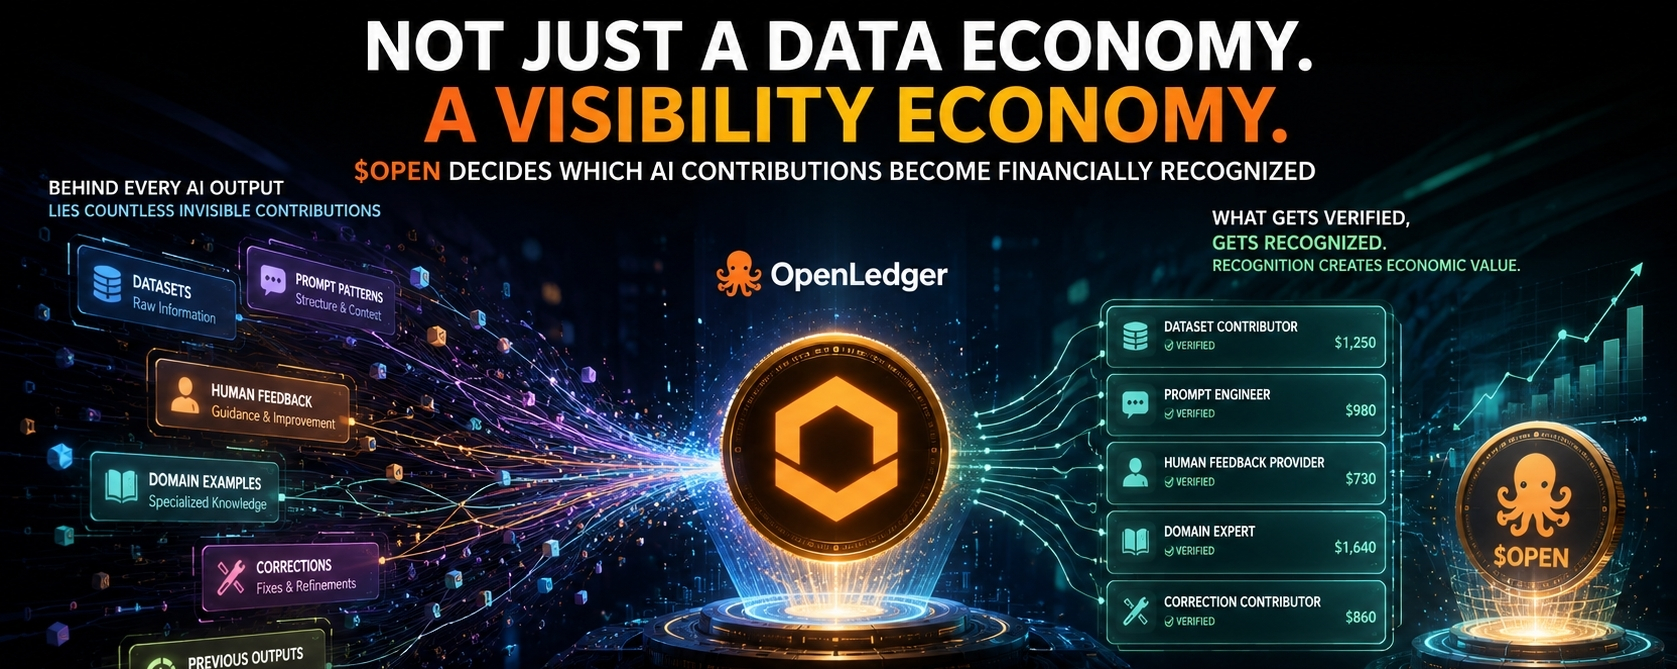
@OpenLedger Hay algo en la forma en que la gente etiqueta casualmente los proyectos como parte de la "economía de datos de IA" que siempre me hace frenar un poco. La frase suena suave y fácil de entender, casi demasiado fácil, como si las preguntas difíciles ya se hubieran resuelto antes de que alguien las pregunte. Con OpenLedger, la explicación superficial parece lo suficientemente simple: los contribuyentes proporcionan datos, los constructores los utilizan, las recompensas circulan a través de la red y ayudan a coordinar todo. Esa versión no es exactamente incorrecta, pero también se siente incompleta. Cuanto más lo pienso, más parece que la verdadera idea detrás de OpenLedger puede no estar centrada en los datos en sí. Puede estar centrada en algo mucho más complicado: decidir qué contribuciones dentro de los sistemas de IA se vuelven lo suficientemente visibles como para llevar un valor económico más adelante.
Esa distinción importa porque la contribución dentro de la IA rara vez es limpia o está aislada. La mayoría de las mejoras útiles no provienen de una sola carga perfecta ni de una acción evidente. Una respuesta de un modelo puede depender en silencio de miles de influencias superpuestas: conjuntos de datos de nicho, estructuras de prompts, correcciones, ejemplos específicos del dominio, retroalimentación por refuerzo, ediciones pequeñas o intervenciones humanas diminutas que mejoraron el sistema sin que nadie lo notara en ese momento. El problema es que los mercados suelen ser malos recompensando cosas que no pueden ver con claridad. Cuando la contribución se vuelve difícil de rastrear, a menudo deja de tratarse como propiedad y empieza a volverse trabajo invisible. Valioso, sí, pero imposible de reconocer correctamente. Lo que hace interesante a OpenLedger es que parece estar explorando si la contribución puede mantenerse visible económicamente en lugar de desaparecer en el fondo cuando el modelo la absorbe.
Por eso la formulación común de “mercado” se siente un poco demasiado superficial para describir lo que realmente podría estar pasando aquí. Los mercados tradicionales están diseñados para intercambios directos: alguien vende, alguien compra, la transacción termina y la transferencia de valor queda completa. Pero la contribución de IA se comporta de forma distinta. Un conjunto de datos útil o una corrección pueden seguir influyendo en las salidas mucho después de haberse realizado la contribución original. En algunos casos, el valor de esa contribución solo se vuelve evidente cuando se reutiliza en distintos agentes, aplicaciones o modelos. Otras veces, algo que al principio parecía irrelevante se vuelve crítico meses después porque cambia el ecosistema que lo rodea. Así que el reto real no es simplemente permitir la participación. El reto más profundo es preservar suficiente estructura alrededor de la contribución para que aún pueda reconocerse, verificarse y citarse financieramente más adelante, en lugar de desvanecerse en la memoria del modelo para siempre.
Ahí es también donde $OPEN empieza a sentirse más importante que solo otro token asociado a la actividad en la plataforma. El sistema no solo trata de incentivos: trata de elegibilidad. Y la elegibilidad es donde todo se complica muy rápido. Cada red, eventualmente, necesita reglas que decidan qué cuenta, qué merece recompensa, qué acciones califican, qué contribuciones importan más y cuáles se ignoran. Esas decisiones al principio siempre parecen técnicas, pero lentamente se vuelven preguntas económicas y sociales porque la visibilidad en sí tiene valor. Cuando un sistema determina quién puede ser reconocido, también determina quién permanece invisible. Si OpenLedger logra coordinar esa capa, entonces $OPEN quizá no solo se mueva a través de una economía de datos. Podría estar mucho más cerca del mecanismo que decide, desde el principio, qué formas de contribución de IA se vuelven económicamente reales.
Sigo pensando en la diferencia entre divulgación y prueba porque la brecha entre esas dos cosas probablemente sea mayor de lo que la gente se imagina. La divulgación es fácil: cualquiera puede decir que contribuyó con algo útil. Pero la prueba es diferente. Una prueba significa que el sistema realmente puede conectar una contribución con resultados significativos de una manera en la que otros confíen. Los mercados se preocupan por la prueba porque la prueba crea poder de fijación de precios. Sin ella, todo se convierte en ruido. Si OpenLedger puede hacer que la contribución sea rastreable sin convertir todo el proceso en un sistema lento de verificación manual, entonces el producto real quizá no sea solo datos. Podría ser visibilidad financiera: una estructura que permita que el trabajo útil dentro de sistemas de IA permanezca visible, reutilizable y reconocido económicamente a lo largo del tiempo.
Al mismo tiempo, no creo que esto se convierta automáticamente en una narrativa alcista perfecta, porque los sistemas de visibilidad atraen la manipulación casi por defecto. En el momento en que las personas entienden que el reconocimiento lleva a recompensas, cambia el comportamiento. Los participantes dejan de centrarse solo en la utilidad y empiezan a optimizar por lo que se puede medir. La cripto ya ha vivido este ciclo muchas veces. La granja de airdrops, la granja de engagement, el mining de liquidez, bucles de actividad falsa: pueden aparecer ecosistemas enteros como activos mientras producen muy poco valor duradero por debajo. Por eso, probablemente las cifras de participación a corto plazo por sí solas no dirán mucho sobre la fortaleza a largo plazo de OpenLedger. Lo más importante es vigilar si los creadores (builders), las aplicaciones o los agentes de IA se vuelven dependientes, con el tiempo, de registros verificados de contribuciones. La dependencia importa más que la actividad porque la dependencia sugiere que el sistema está creando memoria que otros realmente utilizan, en lugar de incentivos temporales que la gente abandona cuando las recompensas disminuyen.
Ahí es donde la dinámica del mercado alrededor de $OPEN podría volverse realmente interesante. Si la red solo atrae a contribuyentes que persiguen emisiones, entonces el token podría tener dificultades para mantener un significado económico más profundo. Pero si los creadores de IA empiezan a necesitar historiales de contribución verificados porque esos registros reducen la incertidumbre, mejoran la calidad del modelo, simplifican la lógica de pagos o facilitan confiar en la colaboración, entonces el token empieza a situarse más cerca de la capa central de coordinación del ecosistema. En esa situación, OpenLedger se sentiría menos como un simple mercado de datos y más como infraestructura para el reconocimiento financiero dentro de sistemas de IA. Y quizá ese sea el ángulo más importante que la gente aún está subestimando: la escasez real podría no ser de datos en sí. Podría ser la capacidad de seguir siendo visible para el sistema como alguien cuya contribución importó. No la visibilidad social o la atención, sino la visibilidad económica: la capacidad de ser reconocido como útil, reutilizable y digno de recompensa mucho después de que la contribución original desaparezca en la máquina.