

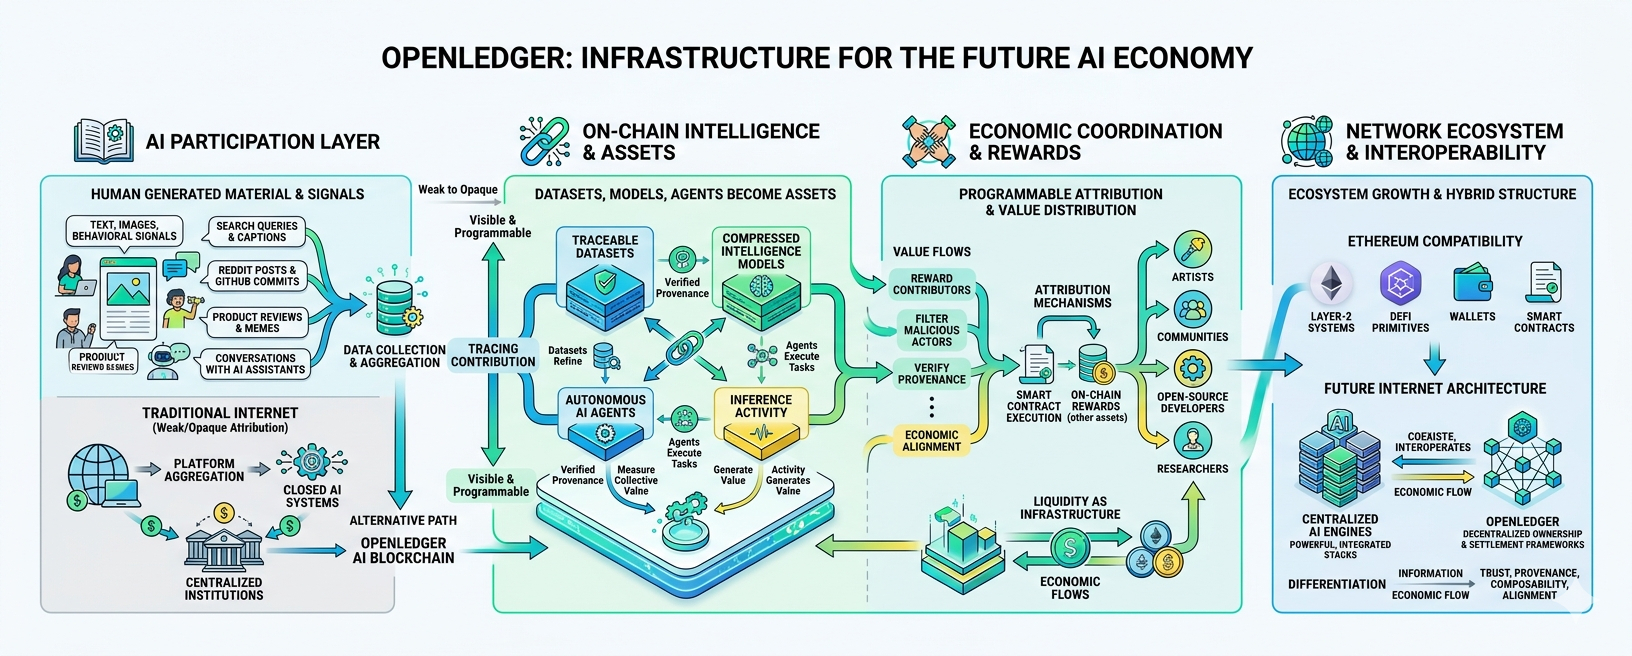
Todos los días, miles de millones de personas generan texto, imágenes, señales de comportamiento, conversaciones, preferencias, anotaciones, reacciones, correcciones y contexto cultural. La mayoría de esta actividad se siente casual y desechable mientras ocurre. Una consulta de búsqueda. Un pie de foto. Una publicación en Reddit. Un ticket de soporte. Un commit en GitHub. Una reseña de producto. Un meme. Una conversación con un asistente de IA a altas horas de la noche.
Pero debajo de la superficie, estos fragmentos se están convirtiendo en materia prima para la inteligencia de las máquinas.
Los grandes sistemas de IA absorben el conocimiento humano a escala planetaria, comprimiendo enormes cantidades de información social, lingüística, emocional y técnica en modelos que eventualmente se convierten en productos valorados en miles de millones de dólares. El proceso se siente tanto milagroso como extrañamente asimétrico. La humanidad alimenta continuamente la máquina, pero la propiedad de la inteligencia resultante a menudo se consolida en un número notablemente pequeño de instituciones.
Ese desequilibrio es donde proyectos como OpenLedger comienzan a importar.
No porque ya hayan resuelto el problema. No lo han hecho. Y, honestamente, las preguntas más difíciles pueden estar apenas comenzando.
Pero OpenLedger representa un intento serio de repensar la capa de infraestructura debajo de las economías de IA mismas — particularmente el problema de la atribución, la participación y la coordinación económica en un mundo cada vez más moldeado por sistemas autónomos.
La mayoría de la gente todavía subestima este cambio.
La conversación sobre IA aún está dominada por el rendimiento de modelos, GPUs, benchmarks y aplicaciones de consumo. Sin embargo, bajo la competencia visible entre chatbots y proveedores de modelos, hay un problema más profundo y no resuelto: ¿quién posee la producción de inteligencia en un Internet nativo de IA?
Esa pregunta se vuelve explosiva económicamente muy rápido.
Los sistemas modernos de IA se entrenan en océanos de material generado por humanos, pero los mecanismos para rastrear la contribución son débiles, opacos o inexistentes. Los artistas rara vez saben cuándo sus estilos influyen en los resultados. Las comunidades no pueden medir fácilmente cuánto valor creó su conocimiento colectivo. Los investigadores contribuyen con descubrimientos que se integran en sistemas más amplios sin participar directamente en la economía descendente. Incluso los desarrolladores de código abierto a menudo ven surgir ecosistemas de mil millones de dólares en torno al trabajo que liberaron gratis.
La estructura actual se asemeja más a la extracción que a la participación.
Y ahí es donde la tesis de OpenLedger comienza a volverse interesante.
El proyecto se posiciona no simplemente como otra blockchain, sino como una “Blockchain de IA” — infraestructura diseñada específicamente para la participación en IA. Esa redacción importa porque implica una suposición diferente sobre para qué sirven las blockchains. Las narrativas tradicionales de Capa-1 a menudo giran en torno a pagos, finanzas descentralizadas o ejecución de contratos inteligentes generalizados. OpenLedger, en cambio, trata a la IA misma como el actor económico principal.
Los conjuntos de datos se convierten en activos.
Los modelos se convierten en activos.
Los agentes se convierten en activos.
La actividad de inferencia se convierte en actividad económica.
La coordinación se vuelve programable.
La capa de infraestructura suele importar más de lo que la gente se da cuenta.
Históricamente, los sistemas que estandarizaron silenciosamente la propiedad y la liquidación a menudo remodelaron economías enteras. Internet en sí no fue valioso simplemente porque existían sitios web. Se volvió transformador porque los protocolos permitieron el intercambio de información a escala global. Los mercados financieros se expandieron porque los sistemas de liquidación se estandarizaron e interoperaron. Los marcos de propiedad intelectual alteraron los incentivos industriales porque la atribución podría ser formalizada y monetizada.
La IA parece estar entrando en una fase similar.
En este momento, la relación entre los sistemas de IA y la creación de valor sigue siendo borrosa. Las empresas recopilan, entrenan, despliegan, monetizan y optimizan dentro de ecosistemas en gran medida cerrados. La atribución es débil porque rastrear cómo los puntos de datos individuales influyen en los resultados es computacional y filosóficamente difícil. La contribución humana se disuelve en abstracción estadística.
OpenLedger está intentando construir infraestructura donde esas relaciones se vuelvan económicamente visibles.
Al menos en teoría.
La idea es engañosamente simple: si los datos, modelos y agentes autónomos están participando en la producción económica, entonces quizás deberían existir como entidades trazables en la cadena capaces de generar, recibir y distribuir valor.
Eso suena casi obvio una vez dicho claramente.
Sin embargo, la arquitectura moderna de Internet nunca fue realmente diseñada para esto. Los sistemas web existentes destacan en la distribución de contenido y la agregación de plataformas, pero luchan con la contabilidad de propiedad granular a escala de IA. Las bases de datos tradicionales pueden rastrear transacciones, pero no crean inherentemente capas de coordinación económica abiertas. Los sistemas de IA cerrados pueden optimizar el rendimiento, pero rara vez exponen mecanismos de recompensa transparentes para los contribuyentes.
El intento de OpenLedger de colocar la participación de IA directamente en la cadena refleja la creencia de que las futuras economías de inteligencia requieren infraestructura económica nativa, no meramente APIs adjuntas a plataformas centralizadas.
Esa distinción puede volverse cada vez más importante.
Considera lo que sucede a medida que los agentes autónomos de IA se vuelven más capaces en la próxima década. No robots de ciencia ficción, sino simplemente entidades de software que realizan continuamente tareas económicas en línea. Agentes que gestionan liquidez. Agentes que analizan investigaciones. Agentes que negocian servicios. Agentes que generan medios. Agentes que coordinan logística. Agentes que entrenan modelos más pequeños especializados en dominios de nicho.
Si estos sistemas comienzan a interactuar continuamente a través de los mercados digitales, las preguntas sobre identidad, propiedad, compensación y verificación se vuelven inevitables.
¿Quién posee la salida de un agente autónomo?
¿Quién recibe pago cuando un modelo mejora a partir de datos comunitarios?
¿Cómo se recompensa a los contribuyentes?
¿Cómo se filtran los actores maliciosos?
¿Cómo transaccionan los agentes entre sí?
¿Cómo verifican los sistemas la procedencia?
¿Cómo surge la confianza en economías nativas de máquinas?
Estas ya no son meramente preguntas técnicas. Son preguntas institucionales.
Y, honestamente, eso puede convertirse en la verdadera batalla económica.
El énfasis de OpenLedger en monetizar conjuntos de datos, modelos y agentes refleja el reconocimiento de que las futuras economías de IA pueden girar menos en torno a la propiedad de software estático y más en torno a sistemas de inteligencia que operan continuamente. En ese entorno, la liquidez misma se convierte en infraestructura. Los activos ya no son archivos pasivos sentados en servidores. Se convierten en entidades productivas que generan salidas, interactúan con redes y potencialmente ganan flujos económicos continuos.
Eso cambia el significado de la propiedad digital.
Hoy, la propiedad en línea a menudo es superficial. Los usuarios técnicamente “poseen” cuentas, tokens o contenido, pero la mayor parte del valor se acumula en plataformas que coordinan la atención y la computación. La dirección filosófica más amplia de OpenLedger sugiere un modelo diferente donde los contribuyentes participan más directamente en la producción de inteligencia misma.
Si esa visión tiene éxito es otra pregunta por completo.
Porque las dificultades aquí son enormes.
La atribución dentro de los sistemas de IA es uno de los problemas de coordinación más difíciles en la computación moderna. Las redes neuronales no exponen naturalmente mapas causales claros entre contribuciones de datos específicas y resultados finales. La creatividad humana en sí misma es profundamente derivativa e interconectada. Los límites entre inspiración, contribución, transformación y replicación a menudo son ambiguos incluso antes de que las máquinas entren en la ecuación.
Intentar formalizar la atribución a gran escala podría volverse costoso computacionalmente, socialmente controvertido y vulnerable a la manipulación.
Ahí es donde las cosas comienzan a volverse incómodas.
Los sistemas abiertos atraen spam.
Los incentivos económicos distorsionan el comportamiento.
La agricultura de datos de baja calidad podría abrumar las contribuciones significativas. Los especuladores pueden perseguir recompensas de tokens sin crear una utilidad genuina. Los contribuyentes podrían optimizar para métricas de atribución medibles en lugar de la calidad real del conocimiento. Las estructuras de gobernanza podrían convertirse en politicizadas. La extracción económica podría simplemente reaparecer en nuevas formas bajo una marca descentralizada.
La historia de la blockchain ofrece muchas advertencias aquí.
Las narrativas alrededor de la descentralización a menudo chocan con las realidades de la concentración, los incentivos pobres, la débil participación en la gobernanza y el exceso especulativo. La infraestructura por sí sola no garantiza resultados equitativos. A veces, simplemente cambia quién captura el valor.
Por lo tanto, OpenLedger enfrenta un desafío más grande que la tecnología misma: construir mecanismos de coordinación creíbles que produzcan una utilidad genuina a largo plazo en lugar de actividad financiera temporal.
La ejecución importa más que la narrativa.
Y los proyectos de infraestructura son notoriamente difíciles porque su éxito depende de que emerjan ecosistemas a su alrededor. El mercado rara vez recompensa la infraestructura de inmediato. Los protocolos de Internet temprano parecían aburridos en comparación con las aplicaciones de consumo. La infraestructura de la nube inicialmente parecía menos emocionante que las plataformas sociales. Los raíles de pago importaban profundamente a pesar de ser mayormente invisibles para los usuarios.
Si OpenLedger tiene éxito en algún sentido significativo, es probable que suceda en silencio al principio.
Desarrolladores integrando sistemas de atribución.
Los agentes de IA utilizan raíles económicos estandarizados.
Proveedores de datos participando en estructuras de recompensa.
Modelos interoperando a través de ecosistemas.
Comunidades experimentando con estructuras de propiedad compartida.
Estos son procesos de coordinación lentos, no momentos virales.
La compatibilidad del proyecto con Ethereum también es estratégicamente significativa. En lugar de aislarse como un ecosistema completamente separado, OpenLedger parece reconocer que las futuras economías de IA probablemente requerirán interoperabilidad con la infraestructura crypto existente. Las billeteras, contratos inteligentes, sistemas de Capa-2 y primitivos financieros descentralizados ya forman una capa de coordinación emergente para activos programables.
Reducir la fricción importa porque la adopción de infraestructura a menudo depende menos de la superioridad teórica y más de la simplicidad de integración.
Los sistemas sobreviven cuando se conectan a patrones de comportamiento existentes.
Eso puede sonar mundano en comparación con grandes visiones sobre IA descentralizada, pero históricamente es exactamente cómo se difunden las tecnologías fundamentales.
Aún así, el escepticismo sigue siendo necesario.
Una de las realidades incómodas del desarrollo de IA es que los sistemas centralizados actualmente poseen enormes ventajas estructurales. El entrenamiento de modelos de frontera requiere vastos recursos computacionales, talento de investigación de élite, técnicas de optimización propietarias y enormes gastos de capital. Los ecosistemas abiertos pueden luchar por competir directamente con pilas de IA corporativas estrechamente integradas, optimizadas a escala industrial.
La infraestructura de IA descentralizada puede no reemplazar a la IA centralizada tanto como complementarla o restringirla.
Esa distinción importa.
OpenLedger puede volverse valioso no porque supere a los proveedores centralizados en la generación de inteligencia cruda, sino porque ofrece mecanismos de propiedad y coordinación alternativos en torno a la actividad de IA misma. En otras palabras, la capa de propiedad puede volverse más importante que la capa de computación con el tiempo.
Esta posibilidad se pasa por alto con frecuencia.
A medida que las capacidades de IA se convierten en mercancía, la diferenciación puede desplazarse cada vez más hacia la confianza, la procedencia, la participación económica y la interoperabilidad. A los usuarios les puede importar menos las mejoras marginales de referencia y más si los sistemas son transparentes, composables y económicamente alineados con los contribuyentes.
El futuro de Internet podría evolucionar hacia una estructura híbrida donde motores de inteligencia centralizados coexistan con marcos de propiedad y liquidación descentralizados.
OpenLedger parece estar posicionado en torno a esa posibilidad.
Y hay una dimensión filosófica más profunda debajo de todo esto.
Durante décadas, Internet monetizó principalmente la atención. Las plataformas competían para captar el engagement, agregar el comportamiento del usuario y vender acceso dirigido. La IA cambia la ecuación porque la actividad humana en sí misma se convierte en sustrato de entrenamiento para la cognición de las máquinas. La economía ya no solo cosecha clics. Está cosechando señales de inteligencia.
Esa transformación altera la relación entre las personas y los sistemas digitales.
La expresión humana se vuelve productiva económicamente de nuevas maneras.
Las comunidades se convierten en entornos de entrenamiento.
El comportamiento se convierte en refinamiento del modelo.
El conocimiento se convierte en infraestructura.
En algún momento, las sociedades pueden exigir sistemas que contabilicen estas contribuciones de manera más transparente.
No necesariamente por idealismo, sino porque la escala de la extracción de valor impulsada por IA podría volverse políticamente y económicamente difícil de ignorar.
OpenLedger existe dentro de esa tensión emergente.
Está intentando crear infraestructura donde la producción de inteligencia se vuelva económicamente legible — donde la participación, la atribución y la propiedad sean programables en lugar de invisibles. Si la tecnología blockchain es en última instancia el sustrato correcto para esto sigue siendo incierto. Si la gobernanza descentralizada puede coordinar efectivamente tales sistemas sigue siendo incierto. Si los contribuyentes realmente reciben resultados más justos sigue siendo incierto.
Hay muchas formas en que esto podría fallar.
Pero las preguntas que se hacen son cada vez más inevitables.
¿Quién posee el valor generado por máquinas?
¿Quién participa en las economías de IA?
¿Cómo debería funcionar la atribución?
¿Qué significa el trabajo digital cuando los humanos y las máquinas colaboran continuamente?
¿Qué pasa con la propiedad cuando la inteligencia en sí misma se vuelve modular, programable y autónoma?
Estas ya no son preguntas marginales de crypto. Son preguntas económicas emergentes para el mismo Internet.
Y quizás esa sea la forma más importante de entender OpenLedger.
No como un token.
No como otra capa especulativa.
No incluso principalmente como un producto de IA.
Pero como parte de un intento más amplio de rediseñar los sistemas de contabilidad invisibles debajo de las futuras economías de inteligencia.
Porque eventualmente, la IA no solo generará contenido o automatizará flujos de trabajo. Participará continuamente en mercados, sistemas de gobernanza, coordinación financiera, investigación, producción de medios y estructuras laborales en línea. Internet podría evolucionar lentamente de una red de sitios web a una red de inteligencias interactivas.
Si eso sucede, la infraestructura que gobierna la atribución y la propiedad podría volverse extraordinariamente importante.
Los sistemas construidos ahora pueden determinar silenciosamente quién captura valor más adelante.
La mayoría de la gente todavía subestima este cambio.
Y, honestamente, nadie sabe completamente a dónde lleva.
