Título:
OpenLedger Se Siente Como una Cadena de IA… Pero $OPEN Podría Estar Realmente Precio de Atribución, No de Cómputo 🧠🔍
Si miras de cerca el paisaje de IA Descentralizada (DeAI), el 90% de los proyectos se ven idénticos. Están compitiendo para convertir el poder de cómputo en una commodity—esencialmente construyendo granjas de servidores descentralizadas para alquilar GPUs. Pero OpenLedger ($OPEN) está ejecutando, en silencio, un libro de jugadas fundamentalmente diferente.
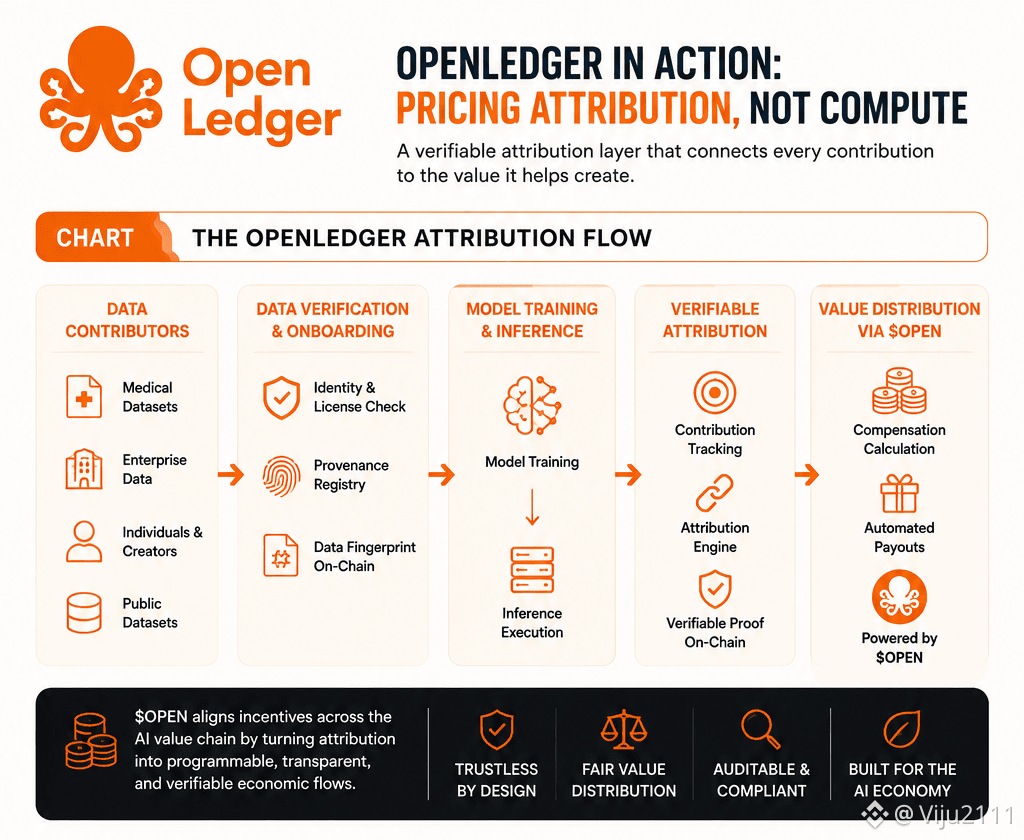
Aunque parece, respira y actúa como una blockchain de IA de alto rendimiento estándar en la superficie, su motor económico central no está valorando ciclos de cómputo. Está valorando la atribución de datos de IA.
Aquí está por qué esta distinción importa para el valor futuro de $OPEN.
La Trampa de Cómputo vs. El Cuello de Botella de Datos
Alquilar GPUs (cómputo descentralizado) es una carrera hacia el fondo. Las grandes empresas tecnológicas están construyendo enormes centros de datos centralizados, y los protocolos de cómputo web3 están constantemente bajando precios entre sí. El cómputo es una commodity.
Los datos, sin embargo, no lo son. El mayor cuello de botella en la IA hoy no es encontrar una tarjeta gráfica; es adquirir datos de alta calidad, especializados y verificablemente limpios para entrenar modelos. La arquitectura de OpenLedger—construida como una infraestructura compatible con EVM usando el OP Stack—se enfoca completamente en este pipeline de datos. A través de lo que ellos llaman Datanets, las comunidades pueden co-crear, alojar y curar conjuntos de datos especializados en la cadena.
Entra la Prueba de Atribución (PoA)
Aquí es donde la física del token $OPEN se vuelve interesante. En lugar de usar un mecanismo estándar de Prueba de Trabajo o Prueba de Participación para asegurar meramente las transacciones, OpenLedger implementa la Prueba de Atribución (PoA).
💡 La Prueba de Atribución es un mecanismo a nivel de protocolo que rastrea exactamente cómo un conjunto de datos específico, LoRA, o modelo base influye en la salida final de un agente de IA.
Cuando se despliega un modelo de IA o un agente de IA responde a una consulta, OpenLedger rastrea la ascendencia de los datos utilizados de vuelta en la cadena. Si tus datos contribuidos ayudaron a afinar ese modelo, el protocolo lo verifica y asegura que se te otorgue crédito. @OpenLedger #OpenLedger