


Hoy es 15 de diciembre, y es nuestro primer programa después de la pausa. Muchos de ustedes probablemente saben que estuve hospitalizada una semana, así que esa fue la razón de la pausa. Durante los días en el hospital, fue bastante difícil, ya que después de perder la salud y la libertad de movimiento, uno se da cuenta de la importancia de la salud. Cuando no estás sano, no piensas en ganar dinero ni en otras distracciones, y el dinero, en cierto sentido, no ayuda mucho con tu enfermedad, porque hay ciertos tipos de cáncer que no se pueden curar, y no importa cuántos recursos tengas. Dado que entendemos la importancia de la salud y que somos una comunidad que enfatiza la acción junto con el conocimiento, no solo debemos saberlo, sino también actuar en consecuencia. Por ejemplo, después de entender la importancia de la salud, deberías tomarte el tiempo para descansar, comer a tiempo, hacer ejercicio regularmente, y evitar hábitos nocivos como fumar y beber alcohol. Hacer es siempre mucho más difícil que saber, como mencioné en (todos deberían tener un BTC); si entiendes Bitcoin, deberías comprarlo de inmediato, incluso si es solo 0.01, eso es realmente entender el valor de Bitcoin.
Volviendo al tema, hoy echaremos un vistazo a la 62ª edición del launchpool de Binance-VANA y predeciremos el rango razonable del precio del token.
Suministro total de tokens de la generación inicial: 112,641,600 VANA (93.87% del suministro máximo de tokens)
Suministro máximo de tokens: 120,000,000 VANA
Cantidad inicial de circulación de VANA en Binance al momento del lanzamiento: 30,084,000 VANA (25.07% del suministro máximo de tokens)
Total en Launchpool: 4,800,000 VANA (4% del suministro máximo de tokens)
Introducción
Vana es una red orientada a los datos propios del usuario. Vana L1 permite a los usuarios agregar datos a DataDAO, mientras mantienen el control y la privacidad.
Los desarrolladores pueden utilizar estos conjuntos de datos descentralizados para crear la próxima generación de aplicaciones, como modelos de IA y dApps impulsadas por datos.
Arquitectura del sistema
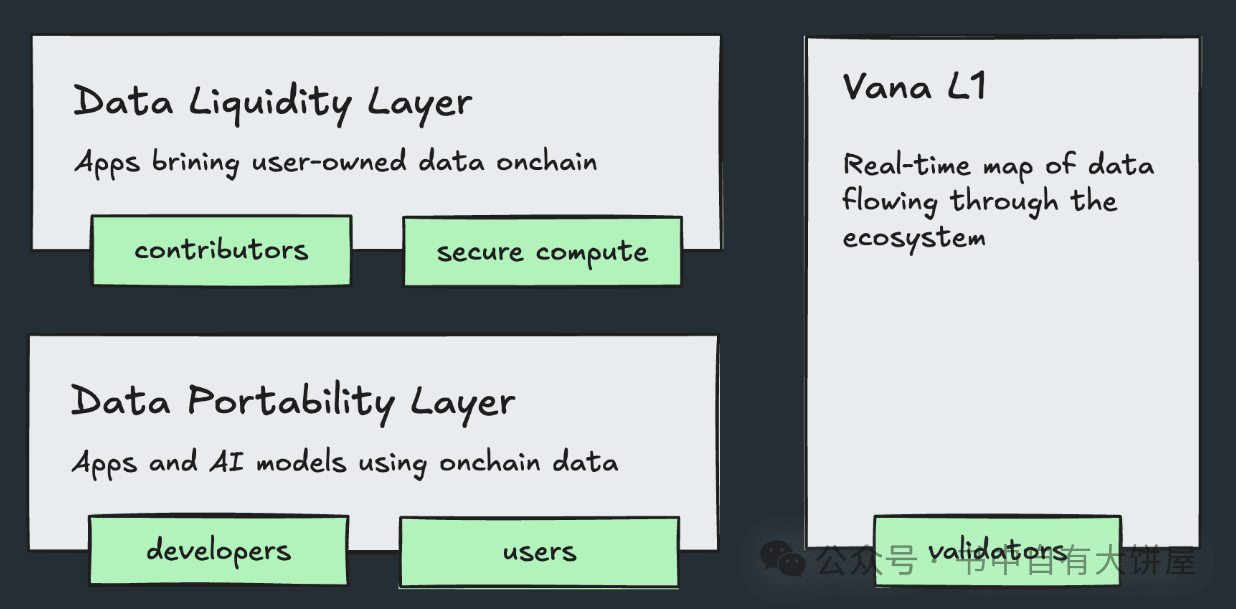
La red está compuesta por dos capas principales que aseguran la propiedad, seguridad y disponibilidad de los datos:
La capa de flujo de datos: la base operativa de las organizaciones autónomas descentralizadas de datos (DataDAOs), destinada a llevar los datos a la cadena y convertirlos en activos digitales transferibles.
Capa de portabilidad de datos: soporta aplicaciones basadas en datos de usuarios, logrando la soberanía del usuario a través de datos verificados.
Capa de flujo de datos
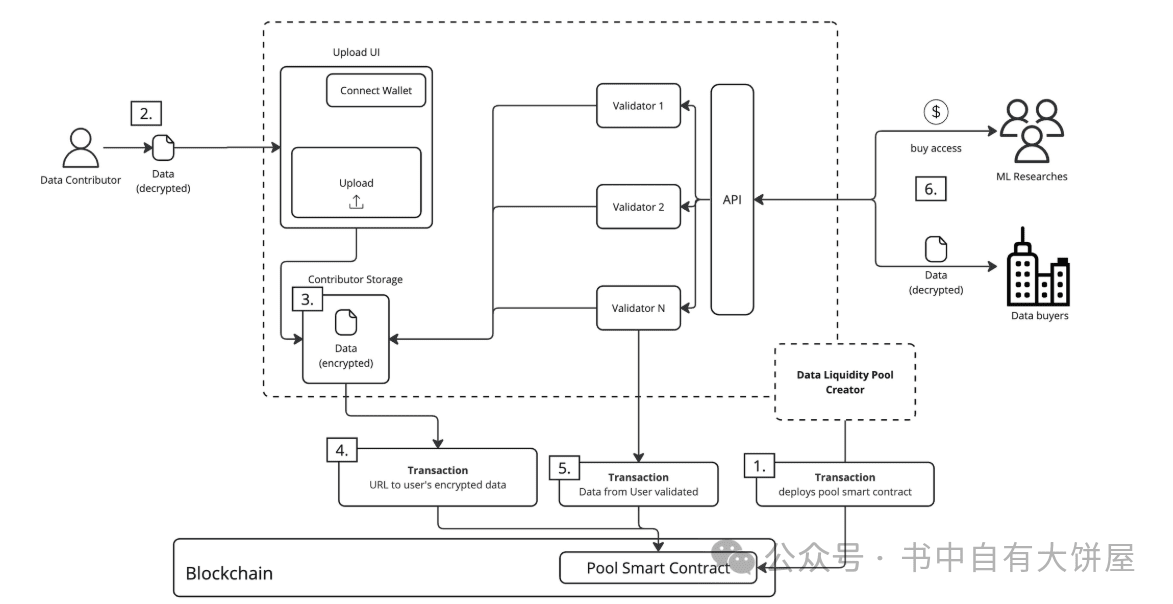
La capa de flujo de datos es la base fundamental de Vana, que soporta el tratamiento de datos como un activo fluido. A través de mecanismos descentralizados, los datos en esta capa pueden ser verificados de forma segura, tokenizados y negociados. Esta capa introduce los DataDAOs, que crean un mercado de datos descentralizado y sin confianza al agregar tipos de datos similares de diferentes contribuyentes.
Funciones principales
Validación de datos: se verifica la contribución de datos a través del mecanismo de 'Prueba de Contribución' (Proof of Contribution, PoC) para asegurar su autenticidad, propiedad, calidad y singularidad.
Tokenización de datos: los datos verificados serán tokenizados para ser negociados o utilizados en la red. Cada DataDAO emitirá su propio token, recompensando a los contribuyentes que proporcionen datos valiosos.
Transacciones y gobernanza: el token DataDAO permite a los usuarios participar en la gobernanza de datos y negociar datos como activos dentro del ecosistema de Vana.
DataDAOs
DataDAOs es el mercado descentralizado de datos:
Contribuyentes de datos: envían datos a los DataDAOs y reciben derechos de gobernanza y recompensas.
Validación de datos: se lleva a cabo en la red Satya (un conjunto de nodos de computación segura) para garantizar la calidad e integridad de los datos.
Consumidores de datos: pueden acceder a estos conjuntos de datos verificados para entrenamiento de IA u otros usos.
DataDAOs fomentan la contribución de datos de alta calidad, y proporcionan un mecanismo transparente para garantizar el uso y entrenamiento de los datos.
Capa de portabilidad de datos
La capa de portabilidad de datos es la capa de aplicación de Vana, permitiendo el acceso, intercambio y uso de conjuntos de datos descentralizados entre diferentes plataformas y aplicaciones. Esta capa asegura que los datos que poseen los usuarios tengan interoperabilidad entre diferentes servicios y sistemas, mientras se mantiene la privacidad y la seguridad. Se caracteriza por que cada DLP define una arquitectura de metadatos estandarizada y estructuras de datos para su dominio, asegurando la consistencia y disponibilidad de los conjuntos de datos agregados.
Funciones principales
1. Compartición de datos entre aplicaciones
- Esta capa soporta el flujo sin fisuras de datos entre aplicaciones, garantizando al mismo tiempo que el usuario tenga el control total. Los usuarios pueden autorizar aplicaciones específicas para acceder a sus datos, asegurando la privacidad y la seguridad.
2. Interoperabilidad
- La capa de portabilidad de datos está diseñada para ser compatible con múltiples plataformas, protocolos y aplicaciones, permitiendo que los datos sean utilizados a través de ecosistemas. Por ejemplo, los modelos de IA entrenados con conjuntos de datos descentralizados de Vana pueden ser accedidos por múltiples aplicaciones de IA.
3. Gobernanza y control de acceso
- Los propietarios de datos mantienen el control sobre sus datos, incluyendo la decisión sobre cómo y por quién se utilizan. Además, los contribuyentes participan en la gobernanza al poseer tokens de DataDAO, influyendo en las decisiones sobre el intercambio de datos.
Aplicaciones descentralizadas (dApps)
La capa de portabilidad de datos soporta aplicaciones descentralizadas que interactúan con conjuntos de datos verificados:
- Modelos de IA
Los desarrolladores pueden construir modelos de IA, acceder y entrenar basados en conjuntos de datos descentralizados, asegurando el uso ético de los datos.
- Aplicaciones impulsadas por datos
Las aplicaciones que dependen de datos generados por usuarios pueden aprovechar los conjuntos de datos seguros y operativos de Vana, proporcionando una mejor experiencia de usuario y perspectivas de datos.
Economía del token
Cantidad total de tokens: 120,000,000, circulación inicial 25.1%, distribución de tokens: contribuyentes centrales/equipo 18.8%, comunidad 44%, inversores 14.2%, ecosistema 22.9%. El equipo y los inversores están bloqueados durante 12 meses, y la liberación total de tokens es de 5 años (equipo). Actualmente, según el sitio oficial, el proyecto ha recibido una inversión de 20 millones de dólares, lo que seguramente ha beneficiado a los inversores, ya que según el porcentaje de inversores, su capitalización de mercado solo es de 140 millones.
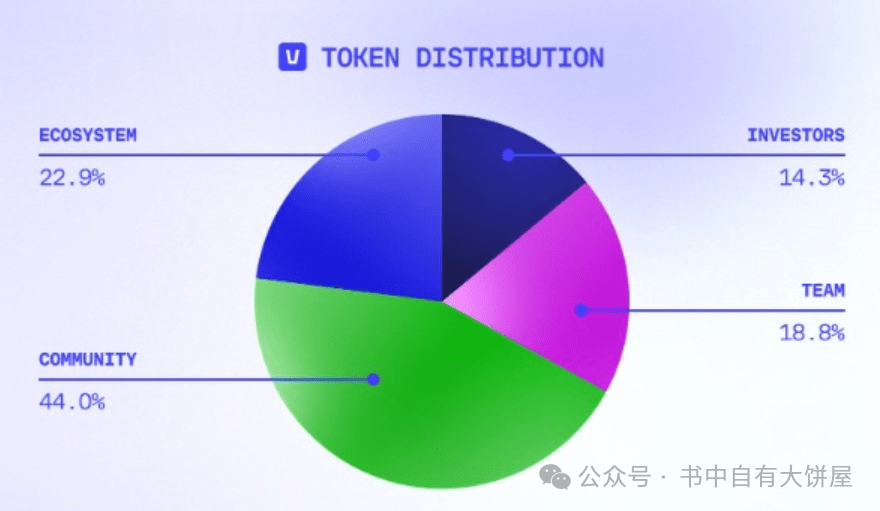
Ahora calculemos el precio del token en su launchpool; según el fondo de 17 millones de BNB, el rendimiento de los launchpools anteriores ha sido de aproximadamente 1% - 2%, así que el precio del token debería estar entre 30 y 60 dólares (asumiendo un BNB a 700 dólares). Considerando la cantidad total, su capitalización de mercado ya ha alcanzado entre 3.6 y 7.2 mil millones de dólares, lo cual es bastante exagerado. Comparado con la capitalización de mercado de inversión que calculamos antes de 140 millones de dólares, ya ha aumentado 20 veces.
Entonces, ¿cuál debería ser la capitalización de mercado razonable para un proyecto de datos de IA? Podemos comparar con ocean (la plataforma líder de intercambio de datos descentralizados - Ocean protocol), que también se dedica al procesamiento de datos relacionados con IA; se puede decir que hacen prácticamente lo mismo, y ocean se fusionó con agix y fet, con una capitalización de mercado de alrededor de 1,000 millones de dólares antes de la fusión.
El equipo de ocean es muy fuerte, y he investigado que el equipo de Vana es bastante inferior. En comparación técnica, ocean apareció en 2017, y en ese momento no tenía mucha experiencia en el tratamiento y comercio de datos, así que simplemente tener un mercado de intercambio de datos NFT no era suficiente. Además, el libro blanco de Vana menciona el problema del doble gasto de datos, que creo que no se ha resuelto adecuadamente, ya que en el problema del intercambio de datos hay muchos pasos involucrados, y si obtengo datos y los proceso, luego hago un doble gasto, realmente no tienes un buen método para evitarlo. Así que aunque Vana puede tener un enfoque un poco más novedoso, en esencia, no ha habido un avance significativo en el comercio de datos de entrenamiento.
Pero no se puede negar que entrenar datos personales y monetizarlos es un camino correcto, aunque actualmente hay muchas dificultades, pero eso no impide que una ola tras otra de emprendedores se rompan la cabeza buscando soluciones. A veces, el progreso tecnológico puede ser lento al principio, pero esta acumulación podría provocar un cambio cualitativo, acelerando la llegada de nuestra era de IA. ¡El futuro está aquí!