

#aiinference
aiinference
1,206 vistas
7 están debatiendo
Hot
Lo último
·
--
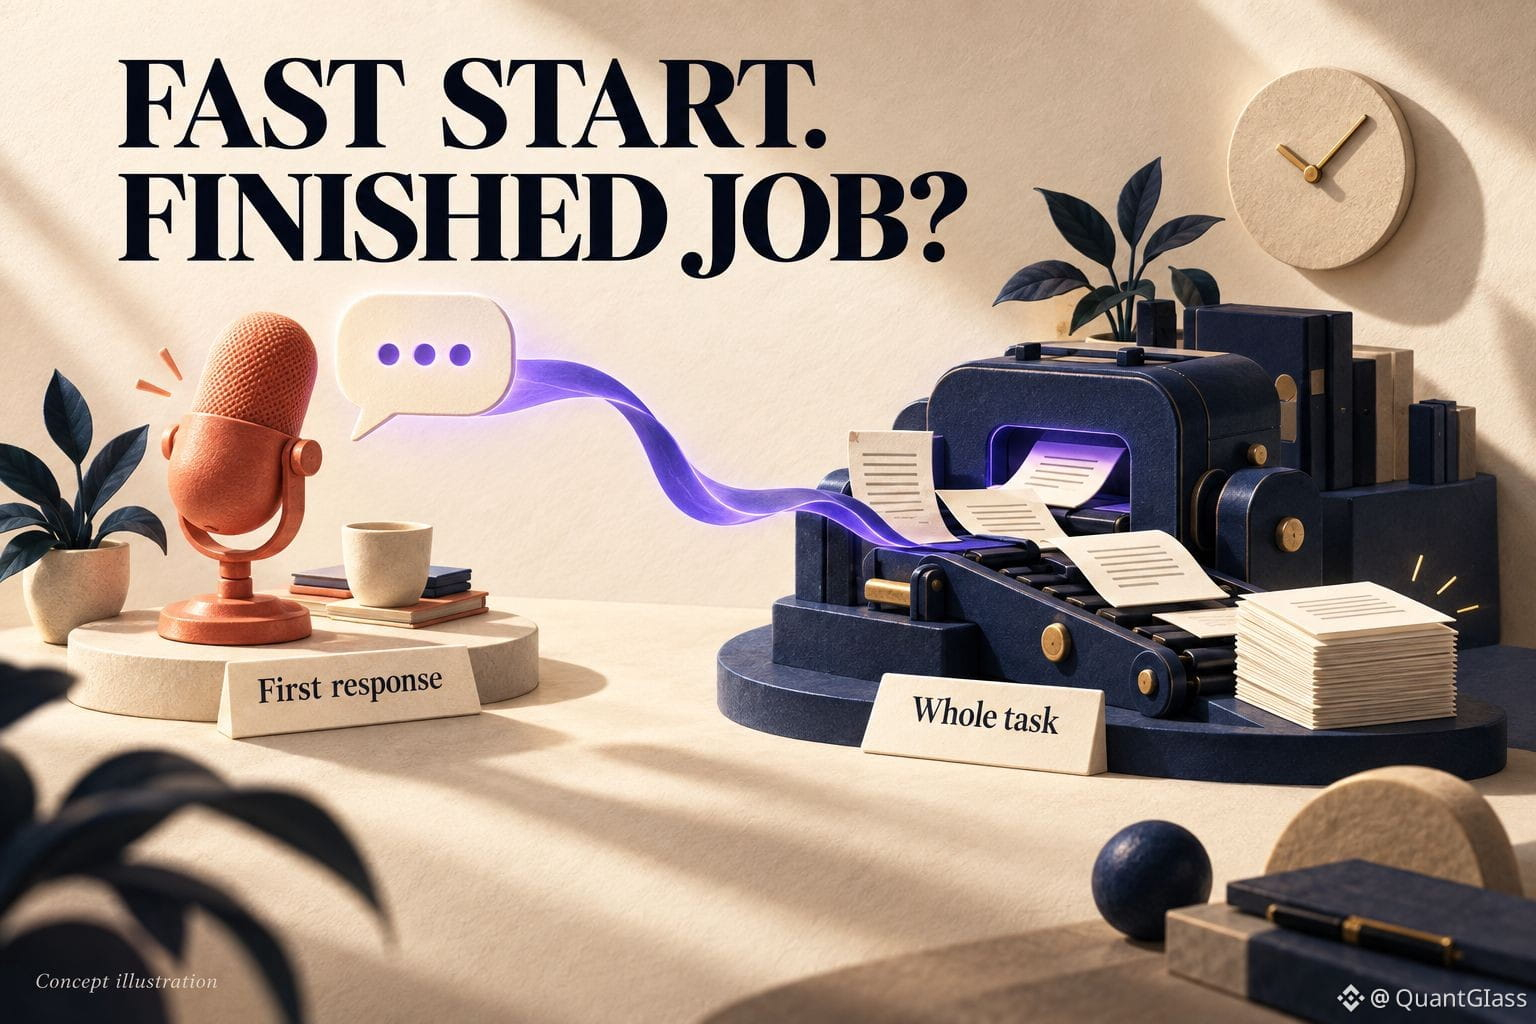
Una IA que empieza a responder rápido aun puede tardar una eternidad en terminar el trabajo.
En su artículo del 18 de septiembre, io.net distingue entre el time-to-first-token (el tiempo de espera antes de que empiece la salida) y el rendimiento por lotes. Coloca sus GPU distribuidas alrededor del costo y la flexibilidad, no ganando la carrera del primer token.
Mi prueba para la historia de $IO compute: medir la tarea completa. Un asistente de voz en tiempo real necesita una respuesta rápida; un trabajo de documentos durante la noche necesita resultados precisos a la fecha límite, con un costo total razonable. Los ejemplos de costos del artículo son ilustrativos, no evaluaciones independientes. Las cargas de trabajo reales todavía necesitan pruebas.
¿Qué te frustra más: esperar la primera palabra o esperar la respuesta final? #AIInference
167
·
--
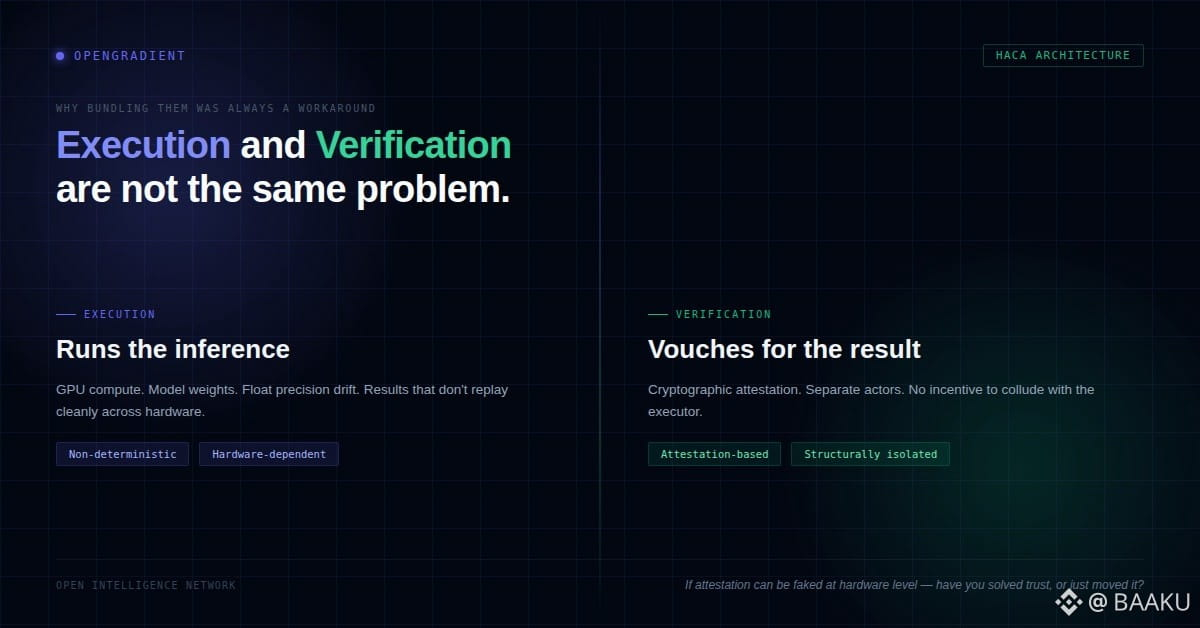
La mayoría de las blockchains tratan la ejecución y la verificación como si fueran el mismo problema. No lo son.
La ejecución es computación. La verificación es confianza. Agruparlas siempre fue una solución alternativa, no una elección de diseño. Y durante años, nadie se dio cuenta porque los modelos eran lo suficientemente simples como para que "ejecuta de nuevo y verifica" pareciera una solución real.
Ya no lo es.
La inferencia de IA no se reproduce de manera limpia. Ejecuta el mismo modelo dos veces en hardware diferente, puedes obtener salidas diferentes. Precisión de punto flotante, variación de temperatura, peculiaridades de la GPU: los resultados se desvían. Así que si tu capa de verificación es solo "ejecutar de nuevo y comparar", ya has perdido. No estás verificando la verdad. Estás verificando la consistencia bajo condiciones ideales, lo cual es algo completamente diferente.
Esta es la brecha que la mayoría de la gente pasa por alto cuando habla de "IA verificable en la cadena."
La arquitectura HACA de OpenGradient realmente separa estas dos capas. Los nodos de ejecución realizan la inferencia. Una capa de verificación separada revisa el resultado, utilizando atestación criptográfica, no re-ejecución redundante. El nodo que ejecutó el modelo y el sistema que lo respalda son actores estructuralmente diferentes con incentivos diferentes.
Esa separación importa más de lo que la gente se da cuenta. Cuando la ejecución y la verificación son manejadas por la misma lógica, el modelo de confianza del sistema es tan bueno como la honestidad del ejecutor. No estás verificando la IA. Estás confiando en que el ejecutor se autorreporta.
Separa los roles, y la estructura de incentivos realmente cambia. Los nodos de verificación no tienen razón para coludir con los ejecutores; no ejecutaron el modelo, solo están revisando la prueba. Esa es una verdadera frontera de confianza, no una teórica.
La limitación honesta: la verificación basada en atestación todavía está madurando. La sobrecarga criptográfica es real, y "prueba de inferencia correcta" en modelos grandes no es un problema resuelto. La dirección del diseño es defensible. Pero las suposiciones de seguridad reales están haciendo mucho trabajo silencioso tras bambalinas.
#OpenGradient #DecentralizedAI #AIInference #opg $OPG @OpenGradient
5
2
97
·
--
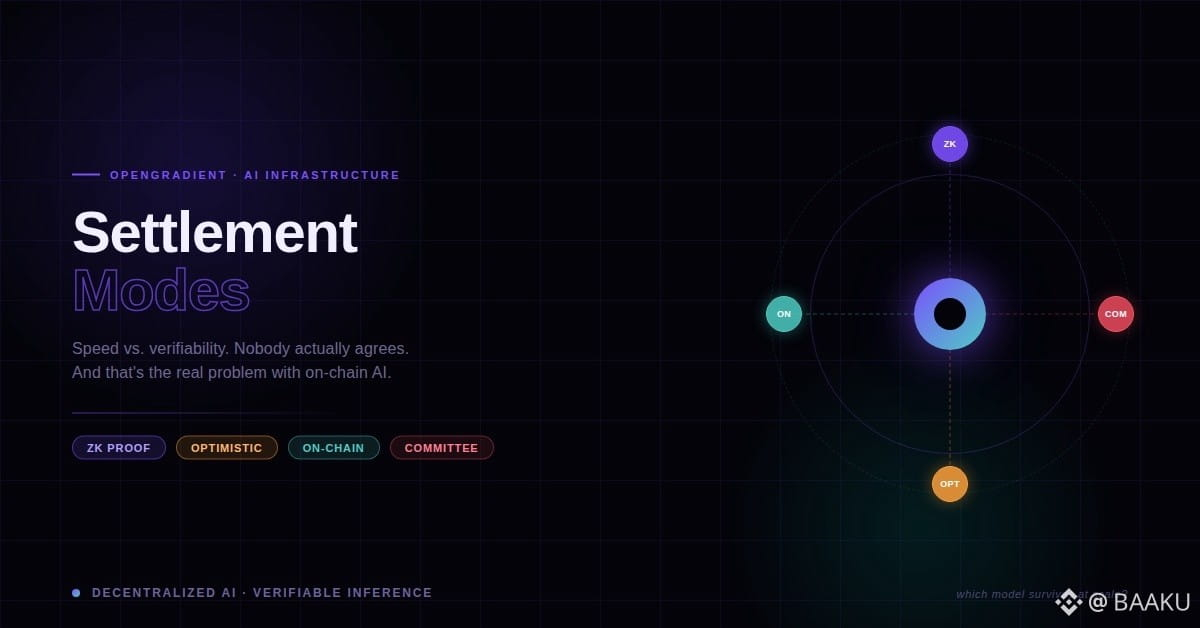
La mayoría de la gente piensa que la liquidación es solo la parte aburrida del backend. La parte que "simplemente funciona."
Por eso es exactamente que se rompe en el peor momento posible.
Aquí es lo que realmente está pasando. Cuando un modelo de IA realiza una inferencia — genera una salida, toma una decisión, puntúa un resultado — no tienes idea si esa salida es real. No en ningún sentido verificable. Estás confiando en una caja negra en el servidor de alguien más para decirte la verdad. Y en el 99% de la infraestructura actual de IA, ese es todo el modelo de seguridad. Confía en mí, amigo. En producción. A gran escala.
La liquidación se supone que debe arreglar esto. La idea es clara: ejecutas el modelo, demuestras que se ejecutó correctamente, registras esa prueba, y ahora la salida tiene integridad. Simple.
Excepto que en el momento que preguntas cómo se liquida esa prueba — en cadena, fuera de cadena, optimista, ZK, basado en comités — te das cuenta de que nadie realmente está de acuerdo. Y la matriz de compensación es brutal.
La liquidación en cadena te da una verificabilidad real pero introduce latencia que hace que la inferencia de IA en tiempo real sea completamente impracticable. No puedes esperar 12 segundos para una confirmación de bloque cada vez que un modelo hace una llamada.
La liquidación optimista es rápida pero empuja el problema de integridad hacia adelante — asumes que es correcta a menos que alguien lo desafíe. La mayoría de los usuarios nunca desafiarán nada. Eso es solo comportamiento humano.
#OpenGradient #AIInference #opg $OPG @OpenGradient
6
5
198

A16Z RESPALDA UNA REVOLUCIÓN LOCAL DE IA A MEDIDA QUE LOS AGENTES EN DISPOSITIVO ENCIENDEN EL RELATO $AI ¡⚡ 🦈!
📌 Los pesos pesados de Silicon Valley, a16z y Khosla Ventures, acaban de respaldar con capital institucional al agente local Underdog de Conway Research. Al ejecutar un modelo compacto de 4B parámetros directamente en hardware de consumo a 4,5x de velocidad sobre MLX, esto señala un gran giro estructural hacia la ejecución sin nube. 💡
El “dinero inteligente” está adelantándose con fuerza al cambio desde modelos voluminosos de centros de datos hacia una inteligencia ágil en el dispositivo. 📊 A medida que la informática en el borde converge con la ejecución de agentes autónomos, la infraestructura de IA local se está convirtiendo rápidamente en el próximo impulsor principal de la narrativa en distintos mercados. ⚡
🤔 ¿Los agentes de IA locales volverán obsoletos los modelos centralizados en la nube para tareas diarias? 👇
⚠️ No es asesoramiento financiero. Gestiona siempre tu riesgo. 🛡️
🏷️ #AI #CryptoAI #TechTrends #Agents #AIInference
🔥 ⚡
118
Inicia sesión para explorar más contenidos
Únete a usuarios globales de criptomonedas en Binance Square
⚡️ Obtén información útil y actualizada sobre criptos.
💬 Avalado por el mayor exchange de criptomonedas en el mundo.
👍 Descubre perspectivas reales de creadores verificados.
Email/número de teléfono
Temas populares
1
#BitcoinParesGainsAfterRallyTo$86.5K
22,610 vistas
89 están debatiendo
2
#CerebrasSinksNearly20%OnReportNvidiaToPowerOpenAI
39,470 vistas
481 están debatiendo
3
#SECProposesCryptoCustodyRules
69,362 vistas
655 están debatiendo
4
#SECApproves3xLongCryptoCommodityETPs
50,415 vistas
503 están debatiendo
5
#MASKHitsRecordMarketCapAbove$35M
2,255 vistas
27 están debatiendo
6
#G7PlansToReleaseUpTo100MBarrelsOilDiesel
40,079 vistas
477 están debatiendo
7
#ICBASuesOCCOverCryptoBankCharters
31,944 vistas
339 están debatiendo
8
#USStocksCloseHigherOnWeakJobsData
31,565 vistas
257 están debatiendo
9
#AnchorageReportedlyCuts17%Workforce
8,406 vistas
99 están debatiendo
10
#NFPWatch
11M vistas
19,804 están debatiendo