

花儿不在
17 Beiträge
花儿不在
Melden
Nutzer blockieren
2 Following
5 Follower
3 Like gegeben
Beiträge
·
--
Übersetzung ansehen
#opg $OPG
今天必须得唠唠OpenGradient——不是因为它画饼画得圆,是因为币安HODLer空投今天刚上线。我翻了一下午白皮书,发现这项目确实有点东西
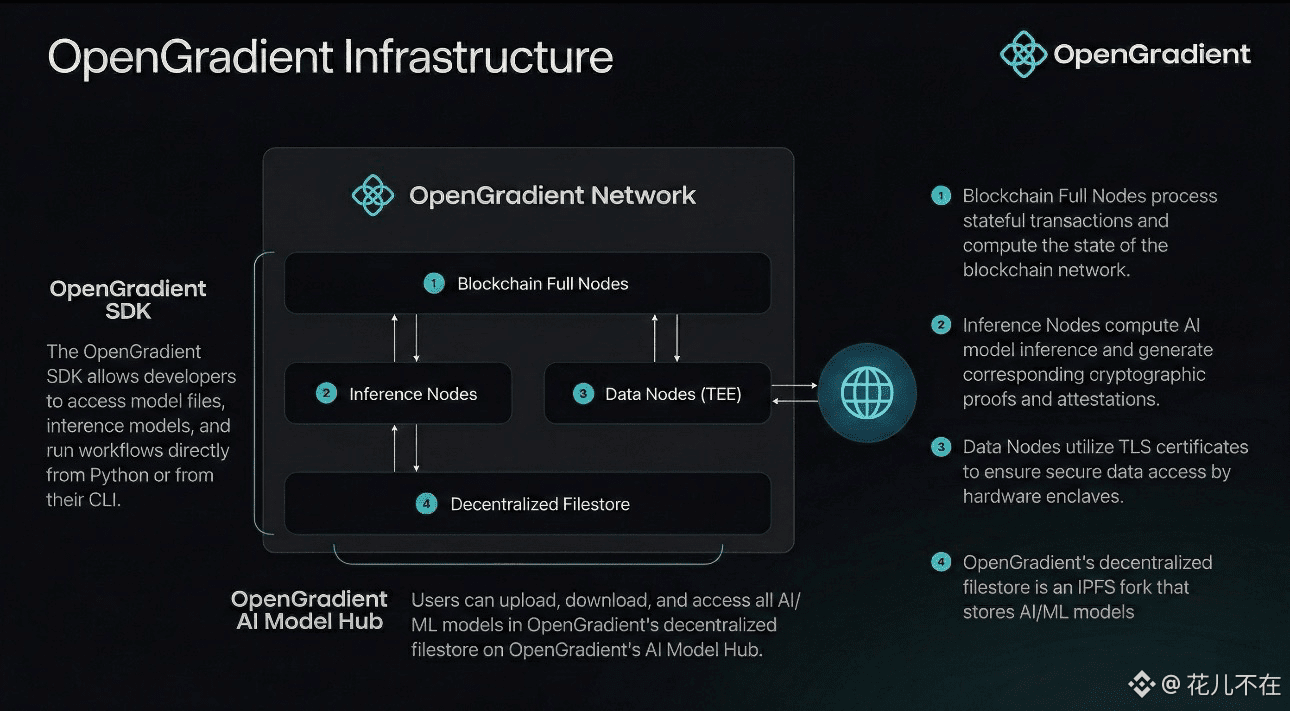
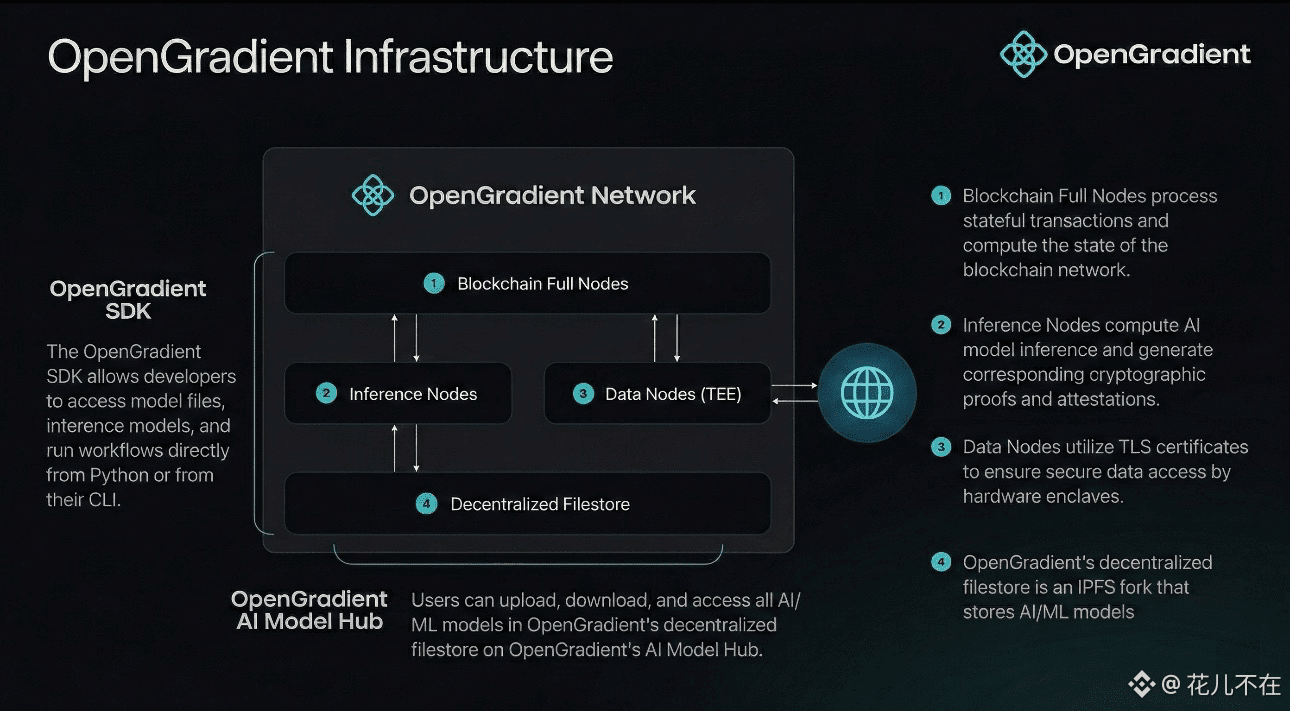
先说技术。如果让链上每个节点都去跑一遍大模型,网络直接瘫痪。OpenGradient白皮书里有句原话特别实在——“让每个验证节点独立重跑模型推理是不切实际的”。所以他们搞了套混合AI计算架构(HACA) ,把“执行”和“验证”彻底分开。推理节点用GPU和TEE跑模型、干重活;全节点只管验证TEE认证和ZKML证明、记个账。你不需要重跑一遍模型,只需要验证它跑对了。验证节点可以很轻量——就这么一个简单的认知转换,把性能和信任全解决了
再说产品。他们家那个Opg Chat,能直接用ChatGPT、Claude、Gemini、Grok这些模型,还能生成图片、传文件。关键是设备端加密——信息在离开浏览器之前就本地加密了,密钥只在你设备上。经过Oblivious HTTP中继时,中继能看到你的IP但只有密文;下游网关能看到明文但永远看不到你的IP。到了TEE隔离网关里才解密处理。而且TEE带远程认证,你可以自己验证这些隐私承诺。这相当于给你配了辆全封闭的超级运钞车——除了你自己,没人知道里面装了啥。Opg Chat上线两周已经服务超200万用户,处理了200多万次可验证推理。Model Hub上还集成了2000多个模型
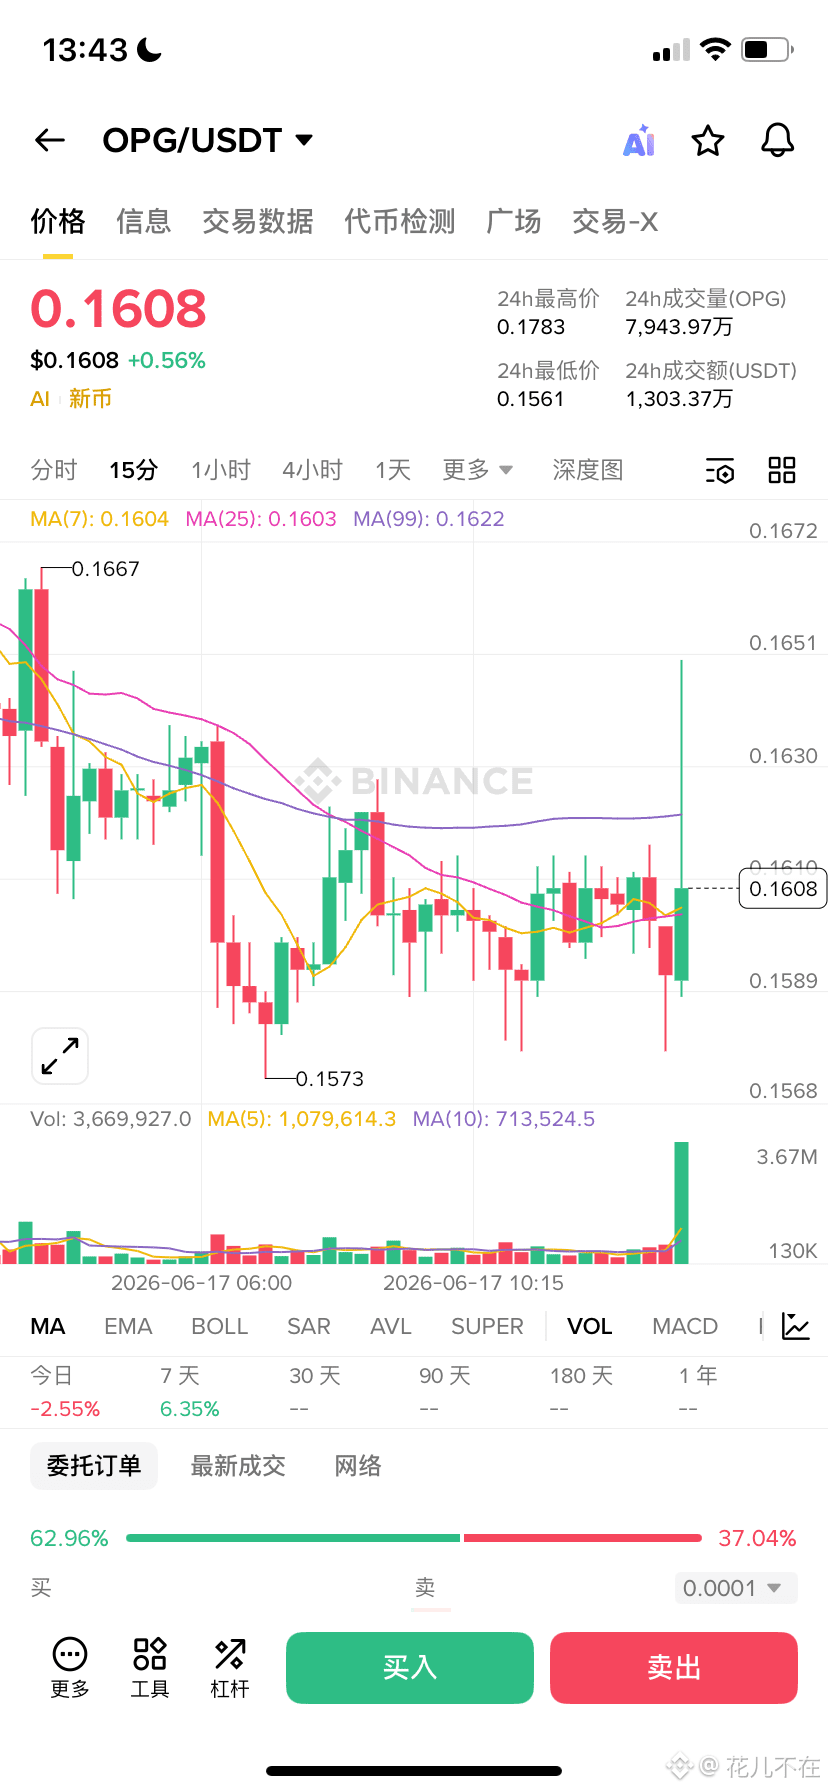
在算经济账。OPG总量10亿枚,流通约1.98亿枚。a16z crypto领投、Coinbase Ventures、SV Angel、Foresight Ventures等24家机构累计投了950万美元。币安第66期HODLer空投今天刚上线。但我也得说句实在话——空投是机会,可别光盯着糖果忘了脚下的荆棘。当前价格$0.15左右,全流通市值(FDV)超1.5亿美元,80%的代币还没解锁呢。项目还在测试网阶段,技术没大规模验证
我的结论很简单——技术叙事能打,空投机会真实,但80%未解锁的代币是悬在头顶的剑 @OpenGradient
1
127
·
--
Übersetzung ansehen
昨晚翻OpenGradient的文档翻到凌晨一点。看到"异步验证"四个字的时候,条件反射般地按了Ctrl+F,输入"验证失败"。
0 results。
又试了"failure"、"settlement"、"rollback"。全都没有。
HACA的设计其实很聪明。传统区块链让每个验证者重跑每笔交易,AI推理又贵又非确定,根本跑不动。OpenGradient的解法是把执行和验证拆开:推理节点跑模型,毫秒级返回结果;全节点异步验证TEE证明。验证节点不需要知道prompt是什么、模型是什么,只需要确认代码在飞地中未被篡改。
问题恰恰出在这儿。官方文档写得清楚:TEE证明验证的是"enclave was not tampered with",不是结果本身对不对。推理节点完全可以在TEE里"正确"跑完模型,返回一个错误结果——证明照样过。文档承认有"临时的信任缺口",但这个缺口怎么补,只字未提。$OPG
Gate学院有篇文章提到"验证失败,结果将被拒绝或重新计算"。可重新计算的钱谁出?已经执行的交易怎么回滚?官方文档里连个TODO都没留
你看看DeFi,验证失败有清算和罚没兜底;再看看乐观Rollup,有挑战期和欺诈证明。OpenGradient把"先出结果、后验证"当卖点,烂摊子谁来收拾——目前看是用户自己扛。#OPG
架构方向没问题。但在主网经济模型完整公布、验证失败处理机制写进文档之前,这笔账我得先算清楚。@OpenGradient
1
78
·
--
Rate nicht, ob das große Modell im Hintergrund heimlich durch eine destillierte Version ersetzt wurde—ich bin da schon mal reingetreten. Zwei Wochen lang habe ich Prompts fein abgestimmt, aber nach dem Go-Live schwankte das Ergebnis mal so, mal so. Die Plattform versicherte mir mit fester Brust, dass die Versionen identisch seien—aber du hast nicht mal die Mittel, um dir selbst die Unschuld zu beweisen.
OpenGradient bricht diese Sackgasse ohne viel Gerede: Die Inferenz wird direkt in eine CPU-TEE-Sicherheitszone eingesperrt und dort ausgeführt. Wieso ist diese „Eisenkäfig“-Lösung so hart? Sobald die Rechenleistung hochfährt, selbst ein Root-Admin beim Cloud-Anbieter bekommt die Daten-Vorhänge nicht mehr auf—Eingabe und Ausgabe sind komplett auf physischer Ebene isoliert. Aber das löst nur die halbe Aufgabe: Wie stellst du sicher, dass wirklich GPT-4 läuft und nicht GPT-3.5? Die Hashes der Modellgewichte sind bereits im Registry auf der Blockchain fest einprogrammiert. Nach der Inferenz gibt die Hardware eine Signatur-Ausweiserfassung aus; wenn beide Seiten nicht mit dem richtigen Code übereinstimmen, wird alles sofort verworfen. Ausführen ist Ausführen, Audit ist Audit—mit gegenseitiger Kontrolle zu zweit: Fehlt einer, fliegt das System.
$OPG
In diesem geschlossenen Kreislauf ist OPG im Grunde ein „Taxameter“. Jeder Aufruf läuft über das x402-Protokoll mit automatischem Abzug; Entwickler verbinden nur die Python-SDK, kümmern sich nicht mehr darum, was in der Signaturprüfung im Hintergrund passiert—sie schreiben einfach die Business-Logik. Und dass OPG „nichts wert“ ist, ist Quatsch: Wenn das Netzwerk heute 100.000 Inferenzanfragen verarbeitet, werden 100.000-mal Gebühren umgeschichtet; bei 1 Million sind es 1 Million-mal—die Bewertung verdoppelt sich entsprechend. Diese Logik ist härter als die „MEME“-Coins, die mit PPTs glänzen.
#OPG
Vergleiche mit dem Markt: Zentrale APIs setzen komplett auf Vertrauen. zkML verifiziert zwar jeden Schritt, aber du wartest dennoch drei Sekunden—für den Handel wird das direkt unattraktiv gemacht. OpenGradient hat einen Kompromiss gewählt: maximaler Verzicht auf Zentralisierung, dafür millisekunden-schnell verifizierbar. Erzähl mir nichts von den Idealen „dezentraler KI“—wenn das Ding erst anfängt, für Menschen Kredite zu prüfen und Private Equity zu steuern, ist „Verifizierbarkeit“ kein Bonus, sondern eine Türvoraussetzung. Wer die Unschuldsbeweise auf Hardware-Ebene zuerst in der Hand hat, blockiert damit die nächste Generation von Finanz-KI am Hals. Wer nur mit Konzepten wirbt, soll beiseite treten.
@OpenGradient
82
·
--
99% der Menschen halten Staking für eine Spardose, aber im Whitepaper von <c-1/> @OpenGradient , Abschnitt 4.3, gibt es eine Zeile, die durchgestrichen ist: die „Teufelsdetails“ — fehlerhafte Beweisergebnisse führen zu Slashing (Slash). Als ich das lese, läuft mir eiskalt den Rücken hinunter: Staking ist keine verzinsliche Einkommensquelle, sondern eine „Kredit-Versicherungsprämie“ für KI-Logik.
Wenn Validatoren OPG staken, schürfen sie nicht nur Mining — sie schreiben dem Netzwerk einen „Schuldschein“: Ich übernehme die Verantwortung für diese Validierung. Wenn es schiefgeht, zahle ich mit echtem Geld. Bei jeder KI-Inference, die OpenGradient zurückliefert, steht am Hintergrund jemand mit Vermögenswerten dafür, dass die Ergebnisse stimmen.
Im Vergleich dazu trifft einen traditionelle KI besonders hart. OpenAI, Claude und Gemini basieren alle auf „kostlosen Zeugenaussagen“ — hat das Modell etwas verfälscht? Passt die Hardware? Am Ende stützen sich alles auf mündliche Zusagen. OpenGradient ersetzt moralische Zusagen durch wirtschaftliche Zwänge: Aus „Ich glaube dir“ wird „Du wagst es nicht, mich zu betrügen — denn Betrug hätte für dich Kosten“.
Das führt zu einem Supply-Side-Schluss, den die meisten nicht durchgerechnet haben:
Beim Staking braucht das OPG zum Aussteigen eine Entsperrphase; wenn Slash als Risiko über allem schwebt, ist die Opportunitätskosten für leichtfertiges Aussteigen höher als das Dabeibleiben. Deshalb steckt die OPG auf der Chain nicht dort, weil die Inhaber besonders optimistisch sind, sondern weil das Mechanismus sie dort „festschweißen“ — passives Locking und aktives Halten sind zweierlei.
Wenn Slash wirklich in Betrieb ist, wird das Angebot-Nachfrage-Modell für OPG komplett neu aufgebaut: Je lebhafter das Netzwerk → desto mehr Bedarf an Validatoren → desto höher der Anteil der durch Verantwortung „eingekesselten“ Einsatzmittel → desto knapper wird der frei handelbare Umlauf. Das ist eine nichtlineare, stark deflationierende Neigung.
Natürlich liegen die Risiken auch offen da: Wachsen Validatoren-Knoten wirklich? Tritt Slash wirklich ein? Diese zwei Datensätze sind derzeit noch Blackbox. Aber der Markt preist oft am härtesten, wenn man „nicht genau hinschauen kann“.
Während andere sich noch in TEE- und ZKML-Technikbegriffen verbeißen, beginnt das schlaueste Geld bereits, den natürlichen Kaufdruck durch das Slashing-Mechanismus einzupreisen. Die Stakemenge bestimmt das Sicherheits-Maximum des Netzwerks, und das Sicherheits-Maximum bestimmt die Bewertungshöchstgrenze — diese Erzählung ist zehnmal „härter“ als ein reines KI-Meme.
Wenn die Richtung stimmt, sprechen die Daten. Wir warten auf den Tag, an dem die Validatoren-Adresse öffentlich ist. $OPG #opg @OpenGradient
1
94
·
--
Übersetzung ansehen
#opg $OPG 周末在咖啡店被店员安利“隐藏菜单”,满怀期待点了一杯——不过是普通拿铁加了焦糖糖浆。这让我想起币圈那些号称“AI革新”的项目,大多只是给大模型套了个发币的壳。但深度体验@OpenGradient后,确实让我改观不少。
它的HACA混合AI计算架构打破了我对“区块链+AI=慢”的刻板印象。 传统区块链靠每个验证节点重复执行每笔交易达成共识,跑大模型在计算上完全不可行。HACA将网络拆分为三个专业角色:推理节点跑模型并生成可验证证明,全节点只验证证明的密码学有效性,数据节点获取可信外部输入。用户先拿结果,验证和结算异步完成——既保住Web2级速度,又锁死链上信任。
更让我觉得“真不一样”的是它的隐私设计。 OpenGradient Chat处理敏感信息时,消息在浏览器端就完成加密,密钥只存在你的设备上;通过Oblivious HTTP匿名中继后,在TEE可信环境中解密处理——运营方既看不到你是谁,也读不懂内容。对比ChatGPT们拿对话喂模型的套路,这才是真正的“架构级隐私”。
数据印证落地速度:4月上线Base以来,已托管超2000个模型、验证超50万份证明、处理超200万次推理。但我心里始终有个结:AI的“黑盒幻觉”与区块链的“透明契约”天生冲突。若模型推理出错,链上自动决策的风险谁来担?目前我只拿小仓位参与观望,既不盲目押注,也不愿错过。
当AI既能极速服务又能锁死隐私,它会是巨头的劲敌,还是一场技术豪赌?且看它下一步怎么解题@OpenGradient
88
·
--
Übersetzung ansehen
#opg $OPG 异步结算的代价@OpenGradient OpenGradient x402机制下被转嫁的节点资金效率风险
Opg的x402支付协议常被包装为“Web2级低延迟”体验,但其核心机制暗含结构性缺陷:异步结算模式将资金效率与价格波动风险完全转嫁给算力节点,在商用批量推理场景下存在先天不适配
机制拆解:预授权≠即时结算 用户发起推理前通过Permit2完成链上预授权,批准OPG额度给结算合约;节点消耗GPU算力返回结果后,OPG代币的正式扣款与划转才在Base链上异步完成。执行与结算在时空上被彻底剥离——节点“先干活”资金“后到账”
对比基准:前置扣款vs后置结算的范式冲突。AWS、GCP等主流云平台均执行“资金到位,算力启动”,或预冻结余额,或实时扣费;去中心化竞品也多采用“预付充值、按秒扣费、余额耗尽即停机”的硬约束。x402的Permit2预授权仅解决“防用户跑单”,却回避了“钱在路上”的账期与汇损问题,本质是将流动性杠杆强行加给硬件提供者
量化视角:三重压力下的收益侵蚀。 面向B端批量推理时:Base链结算拥堵致资金到账窗口延长至12-15个区块(约3-5分钟)此窗口内OPG价格波动带来0.5%-2%的隐性滑点;月均10万次推理的中型节点,未到账资金日均沉淀约5000枚OPG,折算链上借贷成本,每月侵蚀4%以上净利润。GPU电费与折旧是刚性支出,收入却存在不确定延迟,节点现金流安全边际被持续压缩
破局推演:协议层必须补齐的“解药”。 若要保持算力供给稳定,x402须引入动态汇率锚定机制(如按5分钟TWAP均价结算),或设立节点流动性预支池对冲账期风险。否则,Web2级的响应速度与Web3级的结算摩擦之间,终将形成算力供给失血的“成本无底洞”。先服务、后结算,看似保障用户体验,实则将财务风险全额转嫁——这套经济设计的长期可持续性,值得每个算力提供者审慎重估
1
1
80
·
--
#opg $OPG
Zieht heute keine Luftschlösser. OpenGradient – das habe ich erst vor Kurzem wirklich verstanden. Früher, wenn ich von irgendwelchen „Full Nodes“ und „Zero-Knowledge-Proofs“ gehört habe, summte mir der Kopf, weil es sich so weit weg anfühlte. Aber wenn man geduldig auseinandersetzt, wie das darunter eigentlich läuft, dann ist es im Grunde genommen: Eine Bande strenger alter Buchhalter steht dir als Türsteher vor. Irgendein Rechner im Netzwerk führt ein KI-Modell aus – egal ob Inferenz oder Training. Wenn dabei ein Ergebnis herauskommt, musst du das „Buch“ an diese Full Nodes übergeben. Die haben kryptografische Formeln und TEE-Hardwareberichte in der Hand und gleichen sie Punkt für Punkt mit dir ab. Stimmt es nicht? Dann machen sie nicht lange rum: Sie rufen es per Lautsprecher ins ganze Netz – und decken dein Schummeln restlos auf. Und zwischen ihnen rufen sie sich sogar gegenseitig zu, um die Abrechnung durchzugehen, damit kein Detail durchrutscht. Bei traditionellen Konzernen: Wenn die Daten schiefgehen, schicken sie höchstens ein Entschuldigungsschreiben und lassen dich dann hoffen, dass du ihnen weiter vertraust, wegen deren „Charakter“. Und hier? Charakter zählt nicht. Die Mathematik sagt: nicht regelkonform. Da kannst du weinen, so viel du willst – die Full Nodes stempeln es nicht ab, und es wird nicht akzeptiert.
Du wirst sicher fragen: Was, wenn die Full Nodes selbst Böses im Schilde führen? Die sind nicht dumm. Sie müssen erst Kaution hinterlegen: eine große Menge OPG-Token sperren, um überhaupt ihren Job machen zu können. Das System schaut jeden Tag genau hin. Wer sich darauf ausruht oder schludert, wird bei Auffälligkeiten direkt dafür zur Kasse gebeten – die Einsätze werden eingezogen. Spürbar, oder? Umgekehrt: Wenn man fleißig prüft und die Betrüger schnell herausgreift, belohnt das System OPG. Alles klar ausgezeichnet, ganz ohne Hinterzimmer. Wer will schon gegen Geld arbeiten? Das Konzept ist ziemlich clever: Es schiebt menschliche Höflichkeit und soziale Spielchen komplett zur Seite – alles läuft nur über Anreize und Mathematik, die sich gegenseitig kontrollieren und aufeinander beißen. Als normaler Nutzer musst du gar nicht selbst zehntausende verballern, um High-End-Maschinen als Node aufzusetzen. Du rufst einfach die Frontend-Schnittstelle auf – und unten behalten diese starrköpfigen Leute für dich die Kontrolle. Ich habe es ein paar Mal ausprobiert: Du musst niemandem den Großvater anbetteln, sondern rufst es direkt auf – und das Ergebnis ist wirklich knallhart korrekt.
Wenn KI in Zukunft mit sensiblen Daten arbeitet, bildet diese Gruppe von Nodes, die an den Details festbeißt, eine Absicherung – stärker als wenn irgend ein CEO mit dem Brustton der Überzeugung schwört. Mit Mathematik abstempeln statt nur mündliche Zusagen. Diese Richtung liegt genau auf meiner Linie. Und weil die Nodes OPG verdienen wollen, prüfen sie genauer als jeder andere. Du willst dich da herausmogeln? Denkste – Tür zu. Ich mag diese saubere, zügige Art: Kein Blick auf Gesichter, keine Gefälligkeiten – nur Algorithmus und Hardware, die die Sache ernst meinen. Sag mal: Ist das nicht viel besser als Projekte, die ständig „transparent“ schreien, aber am Ende sieht man nichts? Wie auch immer – für meine zukünftige KI-Nutzung setze ich auf genau diese Schicht darunter. Dann ist mein Kopf ruhig. @OpenGradient
67
·
--
#opg $OPG Hast du schon mal darüber nachgedacht, dass bei jedem Aufruf eines AI-Risikomanagement-Modells die wirkliche Gefahr nicht darin liegt, dass es deine Eingaben "liest", sondern in dem Moment, in dem es im Hintergrund Daten abruft?
Ich habe im Systembetrieb gearbeitet und habe schon zu oft in Logs gesehen, wie Benutzer-ID, Kontostände und die Gründe für die letzten Transaktionen klar und deutlich drinstehen. Wenn man Probleme untersucht, muss man zwangsläufig die Anfrageparameter und Rückgabewerte durchsehen, aber während man so durchblättert, sieht man manchmal Dinge, die man besser nicht hätte sehen sollen. Das liegt nicht daran, dass jemand böse ist, sondern dass die Architektur "Daten abrufen" einfach nicht ernst nimmt – der Anwendungsserver hat einerseits die Schnittstellenrechte und füttert andererseits das Modell mit Daten, während alle Spuren einfach in den normalen Logs bleiben. Je mehr externe Datenquellen es gibt, desto trüber wird das Wasser, und die Systembetreuer werden unbewusst zu unsichtbaren Beobachtern der Privatsphäre.
Die Data Nodes von OpenGradient lösen genau diesen Einstiegspunkt. Es ist nicht einfach ein Proxy, sondern hebt die Aktion "Daten abrufen" separat hervor und steckt sie in eine isolierte Ausführungsumgebung. Die Aufgabe sagt nur "Was soll abgefragt werden" und "Nach welchen Regeln soll abgefragt werden", die eigentliche Lesung erfolgt in einem TEE – diese Umgebung lässt nicht mal das Host-Betriebssystem rein, und wenn der Node-Betreiber die Logs durchsuchen will? Da kommt nur Kauderwelsch.
Aber das ist noch nicht genug. Was mir am wichtigsten ist, ist, wie es beweist, dass es die Daten nicht manipuliert hat. Wenn der Data Node Daten zurückgibt, kommt ein Remote-Authentifizierungsnachweis dazu, ähnlich einem verschlüsselten "Lieferschein", der besagt: Diese Daten wurden zu einem bestimmten Zeitpunkt in einer bestimmten Umgebung unter bestimmten Bedingungen abgerufen. Die nachfolgenden Inferenzknoten arbeiten mit diesen Daten, und die Validierungsknoten prüfen nur, ob dieser Lieferschein echt ist. Will jemand die Daten manipulieren? Wenn der Lieferschein nicht passt, wird die gesamte Kette zurückgewiesen. Die Validierer müssen zu keinem Zeitpunkt den Klartext sehen, das ist der geschlossene Kreis.
Dieses System löst ein sehr konkretes Dilemma: Je mehr Echtzeitdaten verwendet werden, desto größer wird der Raum für Fälschungen; je zentralisierter die Berechtigungen, desto schwächer das Vertrauen. Früher haben wir darauf vertraut, dass die Systembetreiber nicht heimlich nachsehen, jetzt ersetzen wir Vertrauen durch verifizierbare Prozesse – Datenabruf ist isoliert, Ergebnisse haben Beweise, und Verantwortlichkeit hat Grundlagen. Privatsphäre ist nicht mehr nur ein Versprechen, sondern eine harte Bedingung, die in die Architektur eingebaut ist. So einfach ist das @OpenGradient
81
·
--
#opg $OPG Das letzte Mal, als ich die KI gebeten habe, meine DCA-Rendite zu berechnen, hat sie die jährliche Rendite verdoppelt, und ich wäre fast impulsiv mit meinem ganzen Kapital reingegangen. Später wurde mir klar, wie das Ganze dahinter funktioniert, ich hatte einfach keine Möglichkeit, das nachzuvollziehen, wie in einer Blackbox. Also als ich gesehen habe, dass OpenGradient die Kiste aufreißen will, um Transparenz zu schaffen, wollte ich als jemand, der schon mal über den Tisch gezogen wurde, gleich applaudieren.
Es ist anders als die großen Firmen, die nur Parameter und hochrealistische Videos optimieren, der Kern macht eine Sache: den Prozess der KI-Argumentation in ein „öffentliches Buch“ zu verwandeln, das jeder nachschlagen kann. Wie machen die das? Man muss ihre hybride KI-Berechnungsarchitektur (HACA) aufdröseln. Kurz gesagt: Ausführen und Verifizieren werden getrennt behandelt.
Früher gab es ein Dilemma, wenn man die KI auf die Blockchain bringen wollte – man musste 100 Knoten dazu bringen, das große Modell neu zu laufen, was nicht nur extrem teuer war, sondern auch, weil das große Modell einen „Temperaturkoeffizienten“ hat, jedes Mal unterschiedlich antwortet, was eine Einigung unmöglich machte. HACA hat einfach die Denkweise geändert: Die Inferenzknoten laufen zuerst das Modell, um schnell Ergebnisse zu liefern (das ist der schnelle Weg), während sie gleichzeitig asynchron einen kryptografischen Beweis generieren (der langsame Weg), unter Verwendung einer TEE-Vertrauensumgebung oder ZKML-Zero-Knowledge-Beweis. Alle Knoten in der Blockchain müssen das Modell nicht erneut ausführen, sondern brauchen nur ein paar Millisekunden, um zu überprüfen, ob der Beweis gültig ist, und die Grundlage wird durch den CometBFT-Konsens auf die Blockchain gelegt, niemand kann das manipulieren. Mit diesem Kombinationsansatz sind bereits über 4400 Modelle auf der Blockchain gehostet, über 2 Millionen verifizierbare Inferenzen durchgeführt und über 500.000 Beweise produziert, alles echte On-Chain-Daten.
Das Benzin, das diese „transparente Überwachung“ antreibt, sind die OPG-Token. Wir Retail-Trader verwenden OPG, um Inferenzen anzufordern, und die Knoten verdienen an den Servicegebühren; um ein Knoten zu werden, muss man OPG staken, um reinzukommen, und wenn man bei den Daten schummelt, wird das gestakte Material direkt eingezogen. Dieses „Bezahl für die Arbeit, bei Fehlern verlierst du Geld“-Spielprinzip verwandelt „nicht böse zu sein“ in eine wirtschaftliche Rechnung, was hundertmal zuverlässiger ist, als auf das Gewissen großer Firmen zu hoffen.
In Zukunft werde ich KI nur noch mit solchen, die überwacht werden können, nutzen. Clevere Maschinen mit vielen Tricks kann ich als neuer Trader echt nicht bedienen. @OpenGradient
99
·
--
#opg $OPG Die Whitepaper von OpenGradient ist ein ständiger Kreislauf, die x402 Abrechnungsschicht ist der wahre Killer. Dieses Ding macht AI-Inferenz on-chain, $OPG wird verwendet, um Gas zu bezahlen und zu staken. Aber der Fokus liegt nicht auf der Technik, sondern darauf, dass es den Entwicklern drei Optionen gibt – PRIVATE, BATCH_HASHED, INDIVIDUAL_FULL – sieht nett aus, ist aber in Wirklichkeit eine Compliance-Bombe, die dir in die Hand gedrückt wird, und du bestimmst den Zeitpunkt der Explosion.
PRIVATE: Keine Spuren on-chain. Die Privatsphäre ist gewahrt, aber das Schild „verifizierbare AI“ zerbricht direkt. Wenn die Regulierungsbehörden zur Prüfung kommen, womit beweist du, dass der Agent nicht geschummelt hat? Mit Luft?
INDIVIDUAL_FULL: Vollständige Protokolle dauerhaft on-chain. Das Whitepaper sagt, es sei geeignet für „öffentlich auditable DeFi-Agenten“, auf gut Deutsch: die Kreditlimits der Benutzer, die Liquidationsschwellen und die Strategie-Inferenz sind nackt. Der Gegner kann einfach die Kette scannen und genau deine Position angreifen, schlimmer als Insiderhandel.
BATCH_HASHED: Merkle Aggregation, die Standardoption. Geringe Kosten, verifizierbar, Datenschutz naja – aber das ist ein Kompromiss, der „drei Dinge nicht berührt“. Wenn die Regulierung sagt „Reiche die Rohprotokolle ein“, gibst du einen Hash, aber erkennt das der Richter?
Eine wahre Geschichte: Angenommen, du betreibst einen Kredit-Agenten und wählst den FULL-Modus, ein Benutzer fragt nach „Wie viel kann ich maximal leihen“ und der Inferenzprozess wird komplett on-chain, der Gegner kann damit sein Risiko ausrechnen und direkt bei der Liquidation überholen. Du verlierst echtes Geld, der Benutzer verklagt dich wegen Datenschutzverletzung. Und OpenGradient hat sich bereits sauber aus der Verantwortung gezogen – im SDK gibt es einen settlement_mode Parameter, der Entwickler wählt selbst, wenn etwas schiefgeht, such nicht das Projektteam.
Meine reale Handelsstrategie, kein Blabla: In den ersten drei Monaten nach dem Mainnet-Launch nur nicht-kern Geschäft abwickeln, zwingend BATCH_HASHED. Gleichzeitig beziehe ich zwei Indikatoren im Blick – die Häufigkeit der on-chain Prüfungsanfragen und die Anzahl der Streitigkeiten unter den verschiedenen Modi. Am Ende des dritten Monats, welcher Modus die niedrigste Fehlerquote und die geringsten regulatorischen Reibungen hat, dann entscheiden, wie viel Geschäftslogik ich dorthin verschieben kann. Vorher wird die gesamte Kerninferenz lokal abgeschlossen, nur die Verifizierungs-Hashes werden on-chain geworfen.
Denk dran: Die Inferenzaufzeichnungen der on-chain AI sind nicht sicherer, je mehr du speicherst, sondern gerade genug, um dich selbst zu beweisen und nicht gegen die Regeln zu verstoßen. Diese Linie zeichnet dir niemand, du musst deine Position ausprobieren. Aber teste vorher, zieh die lebenswichtige Grenze klar – ohne die Datenherkunft zu klären, setze nicht alles auf eine Karte @OpenGradient
2
91
·
--
#opg $OPG
Erzähl OpenGradient, hör erstmal mit dem ganzen blumigen Narrativ auf—wir schauen uns einfach die HACA-Architektur an.
Was ist das Problem bei traditionellen Blockchains? Jedes Node muss die Transaktionen immer wieder neu ausführen. Überweisungen funktionieren zwar, aber wenn du es 100 Nodes machen lässt, die jeweils ein 70B-Modell durchlaufen—dann kostet das das 100-Fache, und die Zeit reicht nicht. Und das Ergebnis ist am Ende auch nicht eindeutig dasselbe. OpenGradient trennt Ausführung und Verifikation: Inferenz-Nodes machen die Rechenarbeit mit der GPU, und danach liefern sie eine TEE-Authentifizierung oder ein ZKML-Beweis. Die Full Nodes prüfen dann nur noch die Beweise—sie müssen nicht dumm und dämlich das Modell immer wieder neu laufen lassen.
Technisch gesehen ist diese Idee tatsächlich nicht schlecht. Die Nodes sind in vier Gruppen aufgeteilt: Inferenz-Nodes laufen das Modell, Full Nodes buchen und verifizieren die Beweise, Data Nodes liefern externe Informationen, und das Speichern landet bei Walrus. Aber wo liegt der Haken? TEE-Nodes müssen eine harte Hardware-Authentifizierung bestehen—das kann man nicht einfach mit irgendeinem Heim-PC hinbekommen. Wer kauft H100? Wer zahlt die Stromrechnung im Rechenzentrum?
Ich habe mir extra mal das Wirtschaftsmodell im Whitepaper angesehen. Die Token-Gesamtmenge beträgt 1 Milliarde. Die Staking-Belohnungen machen nur ein Zehntel aus und werden über 96 Monate linear freigegeben. 96 Monate—was heißt das? Acht Jahre. Wenn man die aktuelle Bewertung von OPG nimmt: Wie viel davon pro Monat im Schnitt ausgezahlt wird, reicht das überhaupt für die Klimaanlagen einiger Maschinen? Node-Betrieb ist keine Wohltätigkeit. Wenn die Subventionen stoppen, läuft die Rechenleistung—bei Weitem—bei den Schnelleren.
Der Projektbetreiber sagt, dass im Mainnet 2 Millionen Inferenz-Läufe gelaufen sind. Aber wie viele Inferenz-Nodes es genau gibt und welche Konfiguration—das wurde bis heute nicht veröffentlicht. Die technologische Story ist zwar sexy, aber ob die Wirtschaftlichkeit aufgeht, kann man damit nicht automatisch rechnen. Ich habe jedenfalls die Node-Liste erstmal als Lesezeichen gespeichert—nach drei Monaten komme ich zurück, um das abzugleichen. Jetzt einsteigen? Ich sehe mir erst noch einmal @OpenGradient an.
1
94
·
--
#opg $OPG habe vier Tage lang OpenGradient Chat getestet, dabei sieben oder acht Dutzend Konversationen von einfachen Fragen bis hin zu mehrstufigen logischen Abfragen ausprobiert. Hier sind ein paar praktische Eindrücke.
Die erste Reaktion ist: schnell. Ich habe es um elf Uhr abends und nachmittags zwischen zwei und drei Uhr getestet, selbst zu Stoßzeiten gab es keine merklichen Verzögerungen; nach einer Frage kam in der Regel innerhalb von zwei Sekunden eine Antwort. Bei der Durchsicht des Whitepapers im zweiten Kapitel haben sie die Inferenz und die Validierung in zwei separate Pfade aufgeteilt – die GPU-Knoten kümmern sich nur um die Ausführung des Modells, das Ergebnis wird separat durch eine kryptografische Validierung verarbeitet. Dieses Design macht im praktischen Einsatz einen spürbaren Unterschied, anders als bei manchen Projekten, wo die Inferenz schnell ist, die Validierung jedoch nicht mithalten kann, oder wo eine umfassende Validierung die Antwortzeiten stark verlangsamt.
Aber es gab auch Rückschläge. Am dritten Abend gab es ein Sicherheitsproblem mit einem Vertrag; die Inferenz war sehr schnell und lieferte in drei Sekunden ein Ergebnis, aber die Validierung hat fast zehn Sekunden gedauert, der Status blieb ständig auf "pending" und ich dachte schon, ich wäre disconnected. Später habe ich die Blockchain-Daten überprüft und festgestellt, dass ein bestimmter Validierungsknoten langsam war. Solche Details findet man nicht im Whitepaper, aber im realen Betrieb stößt man darauf, das ist die Realität von On-Chain-AI.
Jetzt zur Verteilung der Knoten. Ich habe mit zwei Leuten gesprochen, die OPG-Knoten betrieben haben, und sie haben eine Rechnung aufgemacht – derzeit bei dem aktuellen OPG-Preis, wenn man die Stromkosten und die Maschinenabschreibungen einberechnet, ist der Zeitraum zur Amortisation fast doppelt so lang wie offiziell angegeben. Einer von ihnen sagte wörtlich: "Es sei denn, der Coinpreis verdoppelt sich, sonst ist das Aufstocken der Maschinen ein Glücksspiel." Momentan gibt es nur eine begrenzte Anzahl von Inferenzknoten im gesamten Netzwerk, die führenden Akteure konzentrieren einen Großteil der Rechenleistung, was mich etwas zögern lässt.
Mein Urteil: Ich sehe es als ein zentralisiertes AI-Tool, die Erfahrung ist durchweg positiv, es funktioniert sogar recht gut. Aber in Bezug auf den On-Chain-Validierungsbereich werde ich vorerst kein großes Kapital investieren. Wenn die Verteilung der Knoten von der aktuellen Konzentration der Spitzenknoten unter 60 % fällt, werde ich eine Neubewertung vornehmen. Die Untergrenze von OpenGradient ist, dass der Validierungspfad in extremen Fällen hängen bleiben kann, die Obergrenze hängt davon ab, ob die Anreize für die Knoten nachhaltig bleiben. Gut zu nutzen und stabil zu investieren sind zwei verschiedene Dinge; ich beobachte jetzt die Verteilungskarte der Knoten genau.
@OpenGradient
102
·
--
Verifiziert
Übersetzung ansehen
#opg OPG代币到底值不值得拿?说点实在的
先说结论:OPG不是那种让你无脑冲的币,但它的价值逻辑比大多数AI项目要硬。
很多人一上来就问价格,我告诉你,6月16号OPG是0.1618美元,市值3000万出头。但这都不重要。你得先搞清楚一件事——这个代币到底有没有人用?
需求是真的还是假的?
OpenGradient现在跑了200多万次可验证AI推理,托了2000多个模型在上面。每次推理调用都要烧OPG。这不是那种项目方自己刷的数据,是可验证的链上记录。
币安5月22号上了现货,韩国Upbit也跟进。说白了大交易所愿意接,说明尽调过了,不是空气。
代币分配里有玄机
总量10亿,现在流通不到1.9亿,19%左右。乍一看有解锁压力对不对?但你仔细看:生态40%要60个月慢慢放,贡献者和投资者那25%都锁12个月才开始放,一放就是36个月。这意味着什么?大仓位被摁住了,短期内不会砸盘。
四层价值捕获
OPG不是治理币那种虚头巴脑的东西。它是支付工具,你调AI模型就得花OPG;节点要干活得先质押OPG,搞鬼了直接罚没;开发者上传模型也能赚OPG。四层需求叠在一起,比那种只会投票的空气币强太多了。
风险也得说清楚
TEE依赖AWS,这是个中心化风险。项目方自己也清楚,但没办法,短期没有比Nitro更好的选择。另外ZKML那套对LLM成本太高,大部分场景还是靠TEE顶着。
最后说句实在话$OPG
这个赛道真正的考验是:当可验证AI推理成为刚需,OPG的消耗速度能不能跑赢代币解锁。现在盘子小,波动大,自己掂量着来。@OpenGradient
1
1
439
·
--
Übersetzung ansehen
#opg $OPG 先说一个反直觉的判断:OpenGradient要解决的不是“AI不够强”,而是“AI不可信”。LLM输出的投资建议或交易信号,用户无法独立验证计算过程是否被篡改。白皮书的核心思路就是把这个过程变成“可审计的计算”。
一、HACA:执行与验证解耦
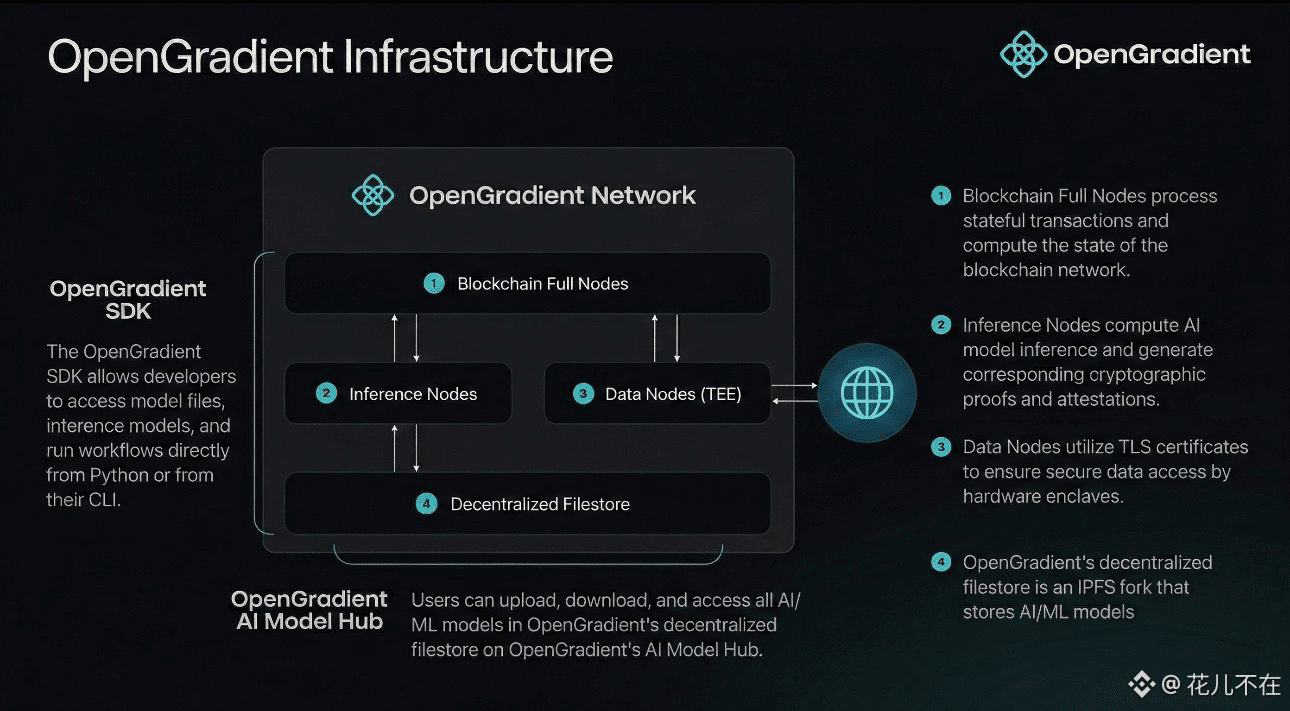
传统区块链要求每个验证节点重新执行每笔交易,这对AI推理不现实。OpenGradient的HACA架构把网络拆成三层:推理节点(GPU+TEE执行模型,返回结果,区块链不在关键路径上)、全节点(验证TEE/ZKML证明,同时用CometBFT共识维护账本)、数据节点(TEE内安全获取外部数据)。验证节点不跑模型,只检查证明——这是性能优化的核心。
二、验证框架:信任等级菜单
白皮书设计了三种验证路径:TEE(AWS Nitro Enclaves,认证文档证明环境未被篡改,覆盖LLM和大部分ML场景)、ZKML(零知识证明,数学级别确定性,但成本高,仅用于高风险ML推理)、Vanilla(无证明,低要求场景)。x402支付协议已嵌入每个TEE实例,消除中心化中间件,支持异步结算,预充值后推理请求不被链上阻塞。
三、代币与现状
OPG总供应量10亿枚,2026年4月TGE于Base链,当前流通约19%。代币用于支付推理费、质押罚没、治理投票。生态、贡献者、投资者份额均有长期锁仓(12个月cliff+36个月线性释放),短期抛压受控。网络目前处于测试网阶段,已处理200万+可验证推理,托管2000+模型,生成50万+证明。
值得观察的风险:TEE依赖AWS Nitro,去中心化存在集中化张力;ZKML对LLM尚不现实,验证的“成本-安全”权衡由开发者承担;未来两年供给释放持续,需网络收入增长匹配。
当“可验证”成为AI输出的默认要求,OpenGradient的架构取舍才有真正的护城河。
#OPG $OPG @OpenGradient
113
·
--
Übersetzung ansehen
#opg $OPG 聊点实在的。很多人盯着OPG代币价格,没搞懂它底层HACA架构到底在解决什么。
传统区块链玩不转AI,原因特简单。以太坊那套逻辑是每个验证节点把同一笔交易重新跑一遍,结果一致就达成共识。转账没问题,但AI推理呢?跑700亿参数大模型,需要GPU、需要时间、每次输出还不一样。让100个验证节点各跑一遍?成本翻100倍,时间拖到死。有人把AI当“预言机”数据喂进来,等于把信任从AI提供商挪到预言机提供商,换汤不换药。
OpenGradient的思路就一个字:拆。HACA的核心:执行和验证分开搞。三种节点各干各的:
· 推理节点——GPU跑模型,结果直接甩给用户,延迟跟用ChatGPT差不多。
· 全节点——不跑模型,只验证推理节点提交的密码学证明(TEE或ZKML)。验证通过就记上链,根本不需要知道提示词、模型、结果是啥,纯密码学操作。
· 数据节点——专门从外部抓数据,TEE里搞,确保数据没被动手脚。
这设计妙在哪?推理走“快路径”——你发请求、GPU算、结果秒回你,区块链不掺和。验证走“慢路径”——证明异步提交、全节点验证、链上记录。速度是Web2级别,信任是Web3级别。推理节点越多吞吐量越大,验证层压力一点不涨——证明验证就毫秒级,跟你跑模型花了5秒还是50秒没关系。
说人话:你拿到结果的速度跟用ChatGPT一样快,但每个结果都能被独立验证、永久追溯——不需要信任何人。
目前主网跑了200多万次可验证推理、50多万份证明、2000多个模型。a16z和Coinbase Ventures已上车。这机制把“黑盒AI”拆成“透明流水线”,方向对了,剩下的看生态能不能跑起来@OpenGradient
95
·
--
#bedrock $BR Aktuell sieht man überall in der Szene die Werbetexte für die Bedrock-All-in-One-Liquidität, Airdrop-Vorteile und hohe Gewinne, die ständig den Markt anheizen. Viele Retail-Trader folgen dem Trend, leihen sich Geld und versuchen, durch das Abgreifen von Belohnungen Gewinne zu erzielen. Nach einer zweiwöchigen Testphase im Live-Trading möchte ich aus der Sicht eines normalen Investors die wahre Natur des Projekts beleuchten.
Das auf uniBTC basierende cross-chain Einkommenssystem ist das Kern-Highlight des Projekts. Früher musste man für BTC-Assets, um in mehreren Ökosystemen zu investieren, häufig Brücken nutzen, was nicht nur zeitaufwendig war, sondern auch mehrere on-chain Transaktionsgebühren anfallen ließ. Mit der Plattform kann man durch einfache Staking-Mechanismen Liquiditätszertifikate generieren, die Assets können flexibel zwischen den verschiedenen Ertragsprotokollen bewegt werden, was die Kapitalumschlagseffizienz weit über die traditionellen Staking-Produkte auf dem Markt hebt. Das Design ist sehr freundlich gegenüber großen Kapitalanlagen.
Um jedoch die Bedienung zu vereinfachen, hat das Projekt das Management der unteren Knoten, das Risikomanagement der Assets und die Regeln zur Kapitalzusammenführung alles intern verpackt. Benutzer können nur die Buchgewinne auf der Frontend-Oberfläche sehen und haben keinen Zugriff auf die Details der verwalteten Basis-Assets. Für alte Hasen, die Wert auf on-chain Transparenz legen, ist dies ein schwerwiegendes Problem.
Derzeit folgen viele Retail-Trader mit einem Volumen von mehreren Hundert USDT dem Zyklus des Staking und der Aufgabenbearbeitung. Das gesamte wirtschaftliche Modell tendiert dabei stark zu den Walen. Die häufigen Transaktionen mit kleinen Beträgen verursachen Gasgebühren und Slippage, die nach und nach die wenigen ökologischen Belohnungen aufzehren. Die meisten Teilnehmer schaffen es nicht, Gewinne zu erzielen, sondern heben indirekt das TVL des Projekts an.
Praktische Empfehlung: Bleibt gelassen und gebt die Vorstellung auf, durch Airdrops reich zu werden, betrachtet das Projekt einfach als Liquiditätswerkzeug. Nutzt die durch Staking erhaltenen Zertifikate für eine solide Konfiguration mit etablierten DeFi-Protokollen und behandelt den Airdrop als zusätzlichen Bonus. Wenn die Marktaufmerksamkeit nachlässt und man die tatsächlichen verbleibenden Gelder im Ökosystem beobachtet, kann man dann die weiteren Investitionen planen.
#Bedrock #btcfire @Bedrock
65
·
--
#bedrock $BR Monate in der Community zeigen immer mehr Leute ihre BR-Punkte, ein Freund hat sogar einen Screenshot der Top 10 als Profilbild und sagt jedem: "Das ist die wahre Kunst von BTCFi". Um ehrlich zu sein, ich musste mich fast kaputtlachen – nach sechs Jahren im DeFi-Bereich, von MakerDAO bis hin zum aktuellen Re-Staking, habe ich mir diese Masche, das "Kapitalniveau" als "Nutzeranreiz" zu verpacken, schon mindestens zehnmal angesehen.
Kurz gesagt, Bedrock kann im BTCFi-Sektor glänzen, weil es nie nur darum ging, BTC einfach cross-chain zu bringen. Hast du bemerkt, dass ihre echte Burggraben-Strategie das scheinbar faire, nichtlineare Punktesystem ist? Die Projektleitung ist schlau, sie machen nicht direkt "Wenigkapitalisten, haltet euch fern", sondern nutzen eine Punktformel, um heimlich eine Kapitalstufung zu vollziehen: Wenn du 1 BTC stakest, können die großen Fische, die ihr Kapital ein Jahr lang binden, an Punkten das gleiche erreichen, was Kleinanleger in drei Monaten durch häufiges Ein- und Aussteigen schaffen. Zwei Kapitalarten, zwei Rabattmodelle, und zwischen ihnen liegt eine immer unerreichbare Ertragskuppel.
Der Vorteil dieses Designs für das Protokoll ist offensichtlich: Der TVL schießt wie ein Luftballon von 500 Millionen auf 3 Milliarden, und das Kapital bleibt in verschachtelten Verträgen gefangen, selbst die Wale wollen nicht einfach abspringen. Aber die Kosten tragen die Kleinanleger – ich habe mit eigenen Augen gesehen, wie jemand in der Gruppe jeden Tag drei Wecker stellt, um um zwei Uhr morgens aufzustehen, ins Pool zu wechseln und Punkte zu farmen. Die Gebühren haben mehrere Tausend U verbrannt, aber die Punktplatzierung bleibt unverändert. Warum? Weil in diesem Modell, das durch die Dauer der Einzahlung und die Kapitalhöhe bestimmt wird, das Umlaufkapital der Kleinen niemals mit den ruhenden Vermögenswerten der großen Fische mithalten kann.
Ironischerweise schafft die Plattform auch noch die Illusion, dass "Fleiß zu mehr Ertrag führt". Du schaust jeden Tag auf die APY-Schwankungen, schiebst dein Kapital zwischen verschiedenen Pools hin und her, um für 0,01% mehr Punkte selbstzufrieden zu sein. Dieses Sisyphus-artige Wiederholen, ist das wirklich faire Teilnahme? Wir sind nur von der untersten Stufe der traditionellen Finanzhierarchie zur Subaltern-Ebene des on-chain-Punktesystems gewandert. Jeder Punkt von $BR , der von Institutionen überteuert eingesammelt wird, hat darunter unzählige kleine Investitionen, die durch Zeit und Skalierung doppelt verwässert wurden, als versunkene Kosten.
#bedrock $BR @Bedrock
104
Anmelden und weiter Inhalte entdecken
Krypto-Nutzer weltweit auf Binance Square kennenlernen
⚡️ Bleib in Sachen Krypto stets am Puls.
💬 Die weltgrößte Kryptobörse vertraut darauf.
👍 Erhalte verlässliche Einblicke von verifizierten Creators.
E-Mail-Adresse/Telefonnummer
Trendthemen
ETHUp70%InQ3ButLiquidityFalls
268 Aufrufe
63 Kommentare
🚨 Ethereum-Update: ETH legte im 3. Quartal um 70 % zu, aber die Liquidität sinkt. Die Kursstärke sieht beeindruckend aus, doch die rückläufige Liquidität könnte die Volatilität erhöhen und die nächste Bewegung noch wichtiger machen. 📊 Kurs rauf. Liquidität runter. Was denkst du, was als Nächstes für ETH kommt? #ETH #Ethereum #Crypto #CryptoNews #DeFi #Blockchain #ETHUSD
#ETHUp70%InQ3ButLiquidityFalls
Die Performance von Ethereum im 3. Quartal 2026 widersetzte sich vollständig den historischen Marktbeziehungen. Während ETH im 3. Quartal um 70,8 % zulegte und damit Bitcoins Anstieg von 42 % deutlich übertraf, erreichte es diesen Meilenstein bei dramatisch ausgedünnten Orderbüchern. Laut aktuellen Daten von CoinGecko fiel die mediane tägliche Markttiefe von ETH auf nur noch 35 % bis 45 % des Bitcoin-Niveaus, nach über 60 % im gleichen Zeitraum des Vorjahres. [1, 2, 3]
Gültige Ergebnisindizes für FinancePriceChart:
CHASEPA SULUX
·0 Likes
·9 Aufrufe
EthStakingExitQueueHits2026High
1,106 Aufrufe
141 Kommentare
FedOctoberHoldOdds82.3%
1,312 Aufrufe
130 Kommentare