
Lavender⁰⁰¹
3.1k Beiträge

Lavender⁰⁰¹
Melden
Nutzer blockieren
Learning | Crypto Content Creator | Web3 believer 💛 💎 📈
Trade eröffnen
Hochfrequenz-Trader
4.8 Monate
221 Following
2.5K+ Follower
1.9K+ Like gegeben
Beiträge
Portfolio
·
--
#dusk $DUSK @Dusk_Foundation Eine kleine Tabelle in DUSKs Sicherheitshinweisen zur Wallet ließ das Wort „Passwort“ irreführend wirken. Die Browser-Erweiterung verwendet PBKDF2-SHA-256 mit 900.000 Iterationen, während der native Weg als Stronghold plus Argon2 und als OS-seitig verschlüsselter Speicher beschrieben wird.
Damit kauft dasselbe Passwort nicht notwendigerweise auch dieselbe Widerstandsfähigkeit gegen das Knacken. Doch DUSKs öffentliches Material legt nicht genug native Argon2-Details offen – etwa den Speicherverbrauch, die Iterationszahl und die Parallelität –, um berechnen zu können, wie viel schwerer ein Offline-Angriff tatsächlich ist. „Speicherhart“ ist eine Designtags-Behauptung, kein gemessener Vorteil.
Es gibt noch ein weiteres Problem: Verschlüsselung im Ruhezustand schützt einen gesperrten Tresor. Nach dem Entsperren hält die Erweiterung das Mnemonic im JavaScript-Heap vor, löscht es bei Sperre oder Timeout, kann jedoch keine vollständige Zeroisierung garantieren. Ein schwaches Passwort kann die erste Verteidigung schrumpfen lassen; eine bösartige Erweiterung oder ein kompromittiertes Gerät kann vollständig daran vorbeigehen.
Das verändert, wie ich DUSKs Self-Custody bewerte: Passwortstärke versus tatsächliche Angriffsfläche – nicht Argon2 im Vergleich zu PBKDF2 als Markenbegriff.
Ich möchte, dass DUSK die vollständigen nativen KDF-Parameter veröffentlicht, gleiche Passwörter geräteübergreifend benchmarkt und berichtet, wie lange Schlüsselmaterial exponiert bleibt. Bis dahin beantwortet die Aussage, dass DUSK Argon2 nutzt, nicht, welches Tool existiert, sondern nicht, wie viel Schutz Nutzer wirklich erhalten.
{future}(DUSKUSDT)
#dusk $DUSK @Dusk Eine kleine Tabelle in DUSKs Sicherheitshinweisen zur Wallet ließ das Wort „Passwort“ irreführend wirken. Die Browser-Erweiterung verwendet PBKDF2-SHA-256 mit 900.000 Iterationen, während der native Weg als Stronghold plus Argon2 und als OS-seitig verschlüsselter Speicher beschrieben wird.
Damit kauft dasselbe Passwort nicht notwendigerweise auch dieselbe Widerstandsfähigkeit gegen das Knacken. Doch DUSKs öffentliches Material legt nicht genug native Argon2-Details offen – etwa den Speicherverbrauch, die Iterationszahl und die Parallelität –, um berechnen zu können, wie viel schwerer ein Offline-Angriff tatsächlich ist. „Speicherhart“ ist eine Designtags-Behauptung, kein gemessener Vorteil.
Es gibt noch ein weiteres Problem: Verschlüsselung im Ruhezustand schützt einen gesperrten Tresor. Nach dem Entsperren hält die Erweiterung das Mnemonic im JavaScript-Heap vor, löscht es bei Sperre oder Timeout, kann jedoch keine vollständige Zeroisierung garantieren. Ein schwaches Passwort kann die erste Verteidigung schrumpfen lassen; eine bösartige Erweiterung oder ein kompromittiertes Gerät kann vollständig daran vorbeigehen.
Das verändert, wie ich DUSKs Self-Custody bewerte: Passwortstärke versus tatsächliche Angriffsfläche – nicht Argon2 im Vergleich zu PBKDF2 als Markenbegriff.
Ich möchte, dass DUSK die vollständigen nativen KDF-Parameter veröffentlicht, gleiche Passwörter geräteübergreifend benchmarkt und berichtet, wie lange Schlüsselmaterial exponiert bleibt. Bis dahin beantwortet die Aussage, dass DUSK Argon2 nutzt, nicht, welches Tool existiert, sondern nicht, wie viel Schutz Nutzer wirklich erhalten.
Damit kauft dasselbe Passwort nicht notwendigerweise auch dieselbe Widerstandsfähigkeit gegen das Knacken. Doch DUSKs öffentliches Material legt nicht genug native Argon2-Details offen – etwa den Speicherverbrauch, die Iterationszahl und die Parallelität –, um berechnen zu können, wie viel schwerer ein Offline-Angriff tatsächlich ist. „Speicherhart“ ist eine Designtags-Behauptung, kein gemessener Vorteil.
Es gibt noch ein weiteres Problem: Verschlüsselung im Ruhezustand schützt einen gesperrten Tresor. Nach dem Entsperren hält die Erweiterung das Mnemonic im JavaScript-Heap vor, löscht es bei Sperre oder Timeout, kann jedoch keine vollständige Zeroisierung garantieren. Ein schwaches Passwort kann die erste Verteidigung schrumpfen lassen; eine bösartige Erweiterung oder ein kompromittiertes Gerät kann vollständig daran vorbeigehen.
Das verändert, wie ich DUSKs Self-Custody bewerte: Passwortstärke versus tatsächliche Angriffsfläche – nicht Argon2 im Vergleich zu PBKDF2 als Markenbegriff.
Ich möchte, dass DUSK die vollständigen nativen KDF-Parameter veröffentlicht, gleiche Passwörter geräteübergreifend benchmarkt und berichtet, wie lange Schlüsselmaterial exponiert bleibt. Bis dahin beantwortet die Aussage, dass DUSK Argon2 nutzt, nicht, welches Tool existiert, sondern nicht, wie viel Schutz Nutzer wirklich erhalten.
8
10
10.9k
·
--
#dusk $DUSK @Dusk_Foundation Ich blieb beim Vergleichen zweier Dusk-Konten hängen, die innerhalb weniger Minuten finanziert wurden. Das eine überwies sofort, das andere blieb unangetastet und tauchte nie wieder auf.
Diese Lücke kann mehr verraten als das Kontowachstum. Sinnvolle Kohorten sind Wallets, die eine erste Aktion ausführen, innerhalb von sieben Tagen zurückkehren und mehr machen als nur kreisförmige Transfers zwischen verbundenen Clustern.
Für DUSK würde ich Transfer-only-Nutzer von Contract-Nutzern trennen, dann die Aktivierungszeit, verwaiste Guthaben, Retention, die Flows der Top-Dekile und die Streuung öffentlicher Guthaben verfolgen. Die Verteilung kann gesünder aussehen, während dasselbe Kapital weiter im Kreis läuft. Etwas unbeholfen, aber wichtig.
Provisioner verdienen dieselbe Testbelohnungs-Volatilität nach der Stake-Größe: der Anteil, der in 24 Stunden nichts verdient, die Quote verpasster Stimmen, eine 99%-Uptime-Abdeckung, der Bucket für 1.000–2.000 DUSK und die Stake-HHI. Dann entferne die drei wichtigsten Provisioner aus den Ausschuss-Simulationen. Hält die Finalität trotzdem?
Was die meisten übersehen, ist: Anzahl ist keine Resilienz. Steigende Stakes nach überdurchschnittlichen Belohnungen könnten Yield-Chasing sein, während eine dominante Rusk-Implementierung jede*n Betreiber*in demselben Client-Ausfall aussetzt.
DUSK kann sichtbare Aktivität belohnen, während es auf einen engeren Kern echter Nutzer und zuverlässige Stakes angewiesen ist. Wenn beide Gruppen breiter wirken, als sie sind, wird Dezentralisierung zur Präsentationsschicht.
Ich beobachte die Verteilungen, nicht die Gesamtsummen.
{future}(DUSKUSDT)
#dusk $DUSK @Dusk Ich blieb beim Vergleichen zweier Dusk-Konten hängen, die innerhalb weniger Minuten finanziert wurden. Das eine überwies sofort, das andere blieb unangetastet und tauchte nie wieder auf.
Diese Lücke kann mehr verraten als das Kontowachstum. Sinnvolle Kohorten sind Wallets, die eine erste Aktion ausführen, innerhalb von sieben Tagen zurückkehren und mehr machen als nur kreisförmige Transfers zwischen verbundenen Clustern.
Für DUSK würde ich Transfer-only-Nutzer von Contract-Nutzern trennen, dann die Aktivierungszeit, verwaiste Guthaben, Retention, die Flows der Top-Dekile und die Streuung öffentlicher Guthaben verfolgen. Die Verteilung kann gesünder aussehen, während dasselbe Kapital weiter im Kreis läuft. Etwas unbeholfen, aber wichtig.
Provisioner verdienen dieselbe Testbelohnungs-Volatilität nach der Stake-Größe: der Anteil, der in 24 Stunden nichts verdient, die Quote verpasster Stimmen, eine 99%-Uptime-Abdeckung, der Bucket für 1.000–2.000 DUSK und die Stake-HHI. Dann entferne die drei wichtigsten Provisioner aus den Ausschuss-Simulationen. Hält die Finalität trotzdem?
Was die meisten übersehen, ist: Anzahl ist keine Resilienz. Steigende Stakes nach überdurchschnittlichen Belohnungen könnten Yield-Chasing sein, während eine dominante Rusk-Implementierung jede*n Betreiber*in demselben Client-Ausfall aussetzt.
DUSK kann sichtbare Aktivität belohnen, während es auf einen engeren Kern echter Nutzer und zuverlässige Stakes angewiesen ist. Wenn beide Gruppen breiter wirken, als sie sind, wird Dezentralisierung zur Präsentationsschicht.
Ich beobachte die Verteilungen, nicht die Gesamtsummen.
Diese Lücke kann mehr verraten als das Kontowachstum. Sinnvolle Kohorten sind Wallets, die eine erste Aktion ausführen, innerhalb von sieben Tagen zurückkehren und mehr machen als nur kreisförmige Transfers zwischen verbundenen Clustern.
Für DUSK würde ich Transfer-only-Nutzer von Contract-Nutzern trennen, dann die Aktivierungszeit, verwaiste Guthaben, Retention, die Flows der Top-Dekile und die Streuung öffentlicher Guthaben verfolgen. Die Verteilung kann gesünder aussehen, während dasselbe Kapital weiter im Kreis läuft. Etwas unbeholfen, aber wichtig.
Provisioner verdienen dieselbe Testbelohnungs-Volatilität nach der Stake-Größe: der Anteil, der in 24 Stunden nichts verdient, die Quote verpasster Stimmen, eine 99%-Uptime-Abdeckung, der Bucket für 1.000–2.000 DUSK und die Stake-HHI. Dann entferne die drei wichtigsten Provisioner aus den Ausschuss-Simulationen. Hält die Finalität trotzdem?
Was die meisten übersehen, ist: Anzahl ist keine Resilienz. Steigende Stakes nach überdurchschnittlichen Belohnungen könnten Yield-Chasing sein, während eine dominante Rusk-Implementierung jede*n Betreiber*in demselben Client-Ausfall aussetzt.
DUSK kann sichtbare Aktivität belohnen, während es auf einen engeren Kern echter Nutzer und zuverlässige Stakes angewiesen ist. Wenn beide Gruppen breiter wirken, als sie sind, wird Dezentralisierung zur Präsentationsschicht.
Ich beobachte die Verteilungen, nicht die Gesamtsummen.
6
11
6.5k
·
--
Verifiziert
#dusk $DUSK @Dusk_Foundation Ich habe die Brückenmathematik von DUSK überprüft, und eine Zahl hat mich mehr gestört als die Lautstärke der Schlagzeile: Wie viel Versorgung liegt tatsächlich noch auf ERC20 und BEP20, nachdem das Mainnet migriert wurde?
Das ist der Reifetest, der mich interessiert.
Wenn €10M abfließen und €10M zurückkommen, kann die Brücke €20M Bruttoaktivität melden, während die Netto-Migration bei null liegt. Bewegung ist nicht Migration. Volumen ist nicht Abschluss.
Ich würde lieber die Migrationsgeschwindigkeit jede Woche verfolgen, den Prozentsatz des verbleibenden Legacy-DUSK noch außerhalb des Mainnets und das „Dust Ratio“, das zurückbleibt, nachdem Nutzer eine Migration anfragen. Diese Zahlen würden zeigen, ob sich das Netzwerk konsolidiert oder nur im Kreis zirkuliert.
Die feste Brücken-Gebühr bringt noch eine weitere Besonderheit hervor. Eine Gebühr von 1 DUSK auf 10 Tokens entspricht 10%. Bei 10.000 Tokens sind es 0,01%. Gleiche Infrastruktur, völlig unterschiedliche Nutzerökonomik.
Und selbst nachdem eine Mainnet-Brückenübertragung endgültig ist, kann die Zustelllieferung am Ziel weiterhin von einem externen Verarbeitungsschritt abhängen. Das ist wichtiger, als es klingt.
Die tiefergehende Frage ist ähnlich bei RWAs: €300M „gewrappt“ On-Chain sind nicht dasselbe wie €300M nativ On-Chain ausgegeben. Das eine spiegelt Legacy-Infrastruktur wider; das andere ersetzt einen Teil davon.
Ich beobachte DUSK auf Migrationsabschluss hin, nicht auf Brückenbewegung.
{future}(DUSKUSDT)
#dusk $DUSK @Dusk Ich habe die Brückenmathematik von DUSK überprüft, und eine Zahl hat mich mehr gestört als die Lautstärke der Schlagzeile: Wie viel Versorgung liegt tatsächlich noch auf ERC20 und BEP20, nachdem das Mainnet migriert wurde?
Das ist der Reifetest, der mich interessiert.
Wenn €10M abfließen und €10M zurückkommen, kann die Brücke €20M Bruttoaktivität melden, während die Netto-Migration bei null liegt. Bewegung ist nicht Migration. Volumen ist nicht Abschluss.
Ich würde lieber die Migrationsgeschwindigkeit jede Woche verfolgen, den Prozentsatz des verbleibenden Legacy-DUSK noch außerhalb des Mainnets und das „Dust Ratio“, das zurückbleibt, nachdem Nutzer eine Migration anfragen. Diese Zahlen würden zeigen, ob sich das Netzwerk konsolidiert oder nur im Kreis zirkuliert.
Die feste Brücken-Gebühr bringt noch eine weitere Besonderheit hervor. Eine Gebühr von 1 DUSK auf 10 Tokens entspricht 10%. Bei 10.000 Tokens sind es 0,01%. Gleiche Infrastruktur, völlig unterschiedliche Nutzerökonomik.
Und selbst nachdem eine Mainnet-Brückenübertragung endgültig ist, kann die Zustelllieferung am Ziel weiterhin von einem externen Verarbeitungsschritt abhängen. Das ist wichtiger, als es klingt.
Die tiefergehende Frage ist ähnlich bei RWAs: €300M „gewrappt“ On-Chain sind nicht dasselbe wie €300M nativ On-Chain ausgegeben. Das eine spiegelt Legacy-Infrastruktur wider; das andere ersetzt einen Teil davon.
Ich beobachte DUSK auf Migrationsabschluss hin, nicht auf Brückenbewegung.
Das ist der Reifetest, der mich interessiert.
Wenn €10M abfließen und €10M zurückkommen, kann die Brücke €20M Bruttoaktivität melden, während die Netto-Migration bei null liegt. Bewegung ist nicht Migration. Volumen ist nicht Abschluss.
Ich würde lieber die Migrationsgeschwindigkeit jede Woche verfolgen, den Prozentsatz des verbleibenden Legacy-DUSK noch außerhalb des Mainnets und das „Dust Ratio“, das zurückbleibt, nachdem Nutzer eine Migration anfragen. Diese Zahlen würden zeigen, ob sich das Netzwerk konsolidiert oder nur im Kreis zirkuliert.
Die feste Brücken-Gebühr bringt noch eine weitere Besonderheit hervor. Eine Gebühr von 1 DUSK auf 10 Tokens entspricht 10%. Bei 10.000 Tokens sind es 0,01%. Gleiche Infrastruktur, völlig unterschiedliche Nutzerökonomik.
Und selbst nachdem eine Mainnet-Brückenübertragung endgültig ist, kann die Zustelllieferung am Ziel weiterhin von einem externen Verarbeitungsschritt abhängen. Das ist wichtiger, als es klingt.
Die tiefergehende Frage ist ähnlich bei RWAs: €300M „gewrappt“ On-Chain sind nicht dasselbe wie €300M nativ On-Chain ausgegeben. Das eine spiegelt Legacy-Infrastruktur wider; das andere ersetzt einen Teil davon.
Ich beobachte DUSK auf Migrationsabschluss hin, nicht auf Brückenbewegung.
15
20
17.6k
·
--
#dusk $DUSK @Dusk_Foundation Der Markt bewegte sich heute Abend seitwärts, und ich las gerade halb die DUSK-Dokumentation, als ich mich dabei erwischte, wie ich viel zu lange auf dieselbe Frage starrte: Wie viel von DUSK’s Aktivität läuft eigentlich wirklich über seine Privacy-Layer?
Es ist einfach, Moonlight und Phoenix als zwei Transaktionsmodelle zu betrachten und damit aufzuhören. Aber das verfehlt den interessanten Teil. Wenn Privacy wirklich nützlich ist, würde ich erwarten, dass Nutzer sie wählen – nicht nur dass das Protokoll sie unterstützt.
Also würde ich den Split über 24H, 7D, 30D und 90D verfolgen: den Moonlight-Anteil, den Phoenix-Anteil, aktive Nutzer, Transaktionen pro Nutzer – und dann dieselben Konten von ihrer ersten Moonlight-Transaktion bis zu ihrer ersten Phoenix-Transaktion nachverfolgen.
Das verändert die Frage komplett.
Privacy-Adoption ist nicht dadurch bewiesen, dass es ein privates Transaktionsmodell gibt.
Sie ist bewiesen, wenn Nutzer freiwillig migrieren und dort bleiben.
Ich würde außerdem die durchschnittliche Median-Migrationszeit messen und die Phoenix-Retention bei D7/D30/D90. Ein Spike bei Phoenix-Transaktionen könnte auf Experimente hindeuten. Beständige wiederholte Nutzung würde für etwas Stärkeres sprechen.
Es gibt eine zweite Ebene, auf die ich achten würde: Vertragsaufrufe versus einfache Transfers. Wenn Anwendungsinteraktionen und Privacy-Aktivität beide steigen, könnte DUSK tiefere Nutzung zeigen – statt nur ein simples Transaktionswachstum.
Ich weiß noch nicht, was die Zahlen ergeben würden. Genau deshalb würde ich lieber Verhalten messen als die wiederholte Privacy-Erzählung.
Und der Reiter für die Dokumentation ist immer noch offen......
{future}(DUSKUSDT)
#dusk $DUSK @Dusk Der Markt bewegte sich heute Abend seitwärts, und ich las gerade halb die DUSK-Dokumentation, als ich mich dabei erwischte, wie ich viel zu lange auf dieselbe Frage starrte: Wie viel von DUSK’s Aktivität läuft eigentlich wirklich über seine Privacy-Layer?
Es ist einfach, Moonlight und Phoenix als zwei Transaktionsmodelle zu betrachten und damit aufzuhören. Aber das verfehlt den interessanten Teil. Wenn Privacy wirklich nützlich ist, würde ich erwarten, dass Nutzer sie wählen – nicht nur dass das Protokoll sie unterstützt.
Also würde ich den Split über 24H, 7D, 30D und 90D verfolgen: den Moonlight-Anteil, den Phoenix-Anteil, aktive Nutzer, Transaktionen pro Nutzer – und dann dieselben Konten von ihrer ersten Moonlight-Transaktion bis zu ihrer ersten Phoenix-Transaktion nachverfolgen.
Das verändert die Frage komplett.
Privacy-Adoption ist nicht dadurch bewiesen, dass es ein privates Transaktionsmodell gibt.
Sie ist bewiesen, wenn Nutzer freiwillig migrieren und dort bleiben.
Ich würde außerdem die durchschnittliche Median-Migrationszeit messen und die Phoenix-Retention bei D7/D30/D90. Ein Spike bei Phoenix-Transaktionen könnte auf Experimente hindeuten. Beständige wiederholte Nutzung würde für etwas Stärkeres sprechen.
Es gibt eine zweite Ebene, auf die ich achten würde: Vertragsaufrufe versus einfache Transfers. Wenn Anwendungsinteraktionen und Privacy-Aktivität beide steigen, könnte DUSK tiefere Nutzung zeigen – statt nur ein simples Transaktionswachstum.
Ich weiß noch nicht, was die Zahlen ergeben würden. Genau deshalb würde ich lieber Verhalten messen als die wiederholte Privacy-Erzählung.
Und der Reiter für die Dokumentation ist immer noch offen......
Es ist einfach, Moonlight und Phoenix als zwei Transaktionsmodelle zu betrachten und damit aufzuhören. Aber das verfehlt den interessanten Teil. Wenn Privacy wirklich nützlich ist, würde ich erwarten, dass Nutzer sie wählen – nicht nur dass das Protokoll sie unterstützt.
Also würde ich den Split über 24H, 7D, 30D und 90D verfolgen: den Moonlight-Anteil, den Phoenix-Anteil, aktive Nutzer, Transaktionen pro Nutzer – und dann dieselben Konten von ihrer ersten Moonlight-Transaktion bis zu ihrer ersten Phoenix-Transaktion nachverfolgen.
Das verändert die Frage komplett.
Privacy-Adoption ist nicht dadurch bewiesen, dass es ein privates Transaktionsmodell gibt.
Sie ist bewiesen, wenn Nutzer freiwillig migrieren und dort bleiben.
Ich würde außerdem die durchschnittliche Median-Migrationszeit messen und die Phoenix-Retention bei D7/D30/D90. Ein Spike bei Phoenix-Transaktionen könnte auf Experimente hindeuten. Beständige wiederholte Nutzung würde für etwas Stärkeres sprechen.
Es gibt eine zweite Ebene, auf die ich achten würde: Vertragsaufrufe versus einfache Transfers. Wenn Anwendungsinteraktionen und Privacy-Aktivität beide steigen, könnte DUSK tiefere Nutzung zeigen – statt nur ein simples Transaktionswachstum.
Ich weiß noch nicht, was die Zahlen ergeben würden. Genau deshalb würde ich lieber Verhalten messen als die wiederholte Privacy-Erzählung.
Und der Reiter für die Dokumentation ist immer noch offen......
7
16
11.9k
·
--
Teilweise korrekt
#dusk $DUSK @Dusk_Foundation DUSK Network Staking Concentration Drift: Wie viel ändert sich der Top-10-Anteil pro 100 Epochen?
Der Markt bewegte sich heute Abend kaum, also habe ich stattdessen auf die Provisioner-Tabelle von DUSK gestarrt. Ich sah ständig „200+ aktive Provisioner“ und habe das anfangs als Signal für Dezentralisierung gelesen.
Dann passte etwas nicht zusammen.
Eine Validator-Zählung sagt mir, wie viele Teilnehmende es gibt. Sie sagt nicht, wie viel Konsensgewicht die größten davon kontrollieren. Dusks Staking-Rewards sind probabilistisch und hängen teilweise von aktivem Stake ab, während das Protokoll keinen maximalen Stake festlegt. Das macht eine Concentration Drift messenswert – nicht zu einer Annahme.
Der aktuelle Community-Explorer-Snapshot weist darauf hin, dass etwa 25,8 % des aktiven Stakes bei den zehn größten Provisionern liegen. Aber ein Snapshot kann mir nicht sagen, ob sich DUSK dezentralisiert oder sich langsam zu Clustern formiert.
Das ist der Unterschied: Die Knotenzahl misst Beteiligung; die Stake-Drift misst Macht.
Ich würde den Anteil von Top-10 am aktiven Stake alle 100 Epochen nachverfolgen und die Veränderung dann mit neuem Stake, Unstaking, Pool-Wachstum, Slashing und Reward-Compounding vergleichen.
Vielleicht bleibt die Verteilung gesund. Ich kann das noch nicht wirklich beantworten.
Das Diagramm ist immer noch still. Die Provisioner-Tabelle sieht jetzt viel interessanter aus.
{future}(DUSKUSDT)
#dusk $DUSK @Dusk DUSK Network Staking Concentration Drift: Wie viel ändert sich der Top-10-Anteil pro 100 Epochen?
Der Markt bewegte sich heute Abend kaum, also habe ich stattdessen auf die Provisioner-Tabelle von DUSK gestarrt. Ich sah ständig „200+ aktive Provisioner“ und habe das anfangs als Signal für Dezentralisierung gelesen.
Dann passte etwas nicht zusammen.
Eine Validator-Zählung sagt mir, wie viele Teilnehmende es gibt. Sie sagt nicht, wie viel Konsensgewicht die größten davon kontrollieren. Dusks Staking-Rewards sind probabilistisch und hängen teilweise von aktivem Stake ab, während das Protokoll keinen maximalen Stake festlegt. Das macht eine Concentration Drift messenswert – nicht zu einer Annahme.
Der aktuelle Community-Explorer-Snapshot weist darauf hin, dass etwa 25,8 % des aktiven Stakes bei den zehn größten Provisionern liegen. Aber ein Snapshot kann mir nicht sagen, ob sich DUSK dezentralisiert oder sich langsam zu Clustern formiert.
Das ist der Unterschied: Die Knotenzahl misst Beteiligung; die Stake-Drift misst Macht.
Ich würde den Anteil von Top-10 am aktiven Stake alle 100 Epochen nachverfolgen und die Veränderung dann mit neuem Stake, Unstaking, Pool-Wachstum, Slashing und Reward-Compounding vergleichen.
Vielleicht bleibt die Verteilung gesund. Ich kann das noch nicht wirklich beantworten.
Das Diagramm ist immer noch still. Die Provisioner-Tabelle sieht jetzt viel interessanter aus.
Der Markt bewegte sich heute Abend kaum, also habe ich stattdessen auf die Provisioner-Tabelle von DUSK gestarrt. Ich sah ständig „200+ aktive Provisioner“ und habe das anfangs als Signal für Dezentralisierung gelesen.
Dann passte etwas nicht zusammen.
Eine Validator-Zählung sagt mir, wie viele Teilnehmende es gibt. Sie sagt nicht, wie viel Konsensgewicht die größten davon kontrollieren. Dusks Staking-Rewards sind probabilistisch und hängen teilweise von aktivem Stake ab, während das Protokoll keinen maximalen Stake festlegt. Das macht eine Concentration Drift messenswert – nicht zu einer Annahme.
Der aktuelle Community-Explorer-Snapshot weist darauf hin, dass etwa 25,8 % des aktiven Stakes bei den zehn größten Provisionern liegen. Aber ein Snapshot kann mir nicht sagen, ob sich DUSK dezentralisiert oder sich langsam zu Clustern formiert.
Das ist der Unterschied: Die Knotenzahl misst Beteiligung; die Stake-Drift misst Macht.
Ich würde den Anteil von Top-10 am aktiven Stake alle 100 Epochen nachverfolgen und die Veränderung dann mit neuem Stake, Unstaking, Pool-Wachstum, Slashing und Reward-Compounding vergleichen.
Vielleicht bleibt die Verteilung gesund. Ich kann das noch nicht wirklich beantworten.
Das Diagramm ist immer noch still. Die Provisioner-Tabelle sieht jetzt viel interessanter aus.
15
20
10k
·
--
#dusk $DUSK @Dusk_Foundation Letzte Nacht habe ich DUSK-Burn-Daten verglichen und dabei etwas leicht Ärgerliches bemerkt: Das Verhältnis änderte sich je nachdem, wo ich mit dem 24-Stunden-Zeitraum begonnen habe.
Das klingt nach einer kleinen buchhalterischen Unstimmigkeit. Ist es nicht.
Ein Kalender-Tag von Mitternacht bis Mitternacht kann eine Burn-Story zeigen, während ein rollierender 24-Stunden-Zeitraum, der sechs Stunden später startet, eine andere zeigen kann. Wenn eine kurze DUSK-Burn-Spitze nahe an der Grenze liegt, kann eine Verschiebung des Fensters entweder den Großteil davon erfassen oder sie auf zwei Zeiträume aufteilen.
Also sagt mir das Spitzen-Burn-Verhältnis allein weniger, als ich zunächst dachte.
Wichtiger ist, ob die Burn-Rate über die Zeit stabil bleibt. Ich würde mir ansehen, wie lange DUSK über einem sinnvollen Burn-zu-Belohnungs-Niveau bleibt, wie stark sich das Verhältnis zwischen rollierenden Fenstern bewegt, und ob die größeren Burn-Phasen weiterhin auftauchen. Ein 30%-Anstieg für eine Stunde ist nicht dasselbe wie 16%, die sich über den Großteil des Tages verteilen.
Das ist im Grunde Peak-Aktivität vs. anhaltender Systemdruck.
Ich würde außerdem die Standardabweichung über mehrere rollierende Fenster beobachten. Wenn 24 unterschiedliche Startzeiten völlig unterschiedliche Verhältnisse ergeben, kann das Verbrennen von DUSK weiterhin ereignisgetrieben sein und nicht strukturell stabil.
Die unbequeme Frage ist einfach: Messen wir echten Token-Zerstörungsdruck, oder wählen wir nur ein Zeitfenster, das das neueste Burn-Ereignis besonders wichtig aussehen lässt?
{future}(DUSKUSDT)
#dusk $DUSK @Dusk Letzte Nacht habe ich DUSK-Burn-Daten verglichen und dabei etwas leicht Ärgerliches bemerkt: Das Verhältnis änderte sich je nachdem, wo ich mit dem 24-Stunden-Zeitraum begonnen habe.
Das klingt nach einer kleinen buchhalterischen Unstimmigkeit. Ist es nicht.
Ein Kalender-Tag von Mitternacht bis Mitternacht kann eine Burn-Story zeigen, während ein rollierender 24-Stunden-Zeitraum, der sechs Stunden später startet, eine andere zeigen kann. Wenn eine kurze DUSK-Burn-Spitze nahe an der Grenze liegt, kann eine Verschiebung des Fensters entweder den Großteil davon erfassen oder sie auf zwei Zeiträume aufteilen.
Also sagt mir das Spitzen-Burn-Verhältnis allein weniger, als ich zunächst dachte.
Wichtiger ist, ob die Burn-Rate über die Zeit stabil bleibt. Ich würde mir ansehen, wie lange DUSK über einem sinnvollen Burn-zu-Belohnungs-Niveau bleibt, wie stark sich das Verhältnis zwischen rollierenden Fenstern bewegt, und ob die größeren Burn-Phasen weiterhin auftauchen. Ein 30%-Anstieg für eine Stunde ist nicht dasselbe wie 16%, die sich über den Großteil des Tages verteilen.
Das ist im Grunde Peak-Aktivität vs. anhaltender Systemdruck.
Ich würde außerdem die Standardabweichung über mehrere rollierende Fenster beobachten. Wenn 24 unterschiedliche Startzeiten völlig unterschiedliche Verhältnisse ergeben, kann das Verbrennen von DUSK weiterhin ereignisgetrieben sein und nicht strukturell stabil.
Die unbequeme Frage ist einfach: Messen wir echten Token-Zerstörungsdruck, oder wählen wir nur ein Zeitfenster, das das neueste Burn-Ereignis besonders wichtig aussehen lässt?
Das klingt nach einer kleinen buchhalterischen Unstimmigkeit. Ist es nicht.
Ein Kalender-Tag von Mitternacht bis Mitternacht kann eine Burn-Story zeigen, während ein rollierender 24-Stunden-Zeitraum, der sechs Stunden später startet, eine andere zeigen kann. Wenn eine kurze DUSK-Burn-Spitze nahe an der Grenze liegt, kann eine Verschiebung des Fensters entweder den Großteil davon erfassen oder sie auf zwei Zeiträume aufteilen.
Also sagt mir das Spitzen-Burn-Verhältnis allein weniger, als ich zunächst dachte.
Wichtiger ist, ob die Burn-Rate über die Zeit stabil bleibt. Ich würde mir ansehen, wie lange DUSK über einem sinnvollen Burn-zu-Belohnungs-Niveau bleibt, wie stark sich das Verhältnis zwischen rollierenden Fenstern bewegt, und ob die größeren Burn-Phasen weiterhin auftauchen. Ein 30%-Anstieg für eine Stunde ist nicht dasselbe wie 16%, die sich über den Großteil des Tages verteilen.
Das ist im Grunde Peak-Aktivität vs. anhaltender Systemdruck.
Ich würde außerdem die Standardabweichung über mehrere rollierende Fenster beobachten. Wenn 24 unterschiedliche Startzeiten völlig unterschiedliche Verhältnisse ergeben, kann das Verbrennen von DUSK weiterhin ereignisgetrieben sein und nicht strukturell stabil.
Die unbequeme Frage ist einfach: Messen wir echten Token-Zerstörungsdruck, oder wählen wir nur ein Zeitfenster, das das neueste Burn-Ereignis besonders wichtig aussehen lässt?
30
24
10.2k
·
--
#dusk $DUSK @Dusk_Foundation Beim Prüfen der Belohnungshistorie eines DUSK-Provisioners ist mir etwas aufgefallen, das ich zuvor zu leichtfertig behandelt hatte: Beanspruchtes Stake und nutzbares Consensus-Stake sind nicht dieselbe Zahl.
Diese Lücke ist wichtig, weil sich die Qualität des Stakings auf das wirtschaftliche Ergebnis auswirken kann, selbst wenn der Emissionsplan vorhersehbar wirkt. Wenn Kapital offline ist, gesperrt, konzentriert oder ständig in Bewegung, kann die sichtbare Beteiligung überschätzen, wie viel Sicherheit DUSK tatsächlich kauft.
Ich würde lieber die Kapitaleffizienz verfolgen: aktives Stake geteilt durch das insgesamt zugesagte DUSK. Dann kombiniere ich das mit Zuflüssen und Abflüssen durch Fluktuation im Verhältnis zum durchschnittlichen aktiven Stake sowie mit der Beibehaltung nach 30, 90 und 365 Tagen.
Der Vergleich ist einfach: Aktivität zeigt, wie viel Kapital ins Staking eingetreten ist; Qualität zeigt, wie viel davon produktiv geblieben ist.
Die Konzentration von Eigentum ist nur die halbe Wahrheit. Die Infrastruktur-HHI könnte hoch bleiben, selbst wenn es viele Wallets gibt, solange dieselben Hosting-Anbieter darunter liegen.
Auch die Börsen-Float im Verhältnis zum aktiven Stake spielt eine Rolle: Wie viel Konsensus-Kapital könnte unter Stress tatsächlich liquid werden?
Was ich jedoch noch nicht sicher weiß, ist die Dauer. Zehn Prozent offline für zehn Minuten sind etwas anderes als zehn Prozent offline für zehn Stunden.
Für die Knappheit von DUSK und die Staking-Qualität müssen nicht immer gemeinsam Verbesserungen eintreten. Diese Spannung wäre das, worauf ich achten würde.
{future}(DUSKUSDT)
#dusk $DUSK @Dusk Beim Prüfen der Belohnungshistorie eines DUSK-Provisioners ist mir etwas aufgefallen, das ich zuvor zu leichtfertig behandelt hatte: Beanspruchtes Stake und nutzbares Consensus-Stake sind nicht dieselbe Zahl.
Diese Lücke ist wichtig, weil sich die Qualität des Stakings auf das wirtschaftliche Ergebnis auswirken kann, selbst wenn der Emissionsplan vorhersehbar wirkt. Wenn Kapital offline ist, gesperrt, konzentriert oder ständig in Bewegung, kann die sichtbare Beteiligung überschätzen, wie viel Sicherheit DUSK tatsächlich kauft.
Ich würde lieber die Kapitaleffizienz verfolgen: aktives Stake geteilt durch das insgesamt zugesagte DUSK. Dann kombiniere ich das mit Zuflüssen und Abflüssen durch Fluktuation im Verhältnis zum durchschnittlichen aktiven Stake sowie mit der Beibehaltung nach 30, 90 und 365 Tagen.
Der Vergleich ist einfach: Aktivität zeigt, wie viel Kapital ins Staking eingetreten ist; Qualität zeigt, wie viel davon produktiv geblieben ist.
Die Konzentration von Eigentum ist nur die halbe Wahrheit. Die Infrastruktur-HHI könnte hoch bleiben, selbst wenn es viele Wallets gibt, solange dieselben Hosting-Anbieter darunter liegen.
Auch die Börsen-Float im Verhältnis zum aktiven Stake spielt eine Rolle: Wie viel Konsensus-Kapital könnte unter Stress tatsächlich liquid werden?
Was ich jedoch noch nicht sicher weiß, ist die Dauer. Zehn Prozent offline für zehn Minuten sind etwas anderes als zehn Prozent offline für zehn Stunden.
Für die Knappheit von DUSK und die Staking-Qualität müssen nicht immer gemeinsam Verbesserungen eintreten. Diese Spannung wäre das, worauf ich achten würde.
Diese Lücke ist wichtig, weil sich die Qualität des Stakings auf das wirtschaftliche Ergebnis auswirken kann, selbst wenn der Emissionsplan vorhersehbar wirkt. Wenn Kapital offline ist, gesperrt, konzentriert oder ständig in Bewegung, kann die sichtbare Beteiligung überschätzen, wie viel Sicherheit DUSK tatsächlich kauft.
Ich würde lieber die Kapitaleffizienz verfolgen: aktives Stake geteilt durch das insgesamt zugesagte DUSK. Dann kombiniere ich das mit Zuflüssen und Abflüssen durch Fluktuation im Verhältnis zum durchschnittlichen aktiven Stake sowie mit der Beibehaltung nach 30, 90 und 365 Tagen.
Der Vergleich ist einfach: Aktivität zeigt, wie viel Kapital ins Staking eingetreten ist; Qualität zeigt, wie viel davon produktiv geblieben ist.
Die Konzentration von Eigentum ist nur die halbe Wahrheit. Die Infrastruktur-HHI könnte hoch bleiben, selbst wenn es viele Wallets gibt, solange dieselben Hosting-Anbieter darunter liegen.
Auch die Börsen-Float im Verhältnis zum aktiven Stake spielt eine Rolle: Wie viel Konsensus-Kapital könnte unter Stress tatsächlich liquid werden?
Was ich jedoch noch nicht sicher weiß, ist die Dauer. Zehn Prozent offline für zehn Minuten sind etwas anderes als zehn Prozent offline für zehn Stunden.
Für die Knappheit von DUSK und die Staking-Qualität müssen nicht immer gemeinsam Verbesserungen eintreten. Diese Spannung wäre das, worauf ich achten würde.
29
23
4k
·
--
#dusk $DUSK @Dusk_Foundation Während ich mir das vertrauliche Sicherheitsmodell von DUSK ansah, blieb ich an einer langweiligen Zahl hängen: Eine 20-jährige Sicherheit könnte ungefähr zehn große Software-Zyklen überstehen, wenn sich der Stack jedes zweite Jahr materiell ändert.
Das ist nicht nur ein Migrationsproblem. Es ist ein Problem der Kontinuität des Eigentums.
Stell dir 50.000 private Positionen vor, die durch eine Aktiensplit-Umstellung gehen. Die einfache Behauptung ist, dass jedes Guthaben aktualisiert wurde. Der schwierigere Standard ist stärker: Das gesamte Eigentum vor der Umstellung muss dem gesamten Eigentum nach der Umstellung entsprechen, wobei jeder Inhaber erhalten bleibt, ohne offenzulegen, wer was besitzt.
Der gleiche Druck zeigt sich bei Dividenden. 20.000 Inhaber, die vierteljährlich zahlen, bedeuten 80.000 Anspruchsereignisse pro Jahr. DUSK kann sich nicht auf öffentliche Sichtbarkeit verlassen, so wie es ein transparenter Ledger kann. Es braucht globale Korrektheit ohne Offenlegung auf Inhaber-Ebene.
Dieser Unterschied ist für DUSK wichtig, weil Datenschutz das Vertrauen von dem Punkt verlagert, dass alle es einsehen können, hin zu dem Punkt, dass alle den Beweis verifizieren können.
Und ich glaube, viele unterschätzen die zweite Ebene: Das Token kann perfekt funktionieren, während die zugrunde liegende Sicherheit oder der MMF dennoch wirtschaftlich scheitert. Eine Onchain-Fehlerrate und eine Asset-Fehlerrate sind nicht dasselbe Risiko.
Meine Kernbeobachtung ist einfach: Nach der fünften Migration – kann DUSK dann weiterhin die Kontinuität so sauber beweisen wie am ersten Tag?
{future}(DUSKUSDT)
#dusk $DUSK @Dusk Während ich mir das vertrauliche Sicherheitsmodell von DUSK ansah, blieb ich an einer langweiligen Zahl hängen: Eine 20-jährige Sicherheit könnte ungefähr zehn große Software-Zyklen überstehen, wenn sich der Stack jedes zweite Jahr materiell ändert.
Das ist nicht nur ein Migrationsproblem. Es ist ein Problem der Kontinuität des Eigentums.
Stell dir 50.000 private Positionen vor, die durch eine Aktiensplit-Umstellung gehen. Die einfache Behauptung ist, dass jedes Guthaben aktualisiert wurde. Der schwierigere Standard ist stärker: Das gesamte Eigentum vor der Umstellung muss dem gesamten Eigentum nach der Umstellung entsprechen, wobei jeder Inhaber erhalten bleibt, ohne offenzulegen, wer was besitzt.
Der gleiche Druck zeigt sich bei Dividenden. 20.000 Inhaber, die vierteljährlich zahlen, bedeuten 80.000 Anspruchsereignisse pro Jahr. DUSK kann sich nicht auf öffentliche Sichtbarkeit verlassen, so wie es ein transparenter Ledger kann. Es braucht globale Korrektheit ohne Offenlegung auf Inhaber-Ebene.
Dieser Unterschied ist für DUSK wichtig, weil Datenschutz das Vertrauen von dem Punkt verlagert, dass alle es einsehen können, hin zu dem Punkt, dass alle den Beweis verifizieren können.
Und ich glaube, viele unterschätzen die zweite Ebene: Das Token kann perfekt funktionieren, während die zugrunde liegende Sicherheit oder der MMF dennoch wirtschaftlich scheitert. Eine Onchain-Fehlerrate und eine Asset-Fehlerrate sind nicht dasselbe Risiko.
Meine Kernbeobachtung ist einfach: Nach der fünften Migration – kann DUSK dann weiterhin die Kontinuität so sauber beweisen wie am ersten Tag?
Das ist nicht nur ein Migrationsproblem. Es ist ein Problem der Kontinuität des Eigentums.
Stell dir 50.000 private Positionen vor, die durch eine Aktiensplit-Umstellung gehen. Die einfache Behauptung ist, dass jedes Guthaben aktualisiert wurde. Der schwierigere Standard ist stärker: Das gesamte Eigentum vor der Umstellung muss dem gesamten Eigentum nach der Umstellung entsprechen, wobei jeder Inhaber erhalten bleibt, ohne offenzulegen, wer was besitzt.
Der gleiche Druck zeigt sich bei Dividenden. 20.000 Inhaber, die vierteljährlich zahlen, bedeuten 80.000 Anspruchsereignisse pro Jahr. DUSK kann sich nicht auf öffentliche Sichtbarkeit verlassen, so wie es ein transparenter Ledger kann. Es braucht globale Korrektheit ohne Offenlegung auf Inhaber-Ebene.
Dieser Unterschied ist für DUSK wichtig, weil Datenschutz das Vertrauen von dem Punkt verlagert, dass alle es einsehen können, hin zu dem Punkt, dass alle den Beweis verifizieren können.
Und ich glaube, viele unterschätzen die zweite Ebene: Das Token kann perfekt funktionieren, während die zugrunde liegende Sicherheit oder der MMF dennoch wirtschaftlich scheitert. Eine Onchain-Fehlerrate und eine Asset-Fehlerrate sind nicht dasselbe Risiko.
Meine Kernbeobachtung ist einfach: Nach der fünften Migration – kann DUSK dann weiterhin die Kontinuität so sauber beweisen wie am ersten Tag?
30
24
4.2k
·
--
#dusk $DUSK @Dusk_Foundation Während ich prüfte, wo DUSK tatsächlich innerhalb einer tokenisierten Wertpapierabwicklungsumgebung sitzt, kam ich immer wieder auf eine unbequeme Trennung: Das Asset kann nativ sein, während der Cash-Leg eventuell noch von einem anderen System abhängt.
Das ist wichtiger, als es auf den ersten Blick aussieht.
Wenn man das Wertpapier auf DUSK setzt, kann das das Eigentum, die Übertragungshistorie und den Compliance-Status bereinigen. Aber wenn die Zahlung weiterhin über eine Bank oder ein Legacy-Ledger abgewickelt wird, muss dennoch jemand zwei Datensätze, zwei Zeitstempel und potenziell zwei Definitionen von „final“ zusammenführen.
Asset-Finalität ist nicht dasselbe wie Abwicklungsfinalität.
Der schwierigere Fall ist die Reihenfolge (Sequencing). Kann Cash unwiderruflich werden, während die endgültige Prüfung der Übertragungsbeschränkungen noch ungeklärt ist? Oder sollte zuerst Compliance-Sicherheit kommen, selbst wenn das die Zahlungs-Seite in der Warteschleife lässt?
Für DUSK löst die native Asset-Ausgabe ein Problem mit nur einem Datensatz. Natives oder tokenisiertes Cash könnte das zweite Problem lösen, indem beide Legs in derselben Abwicklungsumgebung platziert werden und so die zeitliche Lücke zwischen Lieferung und Zahlung verringert wird.
Aber „on-chain“ allein beseitigt nicht jedes Risiko. Atomare Ausführung hängt immer noch von Compliance-Logik, Cash-Qualität und der Gewissheit der Einlösung (Redemption) ab.
Ich beobachte, ob DUSK die Abstimmung (Reconciliation) selbst reduziert oder ob es nur die Asset-Seite nach vorn verlagert, während die Zahlungs-Seite noch alt bleibt.
{future}(DUSKUSDT)
#dusk $DUSK @Dusk Während ich prüfte, wo DUSK tatsächlich innerhalb einer tokenisierten Wertpapierabwicklungsumgebung sitzt, kam ich immer wieder auf eine unbequeme Trennung: Das Asset kann nativ sein, während der Cash-Leg eventuell noch von einem anderen System abhängt.
Das ist wichtiger, als es auf den ersten Blick aussieht.
Wenn man das Wertpapier auf DUSK setzt, kann das das Eigentum, die Übertragungshistorie und den Compliance-Status bereinigen. Aber wenn die Zahlung weiterhin über eine Bank oder ein Legacy-Ledger abgewickelt wird, muss dennoch jemand zwei Datensätze, zwei Zeitstempel und potenziell zwei Definitionen von „final“ zusammenführen.
Asset-Finalität ist nicht dasselbe wie Abwicklungsfinalität.
Der schwierigere Fall ist die Reihenfolge (Sequencing). Kann Cash unwiderruflich werden, während die endgültige Prüfung der Übertragungsbeschränkungen noch ungeklärt ist? Oder sollte zuerst Compliance-Sicherheit kommen, selbst wenn das die Zahlungs-Seite in der Warteschleife lässt?
Für DUSK löst die native Asset-Ausgabe ein Problem mit nur einem Datensatz. Natives oder tokenisiertes Cash könnte das zweite Problem lösen, indem beide Legs in derselben Abwicklungsumgebung platziert werden und so die zeitliche Lücke zwischen Lieferung und Zahlung verringert wird.
Aber „on-chain“ allein beseitigt nicht jedes Risiko. Atomare Ausführung hängt immer noch von Compliance-Logik, Cash-Qualität und der Gewissheit der Einlösung (Redemption) ab.
Ich beobachte, ob DUSK die Abstimmung (Reconciliation) selbst reduziert oder ob es nur die Asset-Seite nach vorn verlagert, während die Zahlungs-Seite noch alt bleibt.
Das ist wichtiger, als es auf den ersten Blick aussieht.
Wenn man das Wertpapier auf DUSK setzt, kann das das Eigentum, die Übertragungshistorie und den Compliance-Status bereinigen. Aber wenn die Zahlung weiterhin über eine Bank oder ein Legacy-Ledger abgewickelt wird, muss dennoch jemand zwei Datensätze, zwei Zeitstempel und potenziell zwei Definitionen von „final“ zusammenführen.
Asset-Finalität ist nicht dasselbe wie Abwicklungsfinalität.
Der schwierigere Fall ist die Reihenfolge (Sequencing). Kann Cash unwiderruflich werden, während die endgültige Prüfung der Übertragungsbeschränkungen noch ungeklärt ist? Oder sollte zuerst Compliance-Sicherheit kommen, selbst wenn das die Zahlungs-Seite in der Warteschleife lässt?
Für DUSK löst die native Asset-Ausgabe ein Problem mit nur einem Datensatz. Natives oder tokenisiertes Cash könnte das zweite Problem lösen, indem beide Legs in derselben Abwicklungsumgebung platziert werden und so die zeitliche Lücke zwischen Lieferung und Zahlung verringert wird.
Aber „on-chain“ allein beseitigt nicht jedes Risiko. Atomare Ausführung hängt immer noch von Compliance-Logik, Cash-Qualität und der Gewissheit der Einlösung (Redemption) ab.
Ich beobachte, ob DUSK die Abstimmung (Reconciliation) selbst reduziert oder ob es nur die Asset-Seite nach vorn verlagert, während die Zahlungs-Seite noch alt bleibt.
81
52
20.1k
·
--
Ich blieb immer wieder an einer kleinen Frage hängen, während ich nachverfolgt habe, wie sich ein tokenisiertes Wertpapier nach den Wallet-Änderungen, also nach dem Token-Wechsel, tatsächlich durch DUSK bewegt: Welche rechtliche Aufzeichnung entscheidet, wem das Asset gehört?
Das klingt simpel, aber Wrapper-Tokenisierung kann sehr viel Infrastruktur darunter verbergen. Man kann einen DUSK-Token haben, während Verwahraufzeichnungen, Aktionärsregister und Abrechnungsbücher noch in drei getrennten Systemen existieren.
Also: Der Token bewegt sich schnell. Der Prozessablauf vielleicht nicht.
Hier glaube ich, verwechseln viele die Übertragung auf der Kette mit der Eigentumsübertragung. Eine Blockchain kann eine Transaktion in ungefähr Sekunden abschließen, während Abgleich, Aktualisierung der Verwahrung, Eignungsprüfungen und Asset-Servicing andernorts noch Stunden, Tage oder sogar Jahre weiterlaufen können.
Für DUSK kann die Integration in die Abrechnung wichtiger sein als das Emissionsvolumen an sich.
Der Vergleich, der mir wichtig ist, ist simpel: Token-Angebot versus Abrechnungsqualität. Zehntausend ausgegebene Tokens sagen mir fast nichts, wenn die Trades danach weiterhin mehrere Abgleiche erfordern. Abrechnungsfehler pro 10.000 Trades würden mir deutlich mehr sagen.
Die schwierigere Frage ist, ob DUSK zur tatsächlichen Quelle der Wahrheit wird oder nur eine weitere synchronisierte Aufzeichnung neben den bisherigen.
Schnelle Finalität ist nützlich. Aber weniger Aufzeichnungen, die übereinstimmen müssen – das wirkt wie der eigentliche Test.
@Dusk_Foundation #dusk $DUSK
Ich blieb immer wieder an einer kleinen Frage hängen, während ich nachverfolgt habe, wie sich ein tokenisiertes Wertpapier nach den Wallet-Änderungen, also nach dem Token-Wechsel, tatsächlich durch DUSK bewegt: Welche rechtliche Aufzeichnung entscheidet, wem das Asset gehört?
Das klingt simpel, aber Wrapper-Tokenisierung kann sehr viel Infrastruktur darunter verbergen. Man kann einen DUSK-Token haben, während Verwahraufzeichnungen, Aktionärsregister und Abrechnungsbücher noch in drei getrennten Systemen existieren.
Also: Der Token bewegt sich schnell. Der Prozessablauf vielleicht nicht.
Hier glaube ich, verwechseln viele die Übertragung auf der Kette mit der Eigentumsübertragung. Eine Blockchain kann eine Transaktion in ungefähr Sekunden abschließen, während Abgleich, Aktualisierung der Verwahrung, Eignungsprüfungen und Asset-Servicing andernorts noch Stunden, Tage oder sogar Jahre weiterlaufen können.
Für DUSK kann die Integration in die Abrechnung wichtiger sein als das Emissionsvolumen an sich.
Der Vergleich, der mir wichtig ist, ist simpel: Token-Angebot versus Abrechnungsqualität. Zehntausend ausgegebene Tokens sagen mir fast nichts, wenn die Trades danach weiterhin mehrere Abgleiche erfordern. Abrechnungsfehler pro 10.000 Trades würden mir deutlich mehr sagen.
Die schwierigere Frage ist, ob DUSK zur tatsächlichen Quelle der Wahrheit wird oder nur eine weitere synchronisierte Aufzeichnung neben den bisherigen.
Schnelle Finalität ist nützlich. Aber weniger Aufzeichnungen, die übereinstimmen müssen – das wirkt wie der eigentliche Test.
@Dusk #dusk $DUSK
Das klingt simpel, aber Wrapper-Tokenisierung kann sehr viel Infrastruktur darunter verbergen. Man kann einen DUSK-Token haben, während Verwahraufzeichnungen, Aktionärsregister und Abrechnungsbücher noch in drei getrennten Systemen existieren.
Also: Der Token bewegt sich schnell. Der Prozessablauf vielleicht nicht.
Hier glaube ich, verwechseln viele die Übertragung auf der Kette mit der Eigentumsübertragung. Eine Blockchain kann eine Transaktion in ungefähr Sekunden abschließen, während Abgleich, Aktualisierung der Verwahrung, Eignungsprüfungen und Asset-Servicing andernorts noch Stunden, Tage oder sogar Jahre weiterlaufen können.
Für DUSK kann die Integration in die Abrechnung wichtiger sein als das Emissionsvolumen an sich.
Der Vergleich, der mir wichtig ist, ist simpel: Token-Angebot versus Abrechnungsqualität. Zehntausend ausgegebene Tokens sagen mir fast nichts, wenn die Trades danach weiterhin mehrere Abgleiche erfordern. Abrechnungsfehler pro 10.000 Trades würden mir deutlich mehr sagen.
Die schwierigere Frage ist, ob DUSK zur tatsächlichen Quelle der Wahrheit wird oder nur eine weitere synchronisierte Aufzeichnung neben den bisherigen.
Schnelle Finalität ist nützlich. Aber weniger Aufzeichnungen, die übereinstimmen müssen – das wirkt wie der eigentliche Test.
@Dusk #dusk $DUSK
34
29
8.3k
·
--
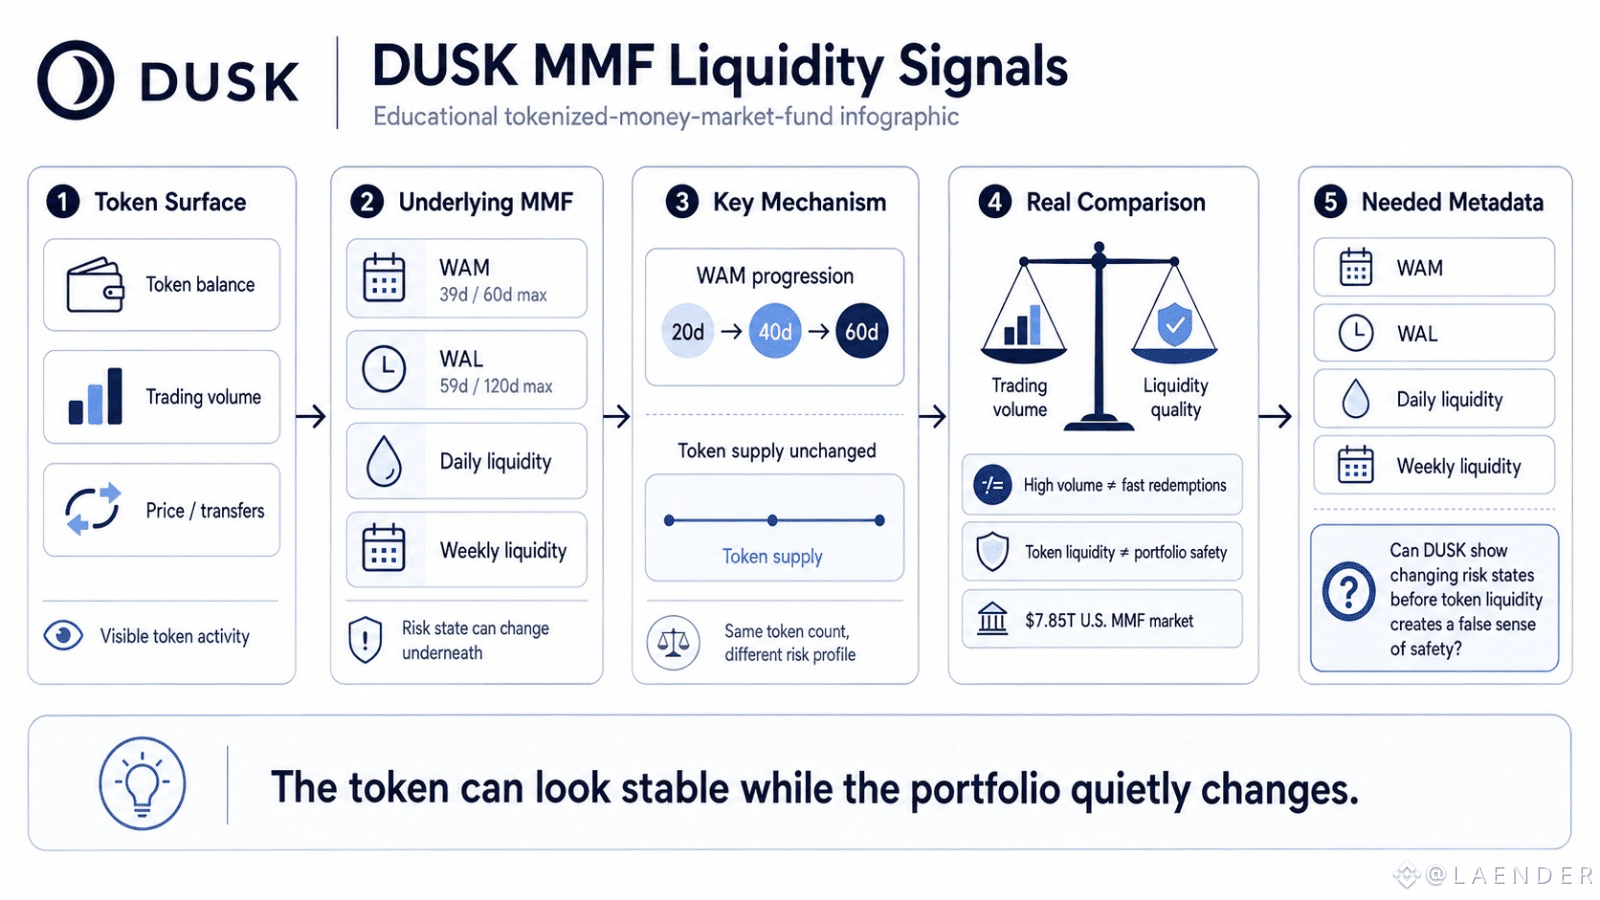
In meiner Überprüfung der MMF-Liquiditätskennzahlen mit Token-Handelsaktivität ist mir etwas aufgefallen, das leicht zu übersehen ist: Der Token-Bestand kann unverändert bleiben, während das Portfolio darunter still und leise risikoreicher wird.
Ein solides MMF kann sich beispielsweise bei einer WAM von etwa 39 Tagen gegenüber einem 60-Tage-Limit einpendeln, während die WAL bei knapp 59 Tagen gegenüber einer Obergrenze von 120 Tagen liegt. Wenn sich die WAM von 20 auf 40 auf 60 Tage bewegt, muss sich die DUSK-Token-Liefermenge überhaupt nicht ändern. Der Risikozustand schon.
Darum halte ich den Vergleich der Liquiditätsqualität gegenüber dem Handelsvolumen hier für aussagekräftiger.
Für DUSK kann ein stark gehandelter MMF-Token dennoch ein Portfolio abbilden, das sich stärker seiner Duration- oder Liquiditätsgrenzen annähert. Ein hohes Sekundärvolumen sagt, dass Nutzer den Token handeln können. Es sagt viel weniger darüber, wie schnell der zugrunde liegende Fonds Rücknahmen bedienen kann.
Das ist wichtig in einem Markt, der ungefähr 7,85 Bio. USD an US-MMF-Vermögenswerten hält. Liquiditätsähnliche Tokenisierung hat ein anderes Druckprofil als eine gewöhnliche Bond-Tokenisierung.
Was ich mir für DUSK wünsche, ist kompakte On-Chain-Risikometadata: WAM, WAL, tägliche Liquidität und wöchentliche Liquidität—ohne dass jede einzelne Portfolio-Position offengelegt wird.
Die unbequeme Frage ist, ob DUSK diese sich verändernden Risikozustände sichtbar machen kann, bevor die Token-Liquidität den Nutzern ein falsches Sicherheitsgefühl vermittelt.
{future}(DUSKUSDT)
@Dusk_Foundation #dusk $DUSK
In meiner Überprüfung der MMF-Liquiditätskennzahlen mit Token-Handelsaktivität ist mir etwas aufgefallen, das leicht zu übersehen ist: Der Token-Bestand kann unverändert bleiben, während das Portfolio darunter still und leise risikoreicher wird.
Ein solides MMF kann sich beispielsweise bei einer WAM von etwa 39 Tagen gegenüber einem 60-Tage-Limit einpendeln, während die WAL bei knapp 59 Tagen gegenüber einer Obergrenze von 120 Tagen liegt. Wenn sich die WAM von 20 auf 40 auf 60 Tage bewegt, muss sich die DUSK-Token-Liefermenge überhaupt nicht ändern. Der Risikozustand schon.
Darum halte ich den Vergleich der Liquiditätsqualität gegenüber dem Handelsvolumen hier für aussagekräftiger.
Für DUSK kann ein stark gehandelter MMF-Token dennoch ein Portfolio abbilden, das sich stärker seiner Duration- oder Liquiditätsgrenzen annähert. Ein hohes Sekundärvolumen sagt, dass Nutzer den Token handeln können. Es sagt viel weniger darüber, wie schnell der zugrunde liegende Fonds Rücknahmen bedienen kann.
Das ist wichtig in einem Markt, der ungefähr 7,85 Bio. USD an US-MMF-Vermögenswerten hält. Liquiditätsähnliche Tokenisierung hat ein anderes Druckprofil als eine gewöhnliche Bond-Tokenisierung.
Was ich mir für DUSK wünsche, ist kompakte On-Chain-Risikometadata: WAM, WAL, tägliche Liquidität und wöchentliche Liquidität—ohne dass jede einzelne Portfolio-Position offengelegt wird.
Die unbequeme Frage ist, ob DUSK diese sich verändernden Risikozustände sichtbar machen kann, bevor die Token-Liquidität den Nutzern ein falsches Sicherheitsgefühl vermittelt.
@Dusk #dusk $DUSK
Ein solides MMF kann sich beispielsweise bei einer WAM von etwa 39 Tagen gegenüber einem 60-Tage-Limit einpendeln, während die WAL bei knapp 59 Tagen gegenüber einer Obergrenze von 120 Tagen liegt. Wenn sich die WAM von 20 auf 40 auf 60 Tage bewegt, muss sich die DUSK-Token-Liefermenge überhaupt nicht ändern. Der Risikozustand schon.
Darum halte ich den Vergleich der Liquiditätsqualität gegenüber dem Handelsvolumen hier für aussagekräftiger.
Für DUSK kann ein stark gehandelter MMF-Token dennoch ein Portfolio abbilden, das sich stärker seiner Duration- oder Liquiditätsgrenzen annähert. Ein hohes Sekundärvolumen sagt, dass Nutzer den Token handeln können. Es sagt viel weniger darüber, wie schnell der zugrunde liegende Fonds Rücknahmen bedienen kann.
Das ist wichtig in einem Markt, der ungefähr 7,85 Bio. USD an US-MMF-Vermögenswerten hält. Liquiditätsähnliche Tokenisierung hat ein anderes Druckprofil als eine gewöhnliche Bond-Tokenisierung.
Was ich mir für DUSK wünsche, ist kompakte On-Chain-Risikometadata: WAM, WAL, tägliche Liquidität und wöchentliche Liquidität—ohne dass jede einzelne Portfolio-Position offengelegt wird.
Die unbequeme Frage ist, ob DUSK diese sich verändernden Risikozustände sichtbar machen kann, bevor die Token-Liquidität den Nutzern ein falsches Sicherheitsgefühl vermittelt.
@Dusk #dusk $DUSK
49
31
14.4k
·
--
Verifiziert
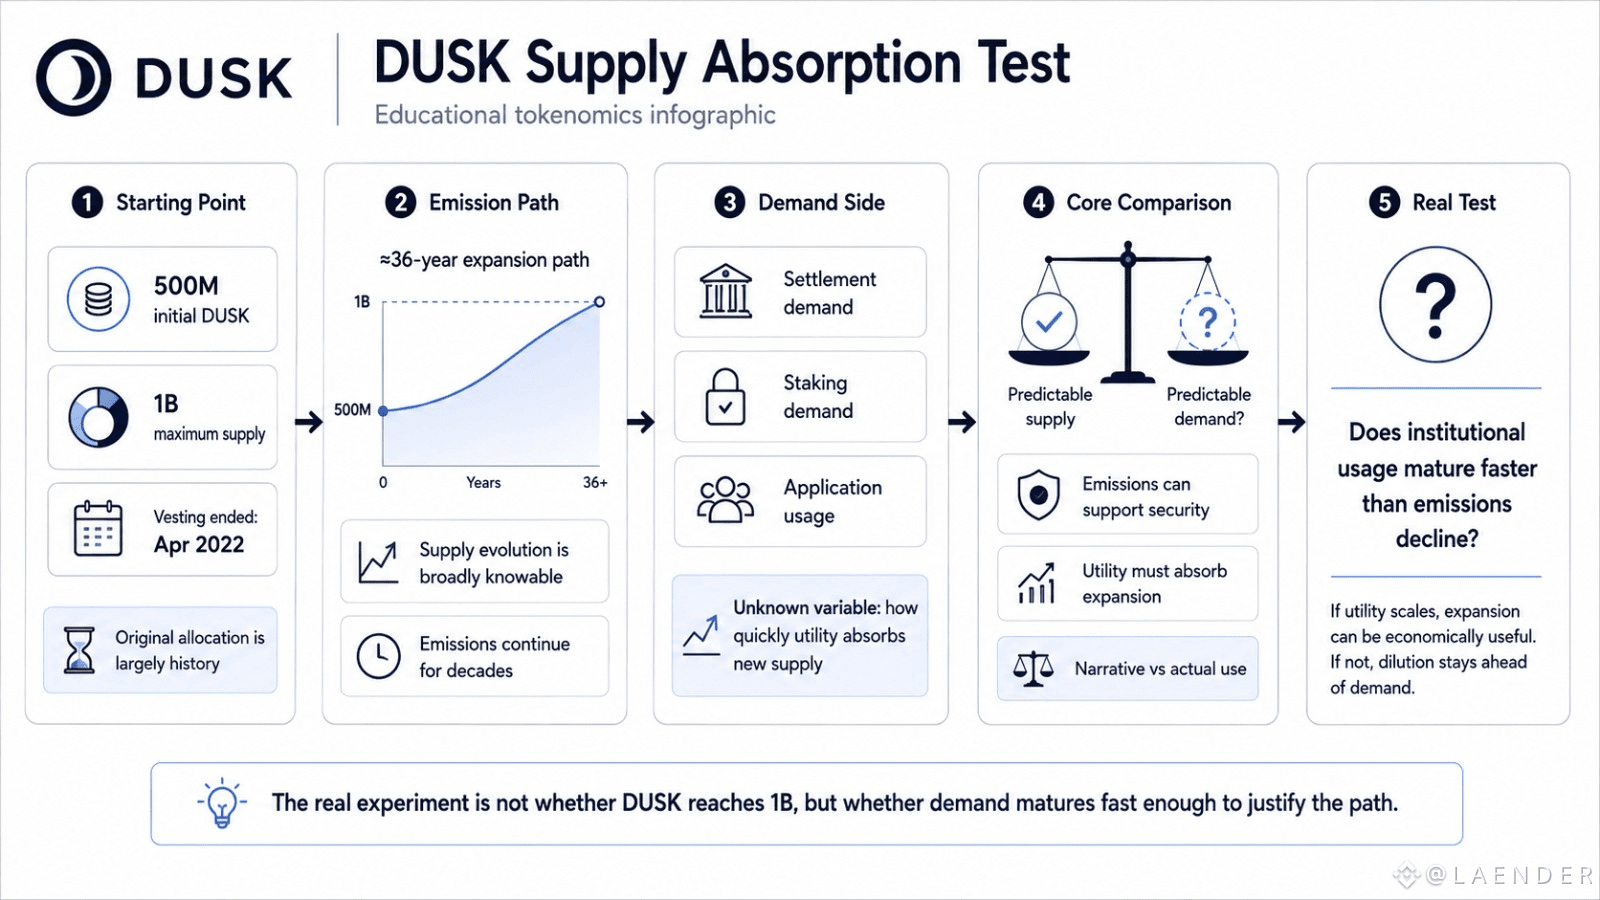
Ich starrte weiter auf DUSKs Angebotskurve und merkte, dass die offensichtliche Zahl – das maximale Angebot von 1 Milliarde – wahrscheinlich der am wenigsten interessante Teil ist.
Der schwierigere Teil ist, wie die zweiten 500 Millionen aufgenommen werden.
Die ursprüngliche Zuteilung liegt weitgehend in der Vergangenheit. Die Sperrfristen endeten 2022. Aber DUSK-Emissionen erweitern das Angebot weiterhin über einen viel längeren Zeitraum und verwandeln die nächsten Jahrzehnte eher in einen Nachfrage-Test als in eine Geschichte über Vesting.
Das verändert, worauf ich achte.
Werden neue Tokens aufgenommen, weil DUSK wirklich an Nutzen gewinnt, oder weil bestehende Inhaber schlicht die Verwässerung akzeptieren? Wächst die institutionelle Aktivität schneller als die Emissionen sinken? Und wenn die Nutzung früh ankommt: skaliert die Token-Nachfrage dann tatsächlich mit?
Ein gewisser Supply-Ausbau ist normal. Netzwerke brauchen Validator-Anreize, Sicherheitsbudgets und Zeit, um zu reifen. Ich würde nicht jeden neuen Token als wirtschaftliche Schwäche betrachten.
Aber vorhersehbares Angebot bedeutet nicht automatisch vorhersehbare Nachfrage.
Das ist der unbequeme Teil. DUSK-Inhaber können grob modellieren, wie sich das Angebot entwickelt. Niemand kann mit derselben Sicherheit modellieren, wie schnell die Nachfrage nach Abwicklung, die Staking-Nachfrage und die Nutzung von Anwendungen wachsen wird.
Für mich ist das das eigentliche 36-Jahres-Experiment: nicht ob DUSK 1 Milliarde Tokens erreicht, sondern ob der Nutzen schnell genug heranreift, um diese Expansion wirtschaftlich nützlich zu machen.
{future}(DUSKUSDT)
@Dusk_Foundation #dusk $DUSK
Ich starrte weiter auf DUSKs Angebotskurve und merkte, dass die offensichtliche Zahl – das maximale Angebot von 1 Milliarde – wahrscheinlich der am wenigsten interessante Teil ist.
Der schwierigere Teil ist, wie die zweiten 500 Millionen aufgenommen werden.
Die ursprüngliche Zuteilung liegt weitgehend in der Vergangenheit. Die Sperrfristen endeten 2022. Aber DUSK-Emissionen erweitern das Angebot weiterhin über einen viel längeren Zeitraum und verwandeln die nächsten Jahrzehnte eher in einen Nachfrage-Test als in eine Geschichte über Vesting.
Das verändert, worauf ich achte.
Werden neue Tokens aufgenommen, weil DUSK wirklich an Nutzen gewinnt, oder weil bestehende Inhaber schlicht die Verwässerung akzeptieren? Wächst die institutionelle Aktivität schneller als die Emissionen sinken? Und wenn die Nutzung früh ankommt: skaliert die Token-Nachfrage dann tatsächlich mit?
Ein gewisser Supply-Ausbau ist normal. Netzwerke brauchen Validator-Anreize, Sicherheitsbudgets und Zeit, um zu reifen. Ich würde nicht jeden neuen Token als wirtschaftliche Schwäche betrachten.
Aber vorhersehbares Angebot bedeutet nicht automatisch vorhersehbare Nachfrage.
Das ist der unbequeme Teil. DUSK-Inhaber können grob modellieren, wie sich das Angebot entwickelt. Niemand kann mit derselben Sicherheit modellieren, wie schnell die Nachfrage nach Abwicklung, die Staking-Nachfrage und die Nutzung von Anwendungen wachsen wird.
Für mich ist das das eigentliche 36-Jahres-Experiment: nicht ob DUSK 1 Milliarde Tokens erreicht, sondern ob der Nutzen schnell genug heranreift, um diese Expansion wirtschaftlich nützlich zu machen.
@Dusk #dusk $DUSK
Der schwierigere Teil ist, wie die zweiten 500 Millionen aufgenommen werden.
Die ursprüngliche Zuteilung liegt weitgehend in der Vergangenheit. Die Sperrfristen endeten 2022. Aber DUSK-Emissionen erweitern das Angebot weiterhin über einen viel längeren Zeitraum und verwandeln die nächsten Jahrzehnte eher in einen Nachfrage-Test als in eine Geschichte über Vesting.
Das verändert, worauf ich achte.
Werden neue Tokens aufgenommen, weil DUSK wirklich an Nutzen gewinnt, oder weil bestehende Inhaber schlicht die Verwässerung akzeptieren? Wächst die institutionelle Aktivität schneller als die Emissionen sinken? Und wenn die Nutzung früh ankommt: skaliert die Token-Nachfrage dann tatsächlich mit?
Ein gewisser Supply-Ausbau ist normal. Netzwerke brauchen Validator-Anreize, Sicherheitsbudgets und Zeit, um zu reifen. Ich würde nicht jeden neuen Token als wirtschaftliche Schwäche betrachten.
Aber vorhersehbares Angebot bedeutet nicht automatisch vorhersehbare Nachfrage.
Das ist der unbequeme Teil. DUSK-Inhaber können grob modellieren, wie sich das Angebot entwickelt. Niemand kann mit derselben Sicherheit modellieren, wie schnell die Nachfrage nach Abwicklung, die Staking-Nachfrage und die Nutzung von Anwendungen wachsen wird.
Für mich ist das das eigentliche 36-Jahres-Experiment: nicht ob DUSK 1 Milliarde Tokens erreicht, sondern ob der Nutzen schnell genug heranreift, um diese Expansion wirtschaftlich nützlich zu machen.
@Dusk #dusk $DUSK
75
34
13k
·
--
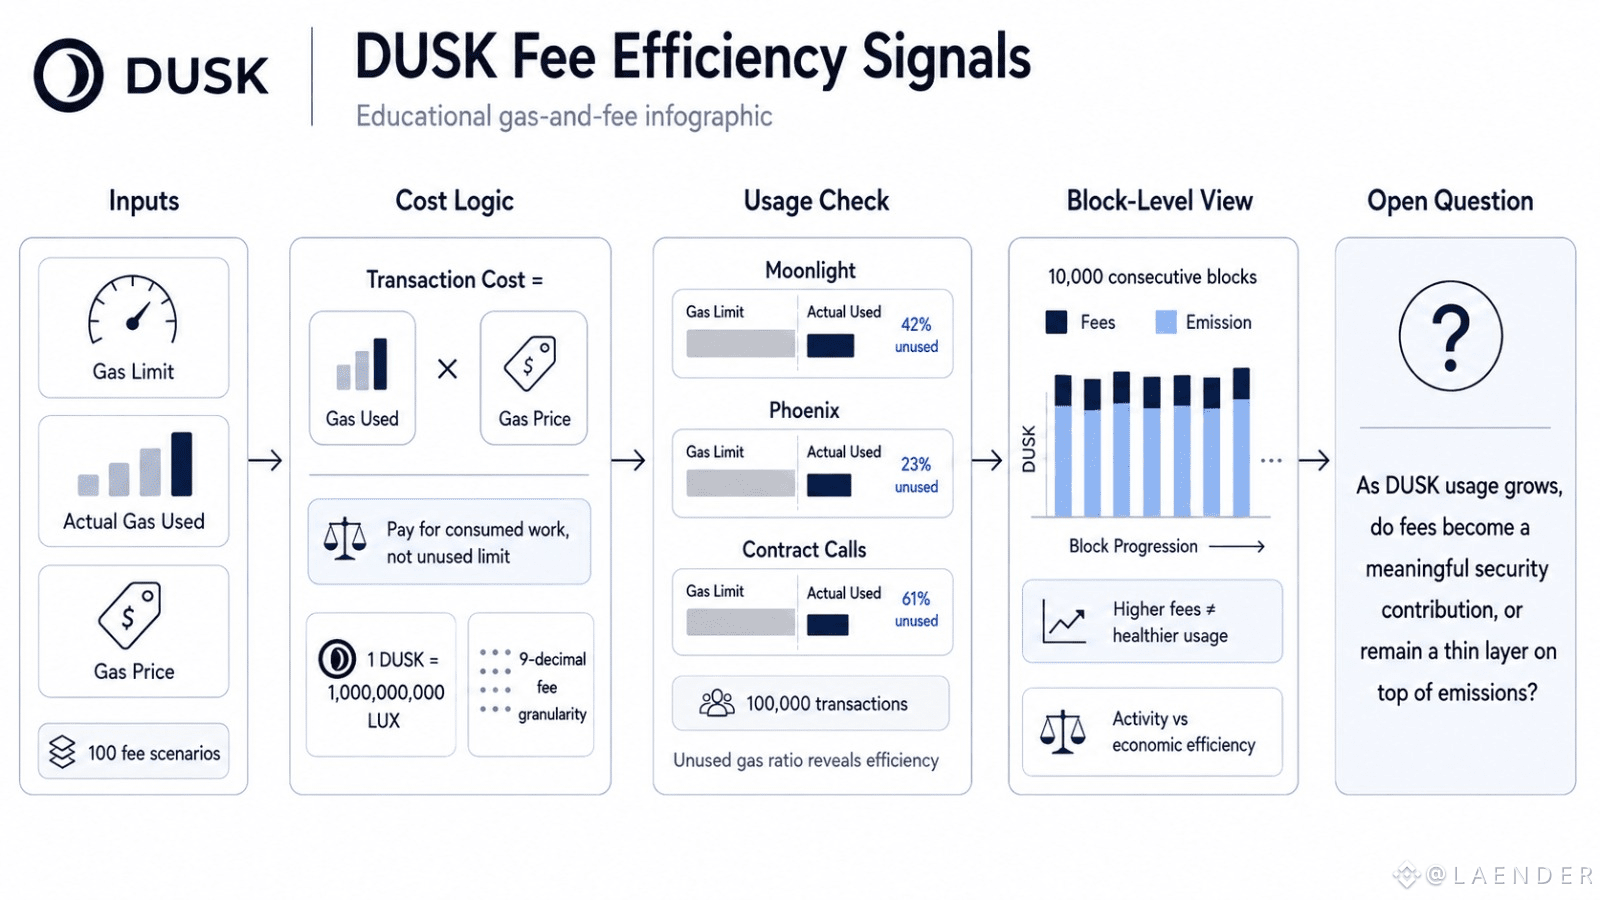
Während ich in die Gebührenrechnung auf DUSK vertieft habe, ist mir aufgefallen, dass mir der Schlagzeilen-Gaspreis fast nichts sagt, außer ich kombiniere ihn mit dem tatsächlich verwendeten Gas.
Das wird über 100 Gebührenszenarien hinweg klarer. Eine Transaktion kann ein großzügiges Gas-Limit mit sich bringen, aber nur für die Arbeit zahlen, die sie wirklich verbraucht. Daher ist die nützliche Kennzahl nicht allein das Limit, sondern das tatsächlich verwendete Gas × der Gaspreis – ergänzt um das Verhältnis des ungenutzten Gases darum herum.
DUSK wird außerdem bei der kleinsten Einheit interessant. Wenn 1 DUSK in 1 Milliarde LUX aufgeteilt wird, können Gebühren mit einer Genauigkeit auf 9 Dezimalstellen bewegt werden. Das klingt nach wenig, aber die Granularität ist entscheidend, wenn Tausende von Transaktionen mit geringen Kosten anfangen, sich zu summieren.
Worauf ich achten würde, ist Moonlight vs.
Phoenix vs. Contract-Aufrufe über 100.000 Transaktionen. Wenn eine Art konstant deutlich mehr Gas reserviert als sie tatsächlich nutzt, ist das ein leises Effizienzsignal.
Menschen könnten Einnahmen aus Gebühren außerdem überinterpretieren. Ein Block, der mehr aus Gebühren verdient, bedeutet nicht automatisch eine bessere Nutzung, wenn die meisten Belohnungen immer noch aus der Emission stammen.
Für DUSK ist der wahre Vergleich Protokollaktivität vs. wirtschaftliche Effizienz.
Meine Skepsis ist einfach: Wenn die Nutzung von DUSK wächst, werden Gebühren dann zu einem bedeutenden Beitrag zur Systemsicherheit, oder bleiben sie nur eine dünne Schicht auf der Emission?
@Dusk_Foundation #dusk $DUSK
{future}(DUSKUSDT)
Während ich in die Gebührenrechnung auf DUSK vertieft habe, ist mir aufgefallen, dass mir der Schlagzeilen-Gaspreis fast nichts sagt, außer ich kombiniere ihn mit dem tatsächlich verwendeten Gas.
Das wird über 100 Gebührenszenarien hinweg klarer. Eine Transaktion kann ein großzügiges Gas-Limit mit sich bringen, aber nur für die Arbeit zahlen, die sie wirklich verbraucht. Daher ist die nützliche Kennzahl nicht allein das Limit, sondern das tatsächlich verwendete Gas × der Gaspreis – ergänzt um das Verhältnis des ungenutzten Gases darum herum.
DUSK wird außerdem bei der kleinsten Einheit interessant. Wenn 1 DUSK in 1 Milliarde LUX aufgeteilt wird, können Gebühren mit einer Genauigkeit auf 9 Dezimalstellen bewegt werden. Das klingt nach wenig, aber die Granularität ist entscheidend, wenn Tausende von Transaktionen mit geringen Kosten anfangen, sich zu summieren.
Worauf ich achten würde, ist Moonlight vs.
Phoenix vs. Contract-Aufrufe über 100.000 Transaktionen. Wenn eine Art konstant deutlich mehr Gas reserviert als sie tatsächlich nutzt, ist das ein leises Effizienzsignal.
Menschen könnten Einnahmen aus Gebühren außerdem überinterpretieren. Ein Block, der mehr aus Gebühren verdient, bedeutet nicht automatisch eine bessere Nutzung, wenn die meisten Belohnungen immer noch aus der Emission stammen.
Für DUSK ist der wahre Vergleich Protokollaktivität vs. wirtschaftliche Effizienz.
Meine Skepsis ist einfach: Wenn die Nutzung von DUSK wächst, werden Gebühren dann zu einem bedeutenden Beitrag zur Systemsicherheit, oder bleiben sie nur eine dünne Schicht auf der Emission?
@Dusk #dusk $DUSK
Das wird über 100 Gebührenszenarien hinweg klarer. Eine Transaktion kann ein großzügiges Gas-Limit mit sich bringen, aber nur für die Arbeit zahlen, die sie wirklich verbraucht. Daher ist die nützliche Kennzahl nicht allein das Limit, sondern das tatsächlich verwendete Gas × der Gaspreis – ergänzt um das Verhältnis des ungenutzten Gases darum herum.
DUSK wird außerdem bei der kleinsten Einheit interessant. Wenn 1 DUSK in 1 Milliarde LUX aufgeteilt wird, können Gebühren mit einer Genauigkeit auf 9 Dezimalstellen bewegt werden. Das klingt nach wenig, aber die Granularität ist entscheidend, wenn Tausende von Transaktionen mit geringen Kosten anfangen, sich zu summieren.
Worauf ich achten würde, ist Moonlight vs.
Phoenix vs. Contract-Aufrufe über 100.000 Transaktionen. Wenn eine Art konstant deutlich mehr Gas reserviert als sie tatsächlich nutzt, ist das ein leises Effizienzsignal.
Menschen könnten Einnahmen aus Gebühren außerdem überinterpretieren. Ein Block, der mehr aus Gebühren verdient, bedeutet nicht automatisch eine bessere Nutzung, wenn die meisten Belohnungen immer noch aus der Emission stammen.
Für DUSK ist der wahre Vergleich Protokollaktivität vs. wirtschaftliche Effizienz.
Meine Skepsis ist einfach: Wenn die Nutzung von DUSK wächst, werden Gebühren dann zu einem bedeutenden Beitrag zur Systemsicherheit, oder bleiben sie nur eine dünne Schicht auf der Emission?
@Dusk #dusk $DUSK
23
26
10.7k
·
--
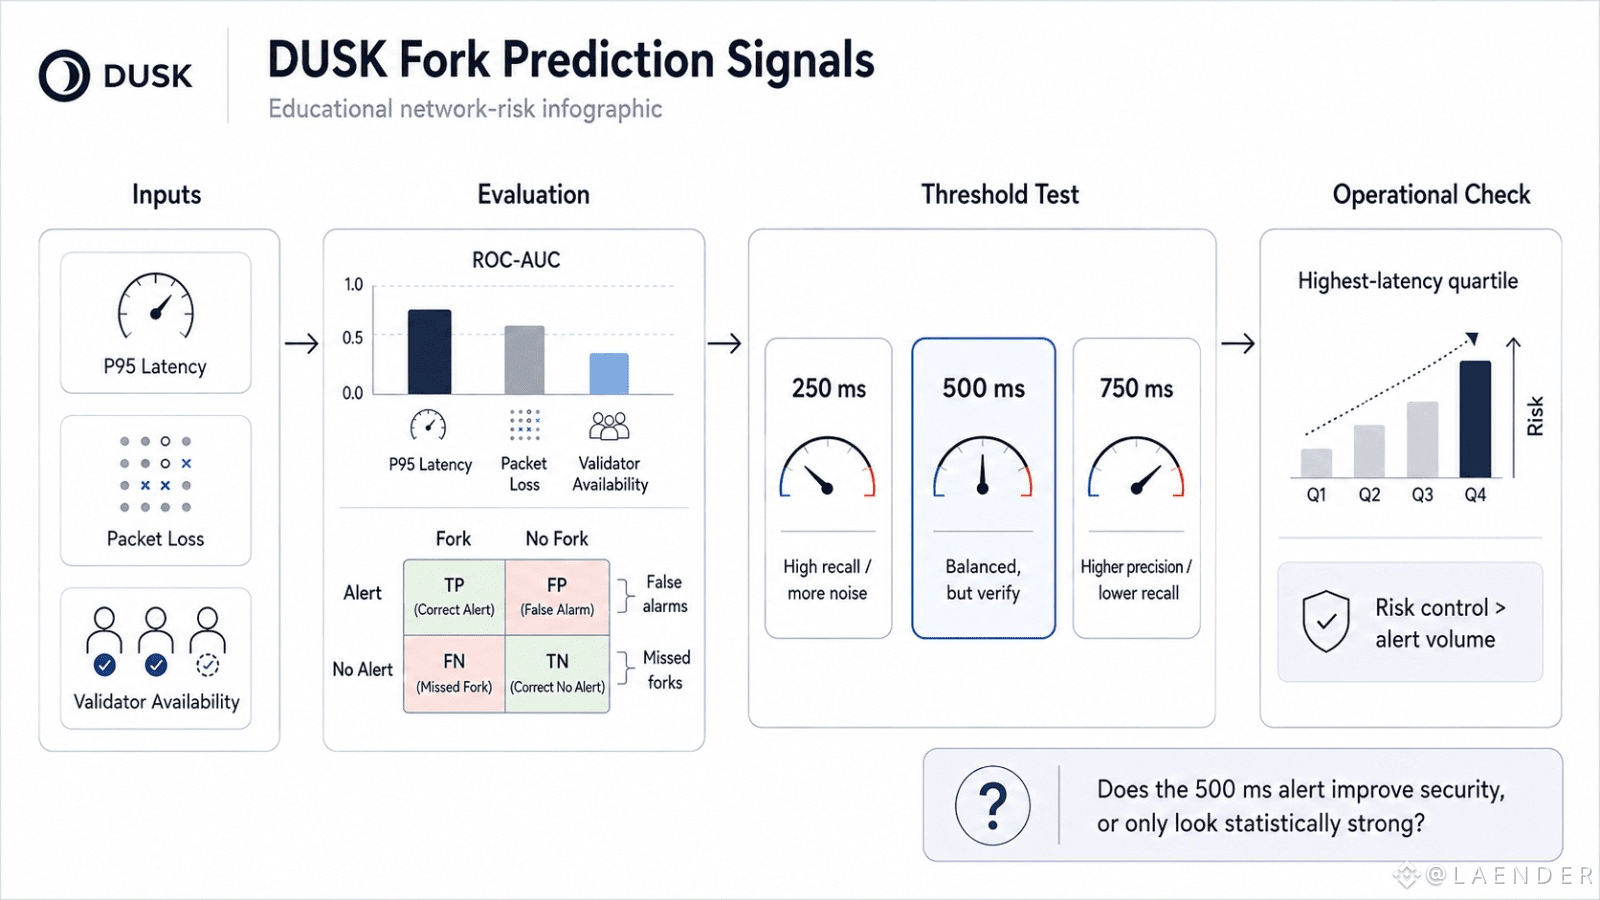
Ich habe etwas beobachtet, als ich DUSK-Fork-Tests beim Sortieren nach P95-Netzwerkverzögerung überprüft habe: Die 500-ms-Alarmmeldung wirkte hilfreich, bis ich mir angesehen habe, was sie tatsächlich abfängt.
Ein Schwellenwert kann präzise klingen und dennoch ein schwacher Prädiktor sein.
Für DUSK Network würde ich Latenz nicht allein bewerten. ROC-AUC über P95-Verzögerung, Paketverlust und die Verfügbarkeit von Validatoren ist entscheidend, weil jedes Signal Fork- und Nicht-Fork-Runden möglicherweise auf unterschiedliche Weise trennt. Dann zeigt die Konfigurationsmatrix, welchen Anteil AUC verdecken kann: falsche Alarme, verpasste Forks und wie oft eine als „High Risk“ eingestufte Runde tatsächlich harmlos war.
Der 250-ms-Schwellenwert kann mehr Fork-Ereignisse erfassen, aber das System mit Rauschen überfluten. Bei 750 ms kann die Präzision zwar steigen, während der Recall einbricht. Die 500-ms-Linie liegt dazwischen, aber „balanciert“ ist nicht automatisch nützlich.
Für DUSK zählt vor allem Risikokontrolle im Verhältnis zum Alarmaufkommen, nicht Latenz im Verhältnis zu keiner Latenz.
Ich würde außerdem den Fork-Risk-Lift in der Quartile der höchsten Latenz beobachten. Wenn diese Gruppe keine aussagekräftige Häufung von Forks zeigt, kann Latenz zwar korreliert sein, operativ aber schwach.
Meine stille Skepsis ist ganz einfach: Verbessert DUSK-Token-Sicherheit tatsächlich, weil der Alarm statistisch gut aussieht, oder nur dann, wenn er die seltenen Ereignisse erwischt, die wirklich zählen?
{future}(DUSKUSDT)
@Dusk_Foundation #dusk $DUSK
Ich habe etwas beobachtet, als ich DUSK-Fork-Tests beim Sortieren nach P95-Netzwerkverzögerung überprüft habe: Die 500-ms-Alarmmeldung wirkte hilfreich, bis ich mir angesehen habe, was sie tatsächlich abfängt.
Ein Schwellenwert kann präzise klingen und dennoch ein schwacher Prädiktor sein.
Für DUSK Network würde ich Latenz nicht allein bewerten. ROC-AUC über P95-Verzögerung, Paketverlust und die Verfügbarkeit von Validatoren ist entscheidend, weil jedes Signal Fork- und Nicht-Fork-Runden möglicherweise auf unterschiedliche Weise trennt. Dann zeigt die Konfigurationsmatrix, welchen Anteil AUC verdecken kann: falsche Alarme, verpasste Forks und wie oft eine als „High Risk“ eingestufte Runde tatsächlich harmlos war.
Der 250-ms-Schwellenwert kann mehr Fork-Ereignisse erfassen, aber das System mit Rauschen überfluten. Bei 750 ms kann die Präzision zwar steigen, während der Recall einbricht. Die 500-ms-Linie liegt dazwischen, aber „balanciert“ ist nicht automatisch nützlich.
Für DUSK zählt vor allem Risikokontrolle im Verhältnis zum Alarmaufkommen, nicht Latenz im Verhältnis zu keiner Latenz.
Ich würde außerdem den Fork-Risk-Lift in der Quartile der höchsten Latenz beobachten. Wenn diese Gruppe keine aussagekräftige Häufung von Forks zeigt, kann Latenz zwar korreliert sein, operativ aber schwach.
Meine stille Skepsis ist ganz einfach: Verbessert DUSK-Token-Sicherheit tatsächlich, weil der Alarm statistisch gut aussieht, oder nur dann, wenn er die seltenen Ereignisse erwischt, die wirklich zählen?
@Dusk #dusk $DUSK
Ein Schwellenwert kann präzise klingen und dennoch ein schwacher Prädiktor sein.
Für DUSK Network würde ich Latenz nicht allein bewerten. ROC-AUC über P95-Verzögerung, Paketverlust und die Verfügbarkeit von Validatoren ist entscheidend, weil jedes Signal Fork- und Nicht-Fork-Runden möglicherweise auf unterschiedliche Weise trennt. Dann zeigt die Konfigurationsmatrix, welchen Anteil AUC verdecken kann: falsche Alarme, verpasste Forks und wie oft eine als „High Risk“ eingestufte Runde tatsächlich harmlos war.
Der 250-ms-Schwellenwert kann mehr Fork-Ereignisse erfassen, aber das System mit Rauschen überfluten. Bei 750 ms kann die Präzision zwar steigen, während der Recall einbricht. Die 500-ms-Linie liegt dazwischen, aber „balanciert“ ist nicht automatisch nützlich.
Für DUSK zählt vor allem Risikokontrolle im Verhältnis zum Alarmaufkommen, nicht Latenz im Verhältnis zu keiner Latenz.
Ich würde außerdem den Fork-Risk-Lift in der Quartile der höchsten Latenz beobachten. Wenn diese Gruppe keine aussagekräftige Häufung von Forks zeigt, kann Latenz zwar korreliert sein, operativ aber schwach.
Meine stille Skepsis ist ganz einfach: Verbessert DUSK-Token-Sicherheit tatsächlich, weil der Alarm statistisch gut aussieht, oder nur dann, wenn er die seltenen Ereignisse erwischt, die wirklich zählen?
@Dusk #dusk $DUSK
26
17
1k
·
--
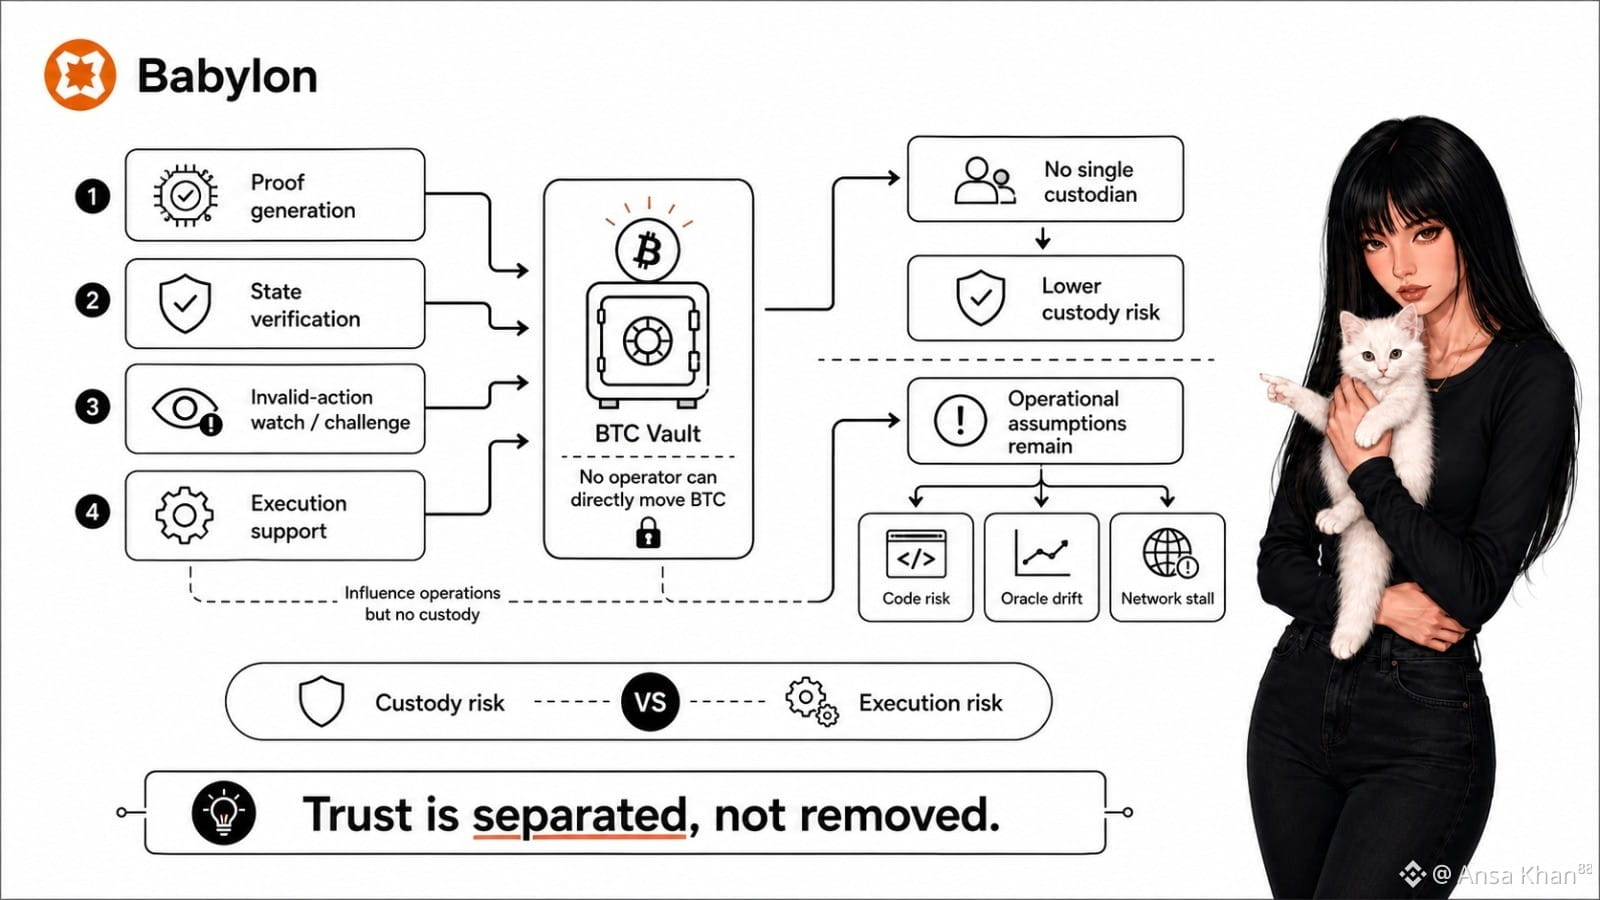
Ich habe Babylons Vertrauensmodell zuerst auf die Frage zur Verwahrung zurückgeführt: Welcher Operator kann den BTC eigentlich bewegen?
Die naheliegende Antwort ist keine der vier Gruppen. Aber das ist nur der oberflächliche Punkt.
Das verborgene Verhalten ist, wie Babylon den Einfluss aufteilt. Eine Gruppe erzeugt Beweise, eine andere verifiziert den Zustand, eine weitere überwacht ungültige Aktionen, und die vierte unterstützt die Ausführung. Keine der Gruppen besitzt das Asset, doch alle vier sind operativ weiterhin entscheidend. Vertrauen ist nicht verschwunden. Es ist eingegrenzt, getrennt und dadurch leichter anzufechten.
Dieser Unterschied ist für BABY wichtig, weil Verwahrungsrisiko und Ausführungsrisiko nicht dasselbe sind. Einen mächtigen Custodian durch vier eingeschränkte Rollen zu ersetzen, reduziert die Wahrscheinlichkeit, dass eine menschliche Freigabe zu einem Verlustereignis wird. Trotzdem kann Code scheitern.
Orakel können abdriften. Netzwerke können ins Stocken geraten.
Ein gewisses Maß an Abhängigkeit ist normal. Ein Live-System braucht Akteure, Infrastruktur und Koordination.
Der eigentliche Test ist die technische Zusage vs. die operative Widerstandsfähigkeit. Kann ein falscher Beweis angefochten werden, bevor er die wirtschaftliche Realität verändert?
Kann Babylon sicher bleiben, wenn eine Betreibergruppe verzögert ist, falsch konfiguriert oder offline? Und wer bemerkt zuerst, wenn sich Annahmen stapeln?
Ich sehe die Stärke des Designs. Ich beobachte weiterhin, ob BABY die Macht der Akteure unter Stress begrenzt – nicht nur auf dem Papier.
{future}(BABYUSDT)
@babylonlabs_io #baby $BABY
Ich habe Babylons Vertrauensmodell zuerst auf die Frage zur Verwahrung zurückgeführt: Welcher Operator kann den BTC eigentlich bewegen?
Die naheliegende Antwort ist keine der vier Gruppen. Aber das ist nur der oberflächliche Punkt.
Das verborgene Verhalten ist, wie Babylon den Einfluss aufteilt. Eine Gruppe erzeugt Beweise, eine andere verifiziert den Zustand, eine weitere überwacht ungültige Aktionen, und die vierte unterstützt die Ausführung. Keine der Gruppen besitzt das Asset, doch alle vier sind operativ weiterhin entscheidend. Vertrauen ist nicht verschwunden. Es ist eingegrenzt, getrennt und dadurch leichter anzufechten.
Dieser Unterschied ist für BABY wichtig, weil Verwahrungsrisiko und Ausführungsrisiko nicht dasselbe sind. Einen mächtigen Custodian durch vier eingeschränkte Rollen zu ersetzen, reduziert die Wahrscheinlichkeit, dass eine menschliche Freigabe zu einem Verlustereignis wird. Trotzdem kann Code scheitern.
Orakel können abdriften. Netzwerke können ins Stocken geraten.
Ein gewisses Maß an Abhängigkeit ist normal. Ein Live-System braucht Akteure, Infrastruktur und Koordination.
Der eigentliche Test ist die technische Zusage vs. die operative Widerstandsfähigkeit. Kann ein falscher Beweis angefochten werden, bevor er die wirtschaftliche Realität verändert?
Kann Babylon sicher bleiben, wenn eine Betreibergruppe verzögert ist, falsch konfiguriert oder offline? Und wer bemerkt zuerst, wenn sich Annahmen stapeln?
Ich sehe die Stärke des Designs. Ich beobachte weiterhin, ob BABY die Macht der Akteure unter Stress begrenzt – nicht nur auf dem Papier.
@BabylonLabs_io #baby $BABY
Die naheliegende Antwort ist keine der vier Gruppen. Aber das ist nur der oberflächliche Punkt.
Das verborgene Verhalten ist, wie Babylon den Einfluss aufteilt. Eine Gruppe erzeugt Beweise, eine andere verifiziert den Zustand, eine weitere überwacht ungültige Aktionen, und die vierte unterstützt die Ausführung. Keine der Gruppen besitzt das Asset, doch alle vier sind operativ weiterhin entscheidend. Vertrauen ist nicht verschwunden. Es ist eingegrenzt, getrennt und dadurch leichter anzufechten.
Dieser Unterschied ist für BABY wichtig, weil Verwahrungsrisiko und Ausführungsrisiko nicht dasselbe sind. Einen mächtigen Custodian durch vier eingeschränkte Rollen zu ersetzen, reduziert die Wahrscheinlichkeit, dass eine menschliche Freigabe zu einem Verlustereignis wird. Trotzdem kann Code scheitern.
Orakel können abdriften. Netzwerke können ins Stocken geraten.
Ein gewisses Maß an Abhängigkeit ist normal. Ein Live-System braucht Akteure, Infrastruktur und Koordination.
Der eigentliche Test ist die technische Zusage vs. die operative Widerstandsfähigkeit. Kann ein falscher Beweis angefochten werden, bevor er die wirtschaftliche Realität verändert?
Kann Babylon sicher bleiben, wenn eine Betreibergruppe verzögert ist, falsch konfiguriert oder offline? Und wer bemerkt zuerst, wenn sich Annahmen stapeln?
Ich sehe die Stärke des Designs. Ich beobachte weiterhin, ob BABY die Macht der Akteure unter Stress begrenzt – nicht nur auf dem Papier.
@BabylonLabs_io #baby $BABY
72
56
8.8k
·
--
Verifiziert
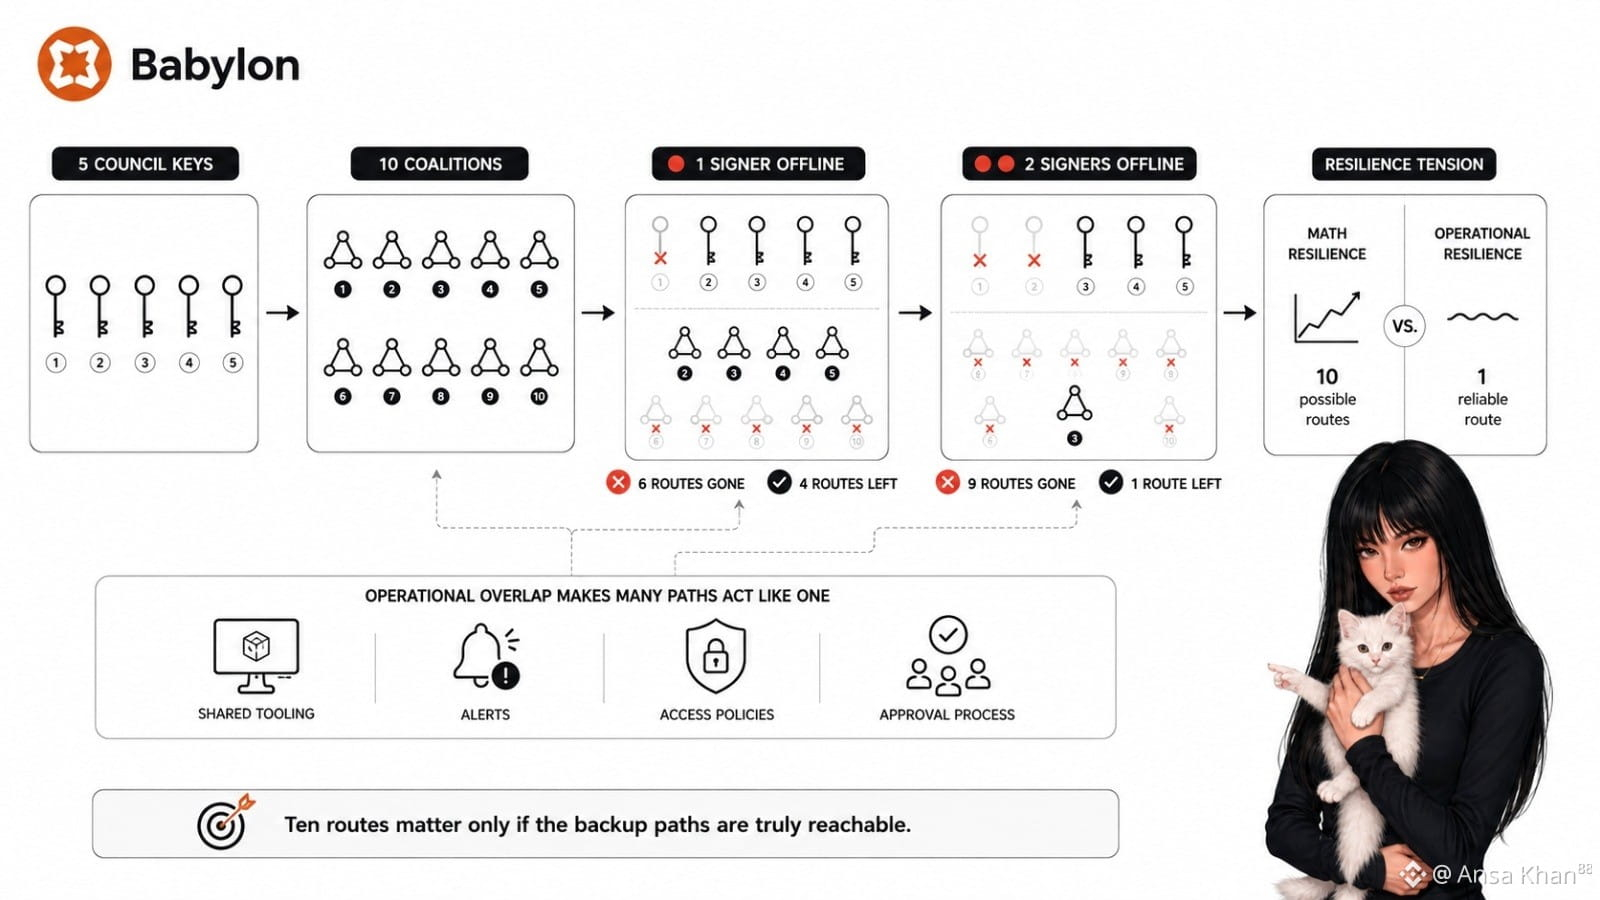
Ich sah Babylons 3-von-5-Rat aus der Schlagzeilen-Zahl: zehn unterzeichnende Koalitionen. Dann entfernte ich einen Schlüssel, und sechs Routen verschwanden.
Der naheliegende Punkt ist, dass Quorum weiterhin funktioniert. Vier Kombinationen bleiben übrig. Das ist jedoch nicht das eigentliche Problem.
Das verborgene Verhalten ist, ob BABY-Operatoren zwischen diesen vier Routen wechseln können, wenn ein Unterzeichner offline ist. Wenn dieselben Personen, Tools, Benachrichtigungen, Zugriffsrichtlinien oder der Genehmigungsprozess hinter jeder Koalition stehen, können zehn mathematische Pfade sich weiterhin wie ein einziger operativer Pfad verhalten.
Ein zweiter Offline-Schlüssel macht das noch deutlicher. Vier verbleibende Koalitionen brechen zu einer einzigen zusammen. Babylon ist technisch gesehen zwar noch am Leben, aber es gibt keine Routenvielfalt mehr. Eine weitere Störung wird unumkehrbar.
Ein gewisses Maß an Konzentration ist normal. Kleine Räte lassen sich leichter koordinieren, und Notfallunterzeichnung darf nicht endlos komplex werden.
Der eigentliche Test ist mathematische Widerstandsfähigkeit vs. operative Widerstandsfähigkeit.
Sind alternative Koalitionen vorab autorisiert, getestet und unter Druck erreichbar? Kann BABY Signierer rotieren, bevor ein Zwischenfall zu einem Governance-Stillstand führt? Oder entdecken Operatoren den Backup-Pfad erst, wenn sie ihn bereits brauchen?
Ich lese einen einzigen Ausfall nicht als Systemversagen. Dennoch sind Babylons zehn Routen nur dann relevant, wenn sie wirklich unabhängig sind, bevor der Notfall beginnt.
{future}(BABYUSDT)
@babylonlabs_io #baby $BABY
Ich sah Babylons 3-von-5-Rat aus der Schlagzeilen-Zahl: zehn unterzeichnende Koalitionen. Dann entfernte ich einen Schlüssel, und sechs Routen verschwanden.
Der naheliegende Punkt ist, dass Quorum weiterhin funktioniert. Vier Kombinationen bleiben übrig. Das ist jedoch nicht das eigentliche Problem.
Das verborgene Verhalten ist, ob BABY-Operatoren zwischen diesen vier Routen wechseln können, wenn ein Unterzeichner offline ist. Wenn dieselben Personen, Tools, Benachrichtigungen, Zugriffsrichtlinien oder der Genehmigungsprozess hinter jeder Koalition stehen, können zehn mathematische Pfade sich weiterhin wie ein einziger operativer Pfad verhalten.
Ein zweiter Offline-Schlüssel macht das noch deutlicher. Vier verbleibende Koalitionen brechen zu einer einzigen zusammen. Babylon ist technisch gesehen zwar noch am Leben, aber es gibt keine Routenvielfalt mehr. Eine weitere Störung wird unumkehrbar.
Ein gewisses Maß an Konzentration ist normal. Kleine Räte lassen sich leichter koordinieren, und Notfallunterzeichnung darf nicht endlos komplex werden.
Der eigentliche Test ist mathematische Widerstandsfähigkeit vs. operative Widerstandsfähigkeit.
Sind alternative Koalitionen vorab autorisiert, getestet und unter Druck erreichbar? Kann BABY Signierer rotieren, bevor ein Zwischenfall zu einem Governance-Stillstand führt? Oder entdecken Operatoren den Backup-Pfad erst, wenn sie ihn bereits brauchen?
Ich lese einen einzigen Ausfall nicht als Systemversagen. Dennoch sind Babylons zehn Routen nur dann relevant, wenn sie wirklich unabhängig sind, bevor der Notfall beginnt.
@BabylonLabs_io #baby $BABY
Der naheliegende Punkt ist, dass Quorum weiterhin funktioniert. Vier Kombinationen bleiben übrig. Das ist jedoch nicht das eigentliche Problem.
Das verborgene Verhalten ist, ob BABY-Operatoren zwischen diesen vier Routen wechseln können, wenn ein Unterzeichner offline ist. Wenn dieselben Personen, Tools, Benachrichtigungen, Zugriffsrichtlinien oder der Genehmigungsprozess hinter jeder Koalition stehen, können zehn mathematische Pfade sich weiterhin wie ein einziger operativer Pfad verhalten.
Ein zweiter Offline-Schlüssel macht das noch deutlicher. Vier verbleibende Koalitionen brechen zu einer einzigen zusammen. Babylon ist technisch gesehen zwar noch am Leben, aber es gibt keine Routenvielfalt mehr. Eine weitere Störung wird unumkehrbar.
Ein gewisses Maß an Konzentration ist normal. Kleine Räte lassen sich leichter koordinieren, und Notfallunterzeichnung darf nicht endlos komplex werden.
Der eigentliche Test ist mathematische Widerstandsfähigkeit vs. operative Widerstandsfähigkeit.
Sind alternative Koalitionen vorab autorisiert, getestet und unter Druck erreichbar? Kann BABY Signierer rotieren, bevor ein Zwischenfall zu einem Governance-Stillstand führt? Oder entdecken Operatoren den Backup-Pfad erst, wenn sie ihn bereits brauchen?
Ich lese einen einzigen Ausfall nicht als Systemversagen. Dennoch sind Babylons zehn Routen nur dann relevant, wenn sie wirklich unabhängig sind, bevor der Notfall beginnt.
@BabylonLabs_io #baby $BABY
26
26
4.3k
·
--
Ich habe Babylons Wiederherstellungsrisiko zuerst bemerkt, als ich ein Backup zeitlich gegen eine nominale 20-Mbit/s-Verbindung abglich.
Der naheliegende Punkt ist, dass 20 Mbit/s zunächst brauchbar klingt. Aber die Schlagzeilenbandbreite ist schwach. Sobald Protokoll-Overhead, Staus, Paketverluste, Verschlüsselung und die Speicherleistung in den Pfad kommen, bleiben nach einer 20-prozentigen Reduktion nur noch etwa 16 Mbit/s als effektive Payload-Durchsatzrate übrig.
Das verändert das Verhalten.
BABY mag auf dem Papier robust wirken, doch Betreiber müssen die Daten trotzdem innerhalb eines festen Zeitfensters wiederherstellen. Testen sie die tatsächliche Wiederherstellungsgeschwindigkeit oder erfassen sie nur den Internet-Tarif? Kann das System eine langsamere Route, eine ausgelastete Leitung oder einen erneuten Versuch nach einem Ausfall verkraften?
Ein gewisser Effizienzverlust ist normal. Kein Netzwerk erreicht dauerhaft seine beworbene Maximalleistung.
Der eigentliche Test ist die technische Zusage im Vergleich zur Erfahrung der Betreiber. Babylon gelingt nur dann, wenn die Wiederherstellungsannahmen mit gemessener Payload-Durchsatzrate arbeiten, nicht mit idealen Serviceraten. Andernfalls kann das Protokoll sein Zeitfenster verfehlen, ohne dass irgendein offensichtlicher Hardwarefehler vorliegt. Die Verbindung funktioniert, nur nicht schnell genug.
Ich lese 20 Mbit/s nicht als unmöglich. Dennoch hängt Babylons Resilienz davon ab, ob BABY für gewöhnliche Netzwerkreibung ausgelegt ist und nicht für ungewöhnlich saubere Bedingungen.
Genau das beobachte ich weiter, weil die Wiederherstellung am Rand scheitert, nicht in der Schlagzeile.
@babylonlabs_io #baby $BABY
Ich habe Babylons Wiederherstellungsrisiko zuerst bemerkt, als ich ein Backup zeitlich gegen eine nominale 20-Mbit/s-Verbindung abglich.
Der naheliegende Punkt ist, dass 20 Mbit/s zunächst brauchbar klingt. Aber die Schlagzeilenbandbreite ist schwach. Sobald Protokoll-Overhead, Staus, Paketverluste, Verschlüsselung und die Speicherleistung in den Pfad kommen, bleiben nach einer 20-prozentigen Reduktion nur noch etwa 16 Mbit/s als effektive Payload-Durchsatzrate übrig.
Das verändert das Verhalten.
BABY mag auf dem Papier robust wirken, doch Betreiber müssen die Daten trotzdem innerhalb eines festen Zeitfensters wiederherstellen. Testen sie die tatsächliche Wiederherstellungsgeschwindigkeit oder erfassen sie nur den Internet-Tarif? Kann das System eine langsamere Route, eine ausgelastete Leitung oder einen erneuten Versuch nach einem Ausfall verkraften?
Ein gewisser Effizienzverlust ist normal. Kein Netzwerk erreicht dauerhaft seine beworbene Maximalleistung.
Der eigentliche Test ist die technische Zusage im Vergleich zur Erfahrung der Betreiber. Babylon gelingt nur dann, wenn die Wiederherstellungsannahmen mit gemessener Payload-Durchsatzrate arbeiten, nicht mit idealen Serviceraten. Andernfalls kann das Protokoll sein Zeitfenster verfehlen, ohne dass irgendein offensichtlicher Hardwarefehler vorliegt. Die Verbindung funktioniert, nur nicht schnell genug.
Ich lese 20 Mbit/s nicht als unmöglich. Dennoch hängt Babylons Resilienz davon ab, ob BABY für gewöhnliche Netzwerkreibung ausgelegt ist und nicht für ungewöhnlich saubere Bedingungen.
Genau das beobachte ich weiter, weil die Wiederherstellung am Rand scheitert, nicht in der Schlagzeile.
@BabylonLabs_io #baby $BABY
Der naheliegende Punkt ist, dass 20 Mbit/s zunächst brauchbar klingt. Aber die Schlagzeilenbandbreite ist schwach. Sobald Protokoll-Overhead, Staus, Paketverluste, Verschlüsselung und die Speicherleistung in den Pfad kommen, bleiben nach einer 20-prozentigen Reduktion nur noch etwa 16 Mbit/s als effektive Payload-Durchsatzrate übrig.
Das verändert das Verhalten.
BABY mag auf dem Papier robust wirken, doch Betreiber müssen die Daten trotzdem innerhalb eines festen Zeitfensters wiederherstellen. Testen sie die tatsächliche Wiederherstellungsgeschwindigkeit oder erfassen sie nur den Internet-Tarif? Kann das System eine langsamere Route, eine ausgelastete Leitung oder einen erneuten Versuch nach einem Ausfall verkraften?
Ein gewisser Effizienzverlust ist normal. Kein Netzwerk erreicht dauerhaft seine beworbene Maximalleistung.
Der eigentliche Test ist die technische Zusage im Vergleich zur Erfahrung der Betreiber. Babylon gelingt nur dann, wenn die Wiederherstellungsannahmen mit gemessener Payload-Durchsatzrate arbeiten, nicht mit idealen Serviceraten. Andernfalls kann das Protokoll sein Zeitfenster verfehlen, ohne dass irgendein offensichtlicher Hardwarefehler vorliegt. Die Verbindung funktioniert, nur nicht schnell genug.
Ich lese 20 Mbit/s nicht als unmöglich. Dennoch hängt Babylons Resilienz davon ab, ob BABY für gewöhnliche Netzwerkreibung ausgelegt ist und nicht für ungewöhnlich saubere Bedingungen.
Genau das beobachte ich weiter, weil die Wiederherstellung am Rand scheitert, nicht in der Schlagzeile.
@BabylonLabs_io #baby $BABY
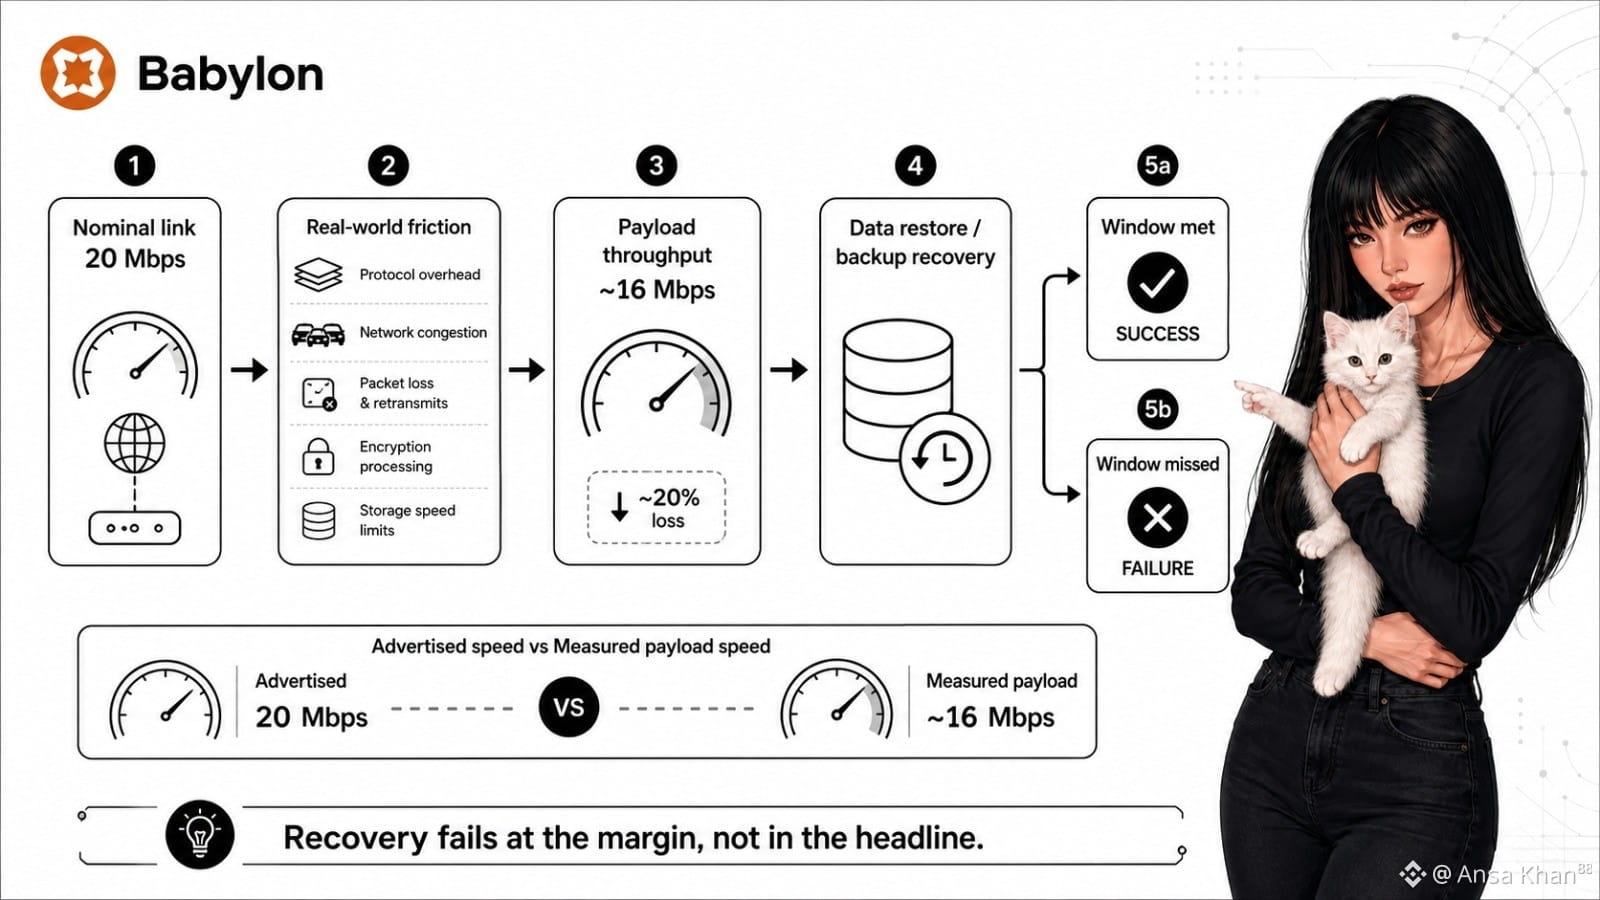
53
40
3.5k
·
--
Ich habe Babylons Liquiditätsproblem bemerkt, nachdem ich den gesperrten Wert neben die tatsächlichen Handelswege des Tokens gelegt habe.
Der offensichtliche Punkt ist, dass der Verlust von mehr als 600 Millionen US-Dollar an gesperrtem Wert alarmierend wirkt. Aber diese Zahl allein ist schwach. Eine Produktexpansion kann fortgesetzt werden, während TVL schrumpft, weil technische Fähigkeiten nicht sofort auf eine Nachfrage treffen.
Das deutlichere Signal ist, wo die Preisfindung für BABY stattfindet.
DEXs wickeln nur etwa 13% des BABY-Volumens ab, während zentrale Handelsplätze die anderen 87% kontrollieren. Selbst ein Anstieg des DEX-Anteils um 200% würde immer noch den Großteil der Aktivität auf zentralen Schienen lassen. Um den aktuellen zentralisierten Cashflow zu matchen, bräuchte man ungefähr 569% mehr DEX-Volumen, unter der Annahme, dass die CEX-Aktivität nicht zurückgeht.
Eine gewisse Schwäche ist hier normal. On-Chain-Liquidität entwickelt sich oft langsamer als Listings, Integrationen und Produktankündigungen.
Aber was ist der echte Test? Kann Babylon die Protokollnutzung in tiefere native Liquidität umwandeln, oder bleibt der Token davon abhängig, dass externe Orderbücher den Markt tragen, während sich das Ökosystem anderswo weiter ausdehnt?
Das ist entscheidend, weil Governance, Nutzen und Nutzerbindung schwerer zu vertrauen sind, wenn der wichtigste Markt des Tokens außerhalb des Systems liegt, das er unterstützen soll.
Ich lese das nicht als Misserfolg durch Kontraktion. Dennoch: Infrastrukturkraft ohne On-Chain-Nachfrage ist eine Lücke, die Babylon bislang noch nicht geschlossen hat.
{future}(BABYUSDT)
@babylonlabs_io $BABY #baby
Ich habe Babylons Liquiditätsproblem bemerkt, nachdem ich den gesperrten Wert neben die tatsächlichen Handelswege des Tokens gelegt habe.
Der offensichtliche Punkt ist, dass der Verlust von mehr als 600 Millionen US-Dollar an gesperrtem Wert alarmierend wirkt. Aber diese Zahl allein ist schwach. Eine Produktexpansion kann fortgesetzt werden, während TVL schrumpft, weil technische Fähigkeiten nicht sofort auf eine Nachfrage treffen.
Das deutlichere Signal ist, wo die Preisfindung für BABY stattfindet.
DEXs wickeln nur etwa 13% des BABY-Volumens ab, während zentrale Handelsplätze die anderen 87% kontrollieren. Selbst ein Anstieg des DEX-Anteils um 200% würde immer noch den Großteil der Aktivität auf zentralen Schienen lassen. Um den aktuellen zentralisierten Cashflow zu matchen, bräuchte man ungefähr 569% mehr DEX-Volumen, unter der Annahme, dass die CEX-Aktivität nicht zurückgeht.
Eine gewisse Schwäche ist hier normal. On-Chain-Liquidität entwickelt sich oft langsamer als Listings, Integrationen und Produktankündigungen.
Aber was ist der echte Test? Kann Babylon die Protokollnutzung in tiefere native Liquidität umwandeln, oder bleibt der Token davon abhängig, dass externe Orderbücher den Markt tragen, während sich das Ökosystem anderswo weiter ausdehnt?
Das ist entscheidend, weil Governance, Nutzen und Nutzerbindung schwerer zu vertrauen sind, wenn der wichtigste Markt des Tokens außerhalb des Systems liegt, das er unterstützen soll.
Ich lese das nicht als Misserfolg durch Kontraktion. Dennoch: Infrastrukturkraft ohne On-Chain-Nachfrage ist eine Lücke, die Babylon bislang noch nicht geschlossen hat.
@BabylonLabs_io $BABY #baby
Der offensichtliche Punkt ist, dass der Verlust von mehr als 600 Millionen US-Dollar an gesperrtem Wert alarmierend wirkt. Aber diese Zahl allein ist schwach. Eine Produktexpansion kann fortgesetzt werden, während TVL schrumpft, weil technische Fähigkeiten nicht sofort auf eine Nachfrage treffen.
Das deutlichere Signal ist, wo die Preisfindung für BABY stattfindet.
DEXs wickeln nur etwa 13% des BABY-Volumens ab, während zentrale Handelsplätze die anderen 87% kontrollieren. Selbst ein Anstieg des DEX-Anteils um 200% würde immer noch den Großteil der Aktivität auf zentralen Schienen lassen. Um den aktuellen zentralisierten Cashflow zu matchen, bräuchte man ungefähr 569% mehr DEX-Volumen, unter der Annahme, dass die CEX-Aktivität nicht zurückgeht.
Eine gewisse Schwäche ist hier normal. On-Chain-Liquidität entwickelt sich oft langsamer als Listings, Integrationen und Produktankündigungen.
Aber was ist der echte Test? Kann Babylon die Protokollnutzung in tiefere native Liquidität umwandeln, oder bleibt der Token davon abhängig, dass externe Orderbücher den Markt tragen, während sich das Ökosystem anderswo weiter ausdehnt?
Das ist entscheidend, weil Governance, Nutzen und Nutzerbindung schwerer zu vertrauen sind, wenn der wichtigste Markt des Tokens außerhalb des Systems liegt, das er unterstützen soll.
Ich lese das nicht als Misserfolg durch Kontraktion. Dennoch: Infrastrukturkraft ohne On-Chain-Nachfrage ist eine Lücke, die Babylon bislang noch nicht geschlossen hat.
@BabylonLabs_io $BABY #baby
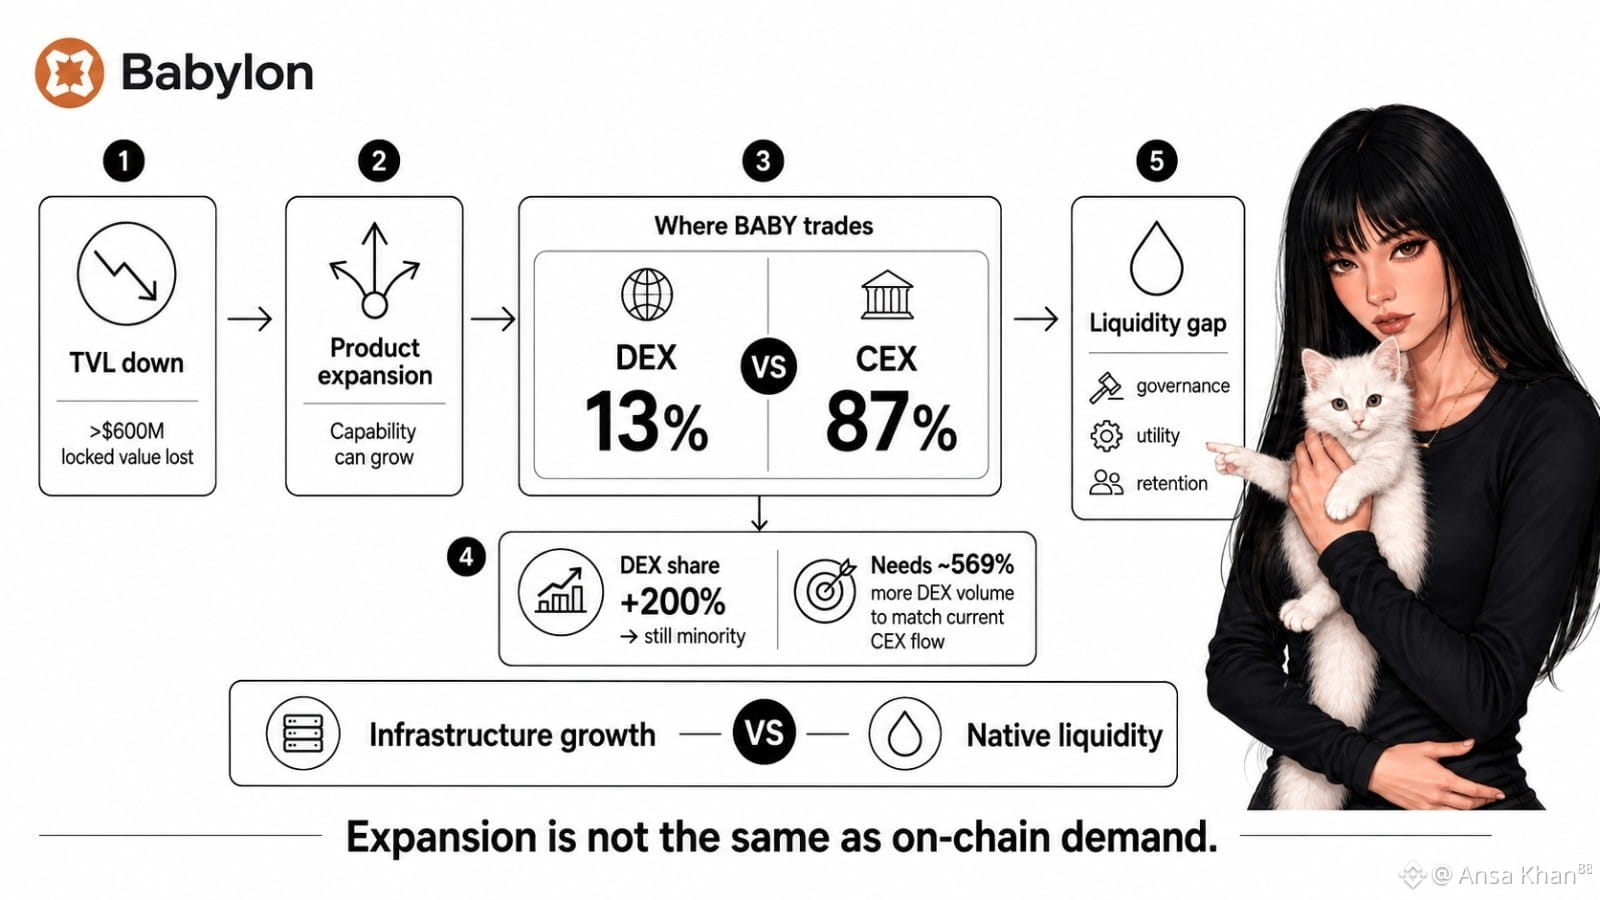
92
43
15.7k
·
--
Ich habe Babylons Zehn-Output-Pre-PegIn-Batch zuerst aus Effizienzgründen bei den Gebühren gesehen. Eine einzelne Transaktion mit zehn Vault-Outputs wirkte sauberer, günstiger und leichter zu skalieren.
Das war die naheliegende Lesart, vermutlich die schwächere.
Das eigentliche Problem zeigt sich nach dem Broadcast. Jeder Output kann seinen eigenen Bitcoin-Ausgabe-Pfad behalten, aber alle zehn hängen noch von einem einzigen Aktivierungsereignis ab, das rechtzeitig abgeschlossen wird. Wenn dieses Peg-in ins Stocken gerät, steht BABY nicht nur einer verzögerten Vault gegenüber. Es kann zehn Nutzer treffen, die hinter demselben Liveness-Ausfall warten.
Eine gemeinsame Abhängigkeit ist normal. Das Batching existiert, weil das Wiederholen der Entry-Overheads zehnmal Blockspeicher verschwendet und die Kosten pro Vault erhöht. Die Effizienz ist real.
Aber der Test ist das Verhalten unter Verzögerung. Kann Babylon die Wiederherstellung pro Output isolieren, oder hält ein problematisches Transaktionslevel die ganze Batch zusammen? Wer reagiert, wenn die Deadline beginnt zu schrumpfen? Macht die größere, an eine Transaktion gebundene absolute Gebühr das erneute Broadcasten noch schmerzhafter?
Das ist Gebühreneffizienz versus Fehlerkonzentration.
BABY gelingt, wenn das Batching die Entry-Kosten senkt, ohne aus einem einzigen Betriebsfehler eine Warteschlange mit zehn Vaults zu machen. Ich beobachte immer noch einen unbequemen Punkt: Getrennte Spend-Pfade garantieren keine getrennte Liveness.
Babylon kann hier Platz sparen. Die schwierigere Frage ist, ob es die Unabhängigkeit bewahrt.
{future}(BABYUSDT)
@babylonlabs_io #baby $BABY
Ich habe Babylons Zehn-Output-Pre-PegIn-Batch zuerst aus Effizienzgründen bei den Gebühren gesehen. Eine einzelne Transaktion mit zehn Vault-Outputs wirkte sauberer, günstiger und leichter zu skalieren.
Das war die naheliegende Lesart, vermutlich die schwächere.
Das eigentliche Problem zeigt sich nach dem Broadcast. Jeder Output kann seinen eigenen Bitcoin-Ausgabe-Pfad behalten, aber alle zehn hängen noch von einem einzigen Aktivierungsereignis ab, das rechtzeitig abgeschlossen wird. Wenn dieses Peg-in ins Stocken gerät, steht BABY nicht nur einer verzögerten Vault gegenüber. Es kann zehn Nutzer treffen, die hinter demselben Liveness-Ausfall warten.
Eine gemeinsame Abhängigkeit ist normal. Das Batching existiert, weil das Wiederholen der Entry-Overheads zehnmal Blockspeicher verschwendet und die Kosten pro Vault erhöht. Die Effizienz ist real.
Aber der Test ist das Verhalten unter Verzögerung. Kann Babylon die Wiederherstellung pro Output isolieren, oder hält ein problematisches Transaktionslevel die ganze Batch zusammen? Wer reagiert, wenn die Deadline beginnt zu schrumpfen? Macht die größere, an eine Transaktion gebundene absolute Gebühr das erneute Broadcasten noch schmerzhafter?
Das ist Gebühreneffizienz versus Fehlerkonzentration.
BABY gelingt, wenn das Batching die Entry-Kosten senkt, ohne aus einem einzigen Betriebsfehler eine Warteschlange mit zehn Vaults zu machen. Ich beobachte immer noch einen unbequemen Punkt: Getrennte Spend-Pfade garantieren keine getrennte Liveness.
Babylon kann hier Platz sparen. Die schwierigere Frage ist, ob es die Unabhängigkeit bewahrt.
@BabylonLabs_io #baby $BABY
Das war die naheliegende Lesart, vermutlich die schwächere.
Das eigentliche Problem zeigt sich nach dem Broadcast. Jeder Output kann seinen eigenen Bitcoin-Ausgabe-Pfad behalten, aber alle zehn hängen noch von einem einzigen Aktivierungsereignis ab, das rechtzeitig abgeschlossen wird. Wenn dieses Peg-in ins Stocken gerät, steht BABY nicht nur einer verzögerten Vault gegenüber. Es kann zehn Nutzer treffen, die hinter demselben Liveness-Ausfall warten.
Eine gemeinsame Abhängigkeit ist normal. Das Batching existiert, weil das Wiederholen der Entry-Overheads zehnmal Blockspeicher verschwendet und die Kosten pro Vault erhöht. Die Effizienz ist real.
Aber der Test ist das Verhalten unter Verzögerung. Kann Babylon die Wiederherstellung pro Output isolieren, oder hält ein problematisches Transaktionslevel die ganze Batch zusammen? Wer reagiert, wenn die Deadline beginnt zu schrumpfen? Macht die größere, an eine Transaktion gebundene absolute Gebühr das erneute Broadcasten noch schmerzhafter?
Das ist Gebühreneffizienz versus Fehlerkonzentration.
BABY gelingt, wenn das Batching die Entry-Kosten senkt, ohne aus einem einzigen Betriebsfehler eine Warteschlange mit zehn Vaults zu machen. Ich beobachte immer noch einen unbequemen Punkt: Getrennte Spend-Pfade garantieren keine getrennte Liveness.
Babylon kann hier Platz sparen. Die schwierigere Frage ist, ob es die Unabhängigkeit bewahrt.
@BabylonLabs_io #baby $BABY
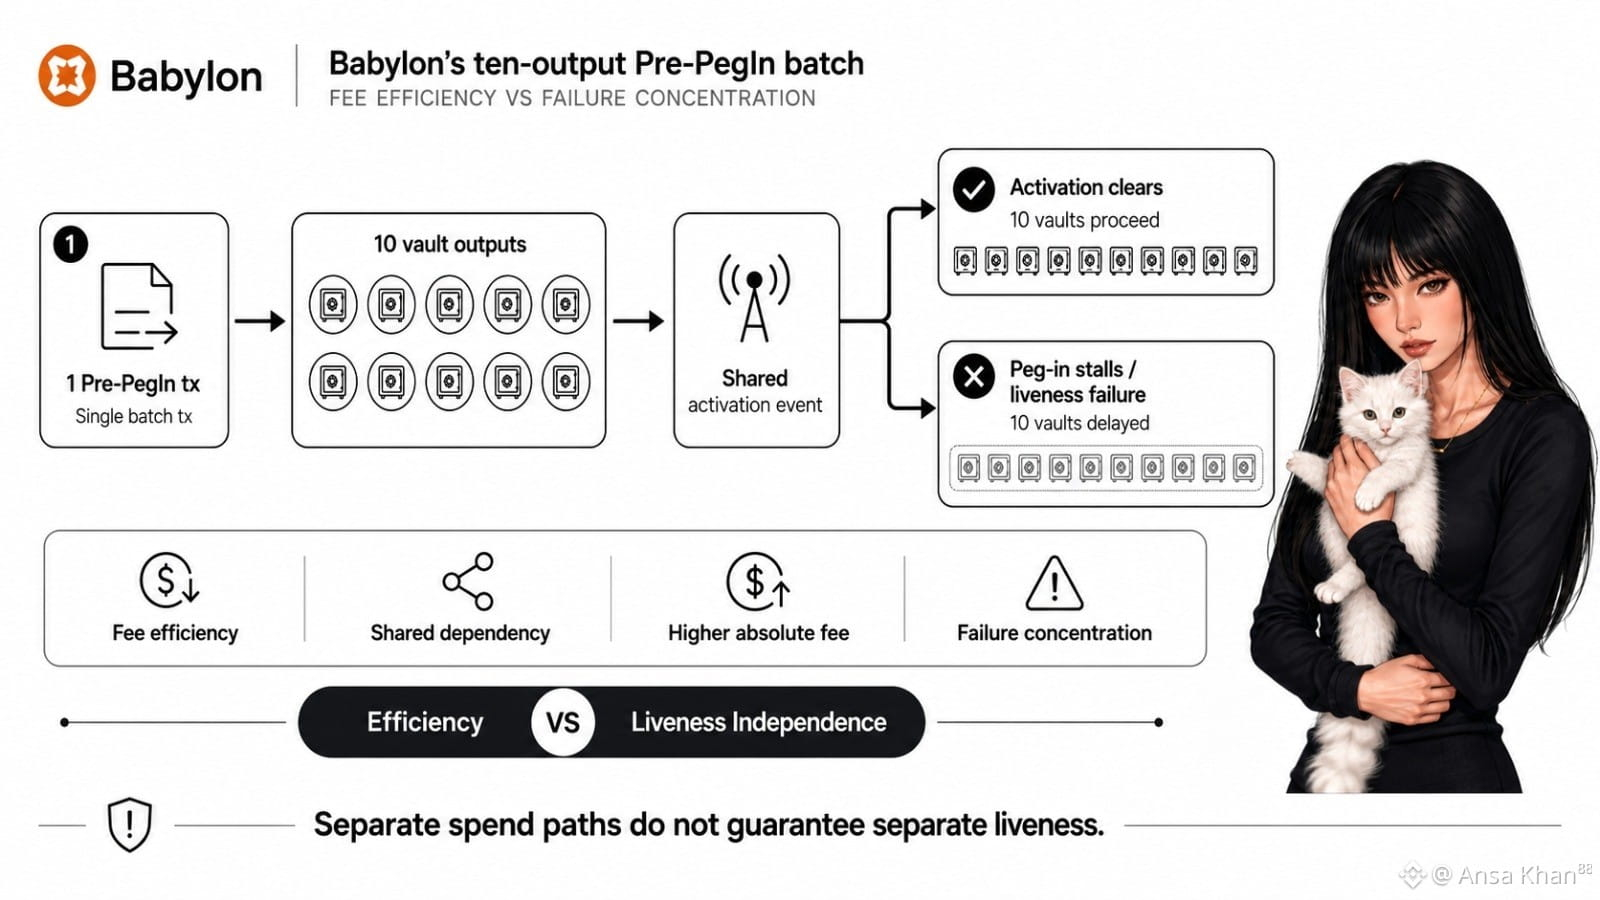
68
54
10.9k
·
--
Teilweise korrekt
Mein erster Eindruck von Babylons Liquidationsdesign abseits der Zero-Basis-Point-Gebühr. Es wirkte darlehensnehmerfreundlich und ungewöhnlich sauber.
Aber das ist die naheliegende Kennzahl, und sie verdeckt die Übertragung.
Ein Darlehensnehmer kann möglicherweise keine Protokollgebühr zahlen, dennoch verlässt weiterhin ein Wert die Position über die Liquidator-Prämie. Nahe der 1,0-Schwelle kann Babylon die vollen 10 % als Anreiz anwenden, statt auf eine tiefere Zahlungsunfähigkeit zu warten. Also ist „Zero Fee“ nicht gleich Nullkosten. Es geht um Gebühren-Sichtbarkeit gegenüber tatsächlichem wirtschaftlichem Verlust.
Dieser Zielkonflikt ist nachvollziehbar. Liquidatoren brauchen genug Anreiz, um schnell zu handeln, wenn die Besicherung dünn ist und der Zeitpunkt zählt. Schwache Anreize können dazu führen, dass sich uneinbringliche Forderungen länger hinziehen. Ein gewisser Aufwand ist normal.
Trotzdem zählt das Verhalten mehr als das Etikett. Schützt BABY die Solvenz, indem es früh handelt, oder verbraucht die 10 %-Prämie zu viel Sicherheiten, bevor der Darlehensnehmer einen sinnvollen Erholungsspielraum hat? Nach Schuldentilgung und Anreizkosten: Wie viel Puffer bleibt tatsächlich übrig?
Die meisten werden darauf achten, ob die Liquidation die Schulden beseitigt. Ich beobachte, was danach übrig bleibt.
Babylon ist erfolgreich, wenn eine frühe Liquidation die Systemstärke bewahrt, ohne dass Darlehensnehmer eine versteckte Strafe absorbieren, die als Null-Protokollgebühr getarnt ist. Meine Skepsis ist einfach: Eine klare Gebührenzeile kann trotzdem ein raues Nutzerergebnis erzeugen.
{future}(BABYUSDT)
@babylonlabs_io #baby $BABY
Mein erster Eindruck von Babylons Liquidationsdesign abseits der Zero-Basis-Point-Gebühr. Es wirkte darlehensnehmerfreundlich und ungewöhnlich sauber.
Aber das ist die naheliegende Kennzahl, und sie verdeckt die Übertragung.
Ein Darlehensnehmer kann möglicherweise keine Protokollgebühr zahlen, dennoch verlässt weiterhin ein Wert die Position über die Liquidator-Prämie. Nahe der 1,0-Schwelle kann Babylon die vollen 10 % als Anreiz anwenden, statt auf eine tiefere Zahlungsunfähigkeit zu warten. Also ist „Zero Fee“ nicht gleich Nullkosten. Es geht um Gebühren-Sichtbarkeit gegenüber tatsächlichem wirtschaftlichem Verlust.
Dieser Zielkonflikt ist nachvollziehbar. Liquidatoren brauchen genug Anreiz, um schnell zu handeln, wenn die Besicherung dünn ist und der Zeitpunkt zählt. Schwache Anreize können dazu führen, dass sich uneinbringliche Forderungen länger hinziehen. Ein gewisser Aufwand ist normal.
Trotzdem zählt das Verhalten mehr als das Etikett. Schützt BABY die Solvenz, indem es früh handelt, oder verbraucht die 10 %-Prämie zu viel Sicherheiten, bevor der Darlehensnehmer einen sinnvollen Erholungsspielraum hat? Nach Schuldentilgung und Anreizkosten: Wie viel Puffer bleibt tatsächlich übrig?
Die meisten werden darauf achten, ob die Liquidation die Schulden beseitigt. Ich beobachte, was danach übrig bleibt.
Babylon ist erfolgreich, wenn eine frühe Liquidation die Systemstärke bewahrt, ohne dass Darlehensnehmer eine versteckte Strafe absorbieren, die als Null-Protokollgebühr getarnt ist. Meine Skepsis ist einfach: Eine klare Gebührenzeile kann trotzdem ein raues Nutzerergebnis erzeugen.
@BabylonLabs_io #baby $BABY
Aber das ist die naheliegende Kennzahl, und sie verdeckt die Übertragung.
Ein Darlehensnehmer kann möglicherweise keine Protokollgebühr zahlen, dennoch verlässt weiterhin ein Wert die Position über die Liquidator-Prämie. Nahe der 1,0-Schwelle kann Babylon die vollen 10 % als Anreiz anwenden, statt auf eine tiefere Zahlungsunfähigkeit zu warten. Also ist „Zero Fee“ nicht gleich Nullkosten. Es geht um Gebühren-Sichtbarkeit gegenüber tatsächlichem wirtschaftlichem Verlust.
Dieser Zielkonflikt ist nachvollziehbar. Liquidatoren brauchen genug Anreiz, um schnell zu handeln, wenn die Besicherung dünn ist und der Zeitpunkt zählt. Schwache Anreize können dazu führen, dass sich uneinbringliche Forderungen länger hinziehen. Ein gewisser Aufwand ist normal.
Trotzdem zählt das Verhalten mehr als das Etikett. Schützt BABY die Solvenz, indem es früh handelt, oder verbraucht die 10 %-Prämie zu viel Sicherheiten, bevor der Darlehensnehmer einen sinnvollen Erholungsspielraum hat? Nach Schuldentilgung und Anreizkosten: Wie viel Puffer bleibt tatsächlich übrig?
Die meisten werden darauf achten, ob die Liquidation die Schulden beseitigt. Ich beobachte, was danach übrig bleibt.
Babylon ist erfolgreich, wenn eine frühe Liquidation die Systemstärke bewahrt, ohne dass Darlehensnehmer eine versteckte Strafe absorbieren, die als Null-Protokollgebühr getarnt ist. Meine Skepsis ist einfach: Eine klare Gebührenzeile kann trotzdem ein raues Nutzerergebnis erzeugen.
@BabylonLabs_io #baby $BABY
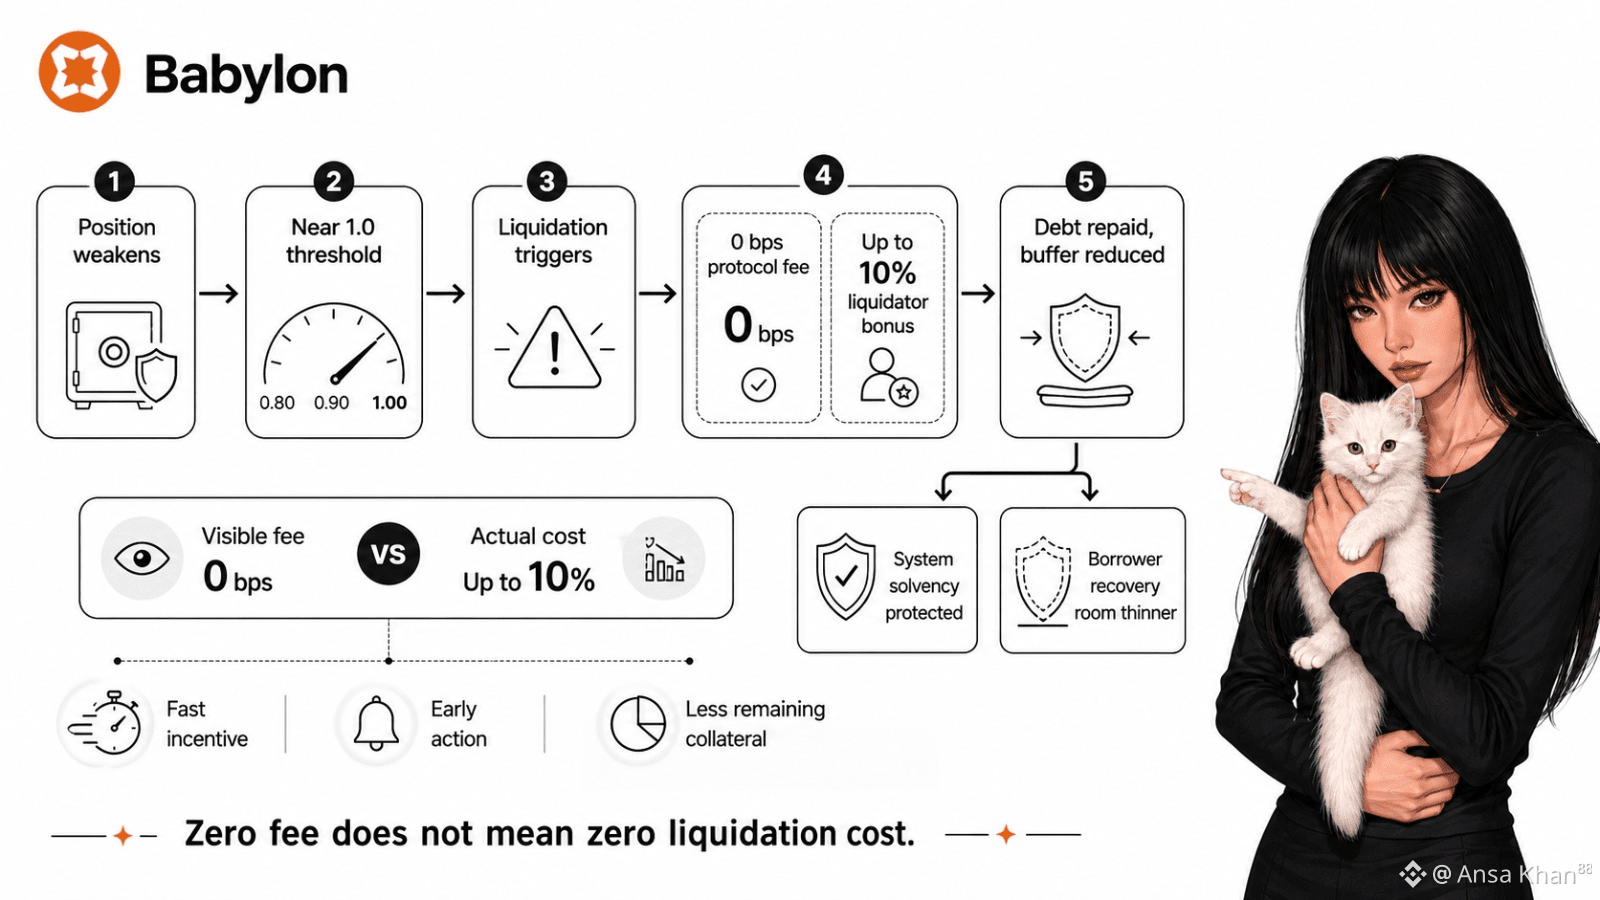
59
41
5.9k
Anmelden und weiter Inhalte entdecken
Krypto-Nutzer weltweit auf Binance Square kennenlernen
⚡️ Bleib in Sachen Krypto stets am Puls.
💬 Die weltgrößte Kryptobörse vertraut darauf.
👍 Erhalte verlässliche Einblicke von verifizierten Creators.
E-Mail-Adresse/Telefonnummer
Trendthemen
HotCPIDecemberHikePriced
5,446 Aufrufe
262 Kommentare
CPI-Marktüberblick | US-Verbraucherpreise steigen im Oktober um 0,4 % und liegen damit über der Prognose von 0,3 %
Binance News
·10 Likes
·14.3k Aufrufe
AnthropicRejectsIPODelayValuationinQuestion
135,306 Aufrufe
1,267 Kommentare
NvidiaInvestigatesAfterHuang’sAffairApology
381,639 Aufrufe
2,743 Kommentare