
ME News
51.8k Beiträge

ME News
 Square Verified+
Melden
Nutzer blockieren
ME Group 是全球领先的金融资讯与科技平台。总部位于香港,纽约设有北美办公室。核心业务涵盖媒体服务(ME News)、品牌会展(ME Event)、视频服务(BTV)、及AI 驱动的媒体、营销与数据服务。致力于为全球用户提供精准的资讯内容、专业的市场服务和AI智能化解决方案。
1 Following
2.5K+ Follower
7.9K+ Like gegeben
Beiträge
Alle
Videos
Live
·
--
Übersetzung ansehen
ME News 消息,9 月 20 日(UTC+8),针对 Paradigm 首席技术官 Georgios Konstantopoulos 声称的“从今往后,隐私将彻底消亡”,Vitalik 回应称,“只有当你放弃时,它才会消亡。我不会放弃隐私。我会加倍捍卫它。”(来源:ME)
ME News 消息,9 月 20 日(UTC+8),针对 Paradigm 首席技术官 Georgios Konstantopoulos 声称的“从今往后,隐私将彻底消亡”,Vitalik 回应称,“只有当你放弃时,它才会消亡。我不会放弃隐私。我会加倍捍卫它。”(来源:ME)
6
·
--
Artikel
Übersetzung ansehen
Fable 5.1超越人类却贵了2.5倍,NeoCognition给Agent进公司算了笔账NeoCognition发布ApprenticeBench评测框架,通过模拟建筑公司应付账款工作场景,检验AI Agent在真实业务环境中的持续学习与软件操作能力。
文章作者:机器之心
文章来源:火星财经
大模型榜单越来越多,但榜单上的几分差距,到了真实工作中究竟意味着什么,并不容易判断。
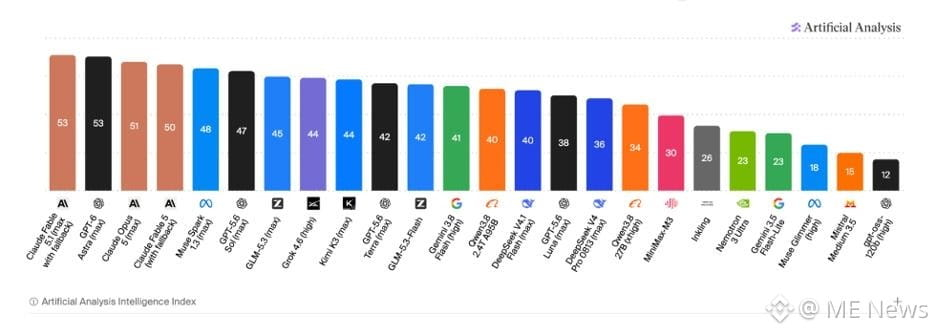
在 Artificial Analysis(AA)、Terminal-Bench 4.0 和 CursorBench 4.0 等评测中,Fable 5.1 和 Opus 5 的成绩只相差几分。可如果让它们进入同一家公司,使用同样的软件、学习同样的业务,再连续处理同一批账单,结果却变成了 72% 对 36%。
完成的任务数,差了一倍。
这个结果来自 NeoCognition 最新发布的 ApprenticeBench。与常见的单项能力测试不同,它把 Agent 放进一家模拟建筑公司,让它像新员工一样入职:阅读员工手册和历史资料,使用真实企业软件,并根据主管反馈逐渐摸清公司的业务规则。
ApprenticeBench
Agent 没有针对这份工作接受专门训练。它需要一边工作,一边从公司的历史数据和带教过程中学习。在这项评测中,Fable 5.1 和 GPT-6 Astra 分别取得 72% 和 68% 的通过率,也超过了本次表现最好的人类测试者的 51%。
Fable 5.1 和 Astra 出现明显的能力跃升,超过本次人类测试者。图源:ApprenticeBench
这也带出了一个更大的问题:如果 Agent 能自己熟悉软件、学会业务,今天需要 FDE(前线部署工程师)为每家客户做的部署和适配,未来能不能交给 Agent 自己完成?
一份看似普通的会计工作,为什么能拉开这么大的差距?对正在训练下一代模型的团队,这些差距又意味着什么?
公司的规矩,进公司才知道
会计学知识可以提前学习,但是一家公司具体怎么做账,最近改了什么政策,任何通用模型都不可能,也不应该知道。一个新员工入职后要补的课,Agent 一样要补。
这便是 ApprenticeBench 的核心设计思路:Agent 进入一家模拟建筑公司,使用和人类员工同样的软件(Odoo)处理应付账款。入职时,它拿到员工手册、软件教程和六个月的历史账单,随后连续处理 100 张新账单。在第一个月里,主管会逐单指导,后来只在月底提供稀疏反馈。
从翻阅历史记录,到逐步独立处理业务,Agent 经历与新员工相似的学习过程。图源:ApprenticeBench 博客
真正做起来才会发现,麻烦都藏在细节里 ——the devil is in the details
建筑公司的应付账款工作中,单位写错、保险过期、前任没交接清楚,都不稀奇。同一张账单,几个问题经常一起出现,还得来回沟通好几轮。然而,现有的 benchmark 把真实工作里的这些麻烦都省略了。同时还有很多规矩,根本不会被明确写下来。相同的支出描述,因为用途不同,就可能归入不同成本码(cost code)。Agent 需要从历史账单中自己琢磨,而不能只靠名称猜答案。
这些麻烦都被放进了 ApprenticeBench。100 个任务经过两位合计拥有超过 30 年相关经验的专业人士独立验证,确认它们确实会在工作中发生,也能根据 benchmark 中提供的信息解决。
拥有 20 年经验的建筑业财务主管 Emilie F. 表示: “这些场景很真实。比如项目经理弄丢了东西却没有意识到,这种事比你想象的常见得多。在参与这个项目之前,我从没想过 AI 能处理这类工作。如果它能应付这些邮件、来回沟通和交叉核对,我相信它会成为会计部门真正的帮手。” 有 10 年建筑与项目管理经验的企业经营者 Austen K. 表示: “这些场景非常符合建筑业财务主管会遇到的情况。目前这些工作都由我自己处理。如果 AI 能接手,我就能腾出时间承接更多项目、拓展业务。对我这样规模的公司,这很容易带来每年六位数美元的价值。如果 AI 能学会这些并拿到高分,我很愿意让它到自己的公司试一试。”
这就是团队所说的 “生态效度”(ecological validity)。它还关系到一种更容易推广的部署方式:企业能否用现有的软件、资料和带教流程,让 Agent 真的像新员工一样学会工作?
真实工作,让模型真正拉开差距
单独测试软件操作,两个模型可能表现接近。但做一份完整的工作,Agent 还得从历史记录里学会公司的惯例,根据主管反馈和政策变化调整做法,并与供应商沟通、补齐信息。这些挑战也会相互影响。软件使用不熟练,可能无法精确检索相关历史记录,公司的规则也就学不明白。主管指出的问题没学会改,后面的账单则会继续出错。把这些挑战放在一起,单项测试中不明显的差距就会累积。Fable 5.1 与 Opus 5 从其他榜单上相差几分,到 ApprenticeBench 的 72% 对 36%,正是值得进一步研究的差距。
AA:Fable 5.1 为 53,Opus 5 为 51。图源:Artificial Analysis 排行榜
Terminal-Bench 4.0:Fable 5.1 为 57.9%,Opus 5 为 51.8%。图源:Terminal-Bench 排行榜
CursorBench 4.0:Fable 5.1 Max 为 51.8%,Opus 5 Max 为 46.6%。图源:CursorBench 排行榜
另外值得一提的是,开源权重模型与闭源模型的差距也很直观。Fable 5.1 和 Kimi K3 在 AA 上是 53 和 44,在这里则是 72% 和 18%。这 100 张账单里,一个有 28 张没通过,另一个是 82 张。如果最后由你接手,这个差距恐怕很难忽略。 这套评测提高了复杂案例的比例,不能直接当作日常业务的错误率。不过,那些需要人接手的地方,恰恰值得模型团队仔细看。
下一版模型,该往哪里使劲?
分数拉开了,接下来让我们看看原因。ApprenticeBench 的几组分析,已经给出了一些具体线索。
用鼠标代替 API,模型要交多少 “CUA 税”?
用图形界面做事,到底会拖累模型多少?为了公平比较,ApprenticeBench 团队专门基于 Odoo 的后台接口,定制了一套与图形界面功能对等的 API 工具,让模型分别通过两种方式完成同一份工作。
团队提出了 “CUA 税” 这一概念来衡量 agent 从 API 切换为 GUI 导致的成功率损失:
CUA 税 =(API 成功率 − GUI 成功率)÷ API 成功率
使用 GUI 带来的相对成功率损失随模型代际快速下降。图源:ApprenticeBench 博客
这笔 “税” 随模型迭代逐渐降低。Fable 5.1 的 GUI/API 成功率为 72%/70%,Astra 为 68%/65%。这一结果说明今天最强模型的 CUA 税可能已经消失。
这意味着,Agent 有望直接使用企业现有软件,减少专门开发接口的需要。不过,GUI 的操作成本仍然更高,效率上还有提升空间。
模型原本就会,还是入职后学会的
做对一道题,不一定说明模型学到了新东西。它可能本来就会,也可能只是找到了可以照抄的答案。
团队设置了一个 “聪明的新手”(smart novice)对照:仅保留公司手册和软件教程,拿掉历史账单、主管反馈和跨任务记忆,看模型只靠已有知识能做多少。Fable 5 在这个设置下只通过了 11 张账单。单独加入历史账单,通过数上升到 31 张。单独加入主管反馈,则升到 35 张。两者同时提供时,达到了 43 张。公司里的经验,确实能帮它把工作做得更好。 但找到旧答案,和学会处理新情况,还有一段距离。成本码实验里,当有先例可参考时,受测模型普遍表现不错。需要从历史账单中归纳规则时,Fable 5.1 和 Astra 才明显领先。
左侧是有先例可参考的成本码,右侧需要归纳隐含规则;虚线为 smart novice 参考表现。图源:ApprenticeBench 博客
有些模型看了历史账单、听了主管反馈,提升仍然有限。有些能从旧账单里找到答案,但需要自己归纳规则时,正确率就明显下降。这些对照让我们看清了分数背后模型能力的差距所在。
经验多了,为什么反而干得更慢
人熟悉工作后,通常会越做越快。这次测试里,Agent 却普遍越做越慢。
人类与 Agent 的处理速度、笔记量随任务推进的变化。图源:ApprenticeBench 博客
笔记就是一个例子。Fable 5.1 写下了约 19.2 万词,分散在 122 个文件里。人类测试者中,笔记较多的一位也只写了约 2,800 词。记得多不代表用得好。笔记越积越多,查阅和维护它们也要花时间。还有个很有意思的例子:账单扫描件太模糊,Agent 居然自己写起了图像处理程序,折腾了近两小时,最后还是找供应商要了份清晰的。本来发条消息就能解决,它却绕了一大圈。
这些问题,光看成功率很难发现。把执行过程和消耗的时间、token 一起看,才能知道模型卡在哪里。下一版模型该学会什么、少做哪些无用功,也就有了具体的改进方向。
做得比人好,还得算算账
Fable 5.1 的通过率达到 72%,超过了人类最高的 51%。但每张账单平均花费 18.23 美元,人类是 7.21 美元,差了约 2.5 倍。这里,模型算的是 token 费用,人工算的是工作时间对应的工资。还有一些成本没算进去。处理同样的 100 张账单,Fable 5.1 发出了 1,032 条消息,两位人类测试者分别是 508 条和 450 条。多出来的来回沟通,也需要同事花时间回应。
不过,成本也不只有处理账单时的开销。让 Agent 进入一家企业,摸清业务、对接软件、配置流程,同样需要人力。这就回到了开头的 FDE 问题:这些部署和适配工作,有多少能交给 Agent 自己完成?
ApprenticeBench 的结果让人看到了这种可能。Agent 已经能直接使用现有软件,也开始能从历史记录和主管反馈中学会公司的做法。如果这些能力足够可靠,换一家客户,就有机会让 Agent 自己学习,而不必事事依赖工程师定制。以后业务规则变了,它也需要能继续学、跟得上。
这条路要走通,Agent 还得做得更省、更稳,也更容易与人配合。但它的价值也很具体:少让人花时间翻查记录、核对表单、反复检查细节,多留些精力理解客户、处理例外、做出判断。
NeoCognition 表示,他们期待,人和 AI 一起工作,最终能比今天单靠人力提高十倍乃至百倍的生产力。这个目标能否实现,要看 AI 做对了多少,也要看部署、指导和复核它需要付出多少。最后,整个团队能多做多少事,才是这笔账的答案。
关于 NeoCognition
硅谷 Agent Lab NeoCognition 由苏煜、邓翔和谷雨联合创立,创始团队在 Agent 领域累计拥有超过 30 年的研究经验。他们相信,未来会有大量各有所长的专业 Agent,让更多人和组织用得上过去难以获得的专业能力。公司已获得 Cambium Capital、Walden Catalyst Ventures、Vista Equity Partners,以及 Lip-Bu Tan、Ion Stoica、Dawn Song 等投资人与学者的支持。
Yu-Xiang Wang 近日宣布已从 UCSD 休假全职加入 NeoCognition。图源:X
最后还有个彩蛋:王宇翔(Yu-Xiang Wang)教授近日宣布,已从 UCSD 休假,全职加入 NeoCognition 担任机器学习总监(Director of Machine Learning)。他从今年 7 月起就已与团队并肩工作,而这次发布的 ApprenticeBench,只是他们正在做的事情的一部分。
Fable 5.1超越人类却贵了2.5倍,NeoCognition给Agent进公司算了笔账
NeoCognition发布ApprenticeBench评测框架,通过模拟建筑公司应付账款工作场景,检验AI Agent在真实业务环境中的持续学习与软件操作能力。
文章作者:机器之心
文章来源:火星财经
大模型榜单越来越多,但榜单上的几分差距,到了真实工作中究竟意味着什么,并不容易判断。
在 Artificial Analysis(AA)、Terminal-Bench 4.0 和 CursorBench 4.0 等评测中,Fable 5.1 和 Opus 5 的成绩只相差几分。可如果让它们进入同一家公司,使用同样的软件、学习同样的业务,再连续处理同一批账单,结果却变成了 72% 对 36%。
完成的任务数,差了一倍。
这个结果来自 NeoCognition 最新发布的 ApprenticeBench。与常见的单项能力测试不同,它把 Agent 放进一家模拟建筑公司,让它像新员工一样入职:阅读员工手册和历史资料,使用真实企业软件,并根据主管反馈逐渐摸清公司的业务规则。
ApprenticeBench
Agent 没有针对这份工作接受专门训练。它需要一边工作,一边从公司的历史数据和带教过程中学习。在这项评测中,Fable 5.1 和 GPT-6 Astra 分别取得 72% 和 68% 的通过率,也超过了本次表现最好的人类测试者的 51%。
Fable 5.1 和 Astra 出现明显的能力跃升,超过本次人类测试者。图源:ApprenticeBench
这也带出了一个更大的问题:如果 Agent 能自己熟悉软件、学会业务,今天需要 FDE(前线部署工程师)为每家客户做的部署和适配,未来能不能交给 Agent 自己完成?
一份看似普通的会计工作,为什么能拉开这么大的差距?对正在训练下一代模型的团队,这些差距又意味着什么?
公司的规矩,进公司才知道
会计学知识可以提前学习,但是一家公司具体怎么做账,最近改了什么政策,任何通用模型都不可能,也不应该知道。一个新员工入职后要补的课,Agent 一样要补。
这便是 ApprenticeBench 的核心设计思路:Agent 进入一家模拟建筑公司,使用和人类员工同样的软件(Odoo)处理应付账款。入职时,它拿到员工手册、软件教程和六个月的历史账单,随后连续处理 100 张新账单。在第一个月里,主管会逐单指导,后来只在月底提供稀疏反馈。
从翻阅历史记录,到逐步独立处理业务,Agent 经历与新员工相似的学习过程。图源:ApprenticeBench 博客
真正做起来才会发现,麻烦都藏在细节里 ——the devil is in the details
建筑公司的应付账款工作中,单位写错、保险过期、前任没交接清楚,都不稀奇。同一张账单,几个问题经常一起出现,还得来回沟通好几轮。然而,现有的 benchmark 把真实工作里的这些麻烦都省略了。同时还有很多规矩,根本不会被明确写下来。相同的支出描述,因为用途不同,就可能归入不同成本码(cost code)。Agent 需要从历史账单中自己琢磨,而不能只靠名称猜答案。
这些麻烦都被放进了 ApprenticeBench。100 个任务经过两位合计拥有超过 30 年相关经验的专业人士独立验证,确认它们确实会在工作中发生,也能根据 benchmark 中提供的信息解决。
拥有 20 年经验的建筑业财务主管 Emilie F. 表示: “这些场景很真实。比如项目经理弄丢了东西却没有意识到,这种事比你想象的常见得多。在参与这个项目之前,我从没想过 AI 能处理这类工作。如果它能应付这些邮件、来回沟通和交叉核对,我相信它会成为会计部门真正的帮手。” 有 10 年建筑与项目管理经验的企业经营者 Austen K. 表示: “这些场景非常符合建筑业财务主管会遇到的情况。目前这些工作都由我自己处理。如果 AI 能接手,我就能腾出时间承接更多项目、拓展业务。对我这样规模的公司,这很容易带来每年六位数美元的价值。如果 AI 能学会这些并拿到高分,我很愿意让它到自己的公司试一试。”
这就是团队所说的 “生态效度”(ecological validity)。它还关系到一种更容易推广的部署方式:企业能否用现有的软件、资料和带教流程,让 Agent 真的像新员工一样学会工作?
真实工作,让模型真正拉开差距
单独测试软件操作,两个模型可能表现接近。但做一份完整的工作,Agent 还得从历史记录里学会公司的惯例,根据主管反馈和政策变化调整做法,并与供应商沟通、补齐信息。这些挑战也会相互影响。软件使用不熟练,可能无法精确检索相关历史记录,公司的规则也就学不明白。主管指出的问题没学会改,后面的账单则会继续出错。把这些挑战放在一起,单项测试中不明显的差距就会累积。Fable 5.1 与 Opus 5 从其他榜单上相差几分,到 ApprenticeBench 的 72% 对 36%,正是值得进一步研究的差距。
AA:Fable 5.1 为 53,Opus 5 为 51。图源:Artificial Analysis 排行榜
Terminal-Bench 4.0:Fable 5.1 为 57.9%,Opus 5 为 51.8%。图源:Terminal-Bench 排行榜
CursorBench 4.0:Fable 5.1 Max 为 51.8%,Opus 5 Max 为 46.6%。图源:CursorBench 排行榜
另外值得一提的是,开源权重模型与闭源模型的差距也很直观。Fable 5.1 和 Kimi K3 在 AA 上是 53 和 44,在这里则是 72% 和 18%。这 100 张账单里,一个有 28 张没通过,另一个是 82 张。如果最后由你接手,这个差距恐怕很难忽略。 这套评测提高了复杂案例的比例,不能直接当作日常业务的错误率。不过,那些需要人接手的地方,恰恰值得模型团队仔细看。
下一版模型,该往哪里使劲?
分数拉开了,接下来让我们看看原因。ApprenticeBench 的几组分析,已经给出了一些具体线索。
用鼠标代替 API,模型要交多少 “CUA 税”?
用图形界面做事,到底会拖累模型多少?为了公平比较,ApprenticeBench 团队专门基于 Odoo 的后台接口,定制了一套与图形界面功能对等的 API 工具,让模型分别通过两种方式完成同一份工作。
团队提出了 “CUA 税” 这一概念来衡量 agent 从 API 切换为 GUI 导致的成功率损失:
CUA 税 =(API 成功率 − GUI 成功率)÷ API 成功率
使用 GUI 带来的相对成功率损失随模型代际快速下降。图源:ApprenticeBench 博客
这笔 “税” 随模型迭代逐渐降低。Fable 5.1 的 GUI/API 成功率为 72%/70%,Astra 为 68%/65%。这一结果说明今天最强模型的 CUA 税可能已经消失。
这意味着,Agent 有望直接使用企业现有软件,减少专门开发接口的需要。不过,GUI 的操作成本仍然更高,效率上还有提升空间。
模型原本就会,还是入职后学会的
做对一道题,不一定说明模型学到了新东西。它可能本来就会,也可能只是找到了可以照抄的答案。
团队设置了一个 “聪明的新手”(smart novice)对照:仅保留公司手册和软件教程,拿掉历史账单、主管反馈和跨任务记忆,看模型只靠已有知识能做多少。Fable 5 在这个设置下只通过了 11 张账单。单独加入历史账单,通过数上升到 31 张。单独加入主管反馈,则升到 35 张。两者同时提供时,达到了 43 张。公司里的经验,确实能帮它把工作做得更好。 但找到旧答案,和学会处理新情况,还有一段距离。成本码实验里,当有先例可参考时,受测模型普遍表现不错。需要从历史账单中归纳规则时,Fable 5.1 和 Astra 才明显领先。
左侧是有先例可参考的成本码,右侧需要归纳隐含规则;虚线为 smart novice 参考表现。图源:ApprenticeBench 博客
有些模型看了历史账单、听了主管反馈,提升仍然有限。有些能从旧账单里找到答案,但需要自己归纳规则时,正确率就明显下降。这些对照让我们看清了分数背后模型能力的差距所在。
经验多了,为什么反而干得更慢
人熟悉工作后,通常会越做越快。这次测试里,Agent 却普遍越做越慢。
人类与 Agent 的处理速度、笔记量随任务推进的变化。图源:ApprenticeBench 博客
笔记就是一个例子。Fable 5.1 写下了约 19.2 万词,分散在 122 个文件里。人类测试者中,笔记较多的一位也只写了约 2,800 词。记得多不代表用得好。笔记越积越多,查阅和维护它们也要花时间。还有个很有意思的例子:账单扫描件太模糊,Agent 居然自己写起了图像处理程序,折腾了近两小时,最后还是找供应商要了份清晰的。本来发条消息就能解决,它却绕了一大圈。
这些问题,光看成功率很难发现。把执行过程和消耗的时间、token 一起看,才能知道模型卡在哪里。下一版模型该学会什么、少做哪些无用功,也就有了具体的改进方向。
做得比人好,还得算算账
Fable 5.1 的通过率达到 72%,超过了人类最高的 51%。但每张账单平均花费 18.23 美元,人类是 7.21 美元,差了约 2.5 倍。这里,模型算的是 token 费用,人工算的是工作时间对应的工资。还有一些成本没算进去。处理同样的 100 张账单,Fable 5.1 发出了 1,032 条消息,两位人类测试者分别是 508 条和 450 条。多出来的来回沟通,也需要同事花时间回应。
不过,成本也不只有处理账单时的开销。让 Agent 进入一家企业,摸清业务、对接软件、配置流程,同样需要人力。这就回到了开头的 FDE 问题:这些部署和适配工作,有多少能交给 Agent 自己完成?
ApprenticeBench 的结果让人看到了这种可能。Agent 已经能直接使用现有软件,也开始能从历史记录和主管反馈中学会公司的做法。如果这些能力足够可靠,换一家客户,就有机会让 Agent 自己学习,而不必事事依赖工程师定制。以后业务规则变了,它也需要能继续学、跟得上。
这条路要走通,Agent 还得做得更省、更稳,也更容易与人配合。但它的价值也很具体:少让人花时间翻查记录、核对表单、反复检查细节,多留些精力理解客户、处理例外、做出判断。
NeoCognition 表示,他们期待,人和 AI 一起工作,最终能比今天单靠人力提高十倍乃至百倍的生产力。这个目标能否实现,要看 AI 做对了多少,也要看部署、指导和复核它需要付出多少。最后,整个团队能多做多少事,才是这笔账的答案。
关于 NeoCognition
硅谷 Agent Lab NeoCognition 由苏煜、邓翔和谷雨联合创立,创始团队在 Agent 领域累计拥有超过 30 年的研究经验。他们相信,未来会有大量各有所长的专业 Agent,让更多人和组织用得上过去难以获得的专业能力。公司已获得 Cambium Capital、Walden Catalyst Ventures、Vista Equity Partners,以及 Lip-Bu Tan、Ion Stoica、Dawn Song 等投资人与学者的支持。
Yu-Xiang Wang 近日宣布已从 UCSD 休假全职加入 NeoCognition。图源:X
最后还有个彩蛋:王宇翔(Yu-Xiang Wang)教授近日宣布,已从 UCSD 休假,全职加入 NeoCognition 担任机器学习总监(Director of Machine Learning)。他从今年 7 月起就已与团队并肩工作,而这次发布的 ApprenticeBench,只是他们正在做的事情的一部分。
文章作者:机器之心
文章来源:火星财经
大模型榜单越来越多,但榜单上的几分差距,到了真实工作中究竟意味着什么,并不容易判断。
在 Artificial Analysis(AA)、Terminal-Bench 4.0 和 CursorBench 4.0 等评测中,Fable 5.1 和 Opus 5 的成绩只相差几分。可如果让它们进入同一家公司,使用同样的软件、学习同样的业务,再连续处理同一批账单,结果却变成了 72% 对 36%。
完成的任务数,差了一倍。
这个结果来自 NeoCognition 最新发布的 ApprenticeBench。与常见的单项能力测试不同,它把 Agent 放进一家模拟建筑公司,让它像新员工一样入职:阅读员工手册和历史资料,使用真实企业软件,并根据主管反馈逐渐摸清公司的业务规则。
ApprenticeBench
Agent 没有针对这份工作接受专门训练。它需要一边工作,一边从公司的历史数据和带教过程中学习。在这项评测中,Fable 5.1 和 GPT-6 Astra 分别取得 72% 和 68% 的通过率,也超过了本次表现最好的人类测试者的 51%。
Fable 5.1 和 Astra 出现明显的能力跃升,超过本次人类测试者。图源:ApprenticeBench
这也带出了一个更大的问题:如果 Agent 能自己熟悉软件、学会业务,今天需要 FDE(前线部署工程师)为每家客户做的部署和适配,未来能不能交给 Agent 自己完成?
一份看似普通的会计工作,为什么能拉开这么大的差距?对正在训练下一代模型的团队,这些差距又意味着什么?
公司的规矩,进公司才知道
会计学知识可以提前学习,但是一家公司具体怎么做账,最近改了什么政策,任何通用模型都不可能,也不应该知道。一个新员工入职后要补的课,Agent 一样要补。
这便是 ApprenticeBench 的核心设计思路:Agent 进入一家模拟建筑公司,使用和人类员工同样的软件(Odoo)处理应付账款。入职时,它拿到员工手册、软件教程和六个月的历史账单,随后连续处理 100 张新账单。在第一个月里,主管会逐单指导,后来只在月底提供稀疏反馈。
从翻阅历史记录,到逐步独立处理业务,Agent 经历与新员工相似的学习过程。图源:ApprenticeBench 博客
真正做起来才会发现,麻烦都藏在细节里 ——the devil is in the details
建筑公司的应付账款工作中,单位写错、保险过期、前任没交接清楚,都不稀奇。同一张账单,几个问题经常一起出现,还得来回沟通好几轮。然而,现有的 benchmark 把真实工作里的这些麻烦都省略了。同时还有很多规矩,根本不会被明确写下来。相同的支出描述,因为用途不同,就可能归入不同成本码(cost code)。Agent 需要从历史账单中自己琢磨,而不能只靠名称猜答案。
这些麻烦都被放进了 ApprenticeBench。100 个任务经过两位合计拥有超过 30 年相关经验的专业人士独立验证,确认它们确实会在工作中发生,也能根据 benchmark 中提供的信息解决。
拥有 20 年经验的建筑业财务主管 Emilie F. 表示: “这些场景很真实。比如项目经理弄丢了东西却没有意识到,这种事比你想象的常见得多。在参与这个项目之前,我从没想过 AI 能处理这类工作。如果它能应付这些邮件、来回沟通和交叉核对,我相信它会成为会计部门真正的帮手。” 有 10 年建筑与项目管理经验的企业经营者 Austen K. 表示: “这些场景非常符合建筑业财务主管会遇到的情况。目前这些工作都由我自己处理。如果 AI 能接手,我就能腾出时间承接更多项目、拓展业务。对我这样规模的公司,这很容易带来每年六位数美元的价值。如果 AI 能学会这些并拿到高分,我很愿意让它到自己的公司试一试。”
这就是团队所说的 “生态效度”(ecological validity)。它还关系到一种更容易推广的部署方式:企业能否用现有的软件、资料和带教流程,让 Agent 真的像新员工一样学会工作?
真实工作,让模型真正拉开差距
单独测试软件操作,两个模型可能表现接近。但做一份完整的工作,Agent 还得从历史记录里学会公司的惯例,根据主管反馈和政策变化调整做法,并与供应商沟通、补齐信息。这些挑战也会相互影响。软件使用不熟练,可能无法精确检索相关历史记录,公司的规则也就学不明白。主管指出的问题没学会改,后面的账单则会继续出错。把这些挑战放在一起,单项测试中不明显的差距就会累积。Fable 5.1 与 Opus 5 从其他榜单上相差几分,到 ApprenticeBench 的 72% 对 36%,正是值得进一步研究的差距。
AA:Fable 5.1 为 53,Opus 5 为 51。图源:Artificial Analysis 排行榜
Terminal-Bench 4.0:Fable 5.1 为 57.9%,Opus 5 为 51.8%。图源:Terminal-Bench 排行榜
CursorBench 4.0:Fable 5.1 Max 为 51.8%,Opus 5 Max 为 46.6%。图源:CursorBench 排行榜
另外值得一提的是,开源权重模型与闭源模型的差距也很直观。Fable 5.1 和 Kimi K3 在 AA 上是 53 和 44,在这里则是 72% 和 18%。这 100 张账单里,一个有 28 张没通过,另一个是 82 张。如果最后由你接手,这个差距恐怕很难忽略。 这套评测提高了复杂案例的比例,不能直接当作日常业务的错误率。不过,那些需要人接手的地方,恰恰值得模型团队仔细看。
下一版模型,该往哪里使劲?
分数拉开了,接下来让我们看看原因。ApprenticeBench 的几组分析,已经给出了一些具体线索。
用鼠标代替 API,模型要交多少 “CUA 税”?
用图形界面做事,到底会拖累模型多少?为了公平比较,ApprenticeBench 团队专门基于 Odoo 的后台接口,定制了一套与图形界面功能对等的 API 工具,让模型分别通过两种方式完成同一份工作。
团队提出了 “CUA 税” 这一概念来衡量 agent 从 API 切换为 GUI 导致的成功率损失:
CUA 税 =(API 成功率 − GUI 成功率)÷ API 成功率
使用 GUI 带来的相对成功率损失随模型代际快速下降。图源:ApprenticeBench 博客
这笔 “税” 随模型迭代逐渐降低。Fable 5.1 的 GUI/API 成功率为 72%/70%,Astra 为 68%/65%。这一结果说明今天最强模型的 CUA 税可能已经消失。
这意味着,Agent 有望直接使用企业现有软件,减少专门开发接口的需要。不过,GUI 的操作成本仍然更高,效率上还有提升空间。
模型原本就会,还是入职后学会的
做对一道题,不一定说明模型学到了新东西。它可能本来就会,也可能只是找到了可以照抄的答案。
团队设置了一个 “聪明的新手”(smart novice)对照:仅保留公司手册和软件教程,拿掉历史账单、主管反馈和跨任务记忆,看模型只靠已有知识能做多少。Fable 5 在这个设置下只通过了 11 张账单。单独加入历史账单,通过数上升到 31 张。单独加入主管反馈,则升到 35 张。两者同时提供时,达到了 43 张。公司里的经验,确实能帮它把工作做得更好。 但找到旧答案,和学会处理新情况,还有一段距离。成本码实验里,当有先例可参考时,受测模型普遍表现不错。需要从历史账单中归纳规则时,Fable 5.1 和 Astra 才明显领先。
左侧是有先例可参考的成本码,右侧需要归纳隐含规则;虚线为 smart novice 参考表现。图源:ApprenticeBench 博客
有些模型看了历史账单、听了主管反馈,提升仍然有限。有些能从旧账单里找到答案,但需要自己归纳规则时,正确率就明显下降。这些对照让我们看清了分数背后模型能力的差距所在。
经验多了,为什么反而干得更慢
人熟悉工作后,通常会越做越快。这次测试里,Agent 却普遍越做越慢。
人类与 Agent 的处理速度、笔记量随任务推进的变化。图源:ApprenticeBench 博客
笔记就是一个例子。Fable 5.1 写下了约 19.2 万词,分散在 122 个文件里。人类测试者中,笔记较多的一位也只写了约 2,800 词。记得多不代表用得好。笔记越积越多,查阅和维护它们也要花时间。还有个很有意思的例子:账单扫描件太模糊,Agent 居然自己写起了图像处理程序,折腾了近两小时,最后还是找供应商要了份清晰的。本来发条消息就能解决,它却绕了一大圈。
这些问题,光看成功率很难发现。把执行过程和消耗的时间、token 一起看,才能知道模型卡在哪里。下一版模型该学会什么、少做哪些无用功,也就有了具体的改进方向。
做得比人好,还得算算账
Fable 5.1 的通过率达到 72%,超过了人类最高的 51%。但每张账单平均花费 18.23 美元,人类是 7.21 美元,差了约 2.5 倍。这里,模型算的是 token 费用,人工算的是工作时间对应的工资。还有一些成本没算进去。处理同样的 100 张账单,Fable 5.1 发出了 1,032 条消息,两位人类测试者分别是 508 条和 450 条。多出来的来回沟通,也需要同事花时间回应。
不过,成本也不只有处理账单时的开销。让 Agent 进入一家企业,摸清业务、对接软件、配置流程,同样需要人力。这就回到了开头的 FDE 问题:这些部署和适配工作,有多少能交给 Agent 自己完成?
ApprenticeBench 的结果让人看到了这种可能。Agent 已经能直接使用现有软件,也开始能从历史记录和主管反馈中学会公司的做法。如果这些能力足够可靠,换一家客户,就有机会让 Agent 自己学习,而不必事事依赖工程师定制。以后业务规则变了,它也需要能继续学、跟得上。
这条路要走通,Agent 还得做得更省、更稳,也更容易与人配合。但它的价值也很具体:少让人花时间翻查记录、核对表单、反复检查细节,多留些精力理解客户、处理例外、做出判断。
NeoCognition 表示,他们期待,人和 AI 一起工作,最终能比今天单靠人力提高十倍乃至百倍的生产力。这个目标能否实现,要看 AI 做对了多少,也要看部署、指导和复核它需要付出多少。最后,整个团队能多做多少事,才是这笔账的答案。
关于 NeoCognition
硅谷 Agent Lab NeoCognition 由苏煜、邓翔和谷雨联合创立,创始团队在 Agent 领域累计拥有超过 30 年的研究经验。他们相信,未来会有大量各有所长的专业 Agent,让更多人和组织用得上过去难以获得的专业能力。公司已获得 Cambium Capital、Walden Catalyst Ventures、Vista Equity Partners,以及 Lip-Bu Tan、Ion Stoica、Dawn Song 等投资人与学者的支持。
Yu-Xiang Wang 近日宣布已从 UCSD 休假全职加入 NeoCognition。图源:X
最后还有个彩蛋:王宇翔(Yu-Xiang Wang)教授近日宣布,已从 UCSD 休假,全职加入 NeoCognition 担任机器学习总监(Director of Machine Learning)。他从今年 7 月起就已与团队并肩工作,而这次发布的 ApprenticeBench,只是他们正在做的事情的一部分。
8
·
--
Übersetzung ansehen
ME News 消息,9 月 20 日(UTC+8),据 MyToken 数据显示,过去24小时加密货币市场全网合约爆仓 3.15 亿美元。BTC 爆仓总金额 5694.13 万美元,ETH 爆仓总金额 5801.73 万美元,SOL 爆仓总金额 1011.43 万美元,XRP 爆仓总金额 1352.53 万美元。(来源:ME)
ME News 消息,9 月 20 日(UTC+8),据 MyToken 数据显示,过去24小时加密货币市场全网合约爆仓 3.15 亿美元。BTC 爆仓总金额 5694.13 万美元,ETH 爆仓总金额 5801.73 万美元,SOL 爆仓总金额 1011.43 万美元,XRP 爆仓总金额 1352.53 万美元。(来源:ME)
12
·
--
Übersetzung ansehen
ME News 消息,9 月 20 日(UTC+8),在 2026 世界制造业大会上,长鑫科技宣布第五代技术平台正式量产。 据介绍,长鑫科技将内存阵列有源区半间距做到 11.95 纳米,存储器电容深宽比 45:1,核心动能区高度降至 6762 纳米,同时,第五代工艺平台的存储密度有了大幅提升,同等条件下,每张晶圆的产出,与上一代平台相比提升了 50% 以上。 基于该平台打造的 24GB LPDDR5X 产品已经进入正式量产,全面进入国产主流旗舰手机。(来源:ME)
ME News 消息,9 月 20 日(UTC+8),在 2026 世界制造业大会上,长鑫科技宣布第五代技术平台正式量产。 据介绍,长鑫科技将内存阵列有源区半间距做到 11.95 纳米,存储器电容深宽比 45:1,核心动能区高度降至 6762 纳米,同时,第五代工艺平台的存储密度有了大幅提升,同等条件下,每张晶圆的产出,与上一代平台相比提升了 50% 以上。 基于该平台打造的 24GB LPDDR5X 产品已经进入正式量产,全面进入国产主流旗舰手机。(来源:ME)
6
·
--
Übersetzung ansehen
历史胜率90%、累计盈利3370万美元,58bro.eth持有超2600万美元BTC及ETH空单ME News 消息,9 月 20 日(UTC+8), 据 58bro.eth 监测,跨市场交易员 58bro.eth(X:0x58bro)近期在 Polymarket 买入多个 BTC 9 月价格预测市场的“No”份额,包括约 1 万份“BTC 在 9 月跌至 7 万美元”No 份额,投入约 9604 美元;约 8578 份“BTC 在 9 月触及 9.5 万美元”No 份额,投入约 8180 美元;以及 5 万份“BTC 在 9 月触及 10 万美元”No 份额,投入约 4.93 万美元。 截至发稿,三个“不触及”方向的市场隐含概率分别约为 95.3%、95.7%和 98.85%。其 7 月预测 BTC 不会跌至 4.75 万美元、不会涨至 7.5 万美元;8 月预测区间为 6 万至 10 万美元。本轮预测将下方边界上调至 7 万美元,并将上方边界收窄至 9.5 万美元。 其 7 月至 8 月进行的 19 笔 BTC 及 ETH 月度价格预测均实现正收益,累计盈利约 1.27 万美元,相关仓位均为“No”份额,多数买入时对应概率超过 95%。近三日,其在 Hyperliquid 的 BTC 空单由 88.75 枚增至 105.25 枚;BTC 及 ETH 空单合计价值约 2613.7 万美元,当前浮亏约 113.2 万美元。其在 Hyperliquid 累计盈利约 3370 万美元,历史胜率 90%,平均单笔持仓时间约 23 日。(来源:ME)
历史胜率90%、累计盈利3370万美元,58bro.eth持有超2600万美元BTC及ETH空单
ME News 消息,9 月 20 日(UTC+8), 据 58bro.eth 监测,跨市场交易员 58bro.eth(X:0x58bro)近期在 Polymarket 买入多个 BTC 9 月价格预测市场的“No”份额,包括约 1 万份“BTC 在 9 月跌至 7 万美元”No 份额,投入约 9604 美元;约 8578 份“BTC 在 9 月触及 9.5 万美元”No 份额,投入约 8180 美元;以及 5 万份“BTC 在 9 月触及 10 万美元”No 份额,投入约 4.93 万美元。 截至发稿,三个“不触及”方向的市场隐含概率分别约为 95.3%、95.7%和 98.85%。其 7 月预测 BTC 不会跌至 4.75 万美元、不会涨至 7.5 万美元;8 月预测区间为 6 万至 10 万美元。本轮预测将下方边界上调至 7 万美元,并将上方边界收窄至 9.5 万美元。 其 7 月至 8 月进行的 19 笔 BTC 及 ETH 月度价格预测均实现正收益,累计盈利约 1.27 万美元,相关仓位均为“No”份额,多数买入时对应概率超过 95%。近三日,其在 Hyperliquid 的 BTC 空单由 88.75 枚增至 105.25 枚;BTC 及 ETH 空单合计价值约 2613.7 万美元,当前浮亏约 113.2 万美元。其在 Hyperliquid 累计盈利约 3370 万美元,历史胜率 90%,平均单笔持仓时间约 23 日。(来源:ME)
17
·
--
Übersetzung ansehen
ME AI 消息,AI研究与部署机构OpenBMB表示,小模型无需承担所有任务,只要能够稳定完成一项实用工作即可;即使没有大型GPU或云端API,2B模型也能将旧电脑转变为实用的个人新闻工作台。(来源:ME)
ME AI 消息,AI研究与部署机构OpenBMB表示,小模型无需承担所有任务,只要能够稳定完成一项实用工作即可;即使没有大型GPU或云端API,2B模型也能将旧电脑转变为实用的个人新闻工作台。(来源:ME)
16
·
--
Artikel
Übersetzung ansehen
长江存储科创板IPO:单季盈利333亿背后的周期与机遇存储行业的历史反复证明,周期从不会缺席,只会迟到。
文章作者:Hension
文章来源:火星财经
近日,上交所官网更新了一则审核动态:长江存储科创板IPO状态变更为"已受理"。公司拟公开发行19.8亿至24.3亿股,募集资金330亿元,其中208亿元投向量产线技术升级,122亿元投向研发项目。
按申报拟募资口径计算,这是科创板迄今申报规模最大的IPO项目,保荐机构为中信证券和中信建投。
招股说明书披露的经营数据足够抢眼。2023年至2025年,长江存储营业收入从187.44亿元增至631.85亿元,复合增长率高达83.60%;归母净利润从2023年亏损191.81亿元,到2024年扭亏赚得67.71亿元,再到2025年的142.11亿元。
2026年第一季度,公司单季实现营业收入470.42亿元、归母净利润333.79亿元——一个季度的利润,已经超过2025年全年的两倍。
长江存储这份成绩单出现在一个特殊的时间窗口。自2025年下半年起,全球存储行业进入一轮由AI算力需求驱动的上行周期,NAND闪存价格持续拉升,国内厂商又恰逢国际存储巨头阶段性倾斜产能、优先保障海外客户供货所留下的供给缺口。
根据TrendForce数据计算,2026年一季度,长江存储在全球NAND Flash厂商中按销售金额和出货量均排名全球第三、中国第一。
不过,疑问也由此产生:单季76.77%的毛利率、71%的净利率,是一家芯片制造企业可持续的常态,还是周期顶部的瞬时留影?当价格红利退潮,这家重资产公司要靠什么支撑每年数百亿元的资本开支?招股书330亿元募资的背后,究竟是进攻的弹药,还是补血的刚需?
要回答这些问题,需要拆开长江存储的财务报表,回到生意本身。
一门"看天吃饭"的重资产生意
长江存储的生意模式并不复杂。公司是一家存储器IDM企业,集芯片设计、晶圆制造、封装测试及系统解决方案于一体,核心产品是3D NAND闪存——一种用于数据存储的芯片,下游覆盖数据中心、企业服务器、手机、PC等场景。
盈利逻辑可以概括为一句话:在价格由市场供需决定的标准品市场里,靠技术迭代和产能规模摊薄成本,赚取售价与成本之间的差额。行情好时,售价远高于相对刚性的成本,利润呈倍数放大;行情差时,高折旧的成本结构又会让亏损同样放大。这是一门典型"看天吃饭"的生意。
收入结构印证了这一逻辑。2025年,公司NAND Flash产品收入占主营业务收入的90.77%,其中存储芯片贡献294.44亿元、占47.17%,是当之无愧的王牌业务,毛利率达44.21%;集成主控芯片和固件的智能终端产品收入211.91亿元、占33.95%,毛利率29.83%;固态硬盘收入60.25亿元、占9.65%,毛利率23.75%。
创收承压的是"其他产品及服务"——晶圆代工、NOR Flash、芯片封测等边缘业务,收入占比从2023年的23.12%一路收缩至2026年一季度的3.58%,毛利率在多数报告期不足25%,已明显边缘化。
股权结构是理解长江存储的另一把钥匙。
发行前长江存储共有29名股东,前五大股东为湖北长晟(26.54%)、芯飞科技(25.35%,曾用名湖北紫光国器,紫光系背景)、大基金一期(11.97%)、大基金二期(11.38%)、光谷产投(9.25%)。招股书明确披露,公司无控股股东、无实际控制人。
这一结构的鲜明特点有三:其一,国资深度主导,湖北国资平台与国家集成电路产业投资基金两期合计持股过半;
其二,股东名单中罕见地聚集了农银投资、建信投资、交银投资、中银资产、工融基金五大国有银行的债转股实施机构,这是早年巨额债务融资留下的印记;
其三,智芯计划一至六号等员工持股平台进入股东序列,合计持股比例不高,但覆盖范围指向核心技术团队。
分散的股权与国资底色叠加,决定了长江存储既承载产业战略任务,又必须在商业上自我造血——而造血能力,恰恰是财报里最需要审视的部分。
亮眼报表背面的四道挑战
先看利润的质量。
2026年一季度333.79亿元的归母净利润,对应的是NAND产品平均单价较2025年全年上涨172.72%,而同期销量增速远不及价格涨幅。
把时间拉长看,驱动公司利润弹性的几乎全是价格:2024年产品均价上涨125.11%,公司扭亏;2025年均价实际下跌13.76%,靠销量增长64.74%才维持住利润增速;2026年一季度价格跳涨,利润随即爆发。
换句话说,长江存储当前超过七成的净利率,建立在存储价格的历史性高点之上。
招股书在"特别风险因素"中亦明确提示价格及毛利率波动和下滑风险——这并非格式化的套话,2023年就是现成的反面样本:那一年行业下行,公司毛利率只有5.45%,净亏191.81亿元,并计提了113.53亿元的存货跌价及合同履约成本减值损失,年末存货跌价准备计提比例达23.85%,高出招股书所列存储类可比公司14.93%的均值近9个百分点。
按招股书的解释,长期资产投入过大推高产品单位成本,是其减值负担重于同业的主因。
同一家公司,三年之间从单年巨亏近200亿元到单季暴赚超300亿元,摆动的不是经营能力的突变,而是周期的指针。
第二道挑战藏在成本结构里。
长江存储营业成本中,制造费用及折旧等占比高达69%至74%,材料成本仅占21%至26%。报告期内,公司折旧及摊销费用合计约509.49亿元,购建长期资产的现金支出累计约963.90亿元。
高固定成本意味着利润的杠杆效应是双向的:产能利用率和售价向上时,毛利急剧放大;一旦价格回落,折旧不会同步减少,亏损会以同样的速度回来。2023年公司产能爬坡期主营毛利率仅5.39%,就是这种成本结构在逆周期中的真实表现。
而此次募投的208亿元量产线升级项目投产后,又将转化为新一轮高额折旧——公司在周期的高位募资扩产,折旧的高峰却大概率落在周期之后。
第三道挑战是现金流与资本开支之间的持续紧绷。
2025年,长江存储经营活动现金流净额为326.84亿元,看似充裕,但同年购建固定资产等支付的现金达361.92亿元,自由现金流实际为负。
2023年至2025年,公司货币资金从563.22亿元一路降至347.78亿元,高投入基本靠消耗存量资金、股权融资和银行借款维持,2023年财务费用曾高达32.26亿元,占当年营业收入的17.21%。
2026年一季度现金流骤然改善至267.44亿元,但同期应收账款从2025年末的95.41亿元激增至228.45亿元,一个季度增加约133亿元,增幅远超收入增速——涨价行情下,收入确认与现金回笼之间出现了明显错配,前五大客户合计占收入54.34%的集中度,意味着公司回款节奏很大程度取决于少数大客户的议价与账期安排。
第四道挑战在存货和采购环节。
截至2026年3月末,公司存货账面余额199.41亿元,其中原材料跌价准备的计提比例高达22.36%,2024年以来各期均保持在20%以上,显著高于库存商品同期7%左右的计提水平。
原材料为何持续大额减值?结合采购数据可以看到一条线索:备品备件采购额占原材料采购总额的比例从2023年的40.99%攀升至2026年一季度的58.99%,2026年一季度第一大供应商是一家贸易商,采购占比23.04%。
设备备件经由贸易商渠道采购、又因技术迭代而较快减值,侧面反映了长江存储外部供应链环境约束下设备维护与备件保障的真实成本。招股书亦坦承,境内本土供应商仍处于追赶国际先进水平阶段,供应链整体技术水平和稳定性构成行业进入壁垒。
把上述四道挑战串起来,逻辑链条是清晰的:长江存储利润靠周期给,成本结构又刚性,所以顺周期攒下的现金必须马上投入下一轮产能军备竞赛;竞赛需要设备和备件,而供应链受制于外部环境,无形推高了采购与减值成本;资金缺口最终回到资本市场解决——这正是此番330亿元IPO募资的由来。
此外,还有一个容易被忽略的细节:截至2026年3月末,长江存储账面上仍有约34亿元的累计亏损尚未填平;2026年一季度研发费用率降至3.75%,已低于招股书所列存储类可比公司4.95%的均值。
在300层以上世代和新型存储架构的技术竞速中,研发投入的强度能否跟上,决定了下一轮换机周期里长江存储坐在牌桌的哪个位置。
超级周期里的卡位与突围
客观地说,长江存储此轮业绩爆发,一半是潮水,一半也有自身的水位。
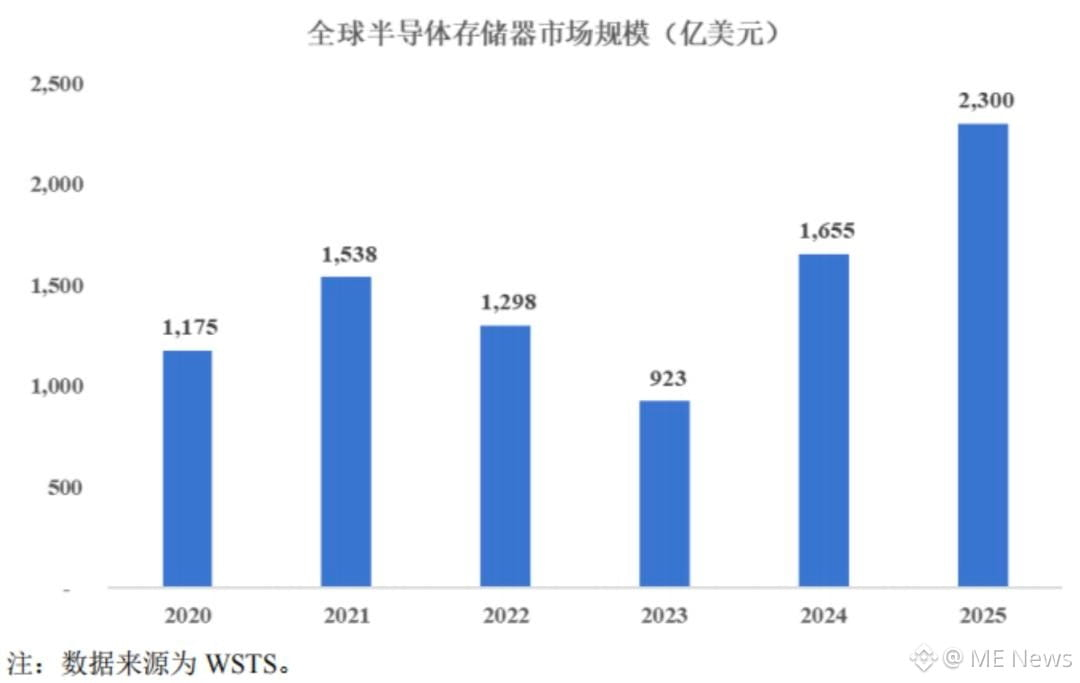
先看潮水。根据WSTS统计,全球半导体存储器市场规模从2020年的1175亿美元增长至2025年的2300亿美元;TrendForce数据显示,2025年全球NAND Flash市场规模为711亿美元。
本轮上行与过往不同之处在于需求结构:AI从训练走向规模化推理部署,云服务商持续加码算力基建,企业级存储需求指数级增长。供给端则出现了对国内厂商有利的错配——国际存储巨头阶段性将产能优先保障海外客户,国内存储厂商产能目前仅能覆盖约半数本土消费级市场需求。缺口即订单,这是长江存储销量放量的外部基础。
再看水位。长江存储的毛利率在2026年一季度已超过美光、铠侠和闪迪,与SK海力士接近,要知道,三年前长江存储这个数字还只有个位数。
产品层面,长江存储是全球首批突破200层以上3D NAND的企业,报告期内主力产品完成从第三代向第四代、第五代的迭代,存储密度和良率的提升直接摊薄了单位成本。
客户层面,企业级存储芯片逐步获得国内头部数据中心用户认可,这是比消费级市场含金量更高的准入突破。与7月27日刚登陆科创板的DRAM龙头长鑫科技相比,长江存储一季度470.42亿元的营收虽低于长鑫的508亿元,但333.79亿元的归母净利润却反超后者的247.6亿元,盈利效率并不落下风。
不过,差距同样明确。三星、SK海力士的存储业务是涵盖DRAM、NAND和HBM的全产品组合,且在企业级市场和全球客户体系中经营数十年。
而长江存储只押注NAND单一品类,收入结构中没有DRAM和HBM的对冲,在AI服务器最核心的HBM赛道上尚无席位。
当三星们用全产品线平滑周期时,单一品类的长江存储只能完整承受NAND价格的每一次起落。
面对这种格局,长江存储的应对路径在招股书里有迹可循。
产品端,向系统级方案延伸,把自产存储芯片更多导入自主智能终端和固态硬盘产品——智能终端收入占比已从2023年的19.99%升至2026年一季度的35.53%,备品备件中系统级产品材料采购的增加也印证了向模组和方案侧下沉的方向,这有助于在晶圆级标准品之外获取一部分品牌与方案溢价。
产能端,推进一期产线升级和二期、三期建设,以规模摊薄折旧,同时把晶圆产能集中于武汉区域以换取协同效率——代价是招股书单列的产能区域集中度风险。
供应链端,构建多元化供应商体系,原厂与贸易商渠道并行,并将半导体材料与设备的国产化适配纳入募投研发方向。
资本端,则是此次IPO本身:330亿元募资加上资产负债率从61.30%降至43.65%的报表修复,为下一轮周期的投入储备弹药。
结语
长江存储的招股书,呈现的是一家踩着周期节奏冲线的公司:三年营收增长逾两倍,2024年扭亏,2026年一季度登顶全球第三,毛利率压过三家国际老牌厂商,这些是真的;
利润对价格的极致敏感、509亿元折旧摊销的重资产包袱、供应链上绕不开的备件成本、34亿元未弥补的累计亏损,这些也都是真的。
对投资者而言,这份招股书最值得记住的或许不是单季333.79亿元的净利润,而是长江存储在风险因素里写下的那句话——价格及毛利率存在波动和下滑风险。
存储行业的历史反复证明,周期从不会缺席,只会迟到。330亿元募资能让长江存储在下一个冬天到来之前,把棉袄缝多厚,才是这份招股书真正要回答的问题。
长江存储科创板IPO:单季盈利333亿背后的周期与机遇
存储行业的历史反复证明,周期从不会缺席,只会迟到。
文章作者:Hension
文章来源:火星财经
近日,上交所官网更新了一则审核动态:长江存储科创板IPO状态变更为"已受理"。公司拟公开发行19.8亿至24.3亿股,募集资金330亿元,其中208亿元投向量产线技术升级,122亿元投向研发项目。
按申报拟募资口径计算,这是科创板迄今申报规模最大的IPO项目,保荐机构为中信证券和中信建投。
招股说明书披露的经营数据足够抢眼。2023年至2025年,长江存储营业收入从187.44亿元增至631.85亿元,复合增长率高达83.60%;归母净利润从2023年亏损191.81亿元,到2024年扭亏赚得67.71亿元,再到2025年的142.11亿元。
2026年第一季度,公司单季实现营业收入470.42亿元、归母净利润333.79亿元——一个季度的利润,已经超过2025年全年的两倍。
长江存储这份成绩单出现在一个特殊的时间窗口。自2025年下半年起,全球存储行业进入一轮由AI算力需求驱动的上行周期,NAND闪存价格持续拉升,国内厂商又恰逢国际存储巨头阶段性倾斜产能、优先保障海外客户供货所留下的供给缺口。
根据TrendForce数据计算,2026年一季度,长江存储在全球NAND Flash厂商中按销售金额和出货量均排名全球第三、中国第一。
不过,疑问也由此产生:单季76.77%的毛利率、71%的净利率,是一家芯片制造企业可持续的常态,还是周期顶部的瞬时留影?当价格红利退潮,这家重资产公司要靠什么支撑每年数百亿元的资本开支?招股书330亿元募资的背后,究竟是进攻的弹药,还是补血的刚需?
要回答这些问题,需要拆开长江存储的财务报表,回到生意本身。
一门"看天吃饭"的重资产生意
长江存储的生意模式并不复杂。公司是一家存储器IDM企业,集芯片设计、晶圆制造、封装测试及系统解决方案于一体,核心产品是3D NAND闪存——一种用于数据存储的芯片,下游覆盖数据中心、企业服务器、手机、PC等场景。
盈利逻辑可以概括为一句话:在价格由市场供需决定的标准品市场里,靠技术迭代和产能规模摊薄成本,赚取售价与成本之间的差额。行情好时,售价远高于相对刚性的成本,利润呈倍数放大;行情差时,高折旧的成本结构又会让亏损同样放大。这是一门典型"看天吃饭"的生意。
收入结构印证了这一逻辑。2025年,公司NAND Flash产品收入占主营业务收入的90.77%,其中存储芯片贡献294.44亿元、占47.17%,是当之无愧的王牌业务,毛利率达44.21%;集成主控芯片和固件的智能终端产品收入211.91亿元、占33.95%,毛利率29.83%;固态硬盘收入60.25亿元、占9.65%,毛利率23.75%。
创收承压的是"其他产品及服务"——晶圆代工、NOR Flash、芯片封测等边缘业务,收入占比从2023年的23.12%一路收缩至2026年一季度的3.58%,毛利率在多数报告期不足25%,已明显边缘化。
股权结构是理解长江存储的另一把钥匙。
发行前长江存储共有29名股东,前五大股东为湖北长晟(26.54%)、芯飞科技(25.35%,曾用名湖北紫光国器,紫光系背景)、大基金一期(11.97%)、大基金二期(11.38%)、光谷产投(9.25%)。招股书明确披露,公司无控股股东、无实际控制人。
这一结构的鲜明特点有三:其一,国资深度主导,湖北国资平台与国家集成电路产业投资基金两期合计持股过半;
其二,股东名单中罕见地聚集了农银投资、建信投资、交银投资、中银资产、工融基金五大国有银行的债转股实施机构,这是早年巨额债务融资留下的印记;
其三,智芯计划一至六号等员工持股平台进入股东序列,合计持股比例不高,但覆盖范围指向核心技术团队。
分散的股权与国资底色叠加,决定了长江存储既承载产业战略任务,又必须在商业上自我造血——而造血能力,恰恰是财报里最需要审视的部分。
亮眼报表背面的四道挑战
先看利润的质量。
2026年一季度333.79亿元的归母净利润,对应的是NAND产品平均单价较2025年全年上涨172.72%,而同期销量增速远不及价格涨幅。
把时间拉长看,驱动公司利润弹性的几乎全是价格:2024年产品均价上涨125.11%,公司扭亏;2025年均价实际下跌13.76%,靠销量增长64.74%才维持住利润增速;2026年一季度价格跳涨,利润随即爆发。
换句话说,长江存储当前超过七成的净利率,建立在存储价格的历史性高点之上。
招股书在"特别风险因素"中亦明确提示价格及毛利率波动和下滑风险——这并非格式化的套话,2023年就是现成的反面样本:那一年行业下行,公司毛利率只有5.45%,净亏191.81亿元,并计提了113.53亿元的存货跌价及合同履约成本减值损失,年末存货跌价准备计提比例达23.85%,高出招股书所列存储类可比公司14.93%的均值近9个百分点。
按招股书的解释,长期资产投入过大推高产品单位成本,是其减值负担重于同业的主因。
同一家公司,三年之间从单年巨亏近200亿元到单季暴赚超300亿元,摆动的不是经营能力的突变,而是周期的指针。
第二道挑战藏在成本结构里。
长江存储营业成本中,制造费用及折旧等占比高达69%至74%,材料成本仅占21%至26%。报告期内,公司折旧及摊销费用合计约509.49亿元,购建长期资产的现金支出累计约963.90亿元。
高固定成本意味着利润的杠杆效应是双向的:产能利用率和售价向上时,毛利急剧放大;一旦价格回落,折旧不会同步减少,亏损会以同样的速度回来。2023年公司产能爬坡期主营毛利率仅5.39%,就是这种成本结构在逆周期中的真实表现。
而此次募投的208亿元量产线升级项目投产后,又将转化为新一轮高额折旧——公司在周期的高位募资扩产,折旧的高峰却大概率落在周期之后。
第三道挑战是现金流与资本开支之间的持续紧绷。
2025年,长江存储经营活动现金流净额为326.84亿元,看似充裕,但同年购建固定资产等支付的现金达361.92亿元,自由现金流实际为负。
2023年至2025年,公司货币资金从563.22亿元一路降至347.78亿元,高投入基本靠消耗存量资金、股权融资和银行借款维持,2023年财务费用曾高达32.26亿元,占当年营业收入的17.21%。
2026年一季度现金流骤然改善至267.44亿元,但同期应收账款从2025年末的95.41亿元激增至228.45亿元,一个季度增加约133亿元,增幅远超收入增速——涨价行情下,收入确认与现金回笼之间出现了明显错配,前五大客户合计占收入54.34%的集中度,意味着公司回款节奏很大程度取决于少数大客户的议价与账期安排。
第四道挑战在存货和采购环节。
截至2026年3月末,公司存货账面余额199.41亿元,其中原材料跌价准备的计提比例高达22.36%,2024年以来各期均保持在20%以上,显著高于库存商品同期7%左右的计提水平。
原材料为何持续大额减值?结合采购数据可以看到一条线索:备品备件采购额占原材料采购总额的比例从2023年的40.99%攀升至2026年一季度的58.99%,2026年一季度第一大供应商是一家贸易商,采购占比23.04%。
设备备件经由贸易商渠道采购、又因技术迭代而较快减值,侧面反映了长江存储外部供应链环境约束下设备维护与备件保障的真实成本。招股书亦坦承,境内本土供应商仍处于追赶国际先进水平阶段,供应链整体技术水平和稳定性构成行业进入壁垒。
把上述四道挑战串起来,逻辑链条是清晰的:长江存储利润靠周期给,成本结构又刚性,所以顺周期攒下的现金必须马上投入下一轮产能军备竞赛;竞赛需要设备和备件,而供应链受制于外部环境,无形推高了采购与减值成本;资金缺口最终回到资本市场解决——这正是此番330亿元IPO募资的由来。
此外,还有一个容易被忽略的细节:截至2026年3月末,长江存储账面上仍有约34亿元的累计亏损尚未填平;2026年一季度研发费用率降至3.75%,已低于招股书所列存储类可比公司4.95%的均值。
在300层以上世代和新型存储架构的技术竞速中,研发投入的强度能否跟上,决定了下一轮换机周期里长江存储坐在牌桌的哪个位置。
超级周期里的卡位与突围
客观地说,长江存储此轮业绩爆发,一半是潮水,一半也有自身的水位。
先看潮水。根据WSTS统计,全球半导体存储器市场规模从2020年的1175亿美元增长至2025年的2300亿美元;TrendForce数据显示,2025年全球NAND Flash市场规模为711亿美元。
本轮上行与过往不同之处在于需求结构:AI从训练走向规模化推理部署,云服务商持续加码算力基建,企业级存储需求指数级增长。供给端则出现了对国内厂商有利的错配——国际存储巨头阶段性将产能优先保障海外客户,国内存储厂商产能目前仅能覆盖约半数本土消费级市场需求。缺口即订单,这是长江存储销量放量的外部基础。
再看水位。长江存储的毛利率在2026年一季度已超过美光、铠侠和闪迪,与SK海力士接近,要知道,三年前长江存储这个数字还只有个位数。
产品层面,长江存储是全球首批突破200层以上3D NAND的企业,报告期内主力产品完成从第三代向第四代、第五代的迭代,存储密度和良率的提升直接摊薄了单位成本。
客户层面,企业级存储芯片逐步获得国内头部数据中心用户认可,这是比消费级市场含金量更高的准入突破。与7月27日刚登陆科创板的DRAM龙头长鑫科技相比,长江存储一季度470.42亿元的营收虽低于长鑫的508亿元,但333.79亿元的归母净利润却反超后者的247.6亿元,盈利效率并不落下风。
不过,差距同样明确。三星、SK海力士的存储业务是涵盖DRAM、NAND和HBM的全产品组合,且在企业级市场和全球客户体系中经营数十年。
而长江存储只押注NAND单一品类,收入结构中没有DRAM和HBM的对冲,在AI服务器最核心的HBM赛道上尚无席位。
当三星们用全产品线平滑周期时,单一品类的长江存储只能完整承受NAND价格的每一次起落。
面对这种格局,长江存储的应对路径在招股书里有迹可循。
产品端,向系统级方案延伸,把自产存储芯片更多导入自主智能终端和固态硬盘产品——智能终端收入占比已从2023年的19.99%升至2026年一季度的35.53%,备品备件中系统级产品材料采购的增加也印证了向模组和方案侧下沉的方向,这有助于在晶圆级标准品之外获取一部分品牌与方案溢价。
产能端,推进一期产线升级和二期、三期建设,以规模摊薄折旧,同时把晶圆产能集中于武汉区域以换取协同效率——代价是招股书单列的产能区域集中度风险。
供应链端,构建多元化供应商体系,原厂与贸易商渠道并行,并将半导体材料与设备的国产化适配纳入募投研发方向。
资本端,则是此次IPO本身:330亿元募资加上资产负债率从61.30%降至43.65%的报表修复,为下一轮周期的投入储备弹药。
结语
长江存储的招股书,呈现的是一家踩着周期节奏冲线的公司:三年营收增长逾两倍,2024年扭亏,2026年一季度登顶全球第三,毛利率压过三家国际老牌厂商,这些是真的;
利润对价格的极致敏感、509亿元折旧摊销的重资产包袱、供应链上绕不开的备件成本、34亿元未弥补的累计亏损,这些也都是真的。
对投资者而言,这份招股书最值得记住的或许不是单季333.79亿元的净利润,而是长江存储在风险因素里写下的那句话——价格及毛利率存在波动和下滑风险。
存储行业的历史反复证明,周期从不会缺席,只会迟到。330亿元募资能让长江存储在下一个冬天到来之前,把棉袄缝多厚,才是这份招股书真正要回答的问题。
文章作者:Hension
文章来源:火星财经
近日,上交所官网更新了一则审核动态:长江存储科创板IPO状态变更为"已受理"。公司拟公开发行19.8亿至24.3亿股,募集资金330亿元,其中208亿元投向量产线技术升级,122亿元投向研发项目。
按申报拟募资口径计算,这是科创板迄今申报规模最大的IPO项目,保荐机构为中信证券和中信建投。
招股说明书披露的经营数据足够抢眼。2023年至2025年,长江存储营业收入从187.44亿元增至631.85亿元,复合增长率高达83.60%;归母净利润从2023年亏损191.81亿元,到2024年扭亏赚得67.71亿元,再到2025年的142.11亿元。
2026年第一季度,公司单季实现营业收入470.42亿元、归母净利润333.79亿元——一个季度的利润,已经超过2025年全年的两倍。
长江存储这份成绩单出现在一个特殊的时间窗口。自2025年下半年起,全球存储行业进入一轮由AI算力需求驱动的上行周期,NAND闪存价格持续拉升,国内厂商又恰逢国际存储巨头阶段性倾斜产能、优先保障海外客户供货所留下的供给缺口。
根据TrendForce数据计算,2026年一季度,长江存储在全球NAND Flash厂商中按销售金额和出货量均排名全球第三、中国第一。
不过,疑问也由此产生:单季76.77%的毛利率、71%的净利率,是一家芯片制造企业可持续的常态,还是周期顶部的瞬时留影?当价格红利退潮,这家重资产公司要靠什么支撑每年数百亿元的资本开支?招股书330亿元募资的背后,究竟是进攻的弹药,还是补血的刚需?
要回答这些问题,需要拆开长江存储的财务报表,回到生意本身。
一门"看天吃饭"的重资产生意
长江存储的生意模式并不复杂。公司是一家存储器IDM企业,集芯片设计、晶圆制造、封装测试及系统解决方案于一体,核心产品是3D NAND闪存——一种用于数据存储的芯片,下游覆盖数据中心、企业服务器、手机、PC等场景。
盈利逻辑可以概括为一句话:在价格由市场供需决定的标准品市场里,靠技术迭代和产能规模摊薄成本,赚取售价与成本之间的差额。行情好时,售价远高于相对刚性的成本,利润呈倍数放大;行情差时,高折旧的成本结构又会让亏损同样放大。这是一门典型"看天吃饭"的生意。
收入结构印证了这一逻辑。2025年,公司NAND Flash产品收入占主营业务收入的90.77%,其中存储芯片贡献294.44亿元、占47.17%,是当之无愧的王牌业务,毛利率达44.21%;集成主控芯片和固件的智能终端产品收入211.91亿元、占33.95%,毛利率29.83%;固态硬盘收入60.25亿元、占9.65%,毛利率23.75%。
创收承压的是"其他产品及服务"——晶圆代工、NOR Flash、芯片封测等边缘业务,收入占比从2023年的23.12%一路收缩至2026年一季度的3.58%,毛利率在多数报告期不足25%,已明显边缘化。
股权结构是理解长江存储的另一把钥匙。
发行前长江存储共有29名股东,前五大股东为湖北长晟(26.54%)、芯飞科技(25.35%,曾用名湖北紫光国器,紫光系背景)、大基金一期(11.97%)、大基金二期(11.38%)、光谷产投(9.25%)。招股书明确披露,公司无控股股东、无实际控制人。
这一结构的鲜明特点有三:其一,国资深度主导,湖北国资平台与国家集成电路产业投资基金两期合计持股过半;
其二,股东名单中罕见地聚集了农银投资、建信投资、交银投资、中银资产、工融基金五大国有银行的债转股实施机构,这是早年巨额债务融资留下的印记;
其三,智芯计划一至六号等员工持股平台进入股东序列,合计持股比例不高,但覆盖范围指向核心技术团队。
分散的股权与国资底色叠加,决定了长江存储既承载产业战略任务,又必须在商业上自我造血——而造血能力,恰恰是财报里最需要审视的部分。
亮眼报表背面的四道挑战
先看利润的质量。
2026年一季度333.79亿元的归母净利润,对应的是NAND产品平均单价较2025年全年上涨172.72%,而同期销量增速远不及价格涨幅。
把时间拉长看,驱动公司利润弹性的几乎全是价格:2024年产品均价上涨125.11%,公司扭亏;2025年均价实际下跌13.76%,靠销量增长64.74%才维持住利润增速;2026年一季度价格跳涨,利润随即爆发。
换句话说,长江存储当前超过七成的净利率,建立在存储价格的历史性高点之上。
招股书在"特别风险因素"中亦明确提示价格及毛利率波动和下滑风险——这并非格式化的套话,2023年就是现成的反面样本:那一年行业下行,公司毛利率只有5.45%,净亏191.81亿元,并计提了113.53亿元的存货跌价及合同履约成本减值损失,年末存货跌价准备计提比例达23.85%,高出招股书所列存储类可比公司14.93%的均值近9个百分点。
按招股书的解释,长期资产投入过大推高产品单位成本,是其减值负担重于同业的主因。
同一家公司,三年之间从单年巨亏近200亿元到单季暴赚超300亿元,摆动的不是经营能力的突变,而是周期的指针。
第二道挑战藏在成本结构里。
长江存储营业成本中,制造费用及折旧等占比高达69%至74%,材料成本仅占21%至26%。报告期内,公司折旧及摊销费用合计约509.49亿元,购建长期资产的现金支出累计约963.90亿元。
高固定成本意味着利润的杠杆效应是双向的:产能利用率和售价向上时,毛利急剧放大;一旦价格回落,折旧不会同步减少,亏损会以同样的速度回来。2023年公司产能爬坡期主营毛利率仅5.39%,就是这种成本结构在逆周期中的真实表现。
而此次募投的208亿元量产线升级项目投产后,又将转化为新一轮高额折旧——公司在周期的高位募资扩产,折旧的高峰却大概率落在周期之后。
第三道挑战是现金流与资本开支之间的持续紧绷。
2025年,长江存储经营活动现金流净额为326.84亿元,看似充裕,但同年购建固定资产等支付的现金达361.92亿元,自由现金流实际为负。
2023年至2025年,公司货币资金从563.22亿元一路降至347.78亿元,高投入基本靠消耗存量资金、股权融资和银行借款维持,2023年财务费用曾高达32.26亿元,占当年营业收入的17.21%。
2026年一季度现金流骤然改善至267.44亿元,但同期应收账款从2025年末的95.41亿元激增至228.45亿元,一个季度增加约133亿元,增幅远超收入增速——涨价行情下,收入确认与现金回笼之间出现了明显错配,前五大客户合计占收入54.34%的集中度,意味着公司回款节奏很大程度取决于少数大客户的议价与账期安排。
第四道挑战在存货和采购环节。
截至2026年3月末,公司存货账面余额199.41亿元,其中原材料跌价准备的计提比例高达22.36%,2024年以来各期均保持在20%以上,显著高于库存商品同期7%左右的计提水平。
原材料为何持续大额减值?结合采购数据可以看到一条线索:备品备件采购额占原材料采购总额的比例从2023年的40.99%攀升至2026年一季度的58.99%,2026年一季度第一大供应商是一家贸易商,采购占比23.04%。
设备备件经由贸易商渠道采购、又因技术迭代而较快减值,侧面反映了长江存储外部供应链环境约束下设备维护与备件保障的真实成本。招股书亦坦承,境内本土供应商仍处于追赶国际先进水平阶段,供应链整体技术水平和稳定性构成行业进入壁垒。
把上述四道挑战串起来,逻辑链条是清晰的:长江存储利润靠周期给,成本结构又刚性,所以顺周期攒下的现金必须马上投入下一轮产能军备竞赛;竞赛需要设备和备件,而供应链受制于外部环境,无形推高了采购与减值成本;资金缺口最终回到资本市场解决——这正是此番330亿元IPO募资的由来。
此外,还有一个容易被忽略的细节:截至2026年3月末,长江存储账面上仍有约34亿元的累计亏损尚未填平;2026年一季度研发费用率降至3.75%,已低于招股书所列存储类可比公司4.95%的均值。
在300层以上世代和新型存储架构的技术竞速中,研发投入的强度能否跟上,决定了下一轮换机周期里长江存储坐在牌桌的哪个位置。
超级周期里的卡位与突围
客观地说,长江存储此轮业绩爆发,一半是潮水,一半也有自身的水位。
先看潮水。根据WSTS统计,全球半导体存储器市场规模从2020年的1175亿美元增长至2025年的2300亿美元;TrendForce数据显示,2025年全球NAND Flash市场规模为711亿美元。
本轮上行与过往不同之处在于需求结构:AI从训练走向规模化推理部署,云服务商持续加码算力基建,企业级存储需求指数级增长。供给端则出现了对国内厂商有利的错配——国际存储巨头阶段性将产能优先保障海外客户,国内存储厂商产能目前仅能覆盖约半数本土消费级市场需求。缺口即订单,这是长江存储销量放量的外部基础。
再看水位。长江存储的毛利率在2026年一季度已超过美光、铠侠和闪迪,与SK海力士接近,要知道,三年前长江存储这个数字还只有个位数。
产品层面,长江存储是全球首批突破200层以上3D NAND的企业,报告期内主力产品完成从第三代向第四代、第五代的迭代,存储密度和良率的提升直接摊薄了单位成本。
客户层面,企业级存储芯片逐步获得国内头部数据中心用户认可,这是比消费级市场含金量更高的准入突破。与7月27日刚登陆科创板的DRAM龙头长鑫科技相比,长江存储一季度470.42亿元的营收虽低于长鑫的508亿元,但333.79亿元的归母净利润却反超后者的247.6亿元,盈利效率并不落下风。
不过,差距同样明确。三星、SK海力士的存储业务是涵盖DRAM、NAND和HBM的全产品组合,且在企业级市场和全球客户体系中经营数十年。
而长江存储只押注NAND单一品类,收入结构中没有DRAM和HBM的对冲,在AI服务器最核心的HBM赛道上尚无席位。
当三星们用全产品线平滑周期时,单一品类的长江存储只能完整承受NAND价格的每一次起落。
面对这种格局,长江存储的应对路径在招股书里有迹可循。
产品端,向系统级方案延伸,把自产存储芯片更多导入自主智能终端和固态硬盘产品——智能终端收入占比已从2023年的19.99%升至2026年一季度的35.53%,备品备件中系统级产品材料采购的增加也印证了向模组和方案侧下沉的方向,这有助于在晶圆级标准品之外获取一部分品牌与方案溢价。
产能端,推进一期产线升级和二期、三期建设,以规模摊薄折旧,同时把晶圆产能集中于武汉区域以换取协同效率——代价是招股书单列的产能区域集中度风险。
供应链端,构建多元化供应商体系,原厂与贸易商渠道并行,并将半导体材料与设备的国产化适配纳入募投研发方向。
资本端,则是此次IPO本身:330亿元募资加上资产负债率从61.30%降至43.65%的报表修复,为下一轮周期的投入储备弹药。
结语
长江存储的招股书,呈现的是一家踩着周期节奏冲线的公司:三年营收增长逾两倍,2024年扭亏,2026年一季度登顶全球第三,毛利率压过三家国际老牌厂商,这些是真的;
利润对价格的极致敏感、509亿元折旧摊销的重资产包袱、供应链上绕不开的备件成本、34亿元未弥补的累计亏损,这些也都是真的。
对投资者而言,这份招股书最值得记住的或许不是单季333.79亿元的净利润,而是长江存储在风险因素里写下的那句话——价格及毛利率存在波动和下滑风险。
存储行业的历史反复证明,周期从不会缺席,只会迟到。330亿元募资能让长江存储在下一个冬天到来之前,把棉袄缝多厚,才是这份招股书真正要回答的问题。
15
·
--
Übersetzung ansehen
ME AI 消息,高盛认为,年底存在一波“全资产上涨”的潜在交易机会:如果接下来顺利度过中期选举,同时油价明显回落,当前压制市场的通胀和加息压力就可能随之缓解,从而给股票、债券等资产创造共同上涨的环境。其中,油价回落是最关键的催化剂。 (来源:ME)
ME AI 消息,高盛认为,年底存在一波“全资产上涨”的潜在交易机会:如果接下来顺利度过中期选举,同时油价明显回落,当前压制市场的通胀和加息压力就可能随之缓解,从而给股票、债券等资产创造共同上涨的环境。其中,油价回落是最关键的催化剂。 (来源:ME)
17
·
--
Übersetzung ansehen
DeepSeek连调休补班也算低谷,今天API仍是半价ME News 消息,9 月 20 日(UTC+8),动察 Beating AI 快讯,DeepSeek 补充 API 峰谷计费规则。调休上班的周末,以及中国法定节假日,全天都按空闲时段收费。今天 9 月 20 日虽然是国庆调休工作日,但 API 依旧执行低谷价。 DeepSeek 8 月 17 日开始实行峰谷定价,空闲时段价格为高峰的一半。不到一周后,它又把周六、周日全部改成低谷价。这次进一步把调休补班和法定节假日的计费口径说清楚。 以 deepseek-flash 为例,每百万 token 缓存未命中输入,空闲时段是 1 元,高峰 2 元;输出分别是 4 元和 8 元。国庆另一个补班日 10 月 10 日是周六,同样按低谷价算。(来源:ME)
DeepSeek连调休补班也算低谷,今天API仍是半价
ME News 消息,9 月 20 日(UTC+8),动察 Beating AI 快讯,DeepSeek 补充 API 峰谷计费规则。调休上班的周末,以及中国法定节假日,全天都按空闲时段收费。今天 9 月 20 日虽然是国庆调休工作日,但 API 依旧执行低谷价。 DeepSeek 8 月 17 日开始实行峰谷定价,空闲时段价格为高峰的一半。不到一周后,它又把周六、周日全部改成低谷价。这次进一步把调休补班和法定节假日的计费口径说清楚。 以 deepseek-flash 为例,每百万 token 缓存未命中输入,空闲时段是 1 元,高峰 2 元;输出分别是 4 元和 8 元。国庆另一个补班日 10 月 10 日是周六,同样按低谷价算。(来源:ME)
12
·
--
Übersetzung ansehen
ME News 消息,9 月 20 日(UTC+8), 加密交易与做市公司 GSR 发布研究报告称,其统计 2013 年以来主要交易所逾 2300 次代币上市数据发现,中位上市代币在 3 日内跌破发行价,90 日内下跌 50%。 数据显示,高 FDV、低流通量代币长期表现更差。发行 FDV 超过 10 亿美元的代币一年后中位回报为-81%;初始流通量低于 20%的代币一年后约下跌 75%,而流通量在 30%至 50%的代币同期约下跌 45%。(来源:ME)
ME News 消息,9 月 20 日(UTC+8), 加密交易与做市公司 GSR 发布研究报告称,其统计 2013 年以来主要交易所逾 2300 次代币上市数据发现,中位上市代币在 3 日内跌破发行价,90 日内下跌 50%。 数据显示,高 FDV、低流通量代币长期表现更差。发行 FDV 超过 10 亿美元的代币一年后中位回报为-81%;初始流通量低于 20%的代币一年后约下跌 75%,而流通量在 30%至 50%的代币同期约下跌 45%。(来源:ME)
9
·
--
Übersetzung ansehen
迪士尼首设 CTO:挖来原 Character.AI CEO 阿南德,统管技术与 AI 平台当地时间 18 日,迪士尼宣布,原 Character.AI CEO 卡兰迪普·阿南德将于 10 月 2 日出任高级执行副总裁兼公司首位首席技术官(CTO),直接向 CEO 乔什·达马罗汇报。
文章作者、来源:AIBase
达马罗接掌迪士尼只有数月,此后一直强调利用技术推动公司各项业务发展。按照迪士尼的安排,阿南德将统管企业技术、基础设施、数据和 AI 平台,以及产品与工程业务,同时协调不同技术团队,进一步推动整个迪士尼的技术开发和交付方式现代化。
“基础设施、消费科技与 AI 的复合经验”
达马罗在声明中称:“卡兰迪普拥有基础设施、消费科技和 AI 领域难得的综合经验,将成为迪士尼高级管理团队的重要成员,帮助我们继续推进三项重点:以优秀叙事为北极星,让技术服务于创意,以及以‘一个迪士尼’的方式协同运营。”
加盟迪士尼前,阿南德曾掌管 Character.AI——用户可借助该平台创建不同角色的聊天机器人并与之互动。迪士尼除招揽阿南德外,也从 Character.AI 技术团队吸纳了部分人才。迪士尼称,阿南德任职期间带领 Character.AI 高速增长,建立起全球用户活跃度最高的消费级 AI 用户群体之一,同时把用户信任和安全放在平台发展的重要位置。此前,他还曾在金融科技公司 Brex 和 Meta 旗下 Facebook 任职。
值得一提的是,迪士尼去年曾向 Character.AI 发出停止侵权函,要求其停止未经授权使用迪士尼持有版权的角色。
迪士尼首设 CTO:挖来原 Character.AI CEO 阿南德,统管技术与 AI 平台
当地时间 18 日,迪士尼宣布,原 Character.AI CEO 卡兰迪普·阿南德将于 10 月 2 日出任高级执行副总裁兼公司首位首席技术官(CTO),直接向 CEO 乔什·达马罗汇报。
文章作者、来源:AIBase
达马罗接掌迪士尼只有数月,此后一直强调利用技术推动公司各项业务发展。按照迪士尼的安排,阿南德将统管企业技术、基础设施、数据和 AI 平台,以及产品与工程业务,同时协调不同技术团队,进一步推动整个迪士尼的技术开发和交付方式现代化。
“基础设施、消费科技与 AI 的复合经验”
达马罗在声明中称:“卡兰迪普拥有基础设施、消费科技和 AI 领域难得的综合经验,将成为迪士尼高级管理团队的重要成员,帮助我们继续推进三项重点:以优秀叙事为北极星,让技术服务于创意,以及以‘一个迪士尼’的方式协同运营。”
加盟迪士尼前,阿南德曾掌管 Character.AI——用户可借助该平台创建不同角色的聊天机器人并与之互动。迪士尼除招揽阿南德外,也从 Character.AI 技术团队吸纳了部分人才。迪士尼称,阿南德任职期间带领 Character.AI 高速增长,建立起全球用户活跃度最高的消费级 AI 用户群体之一,同时把用户信任和安全放在平台发展的重要位置。此前,他还曾在金融科技公司 Brex 和 Meta 旗下 Facebook 任职。
值得一提的是,迪士尼去年曾向 Character.AI 发出停止侵权函,要求其停止未经授权使用迪士尼持有版权的角色。
文章作者、来源:AIBase
达马罗接掌迪士尼只有数月,此后一直强调利用技术推动公司各项业务发展。按照迪士尼的安排,阿南德将统管企业技术、基础设施、数据和 AI 平台,以及产品与工程业务,同时协调不同技术团队,进一步推动整个迪士尼的技术开发和交付方式现代化。
“基础设施、消费科技与 AI 的复合经验”
达马罗在声明中称:“卡兰迪普拥有基础设施、消费科技和 AI 领域难得的综合经验,将成为迪士尼高级管理团队的重要成员,帮助我们继续推进三项重点:以优秀叙事为北极星,让技术服务于创意,以及以‘一个迪士尼’的方式协同运营。”
加盟迪士尼前,阿南德曾掌管 Character.AI——用户可借助该平台创建不同角色的聊天机器人并与之互动。迪士尼除招揽阿南德外,也从 Character.AI 技术团队吸纳了部分人才。迪士尼称,阿南德任职期间带领 Character.AI 高速增长,建立起全球用户活跃度最高的消费级 AI 用户群体之一,同时把用户信任和安全放在平台发展的重要位置。此前,他还曾在金融科技公司 Brex 和 Meta 旗下 Facebook 任职。
值得一提的是,迪士尼去年曾向 Character.AI 发出停止侵权函,要求其停止未经授权使用迪士尼持有版权的角色。
12
·
--
Artikel
Übersetzung ansehen
科技圈CEO平均日赚1万元?顶尖打工人的日薪,我们算了一下8家公司CEO平均年薪257.2万元,按250工作日计算日薪约1万元。
文章作者:壹览商业
文章来源:火星财经
这一轮AI浪潮,最先被重新定价的是人才。
从大模型公司高薪争抢算法工程师,到科技巨头为顶尖研究人员开出「天价」薪酬,人才价格不断刷新市场认知。在技术路径快速迭代、核心人才高度稀缺的阶段,一名关键员工甚至可能影响一家公司的研发节奏与产品方向。
员工被高价争夺,站在公司决策顶端的CEO又该值多少钱?
这个问题很难只靠一张工资单回答。在科技企业中,CEO既是经营管理者,也可能是创始人、核心技术带头人和主要股东,其回报通常分散在现金薪酬、股权价值与未来增值预期之中。因此,有人领取高额年薪,也有人主动放弃工资,单看薪酬高低,并不足以判断其真实回报。
我们梳理了AI大模型、自动驾驶、芯片半导体、具身智能四大赛道共18家头部科技公司的薪酬、人效与持股价值数据,试图回答一个问题:科技公司究竟如何给CEO和核心人才定价,这些价格又反映了怎样的资源配置与未来预期?
芯片赛道分化最大?CEO薪资最高720万,最低「0薪」
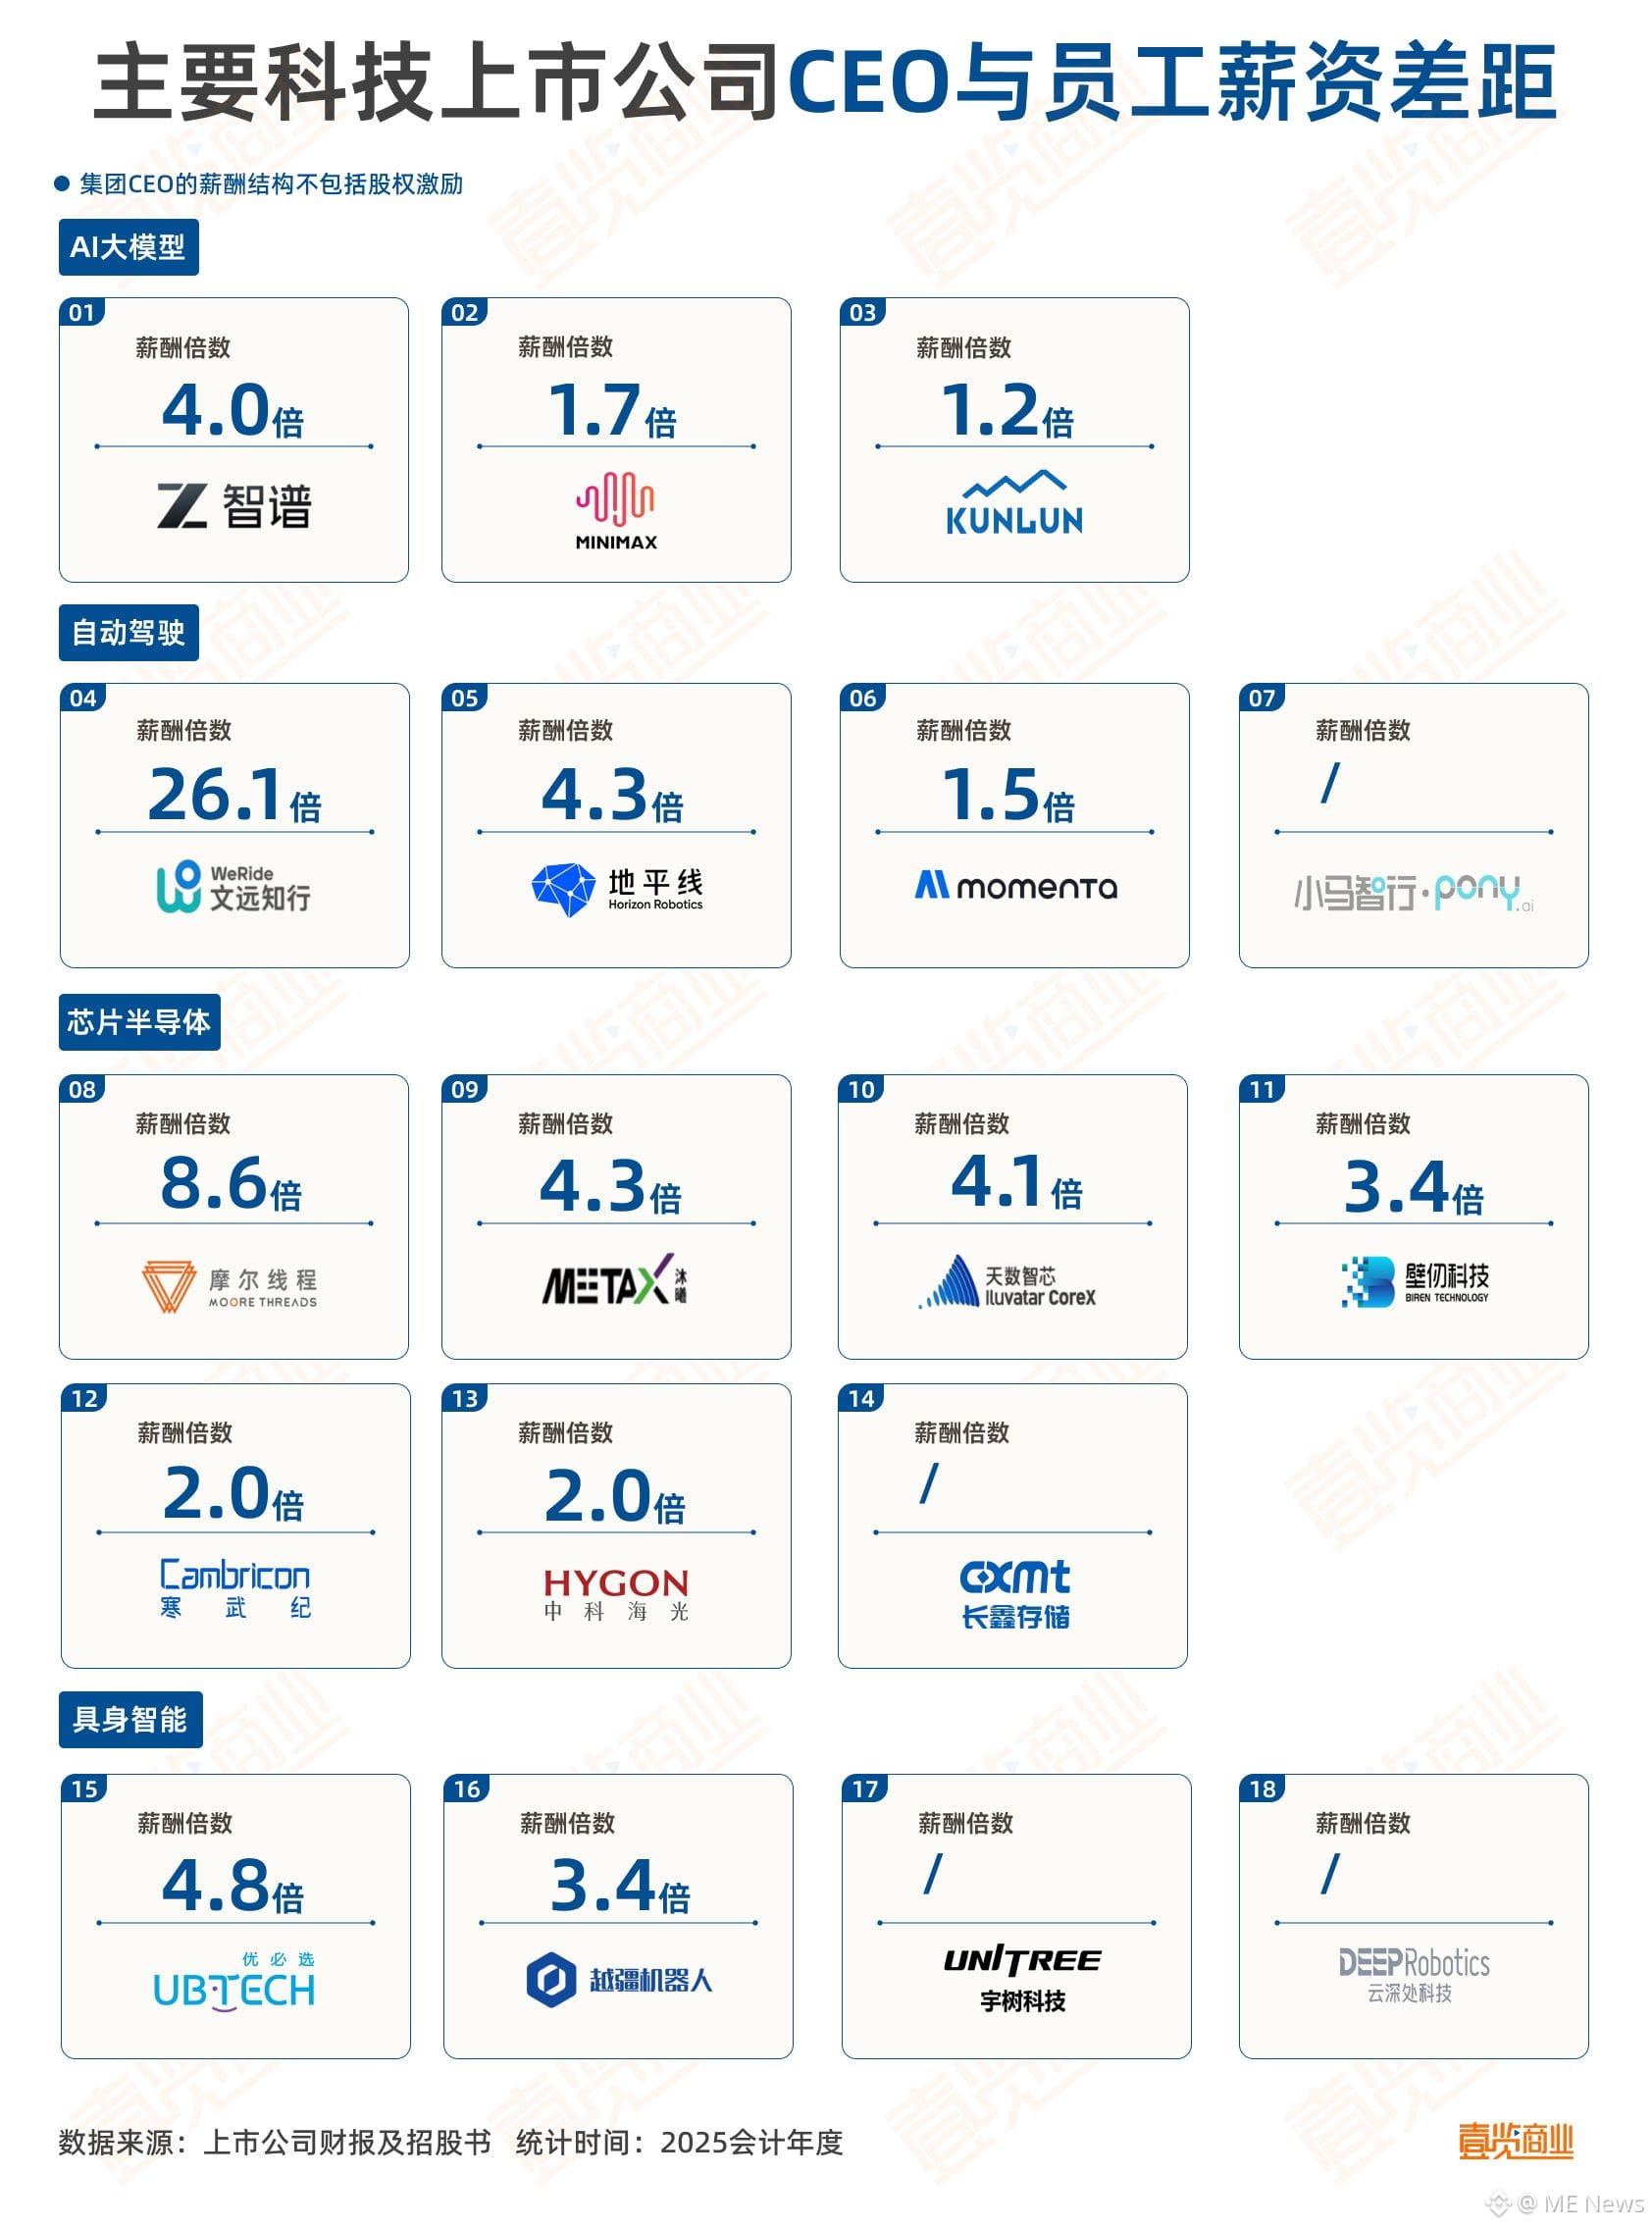
整体来看,18家公司CEO薪资呈现明显梯度分布:年薪500万元以上2家,300-500万元4家,100-300万元9家,100万元以下3家,平均年薪为257.2万元,中位数为209.8万元。若按一年250个工作日计算,平均日薪约1万元。
按赛道计算,自动驾驶公司CEO平均年薪最高,达到367.3万元;芯片半导体去除特殊的CEO朱一明,以336.5万元紧随其后;AI大模型和具身智能分别为183.5万元和148万元。
其中,芯片半导体的薪酬跨度最大。摩尔线程张建中年薪达到720万元,位居18家公司之首,约为第二名文远知行韩旭的1.2倍;同属芯片赛道的长鑫科技朱一明则承诺公司盈利前不领取工资,成为榜单中唯一的「0薪」CEO。不过, MiniMax 的闫俊杰也已于2026年7月公开宣布,在公司实现AGI之前不领取任何薪酬。若AGI未能提前实现,他大概率将在2027年也加入「0薪」行列。
张建中、朱一明的薪资反差,折射出两家公司在创始人激励上的不同选择。摩尔线程处于冲刺资本市场、加快产品迭代和商业化扩张的关键阶段,张建中的现金薪酬既包含对创始人管理职责与行业经验的定价,也体现出公司对核心管理层稳定性的重视。长鑫科技所处的存储芯片行业则具有重资产、长周期和前期投入高的特点,在公司尚未实现盈利时,朱一明选择放弃现金薪酬,将个人回报更多绑定于公司长期发展与股权增值。
随着AI算力需求爆发带动内存需求激增,2026年上半年,这一承诺已收获回报。 长鑫科技实现营收1503.1亿元,同比增长873.6%,归母净利润达776.1亿元,彻底扭亏为盈,成为了国内存储芯片的龙头。
与芯片赛道的首尾分化不同,自动驾驶公司的CEO薪酬更多集中在高位。文远知行韩旭579.9万元、地平线余凯392.9万元、小马智行彭军约335万元,均超过300万元,在18家公司中分别排第2、第3和第5,Momenta曹旭东则为161.2万元,显著低于同赛道其他公司CEO。
AI大模型赛道平均CEO薪资为183.5万元,是四大赛道中最均衡的。这与外界对大模型行业「高投入、高薪抢人」的印象形成反差:大模型公司的主要支出集中在算力基础设施和研发人才,CEO现金薪酬在整体成本中的占比相对有限。尤其当创始人同时持有较多股权时,其长期回报也未必需要通过高额工资体现。
具身智能公司CEO平均年薪为148万元,在四个赛道中最低。云深处科技朱秋国年薪为87.29万元,是除朱一明「0薪」以外薪酬最低的CEO。相较于已经形成较成熟收入模式的芯片企业,具身智能仍处于产品验证、产能建设和场景拓展并行的阶段,企业需要将有限资金投入研发、供应链与市场落地,管理层现金薪酬因此普遍更为克制。
员工薪资与薪酬倍数:商业化阶段影响薪资差距
如果说CEO薪资反映的是公司治理层面的激励策略,那么员工平均薪资则更能看出各家公司在人才争夺战中的真金白银投入。
整体来看,14家披露数据的公司员工平均薪资跨度极大,并且两个极值都出现在自动驾驶赛道:最高值Momenta达到104.1万元,最低值文远知行仅22.2万元。剔除4家数据披露不全的公司,14家可计算公司的员工平均薪资中位数约为80.3万元。
其他三个赛道的员工薪资相对集中,AI大模型内部差值25.0万元,芯片半导体差值18.9万元,具身智能差值2.5万元。唯独自动驾驶的差值达到81.9万元,跨度接近5倍,内部差异远超其他赛道。
这种差距的核心在于商业化阶段的不同。Momenta走的是量产智驾路线,与车企深度合作,截至2025年末,搭载Momenta系统的量产车辆已超68万台,全年营收24.13亿元,其中许可收入占比超过40%。营收规模相对较大,有能力支付更高薪酬。
文远知行则仍处于Robotaxi商业化早期,2025年全年营收6.85亿元,净亏损16.55亿元,研发开支14亿元,营收远未覆盖研发投入。更关键的是人员结构:文远知行研发人员达3523人,占员工总数92.69%。文远知行仅研发人员数量就是Momenta全体员工的2倍还多,庞大的研发团队导致人均薪酬被显著摊薄。
另一个值得关注的是,其他三个赛道的员工平均薪资都在70万元以上,而具身智能两家公司仅30万出头。这一差距,同样源于所处行业阶段的差异:具身智能仍处于从技术验证走向规模商用的过渡阶段。2025年全球人形机器人产量虽突破2万台,但真正进入工厂、物流等真实作业场景的仅约10%,其余大多流向科研、数据采集和娱乐用途,这一格局至今未根本改变。同时,产线装配和交付环节需要大量人力,人均薪酬自然被稀释。相比之下,大模型和芯片公司卖的是「设计」和「算法」,边际成本极低,人均薪资也就更高。
再看CEO与员工的薪酬倍数。14家可计算公司的倍数分布整体集中,但尾部拉得很长:绝大多数公司集中在1到5倍区间,共12家;而文远知行以26.1倍断层第一,是第二名摩尔线程的3倍多,也是大多数公司的6到20倍。
去掉因员工薪资而导致倍数被显著放大的文远知行,剩下13家公司的分布,更能反映行业的一般规律。芯片半导体和具身智能的均值都在4倍左右,自动驾驶约2.9倍,AI大模型约为2.3倍,均处于相对温和的区间。
这说明,在剔除极端值后,硬科技公司CEO与员工的现金薪酬差距,整体处于一个相对可控的水平。无论是芯片半导体、自动驾驶、AI大模型还是具身智能,赛道均值都在1到5倍之间。
平均人效:芯片公司断层领先,自动驾驶仍在爬坡
员工薪资之外,另一个值得关注的维度是人效,它衡量的是每名员工的产出效率。
整体来看,18家公司平均人效跨度极大:最高值寒武纪达到622.6万元,最低值文远知行仅19.9万元,首尾相差超过31倍,整体中位数约在136万元左右。
寒武纪的人效之所以如此突出,关键在于其2025年营收同比增长超过450%的同时,员工总数仅增加了127人,人均创收被急剧放大。
除了公司的人员与营收节奏,人效高低还与商业模式高度相关。芯片公司卖的是「设计」,一旦流片成功,边际成本极低;自动驾驶公司卖的是「未来」,当前仍处于「烧钱研发、营收滞后」的阶段,大量高薪研发人员尚未转化为规模化收入;AI大模型和具身智能赛道居中,内部呈现较大差异,反映出商业化进度的不同。
还有一个有颇有反差感的结论:自动驾驶CEO的平均现金薪酬在四大赛道中最高,平均人效却在四大赛道中最低。或许在商业化尚未跑通、技术路线快速迭代的阶段,留住兼具技术背景与融资能力的创始人,是这些公司最优先的支出项。
股权身价:高估值背后,是资本在为「未来」买单
硬科技公司的创始人,身价普遍不低。14家披露了股权身价的公司中,整体中位数约在82亿元左右,最高值寒武纪陈天石达到1859.1亿元。这一量级,在硬科技赛道中已属顶尖。
但科技公司创始人身价高的逻辑,和传统行业并不相同。传统行业的财富积累,往往靠的是利润分红和资产增值,而硬科技公司的股权价值,更多源于资本市场对未来的定价。一家芯片公司可能尚未盈利,但只要技术路径被认可,估值就能提前兑现。
而这种定价逻辑,源于对未来的想象空间。无论是AI、自动驾驶、芯片半导体,还是具身智能,都存在巨大的「故事溢价」,人们愿意为还没到来的技术变革,提前支付高昂的估值。
这种「为未来买单」的逻辑,在芯片赛道体现得最为极致。寒武纪陈天石身价1859.1亿元,断层第一,是第二名长鑫科技朱一明的两倍。寒武纪作为国产AI芯片第一股,股价持续走高,陈天石作为创始人持股比例较高,身价自然水涨船高。
这也解释了CEO的现金薪酬,为什么往往与持股价值并不正相关。摩尔线程张建中720万元现金薪酬居首,但其股权身价约185.4亿元;寒武纪陈天石现金薪酬仅146.4万元,股权身价却高达1859.1亿元。这种「现金薪酬」与「股权身价」的错位,正是硬科技公司创始人激励结构的典型特征——部分创始人愿意牺牲当期现金薪酬,换取公司长期股权增值。
但资本的耐心终有边界,硬科技公司的未来,最终仍要落实到商业化能力上。随着Robotaxi、具身智能、大模型等赛道逐步进入验证期,那些无法将「故事」转化为营收和利润的公司,估值终将回归理性。
届时,创始人手中的持股价值能否兑现,将取决于公司能否真正跑通商业模式,与此同时,一套既能留住核心人才、又不透支长期利益的薪酬体系,也将成为硬科技公司穿越周期的关键。
科技圈CEO平均日赚1万元?顶尖打工人的日薪,我们算了一下
8家公司CEO平均年薪257.2万元,按250工作日计算日薪约1万元。
文章作者:壹览商业
文章来源:火星财经
这一轮AI浪潮,最先被重新定价的是人才。
从大模型公司高薪争抢算法工程师,到科技巨头为顶尖研究人员开出「天价」薪酬,人才价格不断刷新市场认知。在技术路径快速迭代、核心人才高度稀缺的阶段,一名关键员工甚至可能影响一家公司的研发节奏与产品方向。
员工被高价争夺,站在公司决策顶端的CEO又该值多少钱?
这个问题很难只靠一张工资单回答。在科技企业中,CEO既是经营管理者,也可能是创始人、核心技术带头人和主要股东,其回报通常分散在现金薪酬、股权价值与未来增值预期之中。因此,有人领取高额年薪,也有人主动放弃工资,单看薪酬高低,并不足以判断其真实回报。
我们梳理了AI大模型、自动驾驶、芯片半导体、具身智能四大赛道共18家头部科技公司的薪酬、人效与持股价值数据,试图回答一个问题:科技公司究竟如何给CEO和核心人才定价,这些价格又反映了怎样的资源配置与未来预期?
芯片赛道分化最大?CEO薪资最高720万,最低「0薪」
整体来看,18家公司CEO薪资呈现明显梯度分布:年薪500万元以上2家,300-500万元4家,100-300万元9家,100万元以下3家,平均年薪为257.2万元,中位数为209.8万元。若按一年250个工作日计算,平均日薪约1万元。
按赛道计算,自动驾驶公司CEO平均年薪最高,达到367.3万元;芯片半导体去除特殊的CEO朱一明,以336.5万元紧随其后;AI大模型和具身智能分别为183.5万元和148万元。
其中,芯片半导体的薪酬跨度最大。摩尔线程张建中年薪达到720万元,位居18家公司之首,约为第二名文远知行韩旭的1.2倍;同属芯片赛道的长鑫科技朱一明则承诺公司盈利前不领取工资,成为榜单中唯一的「0薪」CEO。不过, MiniMax 的闫俊杰也已于2026年7月公开宣布,在公司实现AGI之前不领取任何薪酬。若AGI未能提前实现,他大概率将在2027年也加入「0薪」行列。
张建中、朱一明的薪资反差,折射出两家公司在创始人激励上的不同选择。摩尔线程处于冲刺资本市场、加快产品迭代和商业化扩张的关键阶段,张建中的现金薪酬既包含对创始人管理职责与行业经验的定价,也体现出公司对核心管理层稳定性的重视。长鑫科技所处的存储芯片行业则具有重资产、长周期和前期投入高的特点,在公司尚未实现盈利时,朱一明选择放弃现金薪酬,将个人回报更多绑定于公司长期发展与股权增值。
随着AI算力需求爆发带动内存需求激增,2026年上半年,这一承诺已收获回报。 长鑫科技实现营收1503.1亿元,同比增长873.6%,归母净利润达776.1亿元,彻底扭亏为盈,成为了国内存储芯片的龙头。
与芯片赛道的首尾分化不同,自动驾驶公司的CEO薪酬更多集中在高位。文远知行韩旭579.9万元、地平线余凯392.9万元、小马智行彭军约335万元,均超过300万元,在18家公司中分别排第2、第3和第5,Momenta曹旭东则为161.2万元,显著低于同赛道其他公司CEO。
AI大模型赛道平均CEO薪资为183.5万元,是四大赛道中最均衡的。这与外界对大模型行业「高投入、高薪抢人」的印象形成反差:大模型公司的主要支出集中在算力基础设施和研发人才,CEO现金薪酬在整体成本中的占比相对有限。尤其当创始人同时持有较多股权时,其长期回报也未必需要通过高额工资体现。
具身智能公司CEO平均年薪为148万元,在四个赛道中最低。云深处科技朱秋国年薪为87.29万元,是除朱一明「0薪」以外薪酬最低的CEO。相较于已经形成较成熟收入模式的芯片企业,具身智能仍处于产品验证、产能建设和场景拓展并行的阶段,企业需要将有限资金投入研发、供应链与市场落地,管理层现金薪酬因此普遍更为克制。
员工薪资与薪酬倍数:商业化阶段影响薪资差距
如果说CEO薪资反映的是公司治理层面的激励策略,那么员工平均薪资则更能看出各家公司在人才争夺战中的真金白银投入。
整体来看,14家披露数据的公司员工平均薪资跨度极大,并且两个极值都出现在自动驾驶赛道:最高值Momenta达到104.1万元,最低值文远知行仅22.2万元。剔除4家数据披露不全的公司,14家可计算公司的员工平均薪资中位数约为80.3万元。
其他三个赛道的员工薪资相对集中,AI大模型内部差值25.0万元,芯片半导体差值18.9万元,具身智能差值2.5万元。唯独自动驾驶的差值达到81.9万元,跨度接近5倍,内部差异远超其他赛道。
这种差距的核心在于商业化阶段的不同。Momenta走的是量产智驾路线,与车企深度合作,截至2025年末,搭载Momenta系统的量产车辆已超68万台,全年营收24.13亿元,其中许可收入占比超过40%。营收规模相对较大,有能力支付更高薪酬。
文远知行则仍处于Robotaxi商业化早期,2025年全年营收6.85亿元,净亏损16.55亿元,研发开支14亿元,营收远未覆盖研发投入。更关键的是人员结构:文远知行研发人员达3523人,占员工总数92.69%。文远知行仅研发人员数量就是Momenta全体员工的2倍还多,庞大的研发团队导致人均薪酬被显著摊薄。
另一个值得关注的是,其他三个赛道的员工平均薪资都在70万元以上,而具身智能两家公司仅30万出头。这一差距,同样源于所处行业阶段的差异:具身智能仍处于从技术验证走向规模商用的过渡阶段。2025年全球人形机器人产量虽突破2万台,但真正进入工厂、物流等真实作业场景的仅约10%,其余大多流向科研、数据采集和娱乐用途,这一格局至今未根本改变。同时,产线装配和交付环节需要大量人力,人均薪酬自然被稀释。相比之下,大模型和芯片公司卖的是「设计」和「算法」,边际成本极低,人均薪资也就更高。
再看CEO与员工的薪酬倍数。14家可计算公司的倍数分布整体集中,但尾部拉得很长:绝大多数公司集中在1到5倍区间,共12家;而文远知行以26.1倍断层第一,是第二名摩尔线程的3倍多,也是大多数公司的6到20倍。
去掉因员工薪资而导致倍数被显著放大的文远知行,剩下13家公司的分布,更能反映行业的一般规律。芯片半导体和具身智能的均值都在4倍左右,自动驾驶约2.9倍,AI大模型约为2.3倍,均处于相对温和的区间。
这说明,在剔除极端值后,硬科技公司CEO与员工的现金薪酬差距,整体处于一个相对可控的水平。无论是芯片半导体、自动驾驶、AI大模型还是具身智能,赛道均值都在1到5倍之间。
平均人效:芯片公司断层领先,自动驾驶仍在爬坡
员工薪资之外,另一个值得关注的维度是人效,它衡量的是每名员工的产出效率。
整体来看,18家公司平均人效跨度极大:最高值寒武纪达到622.6万元,最低值文远知行仅19.9万元,首尾相差超过31倍,整体中位数约在136万元左右。
寒武纪的人效之所以如此突出,关键在于其2025年营收同比增长超过450%的同时,员工总数仅增加了127人,人均创收被急剧放大。
除了公司的人员与营收节奏,人效高低还与商业模式高度相关。芯片公司卖的是「设计」,一旦流片成功,边际成本极低;自动驾驶公司卖的是「未来」,当前仍处于「烧钱研发、营收滞后」的阶段,大量高薪研发人员尚未转化为规模化收入;AI大模型和具身智能赛道居中,内部呈现较大差异,反映出商业化进度的不同。
还有一个有颇有反差感的结论:自动驾驶CEO的平均现金薪酬在四大赛道中最高,平均人效却在四大赛道中最低。或许在商业化尚未跑通、技术路线快速迭代的阶段,留住兼具技术背景与融资能力的创始人,是这些公司最优先的支出项。
股权身价:高估值背后,是资本在为「未来」买单
硬科技公司的创始人,身价普遍不低。14家披露了股权身价的公司中,整体中位数约在82亿元左右,最高值寒武纪陈天石达到1859.1亿元。这一量级,在硬科技赛道中已属顶尖。
但科技公司创始人身价高的逻辑,和传统行业并不相同。传统行业的财富积累,往往靠的是利润分红和资产增值,而硬科技公司的股权价值,更多源于资本市场对未来的定价。一家芯片公司可能尚未盈利,但只要技术路径被认可,估值就能提前兑现。
而这种定价逻辑,源于对未来的想象空间。无论是AI、自动驾驶、芯片半导体,还是具身智能,都存在巨大的「故事溢价」,人们愿意为还没到来的技术变革,提前支付高昂的估值。
这种「为未来买单」的逻辑,在芯片赛道体现得最为极致。寒武纪陈天石身价1859.1亿元,断层第一,是第二名长鑫科技朱一明的两倍。寒武纪作为国产AI芯片第一股,股价持续走高,陈天石作为创始人持股比例较高,身价自然水涨船高。
这也解释了CEO的现金薪酬,为什么往往与持股价值并不正相关。摩尔线程张建中720万元现金薪酬居首,但其股权身价约185.4亿元;寒武纪陈天石现金薪酬仅146.4万元,股权身价却高达1859.1亿元。这种「现金薪酬」与「股权身价」的错位,正是硬科技公司创始人激励结构的典型特征——部分创始人愿意牺牲当期现金薪酬,换取公司长期股权增值。
但资本的耐心终有边界,硬科技公司的未来,最终仍要落实到商业化能力上。随着Robotaxi、具身智能、大模型等赛道逐步进入验证期,那些无法将「故事」转化为营收和利润的公司,估值终将回归理性。
届时,创始人手中的持股价值能否兑现,将取决于公司能否真正跑通商业模式,与此同时,一套既能留住核心人才、又不透支长期利益的薪酬体系,也将成为硬科技公司穿越周期的关键。
文章作者:壹览商业
文章来源:火星财经
这一轮AI浪潮,最先被重新定价的是人才。
从大模型公司高薪争抢算法工程师,到科技巨头为顶尖研究人员开出「天价」薪酬,人才价格不断刷新市场认知。在技术路径快速迭代、核心人才高度稀缺的阶段,一名关键员工甚至可能影响一家公司的研发节奏与产品方向。
员工被高价争夺,站在公司决策顶端的CEO又该值多少钱?
这个问题很难只靠一张工资单回答。在科技企业中,CEO既是经营管理者,也可能是创始人、核心技术带头人和主要股东,其回报通常分散在现金薪酬、股权价值与未来增值预期之中。因此,有人领取高额年薪,也有人主动放弃工资,单看薪酬高低,并不足以判断其真实回报。
我们梳理了AI大模型、自动驾驶、芯片半导体、具身智能四大赛道共18家头部科技公司的薪酬、人效与持股价值数据,试图回答一个问题:科技公司究竟如何给CEO和核心人才定价,这些价格又反映了怎样的资源配置与未来预期?
芯片赛道分化最大?CEO薪资最高720万,最低「0薪」
整体来看,18家公司CEO薪资呈现明显梯度分布:年薪500万元以上2家,300-500万元4家,100-300万元9家,100万元以下3家,平均年薪为257.2万元,中位数为209.8万元。若按一年250个工作日计算,平均日薪约1万元。
按赛道计算,自动驾驶公司CEO平均年薪最高,达到367.3万元;芯片半导体去除特殊的CEO朱一明,以336.5万元紧随其后;AI大模型和具身智能分别为183.5万元和148万元。
其中,芯片半导体的薪酬跨度最大。摩尔线程张建中年薪达到720万元,位居18家公司之首,约为第二名文远知行韩旭的1.2倍;同属芯片赛道的长鑫科技朱一明则承诺公司盈利前不领取工资,成为榜单中唯一的「0薪」CEO。不过, MiniMax 的闫俊杰也已于2026年7月公开宣布,在公司实现AGI之前不领取任何薪酬。若AGI未能提前实现,他大概率将在2027年也加入「0薪」行列。
张建中、朱一明的薪资反差,折射出两家公司在创始人激励上的不同选择。摩尔线程处于冲刺资本市场、加快产品迭代和商业化扩张的关键阶段,张建中的现金薪酬既包含对创始人管理职责与行业经验的定价,也体现出公司对核心管理层稳定性的重视。长鑫科技所处的存储芯片行业则具有重资产、长周期和前期投入高的特点,在公司尚未实现盈利时,朱一明选择放弃现金薪酬,将个人回报更多绑定于公司长期发展与股权增值。
随着AI算力需求爆发带动内存需求激增,2026年上半年,这一承诺已收获回报。 长鑫科技实现营收1503.1亿元,同比增长873.6%,归母净利润达776.1亿元,彻底扭亏为盈,成为了国内存储芯片的龙头。
与芯片赛道的首尾分化不同,自动驾驶公司的CEO薪酬更多集中在高位。文远知行韩旭579.9万元、地平线余凯392.9万元、小马智行彭军约335万元,均超过300万元,在18家公司中分别排第2、第3和第5,Momenta曹旭东则为161.2万元,显著低于同赛道其他公司CEO。
AI大模型赛道平均CEO薪资为183.5万元,是四大赛道中最均衡的。这与外界对大模型行业「高投入、高薪抢人」的印象形成反差:大模型公司的主要支出集中在算力基础设施和研发人才,CEO现金薪酬在整体成本中的占比相对有限。尤其当创始人同时持有较多股权时,其长期回报也未必需要通过高额工资体现。
具身智能公司CEO平均年薪为148万元,在四个赛道中最低。云深处科技朱秋国年薪为87.29万元,是除朱一明「0薪」以外薪酬最低的CEO。相较于已经形成较成熟收入模式的芯片企业,具身智能仍处于产品验证、产能建设和场景拓展并行的阶段,企业需要将有限资金投入研发、供应链与市场落地,管理层现金薪酬因此普遍更为克制。
员工薪资与薪酬倍数:商业化阶段影响薪资差距
如果说CEO薪资反映的是公司治理层面的激励策略,那么员工平均薪资则更能看出各家公司在人才争夺战中的真金白银投入。
整体来看,14家披露数据的公司员工平均薪资跨度极大,并且两个极值都出现在自动驾驶赛道:最高值Momenta达到104.1万元,最低值文远知行仅22.2万元。剔除4家数据披露不全的公司,14家可计算公司的员工平均薪资中位数约为80.3万元。
其他三个赛道的员工薪资相对集中,AI大模型内部差值25.0万元,芯片半导体差值18.9万元,具身智能差值2.5万元。唯独自动驾驶的差值达到81.9万元,跨度接近5倍,内部差异远超其他赛道。
这种差距的核心在于商业化阶段的不同。Momenta走的是量产智驾路线,与车企深度合作,截至2025年末,搭载Momenta系统的量产车辆已超68万台,全年营收24.13亿元,其中许可收入占比超过40%。营收规模相对较大,有能力支付更高薪酬。
文远知行则仍处于Robotaxi商业化早期,2025年全年营收6.85亿元,净亏损16.55亿元,研发开支14亿元,营收远未覆盖研发投入。更关键的是人员结构:文远知行研发人员达3523人,占员工总数92.69%。文远知行仅研发人员数量就是Momenta全体员工的2倍还多,庞大的研发团队导致人均薪酬被显著摊薄。
另一个值得关注的是,其他三个赛道的员工平均薪资都在70万元以上,而具身智能两家公司仅30万出头。这一差距,同样源于所处行业阶段的差异:具身智能仍处于从技术验证走向规模商用的过渡阶段。2025年全球人形机器人产量虽突破2万台,但真正进入工厂、物流等真实作业场景的仅约10%,其余大多流向科研、数据采集和娱乐用途,这一格局至今未根本改变。同时,产线装配和交付环节需要大量人力,人均薪酬自然被稀释。相比之下,大模型和芯片公司卖的是「设计」和「算法」,边际成本极低,人均薪资也就更高。
再看CEO与员工的薪酬倍数。14家可计算公司的倍数分布整体集中,但尾部拉得很长:绝大多数公司集中在1到5倍区间,共12家;而文远知行以26.1倍断层第一,是第二名摩尔线程的3倍多,也是大多数公司的6到20倍。
去掉因员工薪资而导致倍数被显著放大的文远知行,剩下13家公司的分布,更能反映行业的一般规律。芯片半导体和具身智能的均值都在4倍左右,自动驾驶约2.9倍,AI大模型约为2.3倍,均处于相对温和的区间。
这说明,在剔除极端值后,硬科技公司CEO与员工的现金薪酬差距,整体处于一个相对可控的水平。无论是芯片半导体、自动驾驶、AI大模型还是具身智能,赛道均值都在1到5倍之间。
平均人效:芯片公司断层领先,自动驾驶仍在爬坡
员工薪资之外,另一个值得关注的维度是人效,它衡量的是每名员工的产出效率。
整体来看,18家公司平均人效跨度极大:最高值寒武纪达到622.6万元,最低值文远知行仅19.9万元,首尾相差超过31倍,整体中位数约在136万元左右。
寒武纪的人效之所以如此突出,关键在于其2025年营收同比增长超过450%的同时,员工总数仅增加了127人,人均创收被急剧放大。
除了公司的人员与营收节奏,人效高低还与商业模式高度相关。芯片公司卖的是「设计」,一旦流片成功,边际成本极低;自动驾驶公司卖的是「未来」,当前仍处于「烧钱研发、营收滞后」的阶段,大量高薪研发人员尚未转化为规模化收入;AI大模型和具身智能赛道居中,内部呈现较大差异,反映出商业化进度的不同。
还有一个有颇有反差感的结论:自动驾驶CEO的平均现金薪酬在四大赛道中最高,平均人效却在四大赛道中最低。或许在商业化尚未跑通、技术路线快速迭代的阶段,留住兼具技术背景与融资能力的创始人,是这些公司最优先的支出项。
股权身价:高估值背后,是资本在为「未来」买单
硬科技公司的创始人,身价普遍不低。14家披露了股权身价的公司中,整体中位数约在82亿元左右,最高值寒武纪陈天石达到1859.1亿元。这一量级,在硬科技赛道中已属顶尖。
但科技公司创始人身价高的逻辑,和传统行业并不相同。传统行业的财富积累,往往靠的是利润分红和资产增值,而硬科技公司的股权价值,更多源于资本市场对未来的定价。一家芯片公司可能尚未盈利,但只要技术路径被认可,估值就能提前兑现。
而这种定价逻辑,源于对未来的想象空间。无论是AI、自动驾驶、芯片半导体,还是具身智能,都存在巨大的「故事溢价」,人们愿意为还没到来的技术变革,提前支付高昂的估值。
这种「为未来买单」的逻辑,在芯片赛道体现得最为极致。寒武纪陈天石身价1859.1亿元,断层第一,是第二名长鑫科技朱一明的两倍。寒武纪作为国产AI芯片第一股,股价持续走高,陈天石作为创始人持股比例较高,身价自然水涨船高。
这也解释了CEO的现金薪酬,为什么往往与持股价值并不正相关。摩尔线程张建中720万元现金薪酬居首,但其股权身价约185.4亿元;寒武纪陈天石现金薪酬仅146.4万元,股权身价却高达1859.1亿元。这种「现金薪酬」与「股权身价」的错位,正是硬科技公司创始人激励结构的典型特征——部分创始人愿意牺牲当期现金薪酬,换取公司长期股权增值。
但资本的耐心终有边界,硬科技公司的未来,最终仍要落实到商业化能力上。随着Robotaxi、具身智能、大模型等赛道逐步进入验证期,那些无法将「故事」转化为营收和利润的公司,估值终将回归理性。
届时,创始人手中的持股价值能否兑现,将取决于公司能否真正跑通商业模式,与此同时,一套既能留住核心人才、又不透支长期利益的薪酬体系,也将成为硬科技公司穿越周期的关键。
4
·
--
Übersetzung ansehen
ME News 消息,9 月 20 日(UTC+8), Polymarket 美国平台在业务快速扩张过程中,对盗用借记卡欺诈问题处理不当。今年 2 月,负责处理其借记卡交易的公司发现,大量欺诈者将盗取的借记卡绑定账户,试图下注并将资金提现至可控账户,涉案金额至少 1000 万美元。高峰期,超过 80%的存款被判定为欺诈,远高于行业约 1%的标准。(来源:ME)
ME News 消息,9 月 20 日(UTC+8), Polymarket 美国平台在业务快速扩张过程中,对盗用借记卡欺诈问题处理不当。今年 2 月,负责处理其借记卡交易的公司发现,大量欺诈者将盗取的借记卡绑定账户,试图下注并将资金提现至可控账户,涉案金额至少 1000 万美元。高峰期,超过 80%的存款被判定为欺诈,远高于行业约 1%的标准。(来源:ME)
4
·
--
Übersetzung ansehen
ME News 消息,9 月 20 日(UTC+8),据 CoinMarketCap 行情数据显示,BNB跌破750 美元,现报价 749.9 美元, 24H跌幅达 2.3%。(来源:ME)
ME News 消息,9 月 20 日(UTC+8),据 CoinMarketCap 行情数据显示,BNB跌破750 美元,现报价 749.9 美元, 24H跌幅达 2.3%。(来源:ME)
125
·
--
Übersetzung ansehen
回报率881%,2017年入场ETH OG以10倍杠杆持有ENA多单228天ME News 消息,9 月 20 日(UTC+8), 据监测,2017 年入场的 ETH OG(0xeadc...)持有 ENA 多单约 228 天。截至北京时间 10:34,其持有约 1002.65 万枚 ENA 多单,建仓均价 0.110537 美元,仓位价值约 208.49 万美元,浮盈约 97.66 万美元。该仓位采用 10 倍全仓杠杆,ENA 较建仓成本上涨约 88.12%。 该地址目前持有 41 笔多单,总名义价值约 6984.81 万美元,整体合约杠杆约 4.65 倍。ENA 仓位占其合约敞口约 2.98%,浮盈位列当前持仓第三,低于 NEAR 的约 136.95 万美元及 AAVE 的约 102.25 万美元。该地址曾持有价值近 9000 万美元的 ETH,后均转入 Hyperliquid,此前为该平台最大 HYPE 多单持有者。(来源:ME)
回报率881%,2017年入场ETH OG以10倍杠杆持有ENA多单228天
ME News 消息,9 月 20 日(UTC+8), 据监测,2017 年入场的 ETH OG(0xeadc...)持有 ENA 多单约 228 天。截至北京时间 10:34,其持有约 1002.65 万枚 ENA 多单,建仓均价 0.110537 美元,仓位价值约 208.49 万美元,浮盈约 97.66 万美元。该仓位采用 10 倍全仓杠杆,ENA 较建仓成本上涨约 88.12%。 该地址目前持有 41 笔多单,总名义价值约 6984.81 万美元,整体合约杠杆约 4.65 倍。ENA 仓位占其合约敞口约 2.98%,浮盈位列当前持仓第三,低于 NEAR 的约 136.95 万美元及 AAVE 的约 102.25 万美元。该地址曾持有价值近 9000 万美元的 ETH,后均转入 Hyperliquid,此前为该平台最大 HYPE 多单持有者。(来源:ME)
11
·
--
Übersetzung ansehen
ME News 消息,9 月 20 日(UTC+8),据 CoinMarketCap 行情数据显示,SOL 现报价 108.25 美元, 24H跌幅达 3.0%。(来源:ME)
ME News 消息,9 月 20 日(UTC+8),据 CoinMarketCap 行情数据显示,SOL 现报价 108.25 美元, 24H跌幅达 3.0%。(来源:ME)
2
·
--
Übersetzung ansehen
ME News 消息,9 月 20 日(UTC+8),据 CoinMarketCap 行情数据显示,ETH跌破2600 美元,现报价 2590.6 美元, 24H跌幅达 1.9%。(来源:ME)
ME News 消息,9 月 20 日(UTC+8),据 CoinMarketCap 行情数据显示,ETH跌破2600 美元,现报价 2590.6 美元, 24H跌幅达 1.9%。(来源:ME)
372
·
--
Übersetzung ansehen
ME News 消息,9 月 20 日(UTC+8),据 CoinMarketCap 行情数据显示,XRP 现报价 1.3869 美元, 24H跌幅达 3.1%。(来源:ME)
ME News 消息,9 月 20 日(UTC+8),据 CoinMarketCap 行情数据显示,XRP 现报价 1.3869 美元, 24H跌幅达 3.1%。(来源:ME)
10
·
--
Artikel
Übersetzung ansehen
AI离“理解万物”还有多远?先拿癌细胞和行星轨道试试水其隐空间因子可被解析并用于生成可实验验证的生物干预方案或复现物理定律,推动AI从单纯预测走向可解释、可检验的科学发现接口。
文章作者:量子位
文章来源:火星财经
一篇技术报告中居然出现了两个看起来风马牛不相及的研究对象,跟着AI真是见世面。
一个是患者来源的类器官,另一个则跨越到了宏观宇宙……
先说前者。研究者利用模型学到的内部因子,提出了细胞因子联合抗体阻断的干预方案,并经细胞系、类器官、小鼠实验层层验证。
至于后者,研究者把模拟的行星位置和速度轨迹喂给模型,不告诉它开普勒定律。
等它学完后分析其内部的预测模式,提取出的“轨道频率-半长轴”关系拟合斜率达-1.4991(开普勒第三定律理论值为-1.5),且R²=0.99999999。
肿瘤研究和行星轨道计算两个八竿子打不着的领域,居然能用同一种预测学习方法来搞定。
大千世界千差万别,天气、分子、细胞、病人、机器人乃至行星,各自遵循完全不同的规律。
但AI在理解它们“如何变化”时,有没有可能共享一套更底层的方法?
最近,PhAI Labs联合牛津、斯坦福、普林斯顿、港中文等高校团队最新发布的JEPA-Anything,就在尝试回答这个问题。
论文显示,JEPA-Anything是一个面向不同“世界”学习预测模型的跨领域框架。
每个领域保留自己的观测形式、context-target构造和编码器,但共享后面的预测核心以及一套统一的latent world-state interface。
其中涉及一个叫做OPF(Orthogonal Predictive Factorization,正交预测分解)的关键机制。
可以先简单理解为:
别把世间各种各样的变化,全都堆在一块去学习建模。
给世界建模,一条预测通路可能不够首先来厘清一个概念,在JEPA-Anything这项研究中,“世界模型”究竟意味着什么?
JEPA-Anything论文给出的定义兼具宽泛度与操作性。
论文写道,只要模型能根据现有信息(Context)建立内部状态,并以此预测同一系统中的另一个状态,均可归入隐空间世界模型(Latent World Model)的范畴。
这里的“另一个状态”,既可以是时间上的未来,也可以是空间上的隐藏区域、不同视角,甚至是施加某种干预后的结果。
顺着这一思路,业界在过去几年间已经发展出了日趋成熟的技术路径。
例如,DreamerV3强调先构建环境模型,再在模型内部“构想”行动后果;V-JEPA 2则将视频表征学习与机器人控制结合,让机械臂在规划动作前,先预测不同行为带来的物理反馈。
而JEPA——Joint-Embedding Predictive Architecture,联合嵌入预测架构——是其中颇有代表性的一条路线。
相比直接在原始空间重建目标状态,JEPA选择在表征空间做预测,不必还原每一个像素或细节。
它会将观测信息先编码为隐空间中的内部表征,再在表征空间内完成预测。
这种设计让模型把更多表征能力留给具有预测价值的结构,减少纹理、噪声等原始空间细节的干扰。
不过,标准JEPA通常让信息全部汇入同一个target embedding,走同一条预测路径。
但现实世界的变化往往不是单线程的。
举例来说,分子的整体平移往往伴随着内部原子的微观振动;宏观气象系统的缓慢演变中,夹杂着剧烈的局部扰动;生物系统则更为复杂,多尺度、多通路的变化时刻在同步发生。
当不同尺度、不同实体、不同难度的信号强行挤在一起时,那些更容易预测、变化更显著的信号,可能优先占据更多预测容量。
相比之下,那些相对微弱却同样关键的信息,要么在梯度冲突中被抵消,要么被强信号彻底掩盖。
研究人员将其归结为一个“预测容量如何分配”的问题,同时给出了新的解决思路。
既然拥挤会导致挤压,那就进行空间解耦。
于是就有了JEPA-Anything。
其核心机制OPF(正交预测分解)将原本完整的目标状态切割为多个彼此互补的子空间,交由不同的预测分支独立处理,最终再拼回完整的世界状态。
为了防止多分支演变为“多套人马学同一件事”的冗余状态,OPF引入正交约束,让不同factor尽量占据互不重叠的预测方向,减少多个分支重复学习同一类信息;同时通过因子活性约束和编码器方差约束,避免部分factor失活,并降低表示坍缩风险。
值得注意的是,这些factor并没有被预先规定“你负责速度”“你负责温度”“你负责某条生物通路”。
它们学什么由数据中的可预测结构决定。
训练完成后,这些factor也因此留下了一个可供后续分析的内部接口。
同一预测核心,跨七类系统验证方法论说得再漂亮,最终仍需经受跨领域泛化的检验。
这就不得不提到JEPA-Anything实验设计的独到之处。
它并未局限于视频表征或机器人控制等传统领域,转而将同一套预测核心(Predictive Core)直接置于视觉、生物、临床、控制、分子、物理场和天气七类截然不同的系统中进行验证。
所谓“Anything”,并非指强行将所有领域的数据打散重构为同一种输入格式,图像、单细胞序列、分子结构乃至气象数据,依然保留各自最契合的编码器与数据形态。
它统一的是这样一套底层规则:
当数据被转换为隐空间表征之后,预测部分应当如何搭建模型、如何完成学习。
论文先在一个基于简化Pong构造的受控动态环境CITRIS Interventional Pong里做实验,以验证模型能否将复合变化“拆解学习、再行组合”。
在训练阶段,模型仅接收过单一因子的变化数据;测试阶段则需要面对此前从未出现过的多因子组合干预。
如果模型仅仅死板地记录了训练集中的完整模式,面对全新组合必然失效;如果模型学到的是不同变化之间可复用的状态变化规律,就更有机会在未见组合里重新组合它们。
实验结果表明,在分布内的单项干预中,JEPA-Anything相较标准JEPA降低了约11.7%的预测误差;而在未见过的多因子组合干预中,均方误差(MSE)同样下降了约3.5%,且在五组配对训练seed中全部改善。
随后,验证走向了更复杂的真实系统。
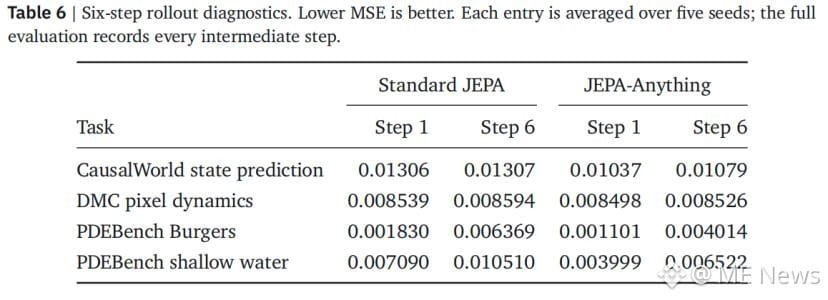
论文构建了一套严格对齐的动力学基准(Matched Dynamics Benchmark),在十项任务中确保标准JEPA与JEPA-Anything使用完全相同的训练数据、编码器、状态转移骨干网络、计算预算及评估切分。
在其中九项预测任务中,JEPA-Anything的性能指标均有所提升。
比如PDEBench里的Burgers方程,MSE下降39.7%;浅水方程下降39.3%;WeatherBench 2下降10.5%。
论文还专门做了多步rollout,让每一次预测继续成为下一次预测的输入,以观察误差不断传递之后会发生什么。
分子系统则把时间线拉得更长。
在液态水、α-石英、对乙酰氨基酚和苯四种体系中,模型需要持续预测未来的原子位置和速度,并把自己的输出不断喂回去。
最终,无论是一步预测的MAE,还是100步自由rollout后的最终位置RMSD,JEPA-Anything在四种分子系统中都拿到了最低误差。
不过值得注意的是,实验数据并未呈现出“单一机制全面碾压”的理想化曲线。
在连续控制测试中,JEPA-Anything并非每项任务都更好:在Walker2d和HalfCheetah上,它的平均得分高于标准JEPA;但在Hopper上,标准JEPA表现更好。
连续预测的距离越远,误差仍会不断累积。
在额外的Burgers测试中,当预测长度从20步增加到50步时,JEPA-Anything虽然仍然领先,但优势已明显缩小。
因此,这篇报告验证的是“共同预测原则存在跨领域适用性”,而非“已经实现一个统一所有领域的世界模型”。
但这些结果至少表明,这套预测原则具备跨领域复用的潜力。
JEPA-Anything学到的结构,能否经得起外部检验?前面的实验主要回答预测和状态表示是否有效。到了第三组实验,论文继续追问一个更进一步的问题:
模型隐空间中所形成的因子(factor),究竟是否具备科学探索价值?
于是,就有了本文开头那两个画风迥异、却又遥相呼应的研究案例。
案例一:从内部因子走向可验证的候选干预在肝癌研究中,研究人员并未将JEPA-Anything简单视作一个“黑盒预测器”,而是对其内部形成的正交因子坐标(Orthogonal Factor Coordinates)展开了领域分析,并从中筛出一个候选组合:IL-18联合NT5E/CD73阻断。
研究团队把它推进到Huh7-PBMC共培养体系,再到患者来源的肝细胞癌类器官和肿瘤组织碎片,之后还加入免疫健全小鼠验证。
实验数据表明,在3份患者类器官与3份肿瘤组织碎片中,IL-18与CD73阻断剂的组合均展现出最强的肿瘤细胞杀伤力,并伴随着显著增强的免疫细胞激活。
这意味着模型内部的Latent Factor不再只负责让预测数字“变好看”。
它开始成为研究者分析系统状态、提出可实验检验的候选假设的一种接口,由此形成“模型内部结构→领域分析→候选干预→实验验证”的链条。
案例二:从隐模式走向已知物理规律的“对账”行星轨道案例反过来拿人类早已知道的开普勒第三定律,去检验模型内部学到的东西有没有物理意义。
研究者仅向模型输入模拟产生的行星位置与速度轨迹,未附带任何先验公式。
训练完成后,研究人员对模型的隐模式(Latent Modes)进行频谱分析,并将提取出的频率与轨道半长轴配对。
结果显示,即使没有人为提前设定公式,研究者还是从模型学到的latent modes中提取出了与这套变量关系高度一致的尺度规律——拟合得到斜率‑1.4991,和理论值‑1.5高度接近,误差极小。
一个案例从内部因子出发,走向湿实验;另一个把内部模式拿出来,与已有物理规律对账。
两者从不同方向为“模型学到的内部结构可以成为科学分析接口”提供了案例证据。
研究者不一定只能在终点看一个预测数字,还可以继续向里追问,它到底捕捉到了哪些变化?这些变化是否对应真实规律?能不能从中形成下一步值得验证的东西?
这也恰好是JEPA-Anything在PhAI Labs整体战略脉络中的定位。
此前,PhAI Labs提出“科学发现大模型”(Discovery Foundation Models, DFM),旨在推动AI向开放式的科学探索迈进。
在DFM设想中,AI需要进一步参与识别未知、形成假设、设计干预,并根据外部证据持续修正的科学发现过程。
JEPA-Anything位于这套结构的世界模型层。
它试图把科学trajectory和真实世界变化中可预测的部分,压缩成可以更快速调用的预测能力,在耗时更长、成本更高的真实实验之前,提供一层近似判断。
至此再审视“从癌细胞到行星轨道”的跨度,其意义便不再停留在展示视觉反差或概念噱头。
研究人员探索的是面对机制迥异的复杂系统,AI能否共享同一种学习“演化逻辑”的方法;以及当这些变化被编码进内部状态后,这些内部结构能否被研究者拿出来分析,并接受实验结果与已知规律的检验。
这距离“AI理解万物”当然还有相当距离。JEPA-Anything目前给出的更像是一种可能性:
世界模型内部学到的结构,除了服务预测,也可以被研究者继续分析,并接受实验和已知规律的检验。
换句话说,模型不只在预测一个世界,也开始把自己学到的“世界”暴露出来,供科学家继续研究。
AI离“理解万物”还有多远?先拿癌细胞和行星轨道试试水
其隐空间因子可被解析并用于生成可实验验证的生物干预方案或复现物理定律,推动AI从单纯预测走向可解释、可检验的科学发现接口。
文章作者:量子位
文章来源:火星财经
一篇技术报告中居然出现了两个看起来风马牛不相及的研究对象,跟着AI真是见世面。
一个是患者来源的类器官,另一个则跨越到了宏观宇宙……
先说前者。研究者利用模型学到的内部因子,提出了细胞因子联合抗体阻断的干预方案,并经细胞系、类器官、小鼠实验层层验证。
至于后者,研究者把模拟的行星位置和速度轨迹喂给模型,不告诉它开普勒定律。
等它学完后分析其内部的预测模式,提取出的“轨道频率-半长轴”关系拟合斜率达-1.4991(开普勒第三定律理论值为-1.5),且R²=0.99999999。
肿瘤研究和行星轨道计算两个八竿子打不着的领域,居然能用同一种预测学习方法来搞定。
大千世界千差万别,天气、分子、细胞、病人、机器人乃至行星,各自遵循完全不同的规律。
但AI在理解它们“如何变化”时,有没有可能共享一套更底层的方法?
最近,PhAI Labs联合牛津、斯坦福、普林斯顿、港中文等高校团队最新发布的JEPA-Anything,就在尝试回答这个问题。
论文显示,JEPA-Anything是一个面向不同“世界”学习预测模型的跨领域框架。
每个领域保留自己的观测形式、context-target构造和编码器,但共享后面的预测核心以及一套统一的latent world-state interface。
其中涉及一个叫做OPF(Orthogonal Predictive Factorization,正交预测分解)的关键机制。
可以先简单理解为:
别把世间各种各样的变化,全都堆在一块去学习建模。
给世界建模,一条预测通路可能不够首先来厘清一个概念,在JEPA-Anything这项研究中,“世界模型”究竟意味着什么?
JEPA-Anything论文给出的定义兼具宽泛度与操作性。
论文写道,只要模型能根据现有信息(Context)建立内部状态,并以此预测同一系统中的另一个状态,均可归入隐空间世界模型(Latent World Model)的范畴。
这里的“另一个状态”,既可以是时间上的未来,也可以是空间上的隐藏区域、不同视角,甚至是施加某种干预后的结果。
顺着这一思路,业界在过去几年间已经发展出了日趋成熟的技术路径。
例如,DreamerV3强调先构建环境模型,再在模型内部“构想”行动后果;V-JEPA 2则将视频表征学习与机器人控制结合,让机械臂在规划动作前,先预测不同行为带来的物理反馈。
而JEPA——Joint-Embedding Predictive Architecture,联合嵌入预测架构——是其中颇有代表性的一条路线。
相比直接在原始空间重建目标状态,JEPA选择在表征空间做预测,不必还原每一个像素或细节。
它会将观测信息先编码为隐空间中的内部表征,再在表征空间内完成预测。
这种设计让模型把更多表征能力留给具有预测价值的结构,减少纹理、噪声等原始空间细节的干扰。
不过,标准JEPA通常让信息全部汇入同一个target embedding,走同一条预测路径。
但现实世界的变化往往不是单线程的。
举例来说,分子的整体平移往往伴随着内部原子的微观振动;宏观气象系统的缓慢演变中,夹杂着剧烈的局部扰动;生物系统则更为复杂,多尺度、多通路的变化时刻在同步发生。
当不同尺度、不同实体、不同难度的信号强行挤在一起时,那些更容易预测、变化更显著的信号,可能优先占据更多预测容量。
相比之下,那些相对微弱却同样关键的信息,要么在梯度冲突中被抵消,要么被强信号彻底掩盖。
研究人员将其归结为一个“预测容量如何分配”的问题,同时给出了新的解决思路。
既然拥挤会导致挤压,那就进行空间解耦。
于是就有了JEPA-Anything。
其核心机制OPF(正交预测分解)将原本完整的目标状态切割为多个彼此互补的子空间,交由不同的预测分支独立处理,最终再拼回完整的世界状态。
为了防止多分支演变为“多套人马学同一件事”的冗余状态,OPF引入正交约束,让不同factor尽量占据互不重叠的预测方向,减少多个分支重复学习同一类信息;同时通过因子活性约束和编码器方差约束,避免部分factor失活,并降低表示坍缩风险。
值得注意的是,这些factor并没有被预先规定“你负责速度”“你负责温度”“你负责某条生物通路”。
它们学什么由数据中的可预测结构决定。
训练完成后,这些factor也因此留下了一个可供后续分析的内部接口。
同一预测核心,跨七类系统验证方法论说得再漂亮,最终仍需经受跨领域泛化的检验。
这就不得不提到JEPA-Anything实验设计的独到之处。
它并未局限于视频表征或机器人控制等传统领域,转而将同一套预测核心(Predictive Core)直接置于视觉、生物、临床、控制、分子、物理场和天气七类截然不同的系统中进行验证。
所谓“Anything”,并非指强行将所有领域的数据打散重构为同一种输入格式,图像、单细胞序列、分子结构乃至气象数据,依然保留各自最契合的编码器与数据形态。
它统一的是这样一套底层规则:
当数据被转换为隐空间表征之后,预测部分应当如何搭建模型、如何完成学习。
论文先在一个基于简化Pong构造的受控动态环境CITRIS Interventional Pong里做实验,以验证模型能否将复合变化“拆解学习、再行组合”。
在训练阶段,模型仅接收过单一因子的变化数据;测试阶段则需要面对此前从未出现过的多因子组合干预。
如果模型仅仅死板地记录了训练集中的完整模式,面对全新组合必然失效;如果模型学到的是不同变化之间可复用的状态变化规律,就更有机会在未见组合里重新组合它们。
实验结果表明,在分布内的单项干预中,JEPA-Anything相较标准JEPA降低了约11.7%的预测误差;而在未见过的多因子组合干预中,均方误差(MSE)同样下降了约3.5%,且在五组配对训练seed中全部改善。
随后,验证走向了更复杂的真实系统。
论文构建了一套严格对齐的动力学基准(Matched Dynamics Benchmark),在十项任务中确保标准JEPA与JEPA-Anything使用完全相同的训练数据、编码器、状态转移骨干网络、计算预算及评估切分。
在其中九项预测任务中,JEPA-Anything的性能指标均有所提升。
比如PDEBench里的Burgers方程,MSE下降39.7%;浅水方程下降39.3%;WeatherBench 2下降10.5%。
论文还专门做了多步rollout,让每一次预测继续成为下一次预测的输入,以观察误差不断传递之后会发生什么。
分子系统则把时间线拉得更长。
在液态水、α-石英、对乙酰氨基酚和苯四种体系中,模型需要持续预测未来的原子位置和速度,并把自己的输出不断喂回去。
最终,无论是一步预测的MAE,还是100步自由rollout后的最终位置RMSD,JEPA-Anything在四种分子系统中都拿到了最低误差。
不过值得注意的是,实验数据并未呈现出“单一机制全面碾压”的理想化曲线。
在连续控制测试中,JEPA-Anything并非每项任务都更好:在Walker2d和HalfCheetah上,它的平均得分高于标准JEPA;但在Hopper上,标准JEPA表现更好。
连续预测的距离越远,误差仍会不断累积。
在额外的Burgers测试中,当预测长度从20步增加到50步时,JEPA-Anything虽然仍然领先,但优势已明显缩小。
因此,这篇报告验证的是“共同预测原则存在跨领域适用性”,而非“已经实现一个统一所有领域的世界模型”。
但这些结果至少表明,这套预测原则具备跨领域复用的潜力。
JEPA-Anything学到的结构,能否经得起外部检验?前面的实验主要回答预测和状态表示是否有效。到了第三组实验,论文继续追问一个更进一步的问题:
模型隐空间中所形成的因子(factor),究竟是否具备科学探索价值?
于是,就有了本文开头那两个画风迥异、却又遥相呼应的研究案例。
案例一:从内部因子走向可验证的候选干预在肝癌研究中,研究人员并未将JEPA-Anything简单视作一个“黑盒预测器”,而是对其内部形成的正交因子坐标(Orthogonal Factor Coordinates)展开了领域分析,并从中筛出一个候选组合:IL-18联合NT5E/CD73阻断。
研究团队把它推进到Huh7-PBMC共培养体系,再到患者来源的肝细胞癌类器官和肿瘤组织碎片,之后还加入免疫健全小鼠验证。
实验数据表明,在3份患者类器官与3份肿瘤组织碎片中,IL-18与CD73阻断剂的组合均展现出最强的肿瘤细胞杀伤力,并伴随着显著增强的免疫细胞激活。
这意味着模型内部的Latent Factor不再只负责让预测数字“变好看”。
它开始成为研究者分析系统状态、提出可实验检验的候选假设的一种接口,由此形成“模型内部结构→领域分析→候选干预→实验验证”的链条。
案例二:从隐模式走向已知物理规律的“对账”行星轨道案例反过来拿人类早已知道的开普勒第三定律,去检验模型内部学到的东西有没有物理意义。
研究者仅向模型输入模拟产生的行星位置与速度轨迹,未附带任何先验公式。
训练完成后,研究人员对模型的隐模式(Latent Modes)进行频谱分析,并将提取出的频率与轨道半长轴配对。
结果显示,即使没有人为提前设定公式,研究者还是从模型学到的latent modes中提取出了与这套变量关系高度一致的尺度规律——拟合得到斜率‑1.4991,和理论值‑1.5高度接近,误差极小。
一个案例从内部因子出发,走向湿实验;另一个把内部模式拿出来,与已有物理规律对账。
两者从不同方向为“模型学到的内部结构可以成为科学分析接口”提供了案例证据。
研究者不一定只能在终点看一个预测数字,还可以继续向里追问,它到底捕捉到了哪些变化?这些变化是否对应真实规律?能不能从中形成下一步值得验证的东西?
这也恰好是JEPA-Anything在PhAI Labs整体战略脉络中的定位。
此前,PhAI Labs提出“科学发现大模型”(Discovery Foundation Models, DFM),旨在推动AI向开放式的科学探索迈进。
在DFM设想中,AI需要进一步参与识别未知、形成假设、设计干预,并根据外部证据持续修正的科学发现过程。
JEPA-Anything位于这套结构的世界模型层。
它试图把科学trajectory和真实世界变化中可预测的部分,压缩成可以更快速调用的预测能力,在耗时更长、成本更高的真实实验之前,提供一层近似判断。
至此再审视“从癌细胞到行星轨道”的跨度,其意义便不再停留在展示视觉反差或概念噱头。
研究人员探索的是面对机制迥异的复杂系统,AI能否共享同一种学习“演化逻辑”的方法;以及当这些变化被编码进内部状态后,这些内部结构能否被研究者拿出来分析,并接受实验结果与已知规律的检验。
这距离“AI理解万物”当然还有相当距离。JEPA-Anything目前给出的更像是一种可能性:
世界模型内部学到的结构,除了服务预测,也可以被研究者继续分析,并接受实验和已知规律的检验。
换句话说,模型不只在预测一个世界,也开始把自己学到的“世界”暴露出来,供科学家继续研究。
文章作者:量子位
文章来源:火星财经
一篇技术报告中居然出现了两个看起来风马牛不相及的研究对象,跟着AI真是见世面。
一个是患者来源的类器官,另一个则跨越到了宏观宇宙……
先说前者。研究者利用模型学到的内部因子,提出了细胞因子联合抗体阻断的干预方案,并经细胞系、类器官、小鼠实验层层验证。
至于后者,研究者把模拟的行星位置和速度轨迹喂给模型,不告诉它开普勒定律。
等它学完后分析其内部的预测模式,提取出的“轨道频率-半长轴”关系拟合斜率达-1.4991(开普勒第三定律理论值为-1.5),且R²=0.99999999。
肿瘤研究和行星轨道计算两个八竿子打不着的领域,居然能用同一种预测学习方法来搞定。
大千世界千差万别,天气、分子、细胞、病人、机器人乃至行星,各自遵循完全不同的规律。
但AI在理解它们“如何变化”时,有没有可能共享一套更底层的方法?
最近,PhAI Labs联合牛津、斯坦福、普林斯顿、港中文等高校团队最新发布的JEPA-Anything,就在尝试回答这个问题。
论文显示,JEPA-Anything是一个面向不同“世界”学习预测模型的跨领域框架。
每个领域保留自己的观测形式、context-target构造和编码器,但共享后面的预测核心以及一套统一的latent world-state interface。
其中涉及一个叫做OPF(Orthogonal Predictive Factorization,正交预测分解)的关键机制。
可以先简单理解为:
别把世间各种各样的变化,全都堆在一块去学习建模。
给世界建模,一条预测通路可能不够首先来厘清一个概念,在JEPA-Anything这项研究中,“世界模型”究竟意味着什么?
JEPA-Anything论文给出的定义兼具宽泛度与操作性。
论文写道,只要模型能根据现有信息(Context)建立内部状态,并以此预测同一系统中的另一个状态,均可归入隐空间世界模型(Latent World Model)的范畴。
这里的“另一个状态”,既可以是时间上的未来,也可以是空间上的隐藏区域、不同视角,甚至是施加某种干预后的结果。
顺着这一思路,业界在过去几年间已经发展出了日趋成熟的技术路径。
例如,DreamerV3强调先构建环境模型,再在模型内部“构想”行动后果;V-JEPA 2则将视频表征学习与机器人控制结合,让机械臂在规划动作前,先预测不同行为带来的物理反馈。
而JEPA——Joint-Embedding Predictive Architecture,联合嵌入预测架构——是其中颇有代表性的一条路线。
相比直接在原始空间重建目标状态,JEPA选择在表征空间做预测,不必还原每一个像素或细节。
它会将观测信息先编码为隐空间中的内部表征,再在表征空间内完成预测。
这种设计让模型把更多表征能力留给具有预测价值的结构,减少纹理、噪声等原始空间细节的干扰。
不过,标准JEPA通常让信息全部汇入同一个target embedding,走同一条预测路径。
但现实世界的变化往往不是单线程的。
举例来说,分子的整体平移往往伴随着内部原子的微观振动;宏观气象系统的缓慢演变中,夹杂着剧烈的局部扰动;生物系统则更为复杂,多尺度、多通路的变化时刻在同步发生。
当不同尺度、不同实体、不同难度的信号强行挤在一起时,那些更容易预测、变化更显著的信号,可能优先占据更多预测容量。
相比之下,那些相对微弱却同样关键的信息,要么在梯度冲突中被抵消,要么被强信号彻底掩盖。
研究人员将其归结为一个“预测容量如何分配”的问题,同时给出了新的解决思路。
既然拥挤会导致挤压,那就进行空间解耦。
于是就有了JEPA-Anything。
其核心机制OPF(正交预测分解)将原本完整的目标状态切割为多个彼此互补的子空间,交由不同的预测分支独立处理,最终再拼回完整的世界状态。
为了防止多分支演变为“多套人马学同一件事”的冗余状态,OPF引入正交约束,让不同factor尽量占据互不重叠的预测方向,减少多个分支重复学习同一类信息;同时通过因子活性约束和编码器方差约束,避免部分factor失活,并降低表示坍缩风险。
值得注意的是,这些factor并没有被预先规定“你负责速度”“你负责温度”“你负责某条生物通路”。
它们学什么由数据中的可预测结构决定。
训练完成后,这些factor也因此留下了一个可供后续分析的内部接口。
同一预测核心,跨七类系统验证方法论说得再漂亮,最终仍需经受跨领域泛化的检验。
这就不得不提到JEPA-Anything实验设计的独到之处。
它并未局限于视频表征或机器人控制等传统领域,转而将同一套预测核心(Predictive Core)直接置于视觉、生物、临床、控制、分子、物理场和天气七类截然不同的系统中进行验证。
所谓“Anything”,并非指强行将所有领域的数据打散重构为同一种输入格式,图像、单细胞序列、分子结构乃至气象数据,依然保留各自最契合的编码器与数据形态。
它统一的是这样一套底层规则:
当数据被转换为隐空间表征之后,预测部分应当如何搭建模型、如何完成学习。
论文先在一个基于简化Pong构造的受控动态环境CITRIS Interventional Pong里做实验,以验证模型能否将复合变化“拆解学习、再行组合”。
在训练阶段,模型仅接收过单一因子的变化数据;测试阶段则需要面对此前从未出现过的多因子组合干预。
如果模型仅仅死板地记录了训练集中的完整模式,面对全新组合必然失效;如果模型学到的是不同变化之间可复用的状态变化规律,就更有机会在未见组合里重新组合它们。
实验结果表明,在分布内的单项干预中,JEPA-Anything相较标准JEPA降低了约11.7%的预测误差;而在未见过的多因子组合干预中,均方误差(MSE)同样下降了约3.5%,且在五组配对训练seed中全部改善。
随后,验证走向了更复杂的真实系统。
论文构建了一套严格对齐的动力学基准(Matched Dynamics Benchmark),在十项任务中确保标准JEPA与JEPA-Anything使用完全相同的训练数据、编码器、状态转移骨干网络、计算预算及评估切分。
在其中九项预测任务中,JEPA-Anything的性能指标均有所提升。
比如PDEBench里的Burgers方程,MSE下降39.7%;浅水方程下降39.3%;WeatherBench 2下降10.5%。
论文还专门做了多步rollout,让每一次预测继续成为下一次预测的输入,以观察误差不断传递之后会发生什么。
分子系统则把时间线拉得更长。
在液态水、α-石英、对乙酰氨基酚和苯四种体系中,模型需要持续预测未来的原子位置和速度,并把自己的输出不断喂回去。
最终,无论是一步预测的MAE,还是100步自由rollout后的最终位置RMSD,JEPA-Anything在四种分子系统中都拿到了最低误差。
不过值得注意的是,实验数据并未呈现出“单一机制全面碾压”的理想化曲线。
在连续控制测试中,JEPA-Anything并非每项任务都更好:在Walker2d和HalfCheetah上,它的平均得分高于标准JEPA;但在Hopper上,标准JEPA表现更好。
连续预测的距离越远,误差仍会不断累积。
在额外的Burgers测试中,当预测长度从20步增加到50步时,JEPA-Anything虽然仍然领先,但优势已明显缩小。
因此,这篇报告验证的是“共同预测原则存在跨领域适用性”,而非“已经实现一个统一所有领域的世界模型”。
但这些结果至少表明,这套预测原则具备跨领域复用的潜力。
JEPA-Anything学到的结构,能否经得起外部检验?前面的实验主要回答预测和状态表示是否有效。到了第三组实验,论文继续追问一个更进一步的问题:
模型隐空间中所形成的因子(factor),究竟是否具备科学探索价值?
于是,就有了本文开头那两个画风迥异、却又遥相呼应的研究案例。
案例一:从内部因子走向可验证的候选干预在肝癌研究中,研究人员并未将JEPA-Anything简单视作一个“黑盒预测器”,而是对其内部形成的正交因子坐标(Orthogonal Factor Coordinates)展开了领域分析,并从中筛出一个候选组合:IL-18联合NT5E/CD73阻断。
研究团队把它推进到Huh7-PBMC共培养体系,再到患者来源的肝细胞癌类器官和肿瘤组织碎片,之后还加入免疫健全小鼠验证。
实验数据表明,在3份患者类器官与3份肿瘤组织碎片中,IL-18与CD73阻断剂的组合均展现出最强的肿瘤细胞杀伤力,并伴随着显著增强的免疫细胞激活。
这意味着模型内部的Latent Factor不再只负责让预测数字“变好看”。
它开始成为研究者分析系统状态、提出可实验检验的候选假设的一种接口,由此形成“模型内部结构→领域分析→候选干预→实验验证”的链条。
案例二:从隐模式走向已知物理规律的“对账”行星轨道案例反过来拿人类早已知道的开普勒第三定律,去检验模型内部学到的东西有没有物理意义。
研究者仅向模型输入模拟产生的行星位置与速度轨迹,未附带任何先验公式。
训练完成后,研究人员对模型的隐模式(Latent Modes)进行频谱分析,并将提取出的频率与轨道半长轴配对。
结果显示,即使没有人为提前设定公式,研究者还是从模型学到的latent modes中提取出了与这套变量关系高度一致的尺度规律——拟合得到斜率‑1.4991,和理论值‑1.5高度接近,误差极小。
一个案例从内部因子出发,走向湿实验;另一个把内部模式拿出来,与已有物理规律对账。
两者从不同方向为“模型学到的内部结构可以成为科学分析接口”提供了案例证据。
研究者不一定只能在终点看一个预测数字,还可以继续向里追问,它到底捕捉到了哪些变化?这些变化是否对应真实规律?能不能从中形成下一步值得验证的东西?
这也恰好是JEPA-Anything在PhAI Labs整体战略脉络中的定位。
此前,PhAI Labs提出“科学发现大模型”(Discovery Foundation Models, DFM),旨在推动AI向开放式的科学探索迈进。
在DFM设想中,AI需要进一步参与识别未知、形成假设、设计干预,并根据外部证据持续修正的科学发现过程。
JEPA-Anything位于这套结构的世界模型层。
它试图把科学trajectory和真实世界变化中可预测的部分,压缩成可以更快速调用的预测能力,在耗时更长、成本更高的真实实验之前,提供一层近似判断。
至此再审视“从癌细胞到行星轨道”的跨度,其意义便不再停留在展示视觉反差或概念噱头。
研究人员探索的是面对机制迥异的复杂系统,AI能否共享同一种学习“演化逻辑”的方法;以及当这些变化被编码进内部状态后,这些内部结构能否被研究者拿出来分析,并接受实验结果与已知规律的检验。
这距离“AI理解万物”当然还有相当距离。JEPA-Anything目前给出的更像是一种可能性:
世界模型内部学到的结构,除了服务预测,也可以被研究者继续分析,并接受实验和已知规律的检验。
换句话说,模型不只在预测一个世界,也开始把自己学到的“世界”暴露出来,供科学家继续研究。
6
·
--
Übersetzung ansehen
ME AI 消息,动察 Beating AI 快讯,智谱 ZCode 的代码上传风波开始从开发者社区烧到企业客户。太原承明科技向智谱发函称,ZCode 自动上传的并非少量代码片段,而是包含完整源代码、Git 历史、数据库口令、云服务凭证和员工个人信息的项目归档,并要求智谱删除已上传数据、说明数据去向并提供删除证明。 智谱此前已经道歉,称问题来自「代码库索引」功能。该功能上线初期默认开启,生成 Repo Wiki 时可能上传仓库数据。智谱称相关数据使用后会立即销毁,问题目前已经修复,并承诺开源 ZCode、邀请第三方审查。(来源:ME)
ME AI 消息,动察 Beating AI 快讯,智谱 ZCode 的代码上传风波开始从开发者社区烧到企业客户。太原承明科技向智谱发函称,ZCode 自动上传的并非少量代码片段,而是包含完整源代码、Git 历史、数据库口令、云服务凭证和员工个人信息的项目归档,并要求智谱删除已上传数据、说明数据去向并提供删除证明。 智谱此前已经道歉,称问题来自「代码库索引」功能。该功能上线初期默认开启,生成 Repo Wiki 时可能上传仓库数据。智谱称相关数据使用后会立即销毁,问题目前已经修复,并承诺开源 ZCode、邀请第三方审查。(来源:ME)
10
Anmelden und weiter Inhalte entdecken
Krypto-Nutzer weltweit auf Binance Square kennenlernen
⚡️ Bleib in Sachen Krypto stets am Puls.
💬 Die weltgrößte Kryptobörse vertraut darauf.
👍 Erhalte verlässliche Einblicke von verifizierten Creators.
E-Mail-Adresse/Telefonnummer
Trendthemen
BOJRaisesRatesTo31YearHigh
84,303 Aufrufe
1,325 Kommentare
#bojraisesratesto31yearhigh
🇯🇵 BOJ erhöhte Zinsen. Warum fiel der Yen trotzdem?
Stell dir vor, du würdest eine Währung leihen, deren Zentralbank gerade die Zinsen erhöht hat …
… und diese Währung wird trotzdem schwächer. 😂
Am 18. September erhöhte die BOJ die Zinsen um 25 Basispunkte auf 1,25 % – das höchste Niveau seit 31 Jahren.
Die Abstimmung? 7–2.
Aber USD/JPY sprang bis auf 158,05, da Händler fragten, wie aggressiv die nächsten Zinsschritte ausfallen könnten.
ABER HIER IST WAS VIELE NICHT BEACHTEN 👀
Der Markt hat nicht nur den Zinsschritt gehandelt.
Er hat die „Guidance“-Lücke gehandelt.
Der 25bp-Schritt war weitgehend erwartet.
Entscheidend war, ob BOJ-Gouverneur Ueda einen klaren Weg für weiteres Straffen signalisieren würde.
Er hat sich nicht auf ein vorgegebenes Tempo festgelegt.
Währenddessen bleibt die Zinsdifferenz zwischen den USA und Japan groß genug, um die Carry-Trade-Story am Leben zu halten: Günstige-Yen-Finanzierung kann sich weiterhin gegen höher verzinsliche Assets anderswo durchsetzen.
Und dann kam die Krypto-Wendung:
BTC erholte sich nach der BOJ-Entscheidung um etwa 5,9 % Richtung 81.000 US-Dollar.
Also:
BOJ-Straffung ≠ automatischer Krypto-Verkauf.
Aber es gibt noch ein Risiko.
Wenn USD/JPY weiter steigt, können die Sorgen um Interventionen stärker werden. Wenn der Yen plötzlich stärker wird, könnten sich überfüllte Carry-Positionen schnell auflösen.
🧠 Square-Einblick:
Märkte handeln nicht die Zinsanhebung. Sie handeln die Lücke zwischen dem, was erwartet wurde, und dem, was geliefert wurde.
Glaubst du, dass der nächste BOJ-Schritt den Carry Trade endlich brechen wird?
Nur Marktkommentar. Keine Finanzberatung.
#BOJ #JapaneseYen #CarryTrade
$BTC
TuilaNamKy
·3 Likes
·4.6k Aufrufe
BuffettStepsDownAsBerkshireChairman
38,027 Aufrufe
618 Kommentare
XRPExchangeReservesHitSevenYearLow
43,409 Aufrufe
582 Kommentare