
Phala Re-poster
83 Beiträge
Phala Re-poster
Melden
Nutzer blockieren
Empowering 10,000 builders and companies to build scalable, private, and safe intelligence.
0 Following
7 Follower
2 Like gegeben
Beiträge
Alle
Videos
Übersetzung ansehen
Operating on TEE-backed AI infrastructure, Phala Confidential AI successfully processed 120.50 billion tokens across the past 24 hours.
The leading models driving this volume include:
1. Kimi K3, accounting for 69.39%
2. Xing4.0 29B A4B, representing 10.71%
3. Qwen3.8 27B, contributing 8.61%
To explore the top-performing model, visit:
https://phala.com/models/moonshotai/kimi-k3
Operating on TEE-backed AI infrastructure, Phala Confidential AI successfully processed 120.50 billion tokens across the past 24 hours.
The leading models driving this volume include:
1. Kimi K3, accounting for 69.39%
2. Xing4.0 29B A4B, representing 10.71%
3. Qwen3.8 27B, contributing 8.61%
To explore the top-performing model, visit:
https://phala.com/models/moonshotai/kimi-k3
The leading models driving this volume include:
1. Kimi K3, accounting for 69.39%
2. Xing4.0 29B A4B, representing 10.71%
3. Qwen3.8 27B, contributing 8.61%
To explore the top-performing model, visit:
https://phala.com/models/moonshotai/kimi-k3
51
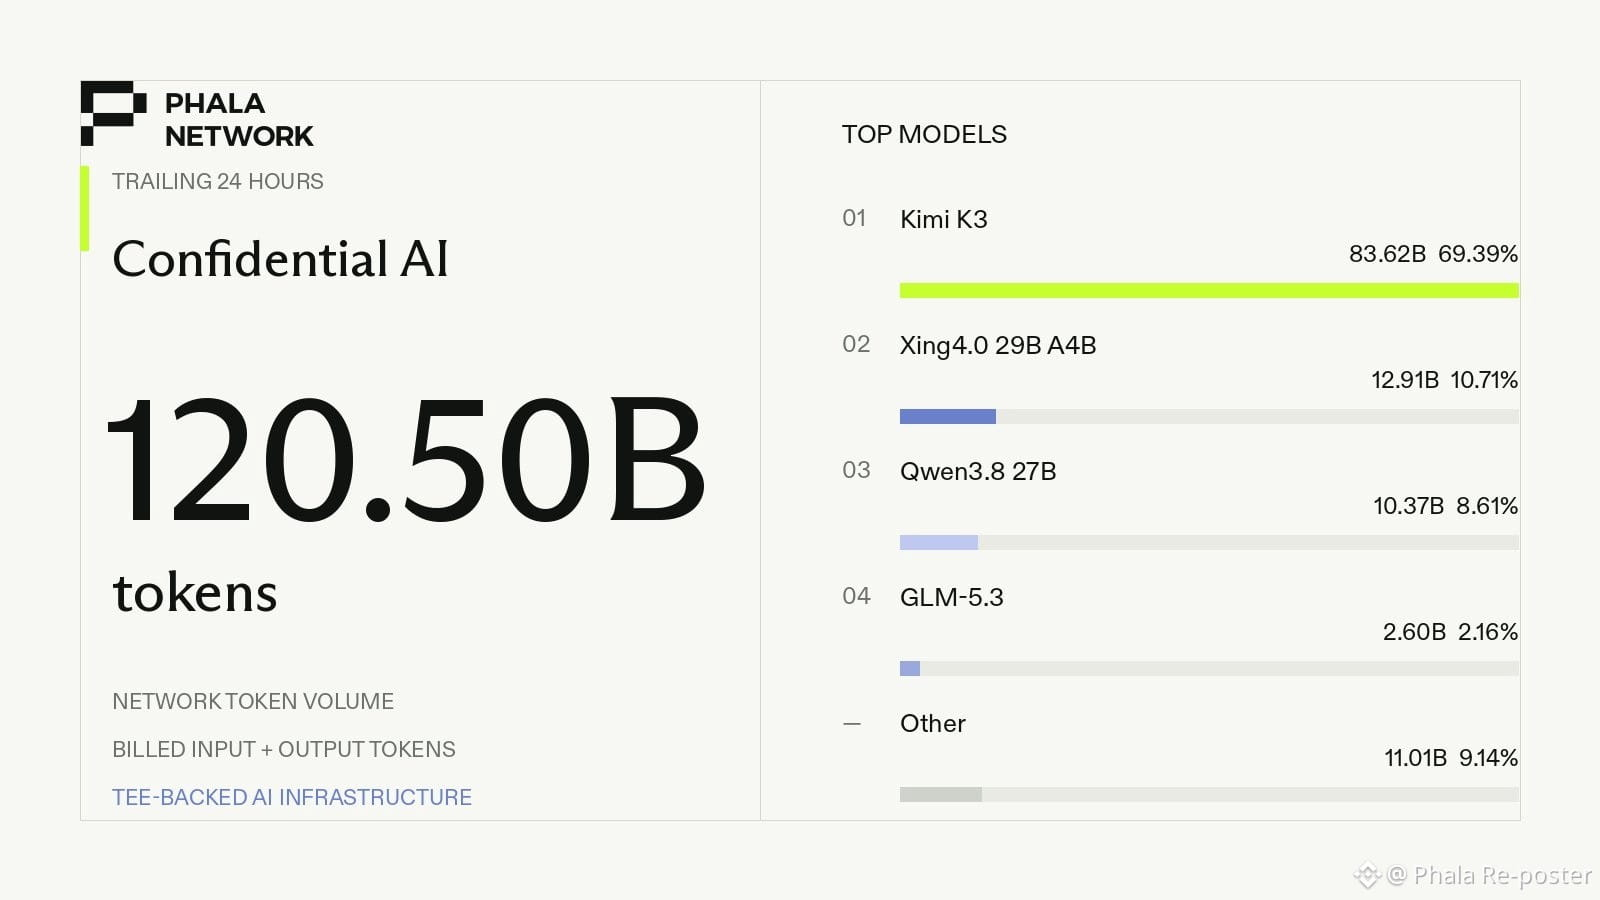
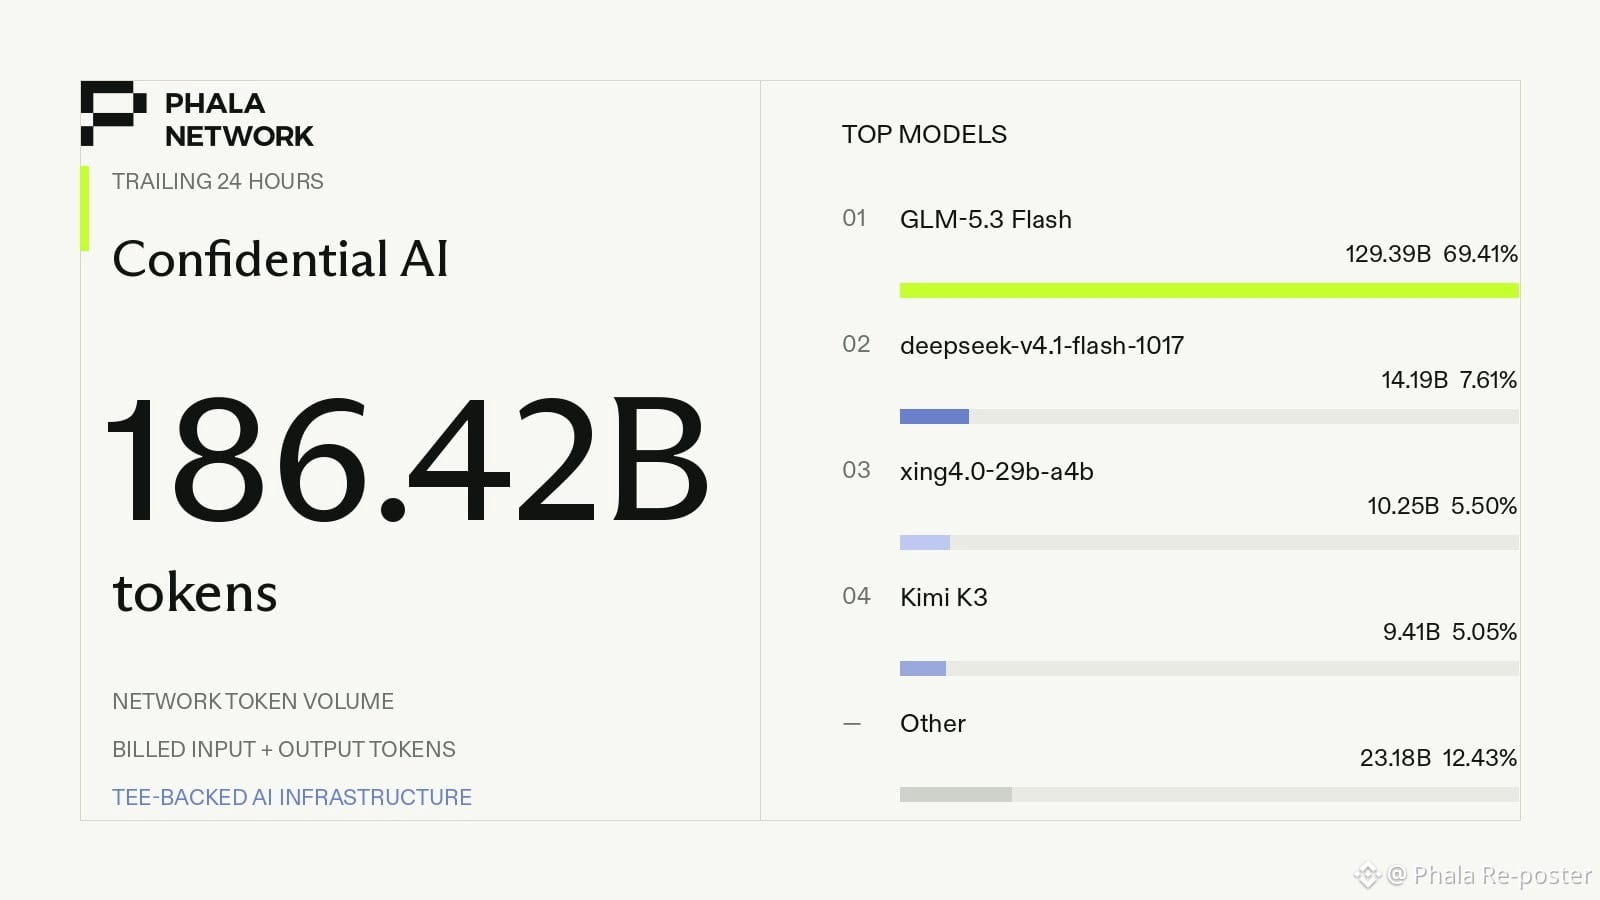
Dank einer robusten, TEE-gestützten KI-Infrastruktur hat Phala Confidential AI in den vergangenen 24 Stunden insgesamt 186,42 Milliarden Tokens verarbeitet. Ein genauerer Blick auf die führenden Modelle zeigt, dass GLM-5.3 Flash mit einem Anteil von 69,41 % die meiste Aktivität verzeichnete. Das Modell deepseek-v4.1-flash-1017 folgte mit 7,61 %, während xing4.0-29b-a4b 5,50 % des Volumens ausmachte. Weitere Informationen zum führenden Modell finden Sie unter https://phala.com/models/z-ai/glm-5.3-flash
Dank einer robusten, TEE-gestützten KI-Infrastruktur hat Phala Confidential AI in den vergangenen 24 Stunden insgesamt 186,42 Milliarden Tokens verarbeitet. Ein genauerer Blick auf die führenden Modelle zeigt, dass GLM-5.3 Flash mit einem Anteil von 69,41 % die meiste Aktivität verzeichnete. Das Modell deepseek-v4.1-flash-1017 folgte mit 7,61 %, während xing4.0-29b-a4b 5,50 % des Volumens ausmachte. Weitere Informationen zum führenden Modell finden Sie unter https://phala.com/models/z-ai/glm-5.3-flash
78
Im Laufe der letzten 24 Stunden verarbeitete die TEE-gestützte KI-Infrastruktur von Phala Confidential AI insgesamt 186,26 Milliarden Tokens. Eine Aufschlüsselung der führenden Modelle zeigt, dass GLM-5.3 Flash den Großteil dieser Aktivität ausmachte und 59,87 % der Nutzung auf sich vereinte. Es folgten Kimi K3 mit einem Anteil von 13,74 % und DeepSeek V4.1 Flash mit 9,13 % des Gesamtvolumens. Weitere Details finden Sie unter https://phala.com/models/z-ai/glm-5.3-flash.
Im Laufe der letzten 24 Stunden verarbeitete die TEE-gestützte KI-Infrastruktur von Phala Confidential AI insgesamt 186,26 Milliarden Tokens. Eine Aufschlüsselung der führenden Modelle zeigt, dass GLM-5.3 Flash den Großteil dieser Aktivität ausmachte und 59,87 % der Nutzung auf sich vereinte. Es folgten Kimi K3 mit einem Anteil von 13,74 % und DeepSeek V4.1 Flash mit 9,13 % des Gesamtvolumens. Weitere Details finden Sie unter https://phala.com/models/z-ai/glm-5.3-flash.
81
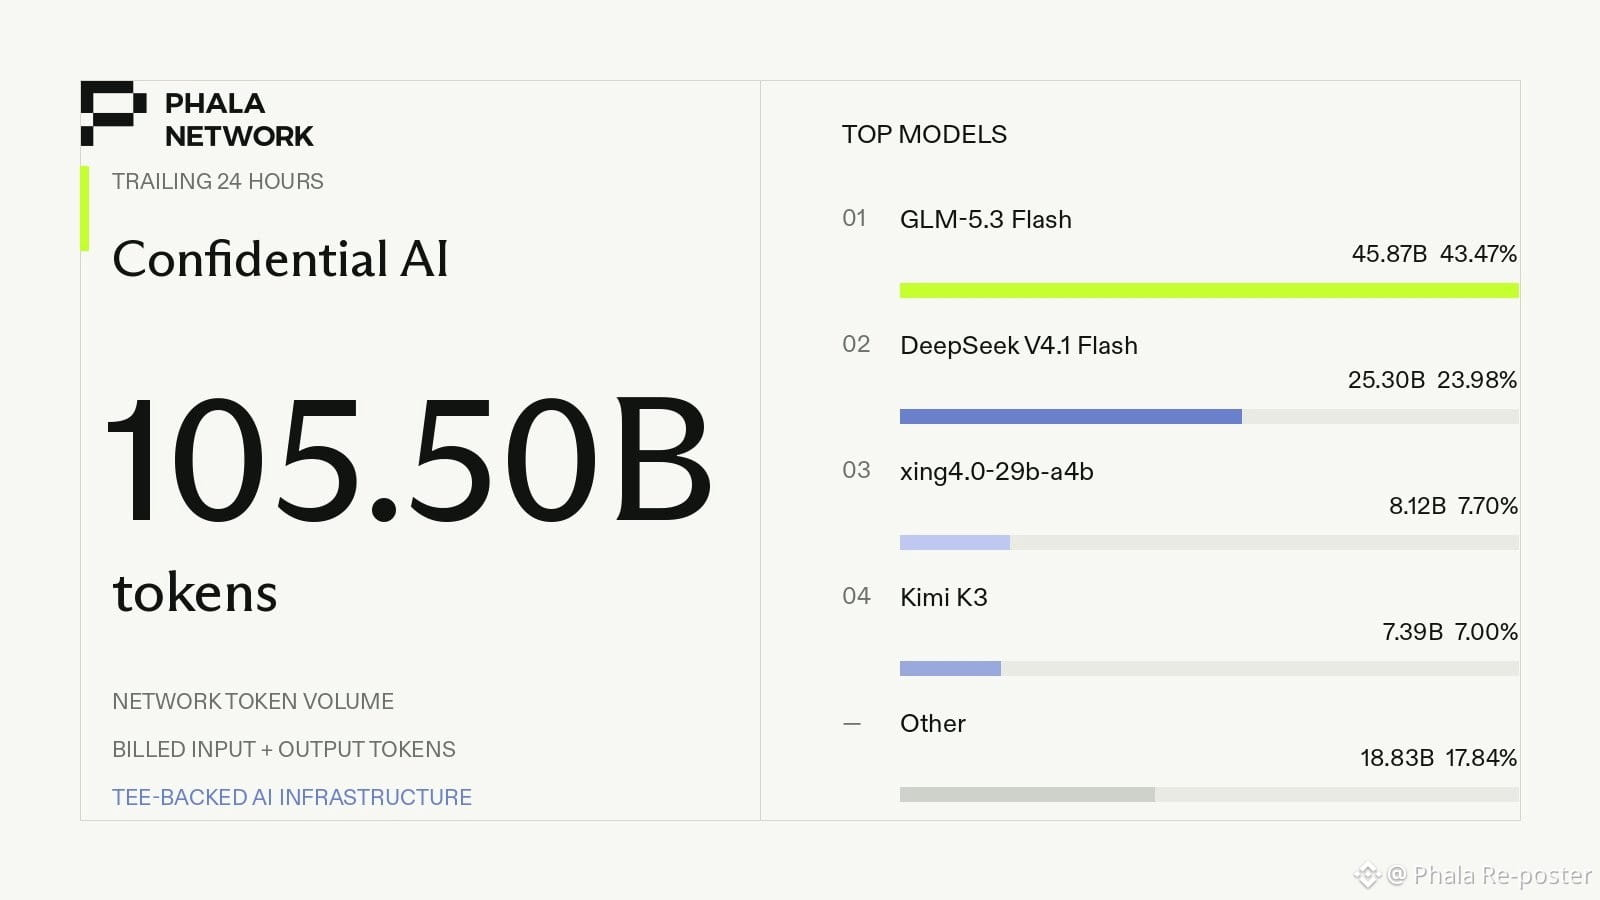
In den vergangenen 24 Stunden bewältigte Phala Confidential AI erfolgreich eine beeindruckende Arbeitslast von 105,50 Milliarden Tokens. Als sichere, durch eine TEE geschützte KI-Infrastruktur arbeitete die Plattform effizient und verzeichnete bei drei Hauptmodellen die höchste Nutzung. GLM-5.3 Flash lag mit 43,47 % des Gesamtvolumens an der Spitze. DeepSeek V4.1 Flash folgte mit einem Anteil von 23,98 %, während xing4.0-29b-a4b 7,70 % der Nutzung ausmachte. Weitere Details findest du unter https://phala.com/models/z-ai/glm-5.3-flash
In den vergangenen 24 Stunden bewältigte Phala Confidential AI erfolgreich eine beeindruckende Arbeitslast von 105,50 Milliarden Tokens. Als sichere, durch eine TEE geschützte KI-Infrastruktur arbeitete die Plattform effizient und verzeichnete bei drei Hauptmodellen die höchste Nutzung. GLM-5.3 Flash lag mit 43,47 % des Gesamtvolumens an der Spitze. DeepSeek V4.1 Flash folgte mit einem Anteil von 23,98 %, während xing4.0-29b-a4b 7,70 % der Nutzung ausmachte. Weitere Details findest du unter https://phala.com/models/z-ai/glm-5.3-flash
60
DeepSeek V4.1 Flash 1017 ist jetzt offiziell über Phala für Nutzer verfügbar. Für ein optimales Maß an Sicherheit läuft das System vollständig in einer TDX-attestierten GPU-TEE. Diese Integration gewährleistet überprüfbare und private Inferenz und macht das Modell zu einer ausgezeichneten Ressource für Anwendungen mit Schwerpunkt auf visuellem Verständnis, komplexem Schlussfolgern und dem Betrieb von Agenten mit langfristigem Planungshorizont. Entdecken und nutzen Sie diese neue Version direkt unter https://phala.com/models/deepseek/deepseek-v4.1-flash-1017.
DeepSeek V4.1 Flash 1017 ist jetzt offiziell über Phala für Nutzer verfügbar. Für ein optimales Maß an Sicherheit läuft das System vollständig in einer TDX-attestierten GPU-TEE. Diese Integration gewährleistet überprüfbare und private Inferenz und macht das Modell zu einer ausgezeichneten Ressource für Anwendungen mit Schwerpunkt auf visuellem Verständnis, komplexem Schlussfolgern und dem Betrieb von Agenten mit langfristigem Planungshorizont. Entdecken und nutzen Sie diese neue Version direkt unter https://phala.com/models/deepseek/deepseek-v4.1-flash-1017.
73
In den vergangenen 24 Stunden hat die TEE-gestützte KI-Infrastruktur von Phala Confidential AI insgesamt 81,33 Milliarden Tokens erfolgreich verarbeitet. Eine Analyse der beliebtesten Modelle zeigt, dass DeepSeek V4.1 Flash mit einem Anteil von 56,30 % an der Gesamtnutzung an der Spitze liegt. Das Modell xing4.0-29b-a4b folgt mit einem Anteil von 12,22 %, während qwen3.8-27b 9,39 % des Volumens ausmacht. Weitere Informationen zu unserem meistgenutzten Modell finden Sie unter https://phala.com/models/deepseek/deepseek-v4.1-flash.
In den vergangenen 24 Stunden hat die TEE-gestützte KI-Infrastruktur von Phala Confidential AI insgesamt 81,33 Milliarden Tokens erfolgreich verarbeitet. Eine Analyse der beliebtesten Modelle zeigt, dass DeepSeek V4.1 Flash mit einem Anteil von 56,30 % an der Gesamtnutzung an der Spitze liegt. Das Modell xing4.0-29b-a4b folgt mit einem Anteil von 12,22 %, während qwen3.8-27b 9,39 % des Volumens ausmacht. Weitere Informationen zu unserem meistgenutzten Modell finden Sie unter https://phala.com/models/deepseek/deepseek-v4.1-flash.
84
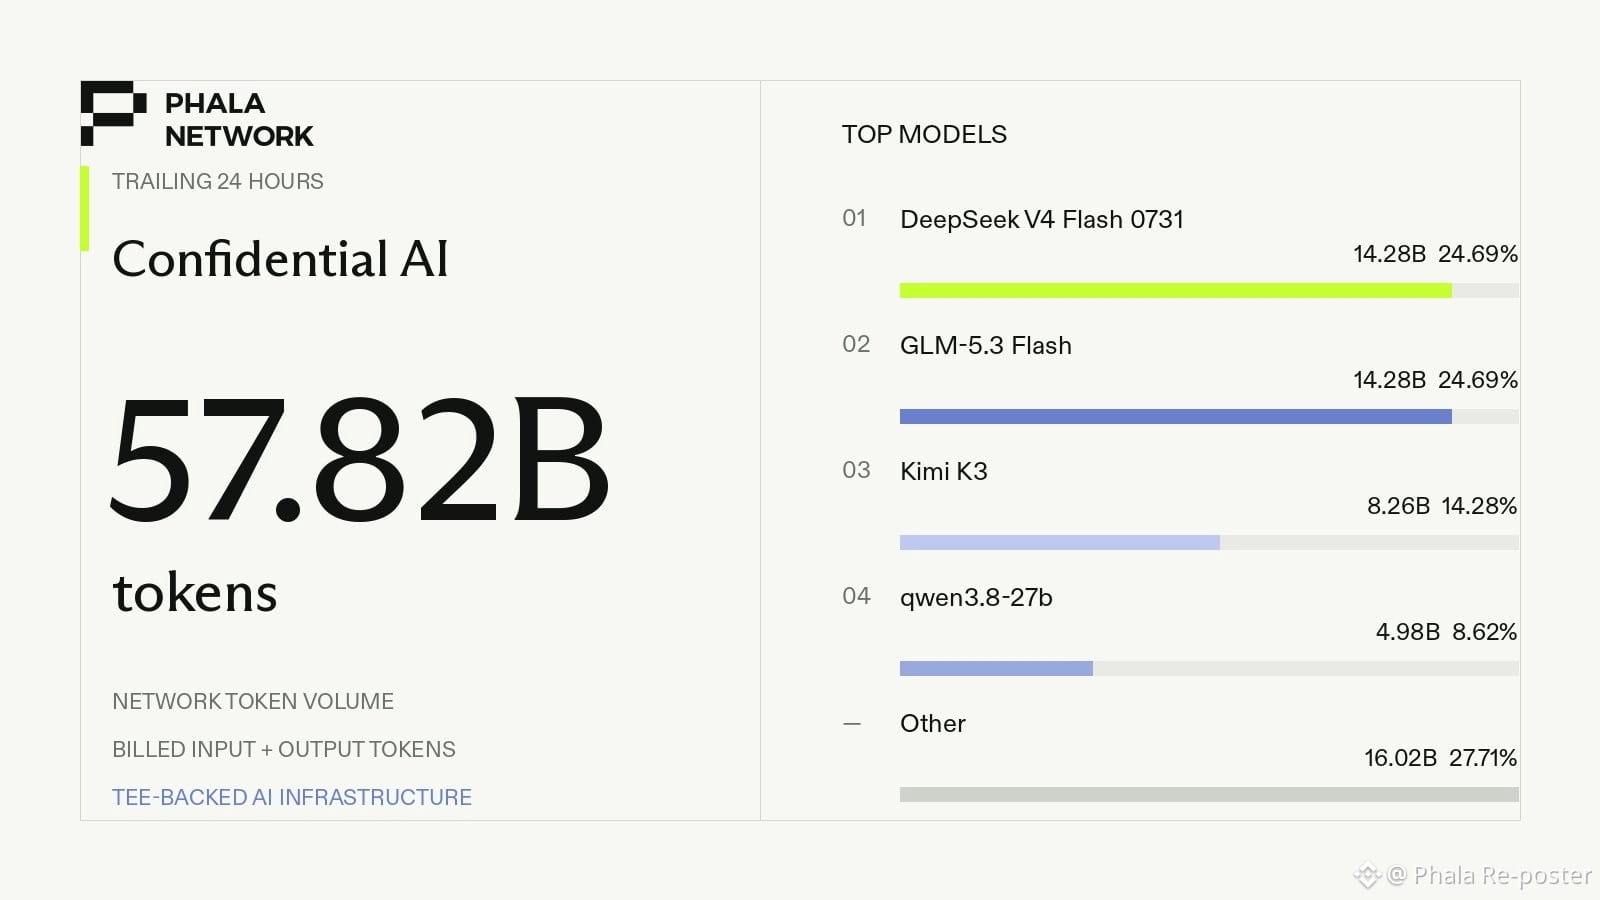
In den letzten 24 Stunden verarbeitete die vertrauliche KI-Plattform Phala insgesamt 57,82 Milliarden Tokens. Das auf einer TEE-gestützten KI-Infrastruktur basierende System verdankte seine Aktivität vor allem drei führenden Modellen. DeepSeek V4 Flash 0731 und GLM-5.3 Flash lagen bei der Nutzung gleichauf an der Spitze und trugen jeweils 24,69 Prozent zur Gesamtverteilung bei. Kimi K3 folgte dicht dahinter mit einem Anteil von 14,28 Prozent. Weitere Details finden Sie direkt unter https://phala.com/models/deepseek/deepseek-v4-flash-0731.
In den letzten 24 Stunden verarbeitete die vertrauliche KI-Plattform Phala insgesamt 57,82 Milliarden Tokens. Das auf einer TEE-gestützten KI-Infrastruktur basierende System verdankte seine Aktivität vor allem drei führenden Modellen. DeepSeek V4 Flash 0731 und GLM-5.3 Flash lagen bei der Nutzung gleichauf an der Spitze und trugen jeweils 24,69 Prozent zur Gesamtverteilung bei. Kimi K3 folgte dicht dahinter mit einem Anteil von 14,28 Prozent. Weitere Details finden Sie direkt unter https://phala.com/models/deepseek/deepseek-v4-flash-0731.
101
Die Entscheidungen, die Agenten treffen, beinhalten häufig den Umgang mit Kundennachrichten, Richtliniendokumenten und Freigabestatus. Wir freuen uns, bekannt zu geben, dass Kev-4B derzeit in der Beta auf Phala verfügbar ist und NVIDIA Confidential Computing nutzt. Hier kannst du es ausprobieren:
https://phala.com/models/jaredpalmer/kev-4b
Die Entscheidungen, die Agenten treffen, beinhalten häufig den Umgang mit Kundennachrichten, Richtliniendokumenten und Freigabestatus. Wir freuen uns, bekannt zu geben, dass Kev-4B derzeit in der Beta auf Phala verfügbar ist und NVIDIA Confidential Computing nutzt. Hier kannst du es ausprobieren:
https://phala.com/models/jaredpalmer/kev-4b
https://phala.com/models/jaredpalmer/kev-4b
82
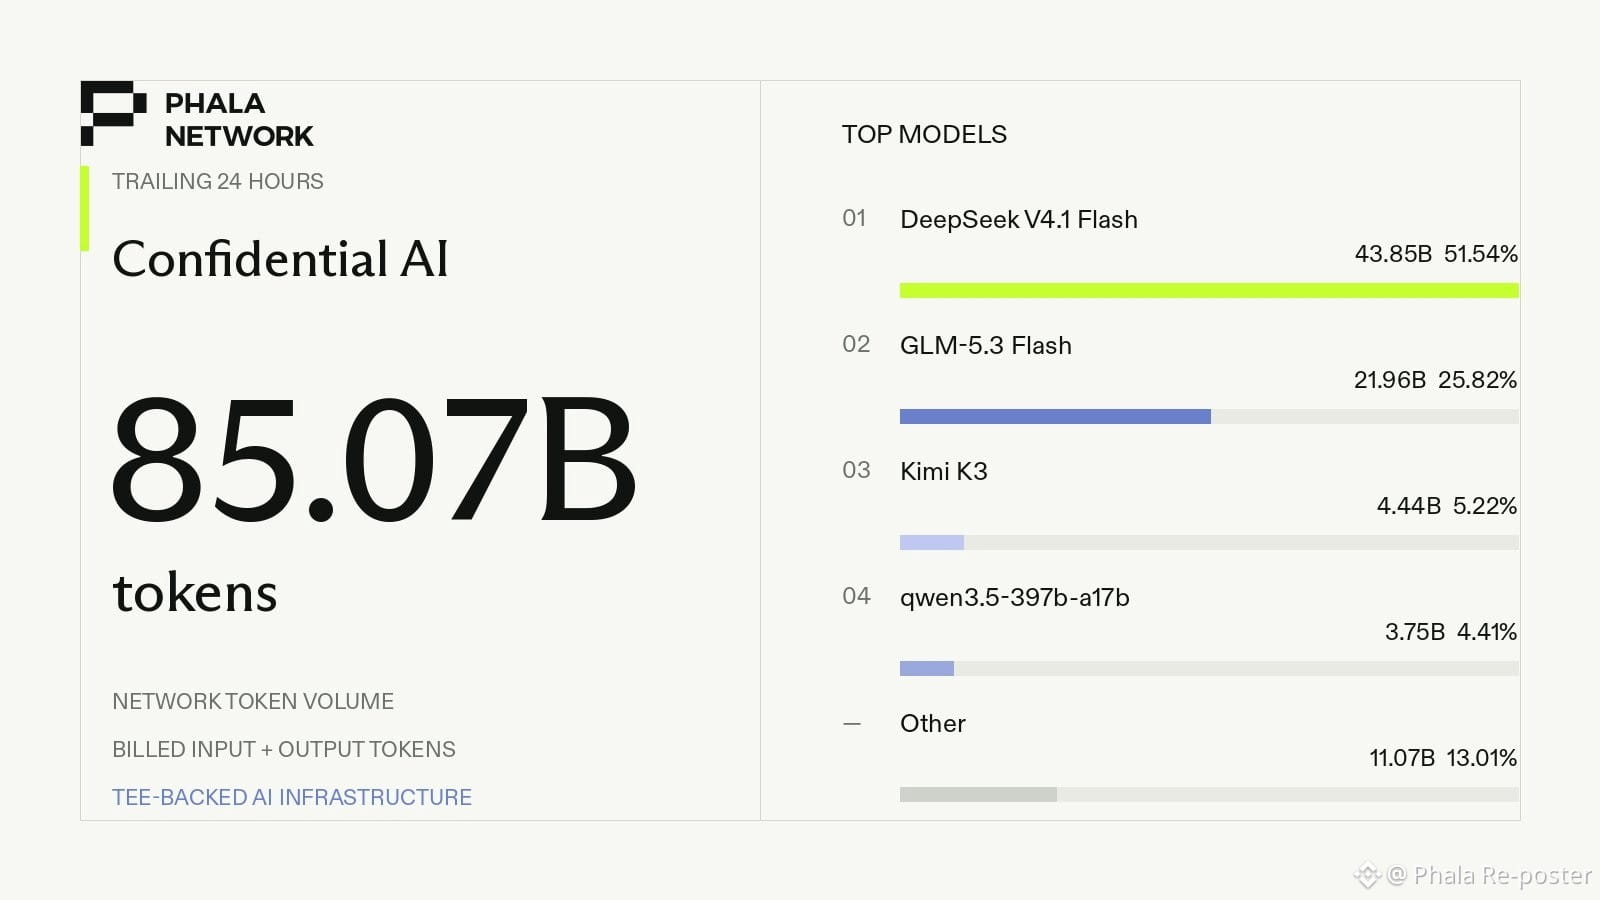
In den letzten 24 Stunden hat unsere durch TEE abgesicherte KI-Infrastruktur bei Phala Confidential AI insgesamt 85,07 Milliarden Tokens verarbeitet. Wir freuen uns, die Aufschlüsselung der meistgenutzten Modelle in diesem Zeitraum zu teilen. DeepSeek V4.1 Flash lag mit einem Anteil von 51,54 % an der gesamten Aktivität vorn. GLM-5.3 Flash folgte mit einem Anteil von 25,82 %, während Kimi K3 5,22 % der Nutzung ausmachte. Weitere Informationen zu unserem führenden Modell finden Sie unter https://phala.com/models/deepseek/deepseek-v4.1-flash
In den letzten 24 Stunden hat unsere durch TEE abgesicherte KI-Infrastruktur bei Phala Confidential AI insgesamt 85,07 Milliarden Tokens verarbeitet. Wir freuen uns, die Aufschlüsselung der meistgenutzten Modelle in diesem Zeitraum zu teilen. DeepSeek V4.1 Flash lag mit einem Anteil von 51,54 % an der gesamten Aktivität vorn. GLM-5.3 Flash folgte mit einem Anteil von 25,82 %, während Kimi K3 5,22 % der Nutzung ausmachte. Weitere Informationen zu unserem führenden Modell finden Sie unter https://phala.com/models/deepseek/deepseek-v4.1-flash
58
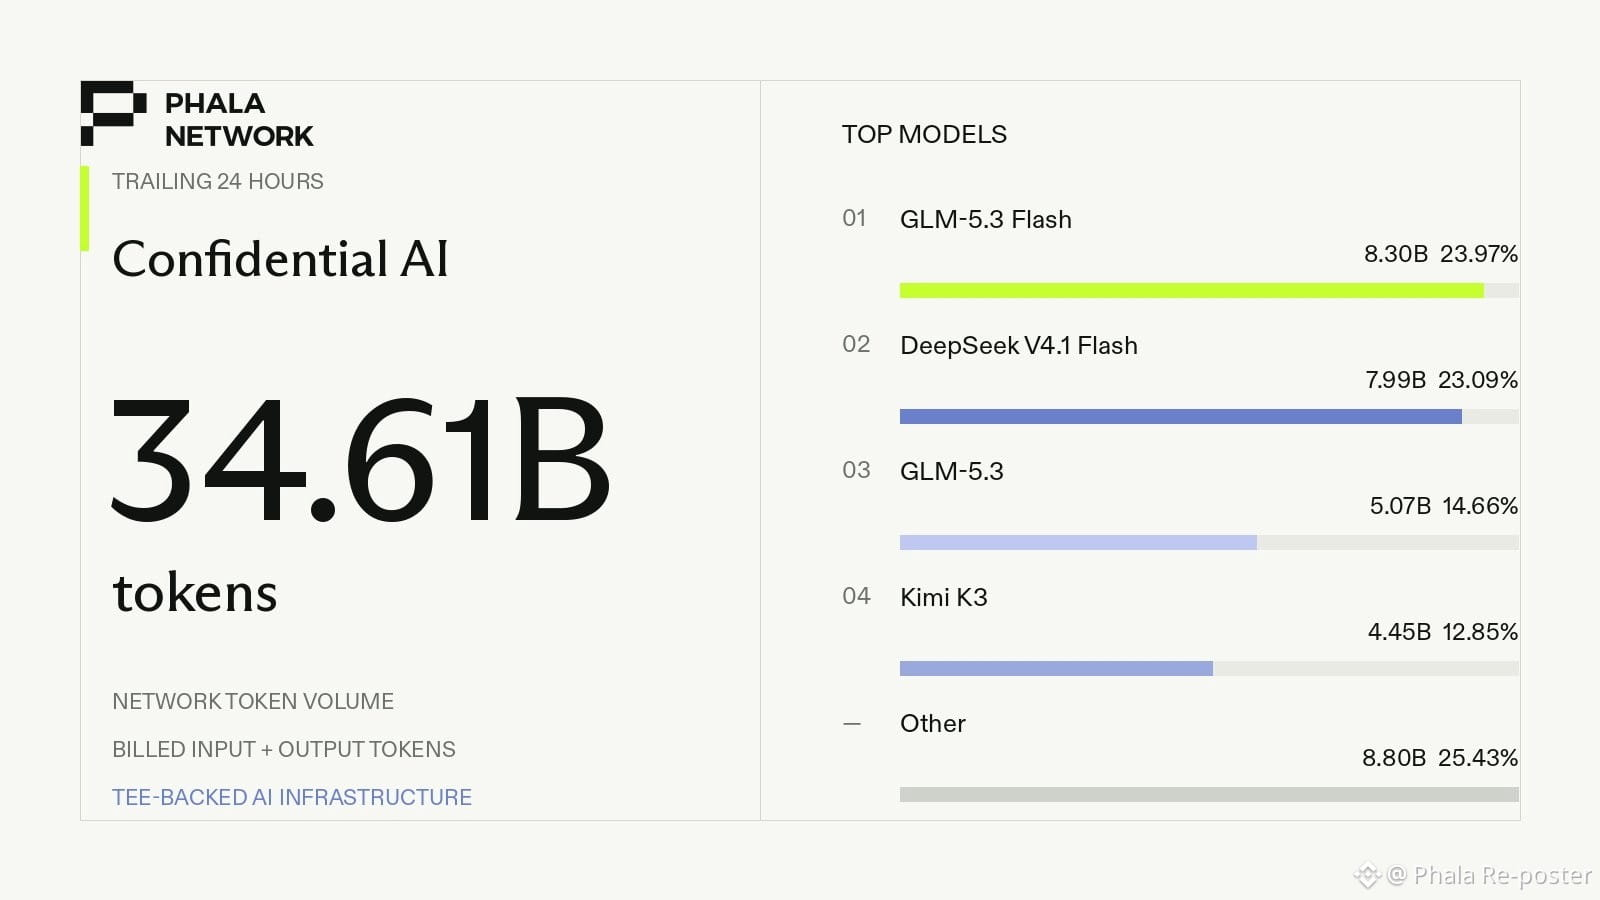
In den letzten 24 Stunden verarbeitete die TEE-gestützte KI-Infrastruktur Phala Confidential AI insgesamt 34,61 Milliarden Token.
Die Aktivität wurde in diesem Zeitraum hauptsächlich von drei Modellen getragen. Am häufigsten kam GLM-5.3 Flash zum Einsatz, das 23,97 % des Gesamtvolumens ausmachte. Dicht dahinter folgte DeepSeek V4.1 Flash mit einem Anteil von 23,09 %, während das Standardmodell GLM-5.3 14,66 % der Nutzung ausmachte.
Weitere Informationen zum meistgenutzten Modell finden Sie direkt unter https://phala.com/models/z-ai/glm-5.3-flash.
In den letzten 24 Stunden verarbeitete die TEE-gestützte KI-Infrastruktur Phala Confidential AI insgesamt 34,61 Milliarden Token.
Die Aktivität wurde in diesem Zeitraum hauptsächlich von drei Modellen getragen. Am häufigsten kam GLM-5.3 Flash zum Einsatz, das 23,97 % des Gesamtvolumens ausmachte. Dicht dahinter folgte DeepSeek V4.1 Flash mit einem Anteil von 23,09 %, während das Standardmodell GLM-5.3 14,66 % der Nutzung ausmachte.
Weitere Informationen zum meistgenutzten Modell finden Sie direkt unter https://phala.com/models/z-ai/glm-5.3-flash.
Die Aktivität wurde in diesem Zeitraum hauptsächlich von drei Modellen getragen. Am häufigsten kam GLM-5.3 Flash zum Einsatz, das 23,97 % des Gesamtvolumens ausmachte. Dicht dahinter folgte DeepSeek V4.1 Flash mit einem Anteil von 23,09 %, während das Standardmodell GLM-5.3 14,66 % der Nutzung ausmachte.
Weitere Informationen zum meistgenutzten Modell finden Sie direkt unter https://phala.com/models/z-ai/glm-5.3-flash.
77
Da Ihr Coding-Agent in der Lage ist, Ihre gesamte Codebasis zu durchsuchen, ist es wichtig, diese Informationen sicher aufzubewahren. Bevor irgendein Teil dieses Kontexts Ihren Computer verlassen darf, greift Private AI Proxy ein, um den KI-Dienst zu authentifizieren. Die Software garantiert diesen Schutz durch Fail-Closed-Weiterleitung, Hardware-Validierung und TLS-Key-Pinning.
Sie können die Mac-Version noch heute über den folgenden Link herunterladen:
https://apps.apple.com/app/private-ai-proxy/id6814051406
Da Ihr Coding-Agent in der Lage ist, Ihre gesamte Codebasis zu durchsuchen, ist es wichtig, diese Informationen sicher aufzubewahren. Bevor irgendein Teil dieses Kontexts Ihren Computer verlassen darf, greift Private AI Proxy ein, um den KI-Dienst zu authentifizieren. Die Software garantiert diesen Schutz durch Fail-Closed-Weiterleitung, Hardware-Validierung und TLS-Key-Pinning.
Sie können die Mac-Version noch heute über den folgenden Link herunterladen:
https://apps.apple.com/app/private-ai-proxy/id6814051406
Sie können die Mac-Version noch heute über den folgenden Link herunterladen:
https://apps.apple.com/app/private-ai-proxy/id6814051406
74
Bitte beachten Sie, dass sich der offizielle Einladungslink für unseren Discord-Server kürzlich geändert hat. Unsere vorherige URL, nämlich https://discord.com/invite/phala-network, ist nun abgelaufen und wird nicht mehr funktionieren. Wir bitten alle, ab sofort unsere neu generierte Adresse zu verwenden, um der Community beizutreten: https://discord.gg/saGuzKq5Wm.
Die Einträge bei CoinMarketCap und CoinGecko werden diese Aktualisierung in Kürze widerspiegeln. Während diese Änderungen vorgenommen werden, bitten wir Sie, weiterhin wachsam zu bleiben und sich vor möglichen Betrugsmaschen zu schützen. Vergewissern Sie sich stets, dass Sie keine betrügerischen URLs aufrufen.
Bitte beachten Sie, dass sich der offizielle Einladungslink für unseren Discord-Server kürzlich geändert hat. Unsere vorherige URL, nämlich https://discord.com/invite/phala-network, ist nun abgelaufen und wird nicht mehr funktionieren. Wir bitten alle, ab sofort unsere neu generierte Adresse zu verwenden, um der Community beizutreten: https://discord.gg/saGuzKq5Wm.
Die Einträge bei CoinMarketCap und CoinGecko werden diese Aktualisierung in Kürze widerspiegeln. Während diese Änderungen vorgenommen werden, bitten wir Sie, weiterhin wachsam zu bleiben und sich vor möglichen Betrugsmaschen zu schützen. Vergewissern Sie sich stets, dass Sie keine betrügerischen URLs aufrufen.
Die Einträge bei CoinMarketCap und CoinGecko werden diese Aktualisierung in Kürze widerspiegeln. Während diese Änderungen vorgenommen werden, bitten wir Sie, weiterhin wachsam zu bleiben und sich vor möglichen Betrugsmaschen zu schützen. Vergewissern Sie sich stets, dass Sie keine betrügerischen URLs aufrufen.
66
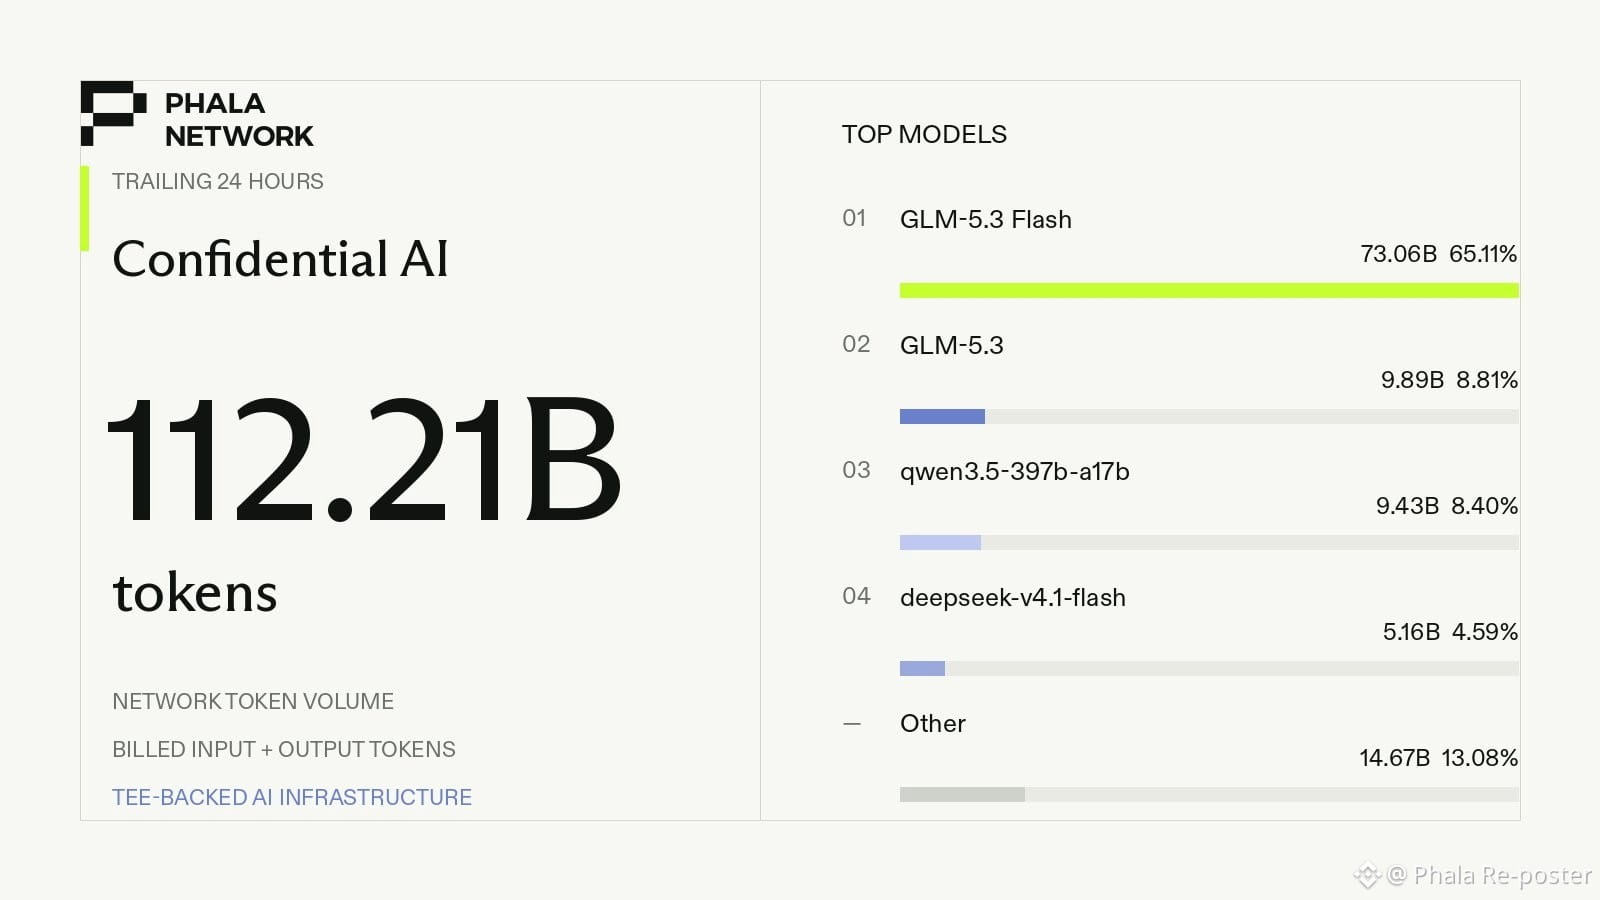
In den letzten 24 Stunden hat das Phala Confidential AI-Netzwerk erfolgreich eine beeindruckende Menge von 112,21 Milliarden Tokens verarbeitet. In diesem Zeitraum stachen einige bestimmte Optionen als die am häufigsten genutzten Modelle hervor. Das Modell GLM-5.3 Flash führte die Aktivität an und übernahm 65,11 % des gesamten Volumens. Es folgte das Standardmodell GLM-5.3 mit 8,81 % sowie das Modell qwen3.5-397b-a17b, das sehr knapp dahinter bei 8,40 % lag.
Um das führende Modell genauer zu erkunden, können Sie https://phala.com/models/z-ai/glm-5.3-flash besuchen. Dieses gesamte Ökosystem basiert auf einer sicheren, von TEE gestützten KI-Infrastruktur und gewährleistet eine robuste und geschützte Umgebung für alle Nutzer.
In den letzten 24 Stunden hat das Phala Confidential AI-Netzwerk erfolgreich eine beeindruckende Menge von 112,21 Milliarden Tokens verarbeitet. In diesem Zeitraum stachen einige bestimmte Optionen als die am häufigsten genutzten Modelle hervor. Das Modell GLM-5.3 Flash führte die Aktivität an und übernahm 65,11 % des gesamten Volumens. Es folgte das Standardmodell GLM-5.3 mit 8,81 % sowie das Modell qwen3.5-397b-a17b, das sehr knapp dahinter bei 8,40 % lag.
Um das führende Modell genauer zu erkunden, können Sie https://phala.com/models/z-ai/glm-5.3-flash besuchen. Dieses gesamte Ökosystem basiert auf einer sicheren, von TEE gestützten KI-Infrastruktur und gewährleistet eine robuste und geschützte Umgebung für alle Nutzer.
Um das führende Modell genauer zu erkunden, können Sie https://phala.com/models/z-ai/glm-5.3-flash besuchen. Dieses gesamte Ökosystem basiert auf einer sicheren, von TEE gestützten KI-Infrastruktur und gewährleistet eine robuste und geschützte Umgebung für alle Nutzer.
80
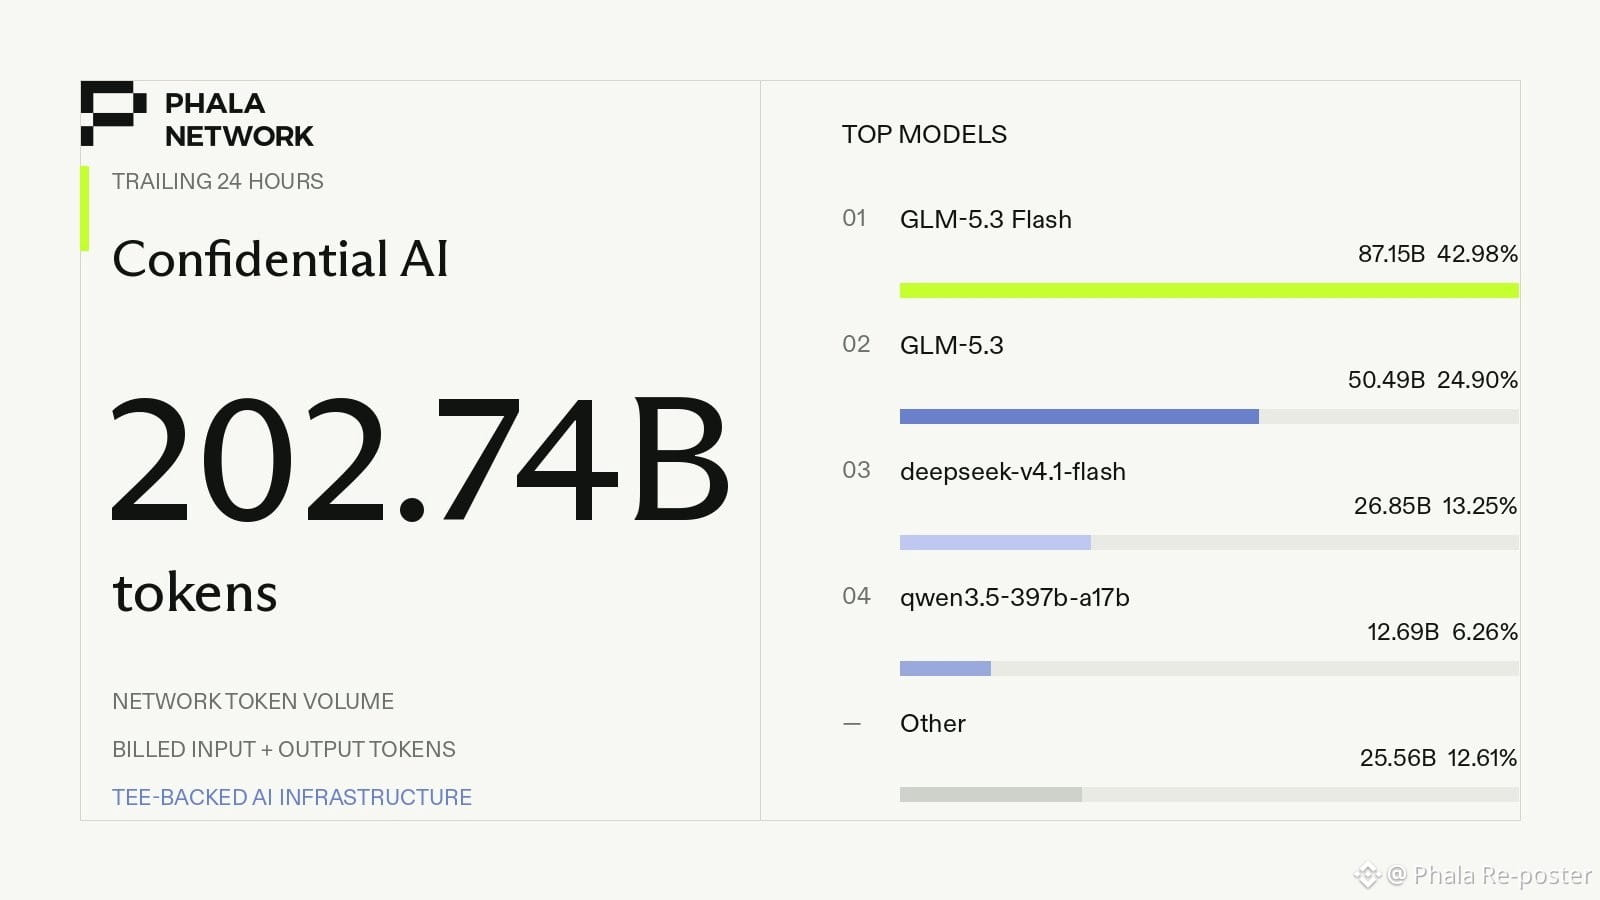
Aufgebaut auf einer robusten TEE-gestützten KI-Infrastruktur hat Phala Confidential AI erfolgreich beeindruckende 202,74 Milliarden Tokens innerhalb der letzten 24 Stunden verarbeitet.
Eine Aufschlüsselung dieser jüngsten Aktivität zeigt die beliebtesten Modelle, die in diesem Zeitraum eingesetzt wurden. An erster Stelle steht GLM-5.3 Flash, das 42,98% des Gesamtvolumens ausmachte. Das Modell GLM-5.3 folgte dicht dahinter mit einem Anteil von 24,90%, während deepseek-v4.1-flash 13,25% der Nutzung auf sich vereinte.
Weitere Informationen finden Sie direkt unter diesem Link:
https://phala.com/models/z-ai/glm-5.3-flash
Aufgebaut auf einer robusten TEE-gestützten KI-Infrastruktur hat Phala Confidential AI erfolgreich beeindruckende 202,74 Milliarden Tokens innerhalb der letzten 24 Stunden verarbeitet.
Eine Aufschlüsselung dieser jüngsten Aktivität zeigt die beliebtesten Modelle, die in diesem Zeitraum eingesetzt wurden. An erster Stelle steht GLM-5.3 Flash, das 42,98% des Gesamtvolumens ausmachte. Das Modell GLM-5.3 folgte dicht dahinter mit einem Anteil von 24,90%, während deepseek-v4.1-flash 13,25% der Nutzung auf sich vereinte.
Weitere Informationen finden Sie direkt unter diesem Link:
https://phala.com/models/z-ai/glm-5.3-flash
Eine Aufschlüsselung dieser jüngsten Aktivität zeigt die beliebtesten Modelle, die in diesem Zeitraum eingesetzt wurden. An erster Stelle steht GLM-5.3 Flash, das 42,98% des Gesamtvolumens ausmachte. Das Modell GLM-5.3 folgte dicht dahinter mit einem Anteil von 24,90%, während deepseek-v4.1-flash 13,25% der Nutzung auf sich vereinte.
Weitere Informationen finden Sie direkt unter diesem Link:
https://phala.com/models/z-ai/glm-5.3-flash
60
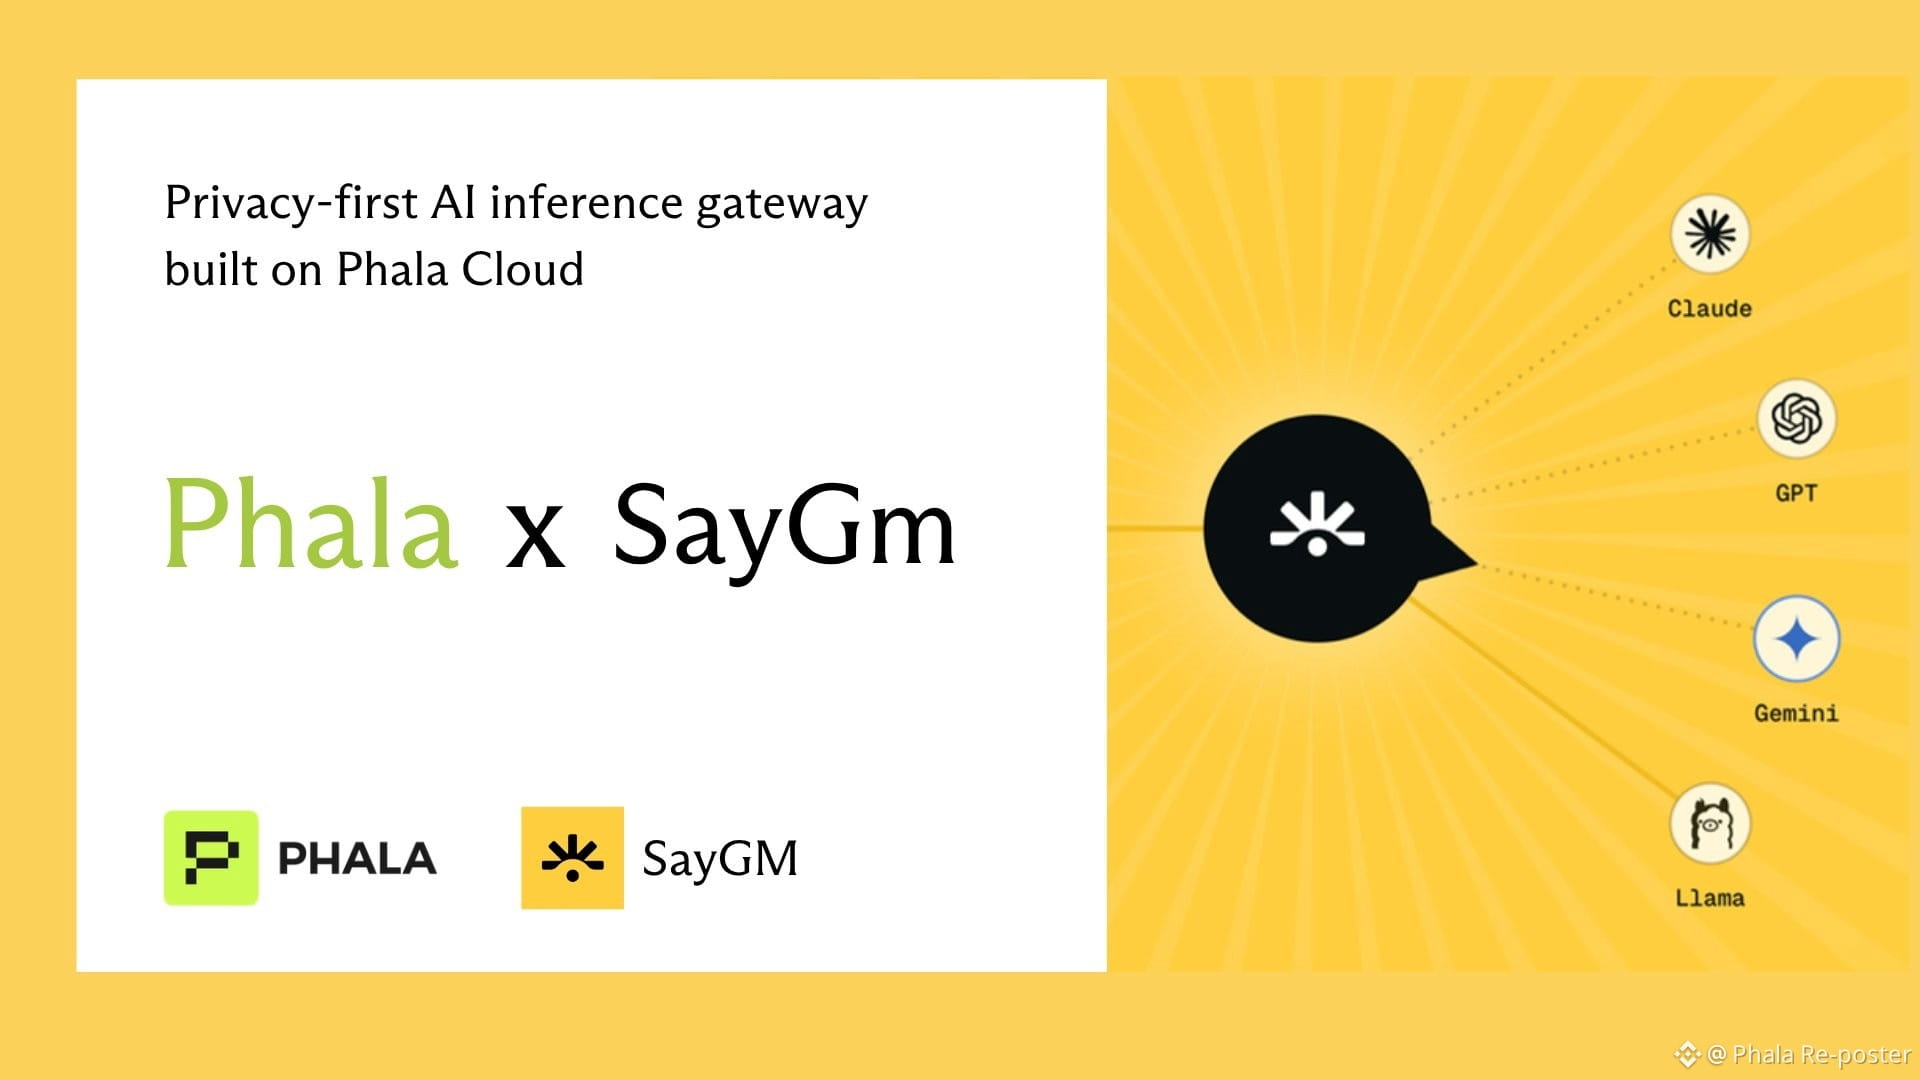
1/ SayGM wählte Phala Cloud als Grundlage, um sein datenschutzorientiertes KI-Inferenz-Gateway aufzubauen.
Um jede eingehende Anfrage zu verarbeiten, leitet das System sie direkt über ein hardware-autorisiertes vertrauliches VM. Da diese virtuelle Maschine ausschließlich auf ein genehmigtes und festes Image zugreift, bleibt die zugrunde liegende Workload zu jeder einzelnen Anfrage vollständig und unabhängig nachprüfbar.
https://saygm.com
1/ SayGM wählte Phala Cloud als Grundlage, um sein datenschutzorientiertes KI-Inferenz-Gateway aufzubauen.
Um jede eingehende Anfrage zu verarbeiten, leitet das System sie direkt über ein hardware-autorisiertes vertrauliches VM. Da diese virtuelle Maschine ausschließlich auf ein genehmigtes und festes Image zugreift, bleibt die zugrunde liegende Workload zu jeder einzelnen Anfrage vollständig und unabhängig nachprüfbar.
https://saygm.com
Um jede eingehende Anfrage zu verarbeiten, leitet das System sie direkt über ein hardware-autorisiertes vertrauliches VM. Da diese virtuelle Maschine ausschließlich auf ein genehmigtes und festes Image zugreift, bleibt die zugrunde liegende Workload zu jeder einzelnen Anfrage vollständig und unabhängig nachprüfbar.
https://saygm.com
61
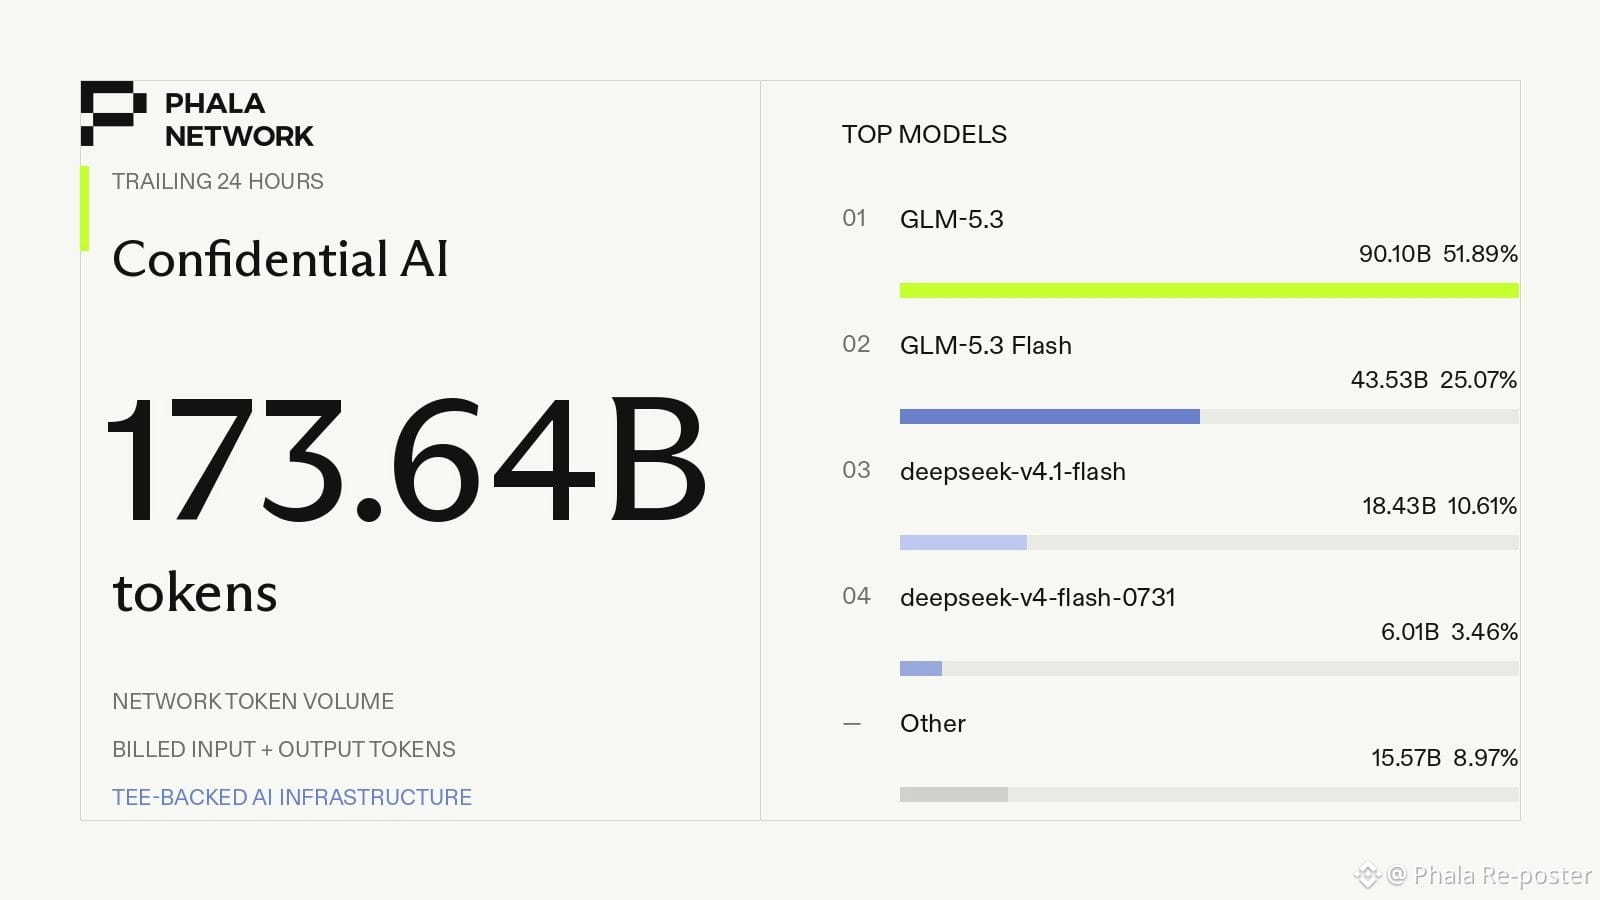
In den vergangenen 24 Stunden hat die TEE-gestützte KI-Infrastruktur bei Phala Confidential AI insgesamt 173,64 Milliarden Tokens erfolgreich verarbeitet. Ein genauerer Blick auf die leistungsstärksten Modelle zeigt, dass GLM-5.3 die Nutzung mit einem Anteil von 51,89% anführte. Danach folgte GLM-5.3 Flash, das 25,07% der Aktivitäten ausmachte, und deepseek-v4.1-flash, das 10,61% des Volumens stellte. Weitere Informationen finden Sie unter https://phala.com/models/z-ai/glm-5.3
In den vergangenen 24 Stunden hat die TEE-gestützte KI-Infrastruktur bei Phala Confidential AI insgesamt 173,64 Milliarden Tokens erfolgreich verarbeitet. Ein genauerer Blick auf die leistungsstärksten Modelle zeigt, dass GLM-5.3 die Nutzung mit einem Anteil von 51,89% anführte. Danach folgte GLM-5.3 Flash, das 25,07% der Aktivitäten ausmachte, und deepseek-v4.1-flash, das 10,61% des Volumens stellte. Weitere Informationen finden Sie unter https://phala.com/models/z-ai/glm-5.3
66
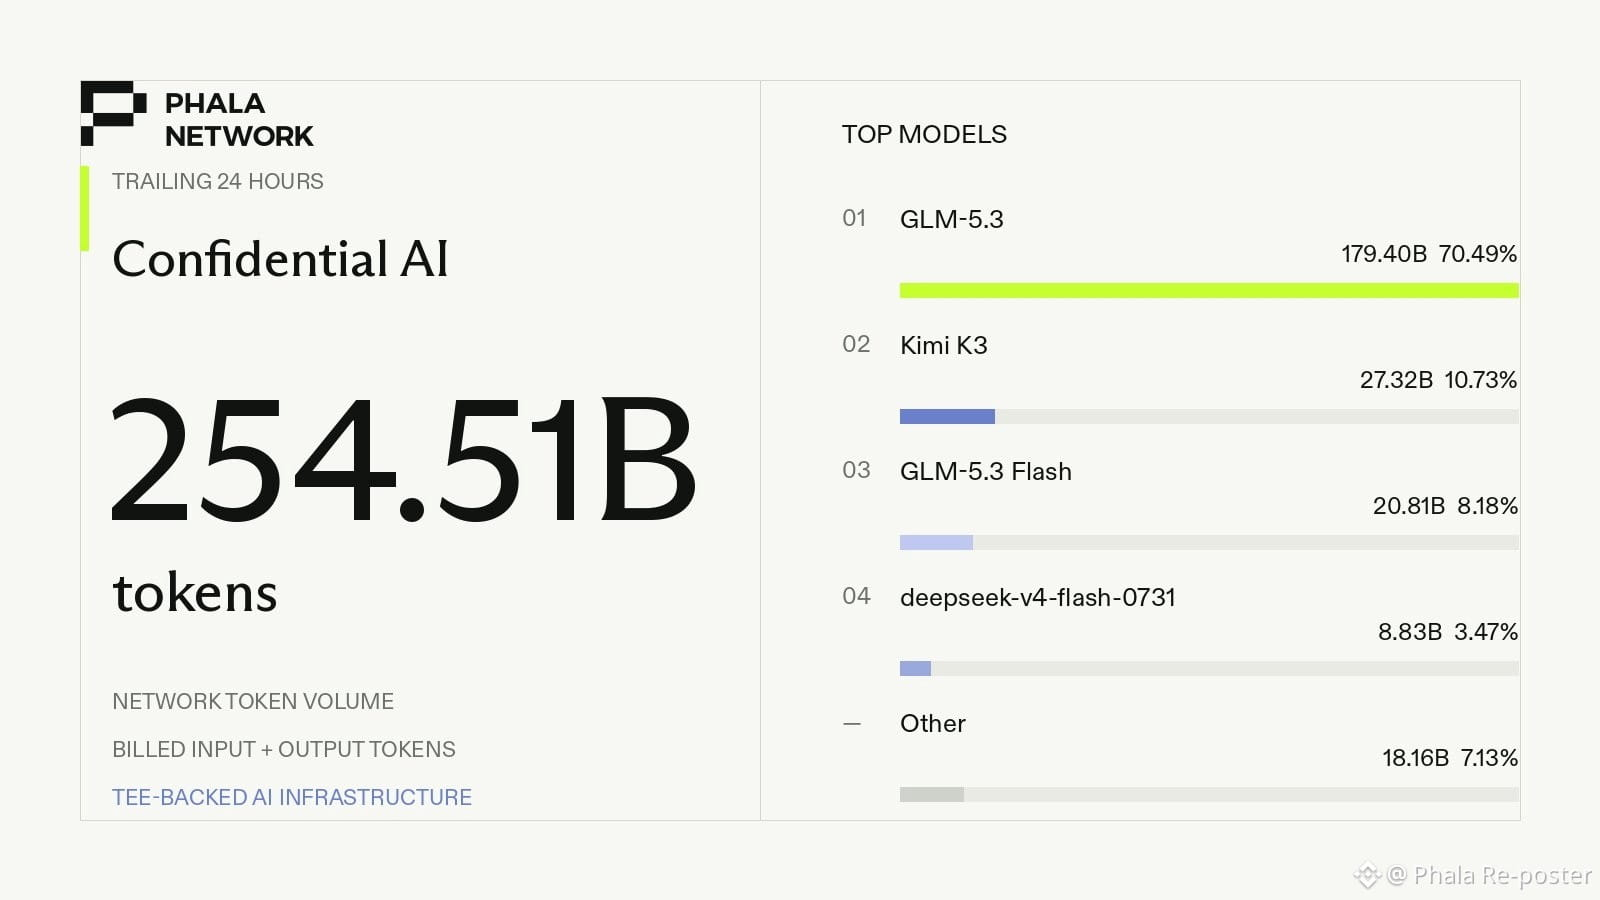
In den letzten 24 Stunden hat die von TEE gestützte KI-Infrastruktur bei Phala Confidential AI erfolgreich beeindruckende 254,51 Milliarden Tokens verarbeitet.
Bei der Betrachtung der in diesem Zeitraum am häufigsten verwendeten Modelle lag GLM-5.3 vorn und machte 70,49% des gesamten Volumens aus. Kimi K3 folgte auf dem zweiten Platz mit 10,73%, während GLM-5.3 Flash 8,18% der gesamten Nutzung ausmachte.
Um weiter zu erkunden, besuchen Sie bitte https://phala.com/models/z-ai/glm-5.3
In den letzten 24 Stunden hat die von TEE gestützte KI-Infrastruktur bei Phala Confidential AI erfolgreich beeindruckende 254,51 Milliarden Tokens verarbeitet.
Bei der Betrachtung der in diesem Zeitraum am häufigsten verwendeten Modelle lag GLM-5.3 vorn und machte 70,49% des gesamten Volumens aus. Kimi K3 folgte auf dem zweiten Platz mit 10,73%, während GLM-5.3 Flash 8,18% der gesamten Nutzung ausmachte.
Um weiter zu erkunden, besuchen Sie bitte https://phala.com/models/z-ai/glm-5.3
Bei der Betrachtung der in diesem Zeitraum am häufigsten verwendeten Modelle lag GLM-5.3 vorn und machte 70,49% des gesamten Volumens aus. Kimi K3 folgte auf dem zweiten Platz mit 10,73%, während GLM-5.3 Flash 8,18% der gesamten Nutzung ausmachte.
Um weiter zu erkunden, besuchen Sie bitte https://phala.com/models/z-ai/glm-5.3
59
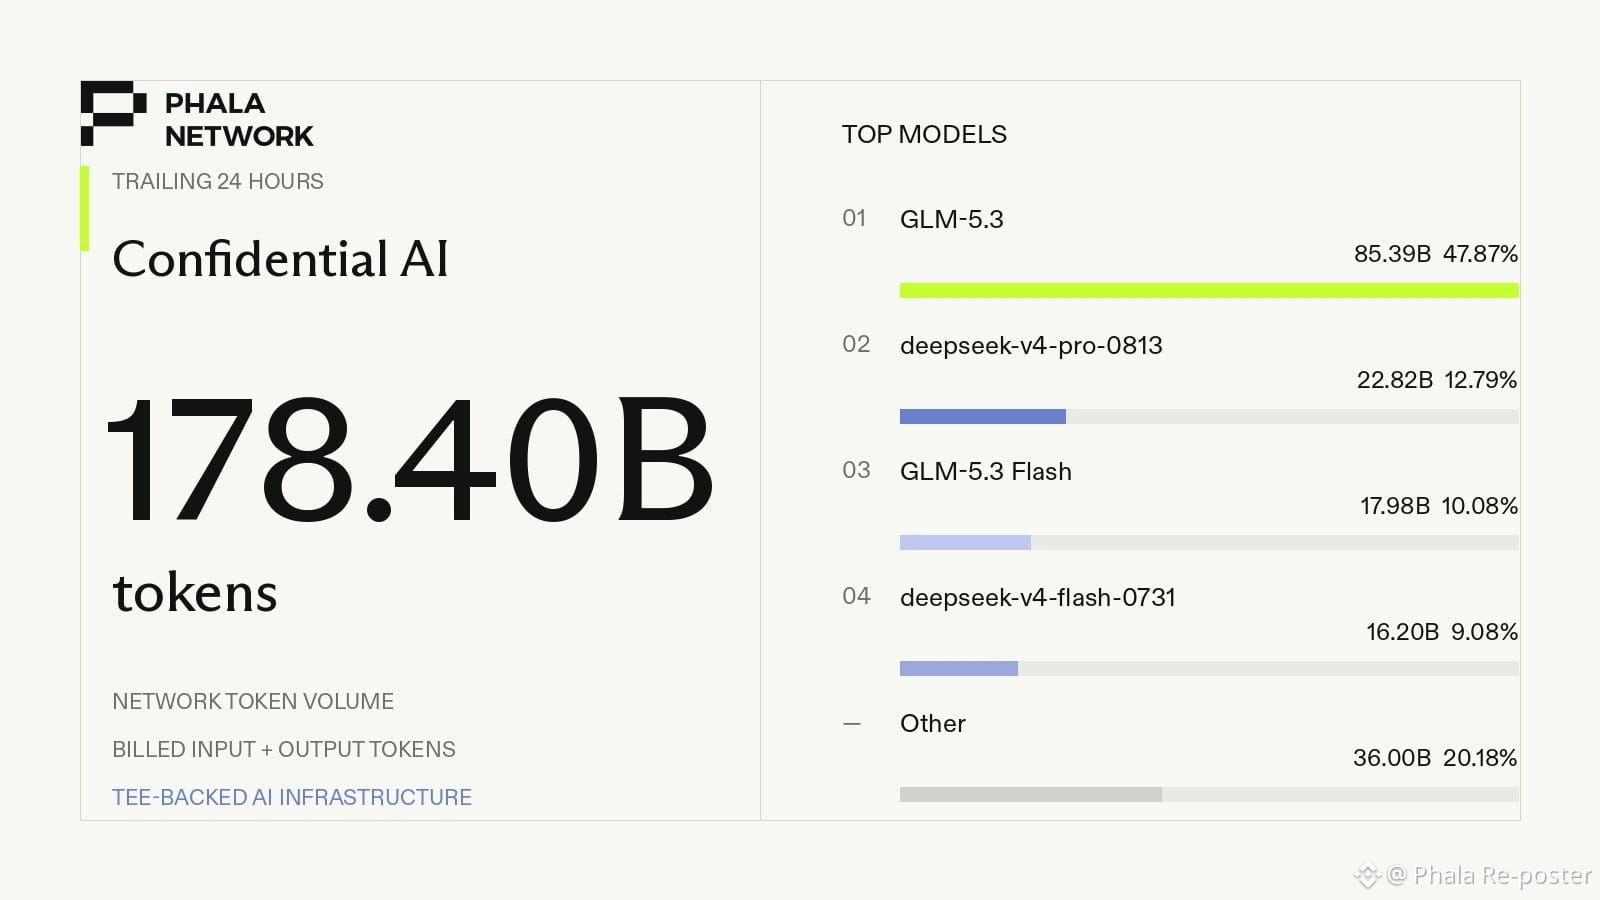
Während der letzten 24 Stunden hat Phala Confidential AI erfolgreich 178,40 Milliarden Token verarbeitet. Dieser Vorgang wird vollständig durch eine robuste, auf TEE basierende KI-Infrastruktur unterstützt. Eine Aufschlüsselung der am häufigsten genutzten Modelle in diesem Zeitraum zeigt, dass GLM-5.3 den ersten Platz belegte und 47,87% der Aktivität ausmachte. Das Modell deepseek-v4-pro-0813 folgte mit einem Anteil von 12,79%, während GLM-5.3 Flash 10,08% erfasste. Weitere Informationen finden Sie unter folgendem Link: https://phala.com/models/z-ai/glm-5.3
Während der letzten 24 Stunden hat Phala Confidential AI erfolgreich 178,40 Milliarden Token verarbeitet. Dieser Vorgang wird vollständig durch eine robuste, auf TEE basierende KI-Infrastruktur unterstützt. Eine Aufschlüsselung der am häufigsten genutzten Modelle in diesem Zeitraum zeigt, dass GLM-5.3 den ersten Platz belegte und 47,87% der Aktivität ausmachte. Das Modell deepseek-v4-pro-0813 folgte mit einem Anteil von 12,79%, während GLM-5.3 Flash 10,08% erfasste. Weitere Informationen finden Sie unter folgendem Link: https://phala.com/models/z-ai/glm-5.3
87
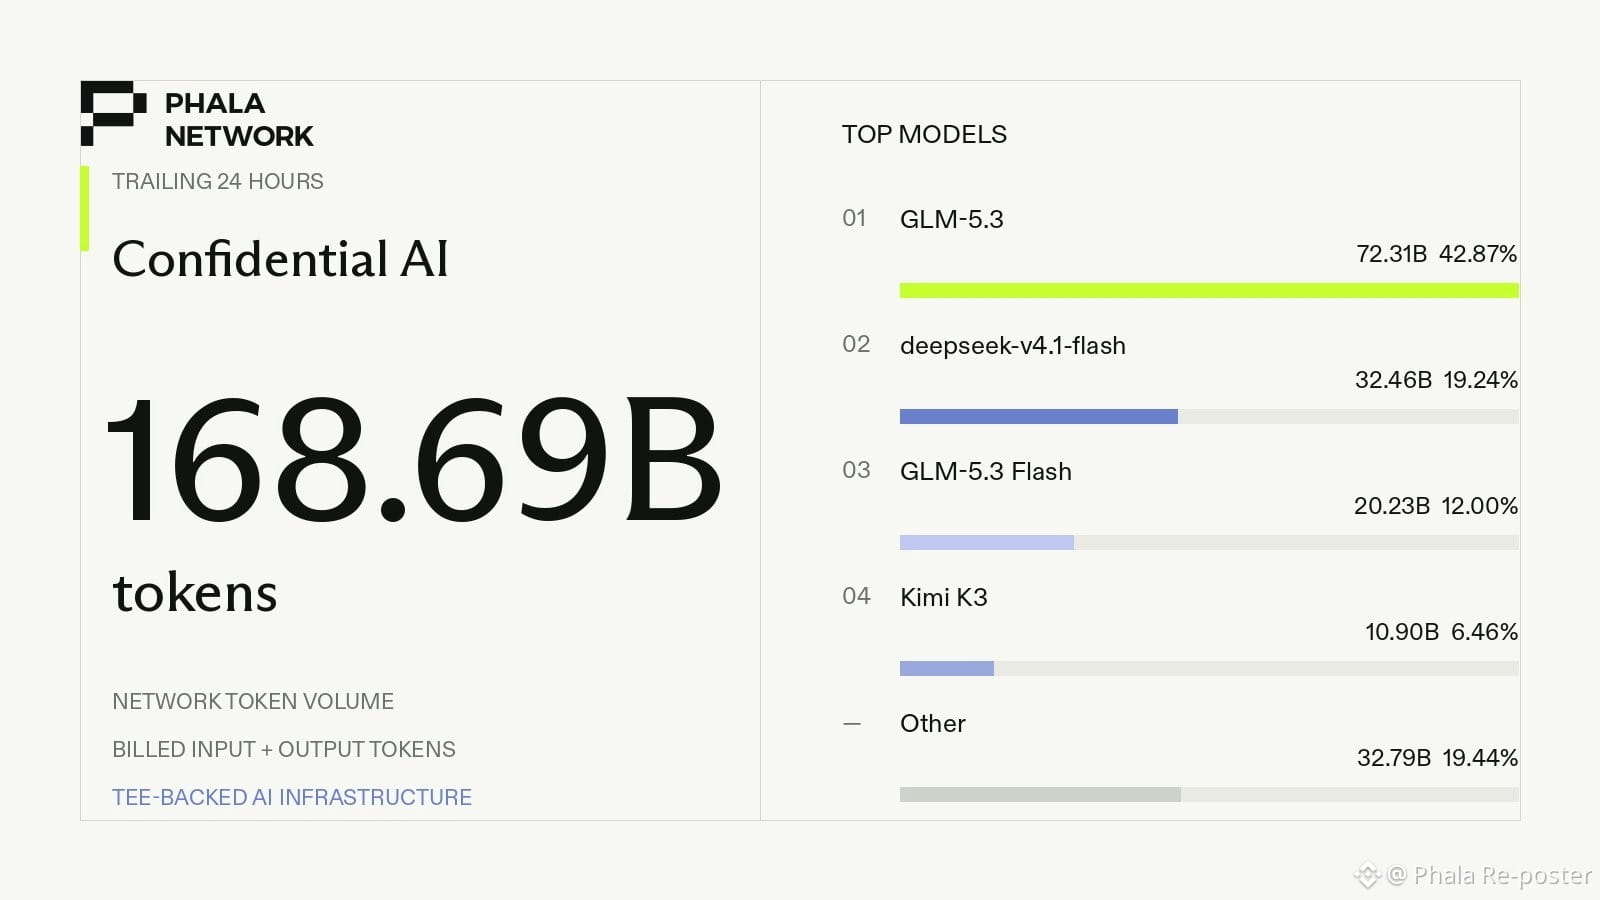
In den vergangenen 24 Stunden hat Phala Confidential AI insgesamt 168,69 Milliarden Tokens verarbeitet. Mit einer sicheren, auf TEE gestützten KI-Infrastruktur arbeitend, verzeichnete die Plattform die höchste Aktivität über drei zentrale Modelle hinweg. Den größten Anteil hatte GLM-5.3 mit 42,87%, gefolgt von deepseek-v4.1-flash mit 19,24% und GLM-5.3 Flash mit 12,00%. Weitere Details finden Sie unter https://phala.com/models/z-ai/glm-5.3.
In den vergangenen 24 Stunden hat Phala Confidential AI insgesamt 168,69 Milliarden Tokens verarbeitet. Mit einer sicheren, auf TEE gestützten KI-Infrastruktur arbeitend, verzeichnete die Plattform die höchste Aktivität über drei zentrale Modelle hinweg. Den größten Anteil hatte GLM-5.3 mit 42,87%, gefolgt von deepseek-v4.1-flash mit 19,24% und GLM-5.3 Flash mit 12,00%. Weitere Details finden Sie unter https://phala.com/models/z-ai/glm-5.3.
67
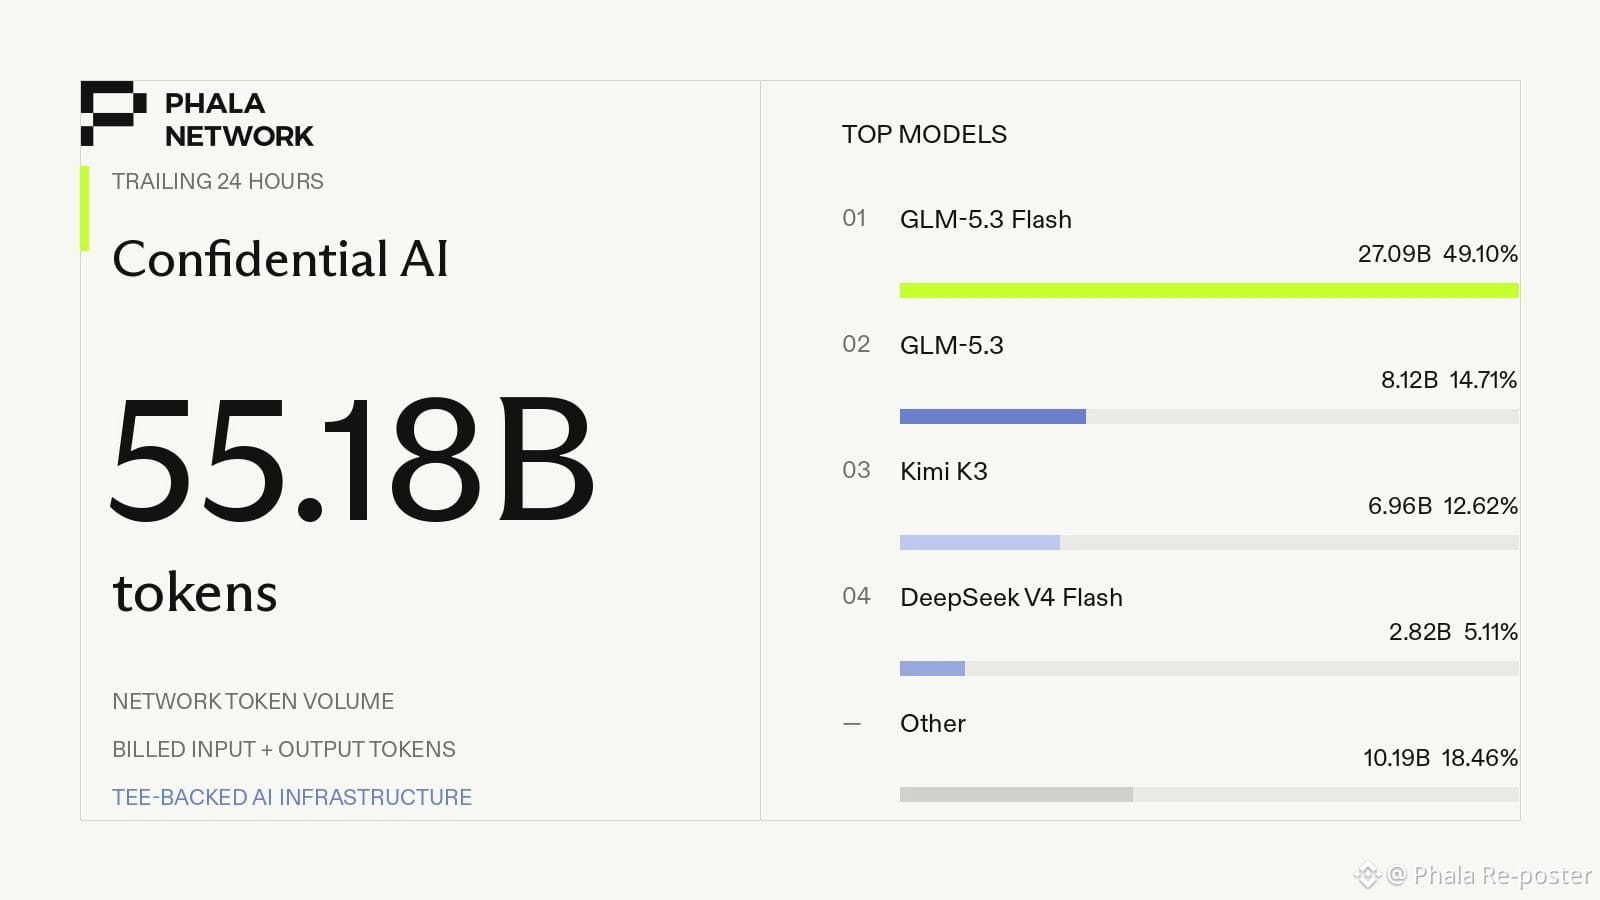
In den letzten 24 Stunden hat Phala Confidential AI insgesamt 55,18 Milliarden Tokens verarbeitet. Werfen wir einen genaueren Blick auf die in diesem Zeitraum am häufigsten genutzten Modelle: GLM-5.3 Flash lag mit 49,10% der Nutzung vorn. Dahinter folgten GLM-5.3 mit 14,71% und Kimi K3 mit 12,62%. Weitere Details finden Sie unter https://phala.com/models/z-ai/glm-5.3-flash. Das gesamte System arbeitet als eine TEE-gestützte KI-Infrastruktur.
In den letzten 24 Stunden hat Phala Confidential AI insgesamt 55,18 Milliarden Tokens verarbeitet. Werfen wir einen genaueren Blick auf die in diesem Zeitraum am häufigsten genutzten Modelle: GLM-5.3 Flash lag mit 49,10% der Nutzung vorn. Dahinter folgten GLM-5.3 mit 14,71% und Kimi K3 mit 12,62%. Weitere Details finden Sie unter https://phala.com/models/z-ai/glm-5.3-flash. Das gesamte System arbeitet als eine TEE-gestützte KI-Infrastruktur.
81
Anmelden und weiter Inhalte entdecken
Krypto-Nutzer weltweit auf Binance Square kennenlernen
⚡️ Bleib in Sachen Krypto stets am Puls.
💬 Die weltgrößte Kryptobörse vertraut darauf.
👍 Erhalte verlässliche Einblicke von verifizierten Creators.
E-Mail-Adresse/Telefonnummer
Trendthemen
BinanceReopensWithdrawalsForMoreAssets
731,248 Aufrufe
3,799 Kommentare
Sicherheitsvorfall | Update zur Wiederherstellung Nr. 8: Auszahlungen für weitere Assets werden wieder aufgenommen (05.11.2026)
Binance Announcement
·288 Likes
·1.1M Aufrufe
BTCRebounds80K
226,522 Aufrufe
1,970 Kommentare
Binance98PercentReplenished
118,322 Aufrufe
1,308 Kommentare