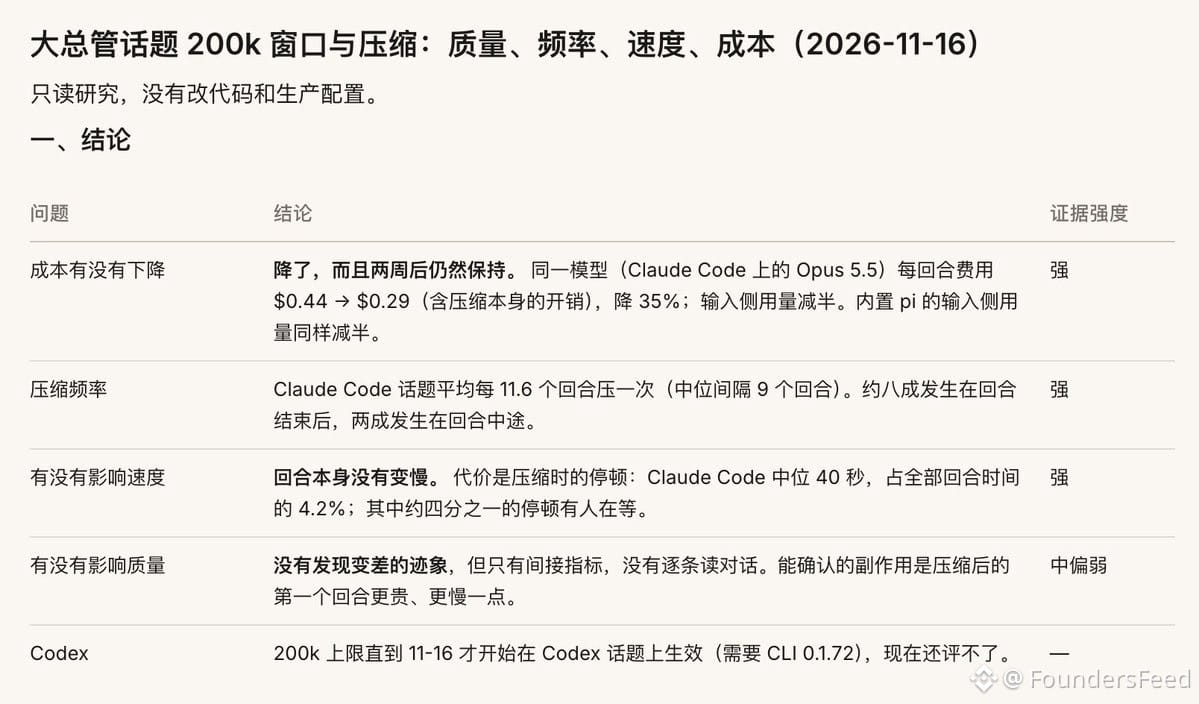
Ich habe im Todos-Arbeitsbereich ein zweiwöchiges Experiment durchgeführt und das Auto-Kompressionsfenster auf 200.000 Tokens begrenzt:
35 % weniger Kosten für Eingabe-Tokens (buchstäblich halbiert)
Die Kompression wurde deutlich schneller, die Iterationszyklen fühlen sich agiler an
Der Erhalt kritischer Kontexte bleibt zuverlässig, die Aufgabenqualität ist praktisch unverändert
Fazit: Modell-Kontextfenster nicht blind bis zum Maximum ausreizen. Intelligente Grenzen für die Kompression = schnellere Inferenz + geringere Kosten, ohne Abstriche bei der Ausgabequalität. Die Feinabstimmung des Kontextfensters ist wichtiger, als viele denken.
35 % weniger Kosten für Eingabe-Tokens (buchstäblich halbiert)
Die Kompression wurde deutlich schneller, die Iterationszyklen fühlen sich agiler an
Der Erhalt kritischer Kontexte bleibt zuverlässig, die Aufgabenqualität ist praktisch unverändert
Fazit: Modell-Kontextfenster nicht blind bis zum Maximum ausreizen. Intelligente Grenzen für die Kompression = schnellere Inferenz + geringere Kosten, ohne Abstriche bei der Ausgabequalität. Die Feinabstimmung des Kontextfensters ist wichtiger, als viele denken.