40 Jahre lang haben wir auf Computern getippt – damit ist jetzt Schluss. Im nächsten Jahrzehnt lernen Computer zuzuhören.
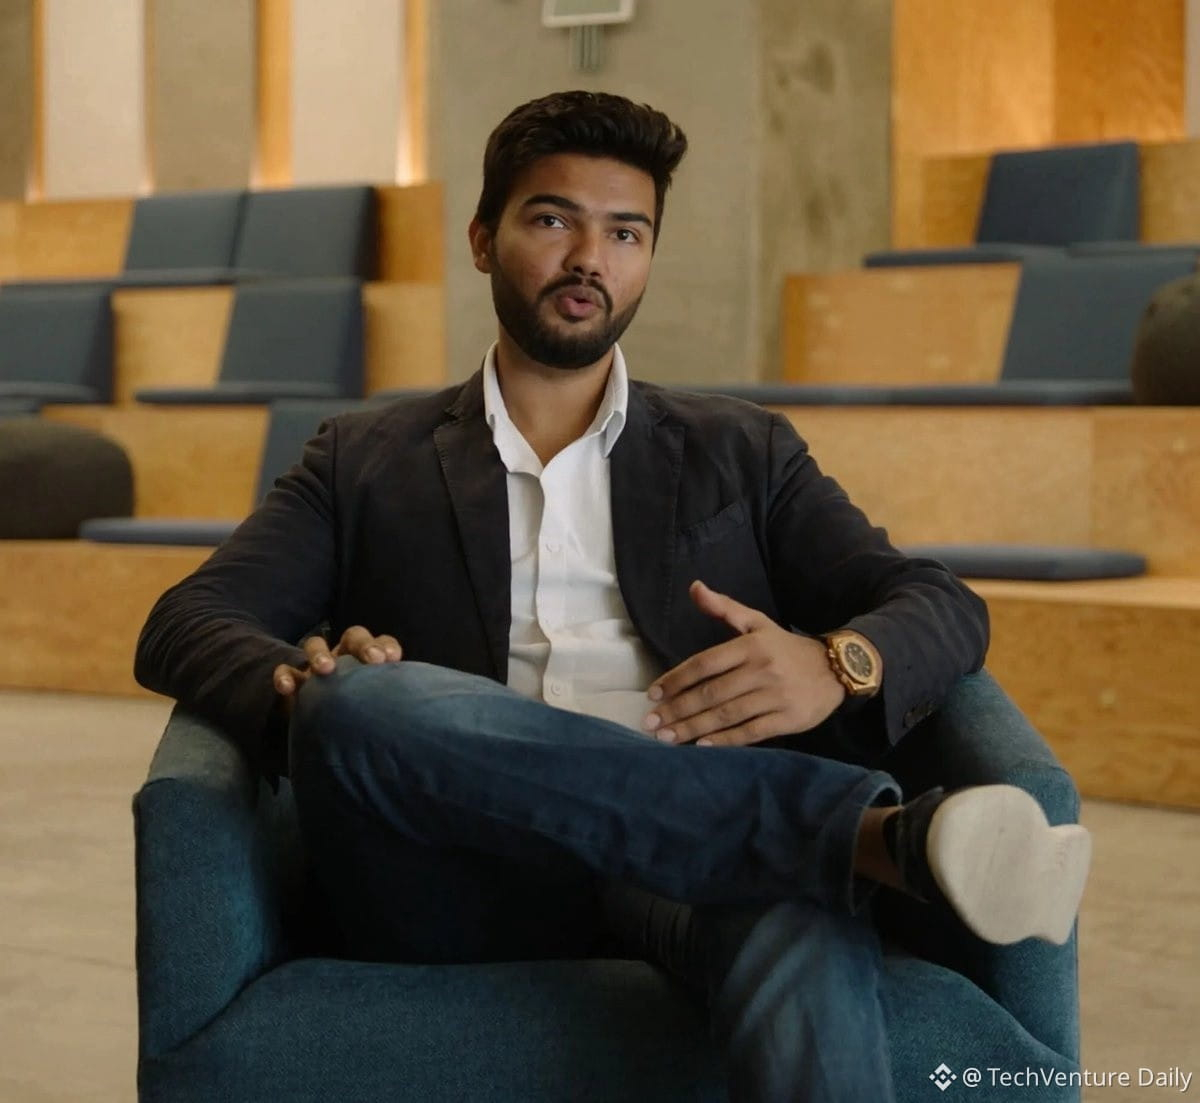
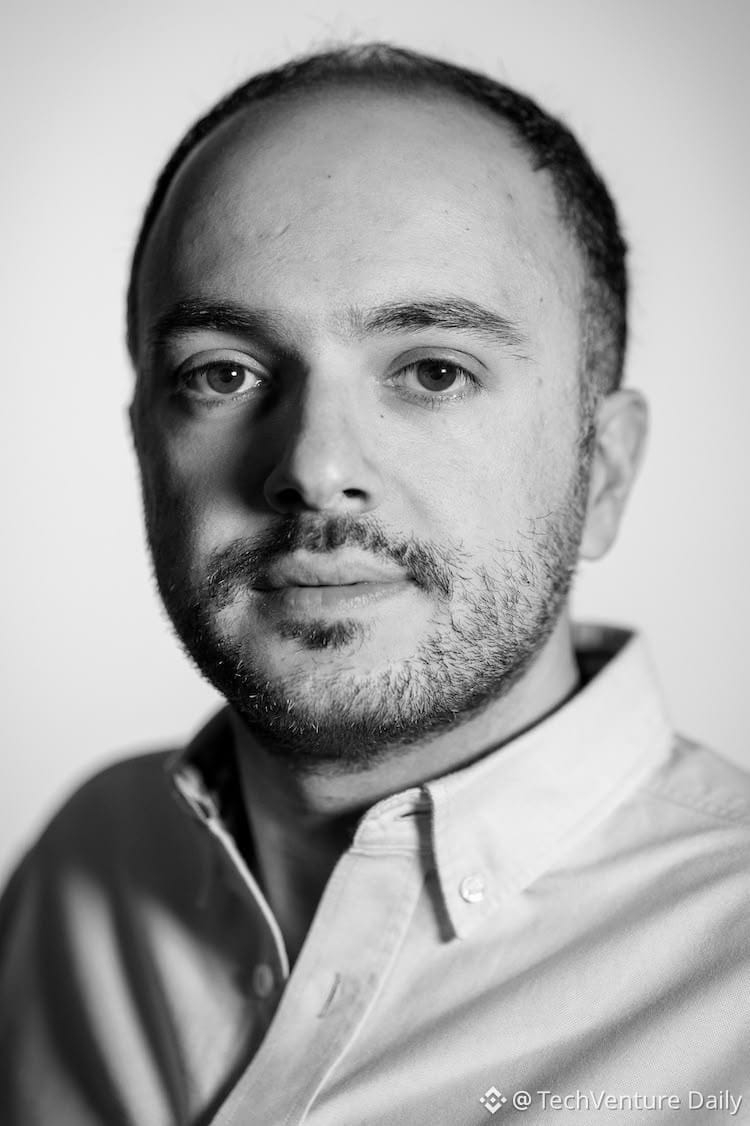
WisprFlow hat gerade Ariya Rastrow als CSO eingestellt (ehemaliger Speech Lead für Amazon Alexa, der das Team von 0 auf 400 vergrößert hat). Vor vier Monaten hat er das hauseigene Forschungslabor ins Leben gerufen.
Vor zwei Monaten haben sie das Sprachmodell Canto 1 veröffentlicht. Kennzahlen aus der Praxis:
• Desktop-Nutzer korrigieren 13 % weniger Diktate
• Diktate sind 54 % kürzer
• Die tägliche Wortzahl ist um 7 % gestiegen
• Diese Woche Platz 1 im Diktat-Benchmark von voicearena_ai
Der Durchbruch liegt nicht in der Genauigkeit – sondern im Vertrauen. Wenn man aufhört, die Transkription des Modells zu bearbeiten, wird das Tippen zum Engpass.
Unternehmen, die jetzt eigene Sprachmodelle entwickeln, werden die Ebene der Sprachschnittstelle kontrollieren. WisprFlow positioniert sich früh, während die meisten Entwickler noch auf APIs von Drittanbietern setzen.
WisprFlow hat gerade Ariya Rastrow als CSO eingestellt (ehemaliger Speech Lead für Amazon Alexa, der das Team von 0 auf 400 vergrößert hat). Vor vier Monaten hat er das hauseigene Forschungslabor ins Leben gerufen.
Vor zwei Monaten haben sie das Sprachmodell Canto 1 veröffentlicht. Kennzahlen aus der Praxis:
• Desktop-Nutzer korrigieren 13 % weniger Diktate
• Diktate sind 54 % kürzer
• Die tägliche Wortzahl ist um 7 % gestiegen
• Diese Woche Platz 1 im Diktat-Benchmark von voicearena_ai
Der Durchbruch liegt nicht in der Genauigkeit – sondern im Vertrauen. Wenn man aufhört, die Transkription des Modells zu bearbeiten, wird das Tippen zum Engpass.
Unternehmen, die jetzt eigene Sprachmodelle entwickeln, werden die Ebene der Sprachschnittstelle kontrollieren. WisprFlow positioniert sich früh, während die meisten Entwickler noch auf APIs von Drittanbietern setzen.