
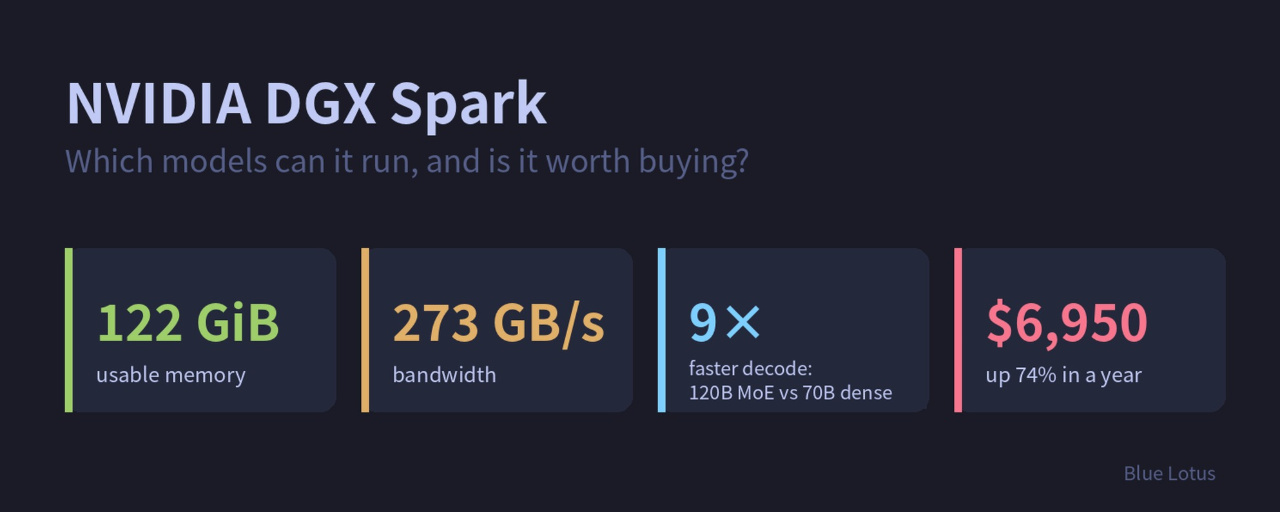
Der NVIDIA DGX Spark ist handtellergroß, und das System meldet 121,93 GiB nutzbaren Speicher. Diese Zahl verleitet zu einem verlockenden Schluss: Wenn die gesamten 128 GB als GPU-Speicher dienen können, müsste er doch jedes große Modell ausführen können, das man ihm vorsetzt, oder?
Ein Modell in den Speicher zu bekommen, bedeutet nicht, dass es schnell läuft. Was diese Maschine tatsächlich leisten kann, hängt von zwei Zahlen ab, die sehr unterschiedliche Dinge messen.
Zwei Zahlen: Kapazität und Bandbreite
Der DGX Spark basiert auf NVIDIAs GB10-Chip. CPU und GPU teilen sich einen gemeinsamen Speicherpool mit 128 GB LPDDR5x-Speicher. Nachdem das System seinen Anteil abgezogen hat, bleiben für Modelle etwa 122 GiB übrig. Zum Vergleich: Eine RTX 5090 verfügt über 32 GB VRAM. Betrachtet man nur die Kapazität, bietet ein Spark so viel Speicher wie vier Gaming-Flaggschiffe.
Die Speicherbandbreite beträgt allerdings nur etwa 273 GB/s. Die RTX 5090 schafft 1,8 TB/s, also mehr als das Sechsfache.
Die Kapazität entscheidet, ob ein Modell hineinpasst. Die Bandbreite entscheidet, wie schnell es kommuniziert.
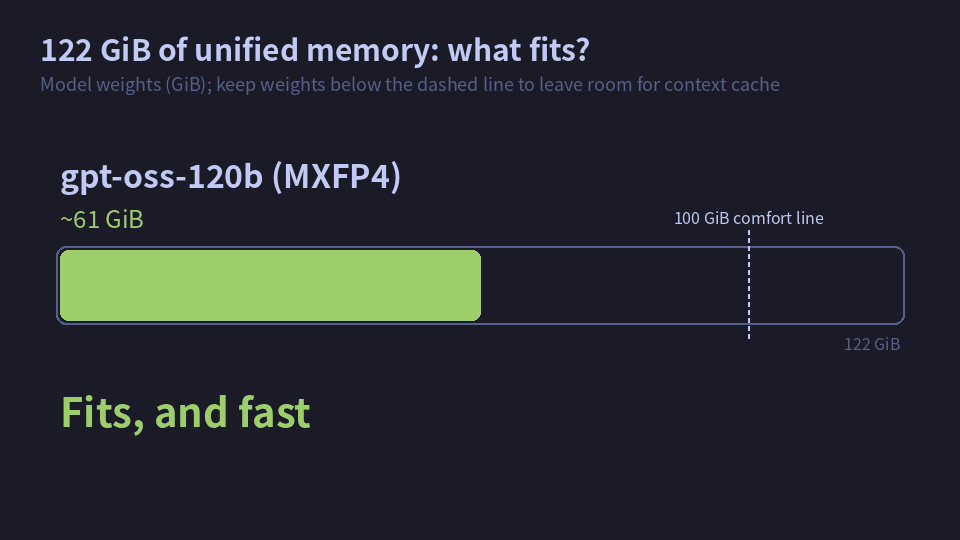
Nach Gewichtsspeicher sortiert: gpt-oss-120b benötigt etwa 61 GiB und ein GLM-4.5-Air mit 4 Bit etwa 68 GiB. Beide passen problemlos hinein, und es bleiben mehr als 40 GiB für den Kontext-Cache. Qwen3-235B passt nur mit 3 Bit hinein, dann wird der Platz knapp. Ein 671B-Modell wie DeepSeek V3 benötigt selbst mit 4 Bit rund 380 GiB, sodass ein einzelner Spark es nicht aufnehmen kann.
Eine praktische Faustregel: Halte die Gewichte unter 100 GiB. Oberhalb dieser Grenze bleibt kein Platz mehr für einen Cache mit langem Kontext.
Die Geschwindigkeit lässt sich auf eine Formel bringen
Um jedes Token zu generieren, muss das Modell bei diesem Schritt alle verwendeten Gewichte aus dem Speicher lesen. Dadurch ist die Generierungsgeschwindigkeit für einen einzelnen Nutzer klar begrenzt:
Maximale Generierungsgeschwindigkeit ≈ Speicherbandbreite ÷ gelesene Bytes pro Token
Ein 70B-Llama mit 4 Bit (Q4_K_M) ist etwa 42,5 GB groß, und 273 ÷ 42,5 ≈ 6,4. Das ist die theoretische Obergrenze; in der Praxis fallen die Werte niedriger aus.
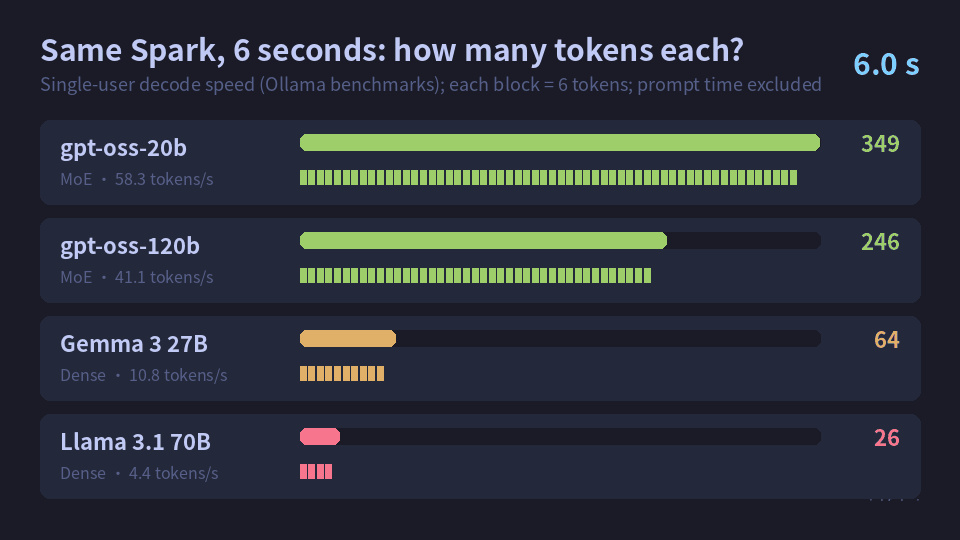
Offizielle Benchmarks von Ollama auf dem DGX Spark:
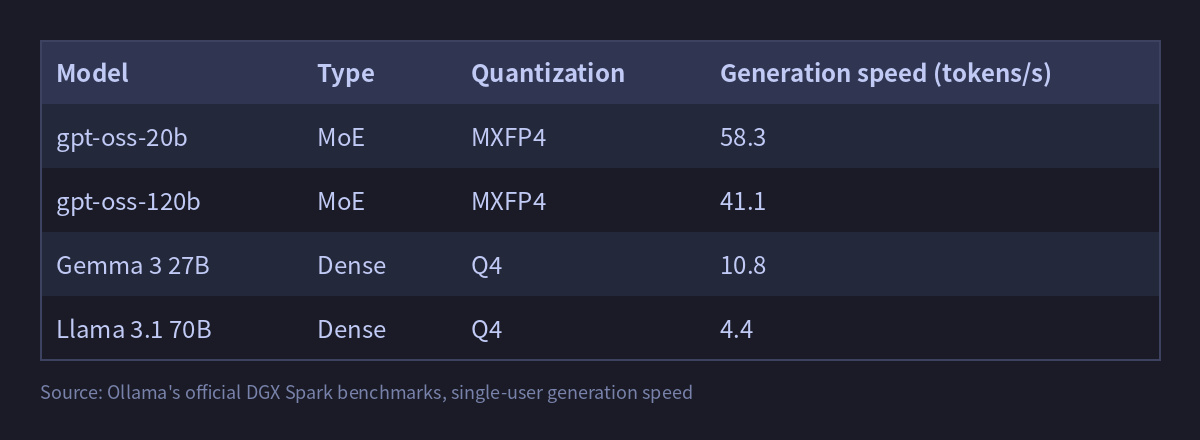
Bei 4 Tokens pro Sekunde tröpfelt die Antwort nur dahin. Die interaktive Nutzung ist mühsam.
Das zunächst überraschende Ergebnis: 120B läuft fast zehnmal schneller als 70B
Die interessanteste Zeile in dieser Tabelle betrifft gpt-oss-120b. Es hat etwa 67 % mehr Parameter als Llama 70B, generiert aber mehr als neunmal schneller.
Der Grund liegt in der Architektur. Llama 70B ist ein dichtes Modell: Alle seine 70 Milliarden Parameter kommen bei jedem Token zum Einsatz, daher werden sie jedes Mal aus dem Speicher gelesen. gpt-oss-120b ist ein Mixture-of-Experts-Modell (MoE): Seine 117 Milliarden Parameter sind auf viele „Experten“ verteilt, und für jedes Token werden nur einige davon herangezogen. Pro Token sind nur etwa 5,1 Milliarden Parameter aktiv.
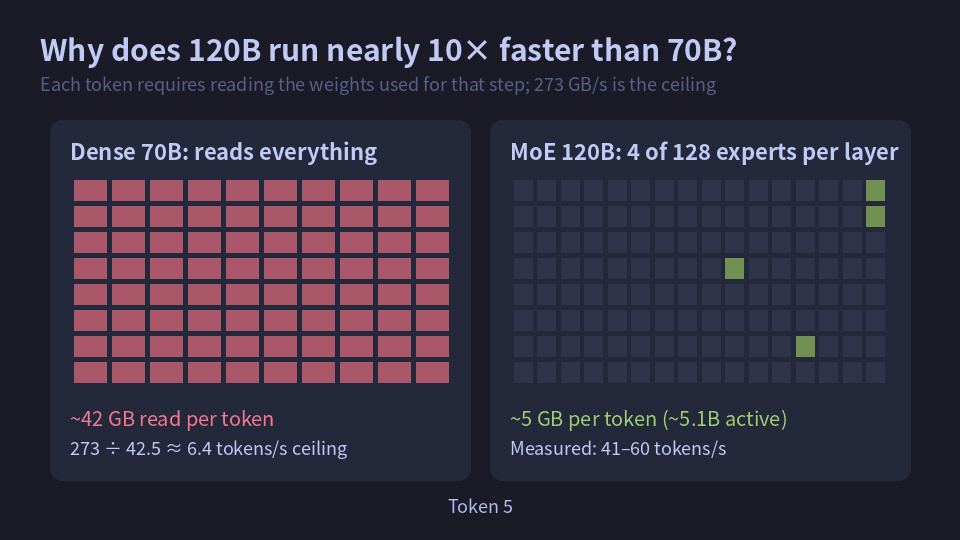
Das dichte 70B-Modell liest pro Token etwa 42 GB. Das MoE-Modell mit 120B liest nur etwa 5 GB: ungefähr 2 GB für die ausgewählten Experten und weitere 3 GB für die Attention- und Ausgabeschichten, die mit höherer Präzision gespeichert werden. Das erklärt den nahezu zehnfachen Geschwindigkeitsunterschied auf einer Maschine, deren Leistung durch die Bandbreite begrenzt ist.
Das gibt auch die Regel für die Modellwahl vor: Der Spark ist für MoE-Modelle ausgelegt. Die Gesamtzahl der Parameter darf groß sein, weil reichlich Speicher vorhanden ist. Die Zahl der aktiven Parameter muss klein sein, weil die Bandbreite begrenzt ist.
Was er tatsächlich ausführen kann
Nach dieser Logik lassen sich gängige Open-Weight-Modelle in sieben Leistungsklassen einteilen:
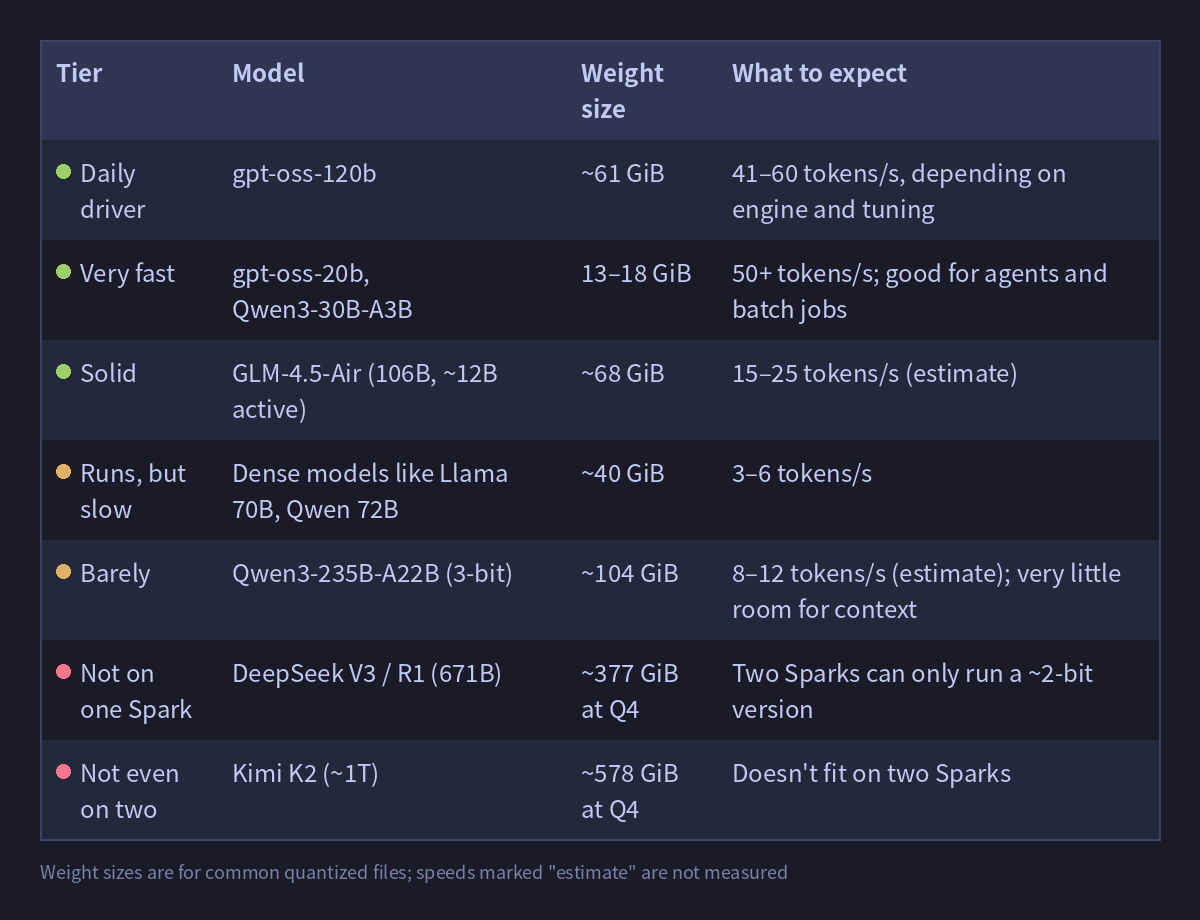
Auch die Inferenz-Engine spielt eine Rolle. Foren-Benchmarks für gpt-oss-120b zeigen etwa 46 Tokens/s mit llama.cpp, etwa 52 mit SGLang und bis zu 60 Tokens/s mit einem optimierten vLLM. Für einen einzelnen Nutzer ist llama.cpp am unkompliziertesten. Für die gemeinsame Nutzung mit vielen gleichzeitigen Anfragen solltest du vLLM verwenden.
Zwei miteinander verbinden: 256 GB
Der Spark verfügt über eine integrierte Hochgeschwindigkeits-Netzwerkkarte ConnectX-7. Zwei Geräte lassen sich direkt miteinander verbinden und mit Tensor-Parallelismus ein Modell in zwei Hälften aufteilen, sodass jedes Gerät eine Hälfte ausführt.
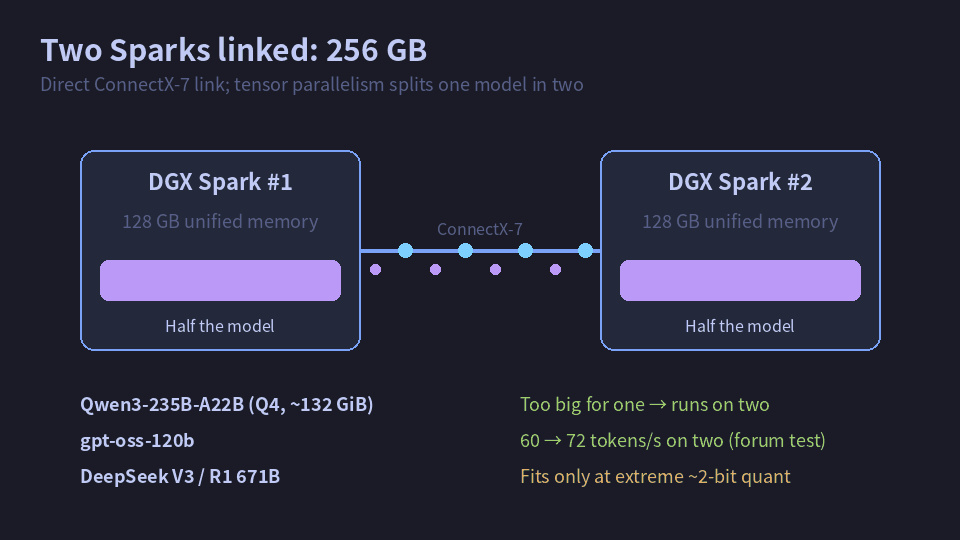
Mit insgesamt 256 GB auf zwei Geräten läuft Qwen3-235B vollständig mit 4 Bit. In Foren-Benchmarks steigt gpt-oss-120b von 60 Tokens/s auf einem einzelnen Spark auf 72 auf zwei Geräten – ein bescheidener Zuwachs, da es von Anfang an nicht an Speicher mangelte. DeepSeek 671B passt auf zwei Geräte weiterhin nur mit einer extremen Quantisierung auf etwa 2 Bit; der Qualitätsverlust ist spürbar, und wirklich lohnenswert ist es kaum.
Ist es den Preis wert?
Diese Maschine ist im letzten Jahr nur teurer geworden. Die NVIDIA Founders Edition mit 128 GB kam für 3.999 $ auf den Markt, stieg im Februar 2026 auf 4.699 $ und sprang im Oktober auf 6.950 $ – ein Plus von 74 % innerhalb eines Jahres. Als NVIDIA den Preis im Februar erhöhte, verwies das Unternehmen auf die knappe Speicherverfügbarkeit; bei der Erhöhung im Oktober verwiesen die Medien ebenfalls auf den weltweiten Speicherengpass.
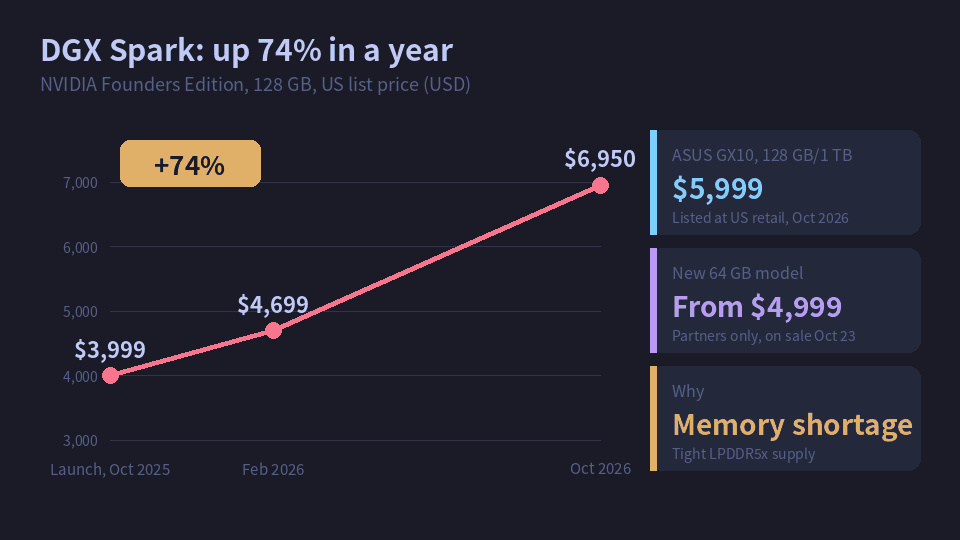
Stellen wir diese Preise nun den Bandbreitenwerten gegenüber, auf die wir immer wieder zurückkommen:
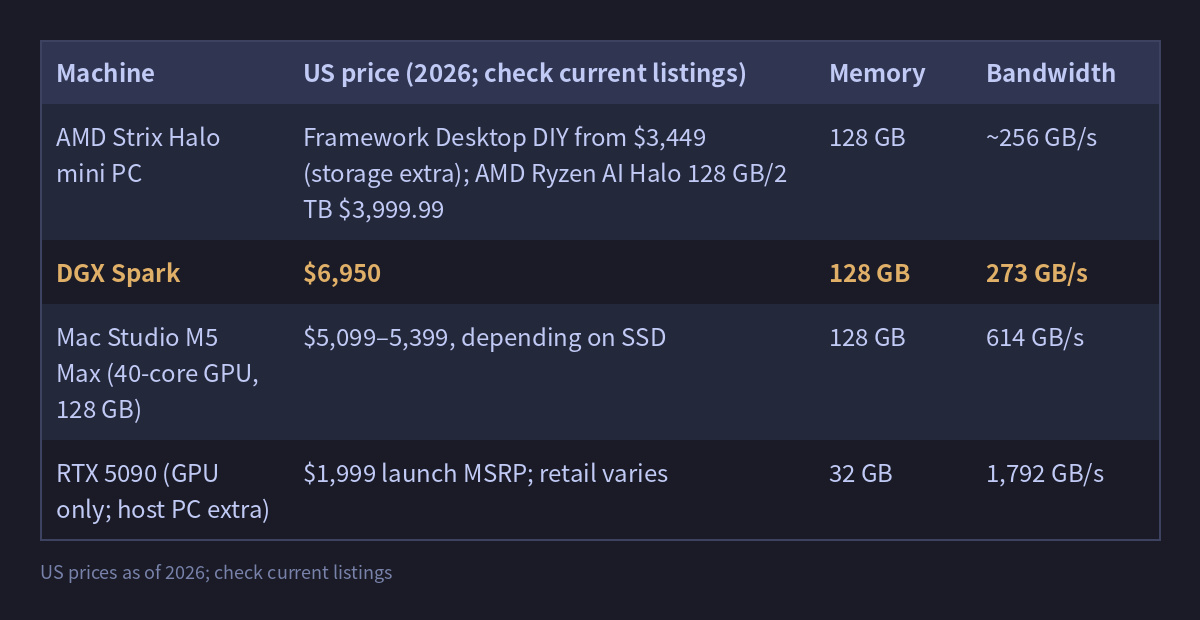
Bei denselben 128 GB bietet ein AMD Strix Halo Mini-PC ungefähr dieselbe Bandbreite wie der Spark, kostet aber etwa halb so viel. Ein Mac Studio M5 Max kostet inzwischen weniger als der Spark und bietet die 2,2-fache Bandbreite – er generiert also spürbar schneller. Wenn du nur große Modelle lokal ausführen willst, bietet der Spark keinen klaren Preisvorteil.
Wofür du das zusätzliche Geld bekommst, ist NVIDIAs Software-Stack: CUDA, vLLM, SGLang und TensorRT-LLM funktionieren sofort, lange Prompts werden schnell verarbeitet, Fine-Tuning funktioniert, und alles, was du hier entwickelst, läuft unverändert auf NVIDIA-Servern im Rechenzentrum. Wenn du all das nicht brauchst, ist er den Preis nicht wert.
Für wen er gedacht ist
Betrachte diese Maschine als Workstation, die große Modelle aufnehmen kann, aber nicht schnell mit ihnen kommuniziert:
Für alltägliche Chats und Hilfe beim Programmieren ist gpt-oss-120b schnell und gut genug;
Für Agenten und die stapelweise Verarbeitung von Dokumenten solltest du ein kleineres MoE-Modell verwenden; in den obigen Benchmarks dekodiert gpt-oss-20b etwa 40 % schneller als gpt-oss-120b;
Beim Fine-Tuning von Modellen bis 70B (QLoRA) macht sich der 128-GB-Speicher wirklich bezahlt;
Dichte 70B-Modelle eignen sich nur für Offline-Aufgaben, bei denen Wartezeit keine Rolle spielt; wenn du unbedingt eines verwenden musst, ergänze ein kleines Entwurfsmodell für spekulatives Decoding, das die Verarbeitung spürbar beschleunigt.
Wenn du hauptsächlich „eine Person, die schnell mit einem großen Modell chattet“ möchtest, bist du mit einem Mac Studio oder einer GPU mit viel VRAM besser beraten. Wenn du ein Modell der 100B-Klasse einfach möglichst günstig vorhalten möchtest, ist ein AMD-Mini-PC das bessere Angebot. Der Spark ist seinen Preis nur wert, wenn deine Arbeit von CUDA abhängt, Fine-Tuning umfasst oder denselben Software-Stack wie im Rechenzentrum benötigt.
Stell dir bei der Modellwahl nur zwei Fragen: Passen die Gesamtparameter in 122 GiB? Sind die aktiven Parameter klein genug? Wenn du beide Fragen mit Ja beantwortest, eignet sich das Modell gut für diese Maschine.
Hardware kaufen oder ein Abonnement abschließen?
Nach der Rechnung zur Hardware gibt es eine direktere Rechnung.
Ich entscheide mich für Abonnements: Claude Max 5x für 100 $ im Monat plus ChatGPT Plus (einschließlich Codex) für 20 $ im Monat, also insgesamt 1.440 $ im Jahr. Ein Spark für 6.950 $ würde fast 5 Jahre lang für beide Abonnements reichen; für Max 5x allein fast 6 Jahre.
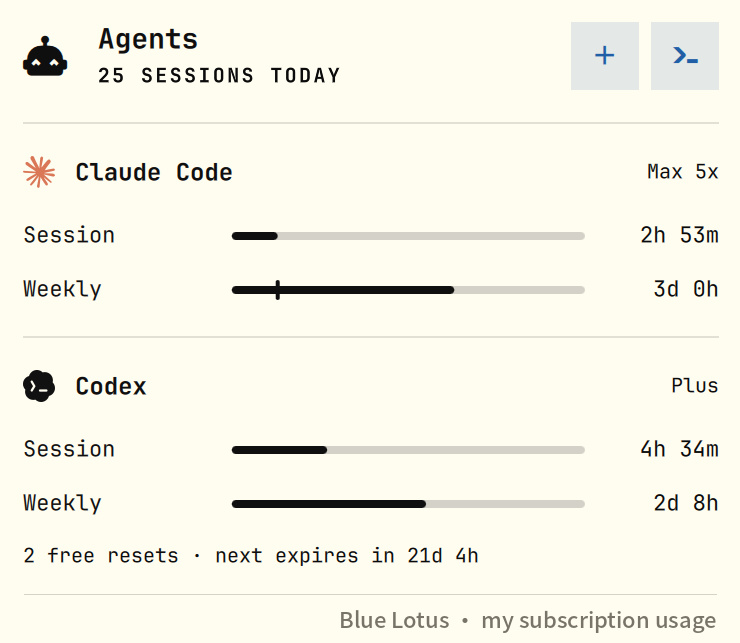
So sah meine Nutzung an einem Tag aus: 25 Agent-Sitzungen, etwa 60 % des wöchentlichen Claude-Code-Kontingents verbraucht, obwohl bis zum Zurücksetzen noch 3 Tage blieben, und etwas mehr als die Hälfte des wöchentlichen Codex-Kontingents. Bei diesem Tempo decken die beiden Abonnements im Allgemeinen meinen Bedarf, und sie bieten Zugang zu Frontier-Modellen. Die beste lokale Option, gpt-oss-120b, kann bei Programmieraufgaben und lang laufenden Aufgaben trotzdem nicht mit ihnen mithalten.
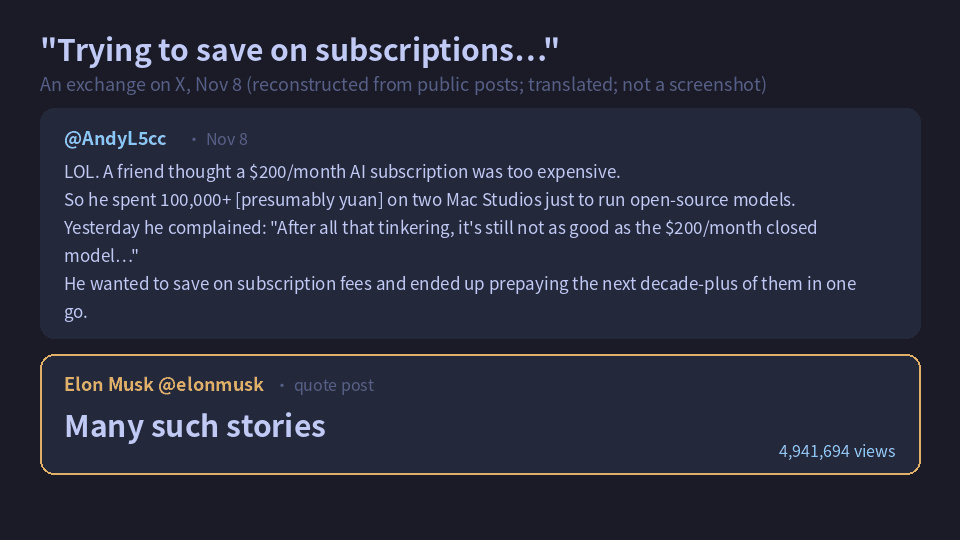
Ich bin nicht der Einzige, der diese Rechnung aufstellt. Am 8. November ging ein chinesischsprachiger Beitrag auf X viral: Jemand hielt ein KI-Abonnement für 200 $ im Monat für zu teuer und gab daraufhin mehr als 100.000 (vermutlich Yuan) für zwei Mac Studios aus, nur um Open-Source-Modelle auszuführen. Nach viel Herumprobieren stellte sich jedoch heraus, dass es „immer noch nicht so gut ist wie das geschlossene Modell für 200 $ im Monat“. Die Zusammenfassung des Verfassers: „Er wollte Abonnementgebühren sparen und hat am Ende mehr als ein Jahrzehnt davon auf einmal im Voraus bezahlt.“ Elon Musk versah den Beitrag mit einem Zitat und nur drei Worten: „Davon gibt es viele.“ Der zitierte Beitrag erzielte fast 5 Millionen Aufrufe.
OpenAIs Sam Altman erklärte kürzlich in einem Podcast die dahinterstehende Logik: Der Speicher in privaten Computern sei nur etwa 5 % der Zeit in Gebrauch (so seine eigene Schätzung), während die Cloud durch das Bündeln von Anfragen und deren Stapelverarbeitung die Auslastung normalerweise steigern und die Kosten verteilen könne. Er verkauft Cloud-Abonnements und hat daher ein Interesse an diesem Argument, aber die Logik ist stichhaltig: In der Cloud kann ein einmaliges Lesen der Gewichte einen ganzen Stapel von Anfragen gleichzeitig bedienen und so die Kosten verteilen; ein privater Rechner bedient jeweils eine Person und steht einen Großteil des Tages ungenutzt herum. Schätze also vor dem Kauf lokaler Hardware ab, wie viel du sie tatsächlich nutzen wirst: Je weniger du sie nutzt, desto schlechter ist das Angebot.
Lokale Modelle bieten allerdings Vorteile, die ein Abonnement nicht bieten kann:
Datenschutz: Kundendaten, interner Code, Compliance-Anforderungen; die Daten dürfen den eigenen Rechner nicht verlassen;
Keine Plattformbeschränkungen: Für das Modell gelten nicht die Inhaltsrichtlinien eines Anbieters, und du entscheidest, was es beantworten darf;
Offline und unbegrenzt: Es funktioniert ohne Verbindung, und Stapelverarbeitungsaufträge werden nicht auf ein Kontingent angerechnet;
Fine-Tuning: Wenn du dein eigenes Modell trainieren möchtest, kann ein Abonnement das nicht leisten.
Für die meisten Menschen ist ein Abonnement günstiger, und die Modelle sind leistungsfähiger. Der Kauf eines Spark ergibt nur dann Sinn, wenn mindestens eine der vier oben genannten Anforderungen unverzichtbar ist.