

上一期把模型分数和动量各取一半,测试期做到 +172.93% 收益、-18.44% 回撤、夏普 2.076。结尾我说,下一期把融合接上 buffer 和止损,再跑验证期。
真开始做之前,我先停了一下。九个表现较好的策略,结果散在不同的消融脚本和缓存目录里,参数写在配置字典,信号文件命名不统一。如果换一台机器,或者过两周再回来,这九个数字还能不能原样跑出来?答案是不能。
所以这一期不继续追收益,先把九个策略固化成能一键复现的目录。一个不能复现的回测,和编故事没有区别。
这次交付三样东西:九个策略文件、六份信号文件、一个统一 notebook。九个策略全部跑通,9/9 与预期值逐项对上。
一、为什么先做复现,而不是继续调参
这个系列前两期,一期在清洗币池,一期在修选币接口。到这一期,策略数量已经有九个,继续加参数很容易,但每加一个,复现难度就高一分。
之前的九个策略来自 `robust_ablation.py` 和 `risk_guard_ablation.py` 的配置字典。同样的选币逻辑抄在不同配置里,参数写死。改一个信号,你分不清是信号变了,还是代码路径变了。更麻烦的是,别人看到一个数字,没有办法判断它是哪版代码、哪份信号、哪套参数跑出来的。
复现不是形式主义。它把策略从一次性的脚本输出,变成可以引用、可以对比、可以传给别人检查的文件。后面不管加资金费、加滑点,还是做 walk-forward,都需要一个稳定的起点。
二、九个策略文件:只固定参数,不复制逻辑
新建目录 `alpha/crypto/strategy_catalog/`,九个策略文件放在里面。每个文件对应一个策略:
- 融合 top5
- 模型 buf4 止损35
- mom10 top5 多头 buf5
- 模型 buf4 止损10
- 模型 多头 buf5 止损10
- mom10 top5
- 模型 buf4
- 模型 多头 buf5
- mom10 top20 多头 buf5
九个文件都是薄子类,不复制基类逻辑。选币、排名缓冲区、止损状态机仍然在 `CryptoRobustStrategy` 和 `CryptoRobustGuardedStrategy` 里,子类只固定参数。
每个文件统一导出六个对象:策略名、信号族、策略类、回测参数、测试期预期指标、验证期对照值。验证期对照值只有三个 mom10 策略有,模型和融合暂时留空。notebook 靠这些对象自动组装,不需要手写九段回测代码。
为什么不做成九个独立实现?因为九个文件如果各抄一份选币逻辑,就是九个潜在的 bug。改基类只改一处,九个策略同时受益;改参数只改一个文件,不会影响其他八个。
文件头的中文说明写清楚四件事:多空两端怎么选、需要哪族信号和哪些列、固定参数是什么意思、什么情况下这个策略会失效。最后一条很重要。一个策略文件如果只写怎么赚钱,不写什么时候会亏,下次很容易在一个已经坏掉的策略上继续调参。
这里有一个具体的坑。三个止损策略的 `stop_pct` 和 `stop_cooldown` 必须同时写进 `BACKTEST_SETTING`。因为回测 runner 读的是 `setting.get("stop_pct")`,不是类属性。只写在类上,策略自己仍会判止损,但 runner 不会做事后盈亏校正,回测照常出结果,止损日的账却是错的。notebook 里加了断言,类属性和 setting 必须一致,不一致直接报错。
另一个限制是,`CryptoRobustGuardedStrategy` 的 `on_bars` 硬编码了 p5 和 p0,只支持 level 选币,不支持融合选币。九个策略里没有融合加止损,所以这次不改基类,只在三个止损文件的说明里写清楚。以后要做融合加止损,得先把基类的选币接口抽出来。
三、六份信号:三族信号,测试和验证各一份
九个策略共用三族信号,不需要复制九份:
- 模型信号:p5、p0、score,来自 LightGBM 五分类模型
- mom10 信号:过去 10 个交易日的动量
- 融合信号:模型分数排名和动量排名各取一半
每族信号有测试段和验证段两份,一共六份文件。
为什么不给每个策略复制一份信号?因为信号是输入,策略是消费方式。同一份模型信号,top5、buffer4、止损10 都是不同的消费方式。复制九份会让 hash 校验失去意义,也容易改了一处忘了另一处。
所有信号共用一套 schema,融合文件多三列诊断列:
| 列 | 类型 | 含义 |
|---|---|---|
| datetime | Datetime("us") | 交易日午夜,naive 时间 |
| vt_symbol | String | 合约代码 |
| signal | Array(Float64, 6) | 五分类概率 |
| p5 | Float64 | signal[5],进入最高一档的概率 |
| p0 | Float64 | signal[0],进入最低一档的概率 |
| score | Float64 | p5 减 p0 |
| mom_return_10 | Float64 | 10 日动量 |
| score_rank_pct | Float64 | 模型分数的截面排名分位,仅融合文件 |
| mom_rank_pct | Float64 | 动量的截面排名分位,仅融合文件 |
| blend_score | Float64 | 两列各半,仅融合文件 |
写入前检查四件事:主键日期加合约唯一;合约与纯加密排除名单交集为空;`signal` 仍然是 `Array(Float64, 6)`,不能变成 `List`;p5、p0、score 三者自洽。
还有一个容易被忽略的点:行序不能动。
选币时如果排名在边界上并列,稳定排序会按原始行序决定谁进谁出。把信号文件按日期或合约排一次序,持仓就可能变,收益也跟着变。所以所有投影和补列都保留源文件行序,禁止排序。这不是代码风格问题,是结果能不能复现的问题。
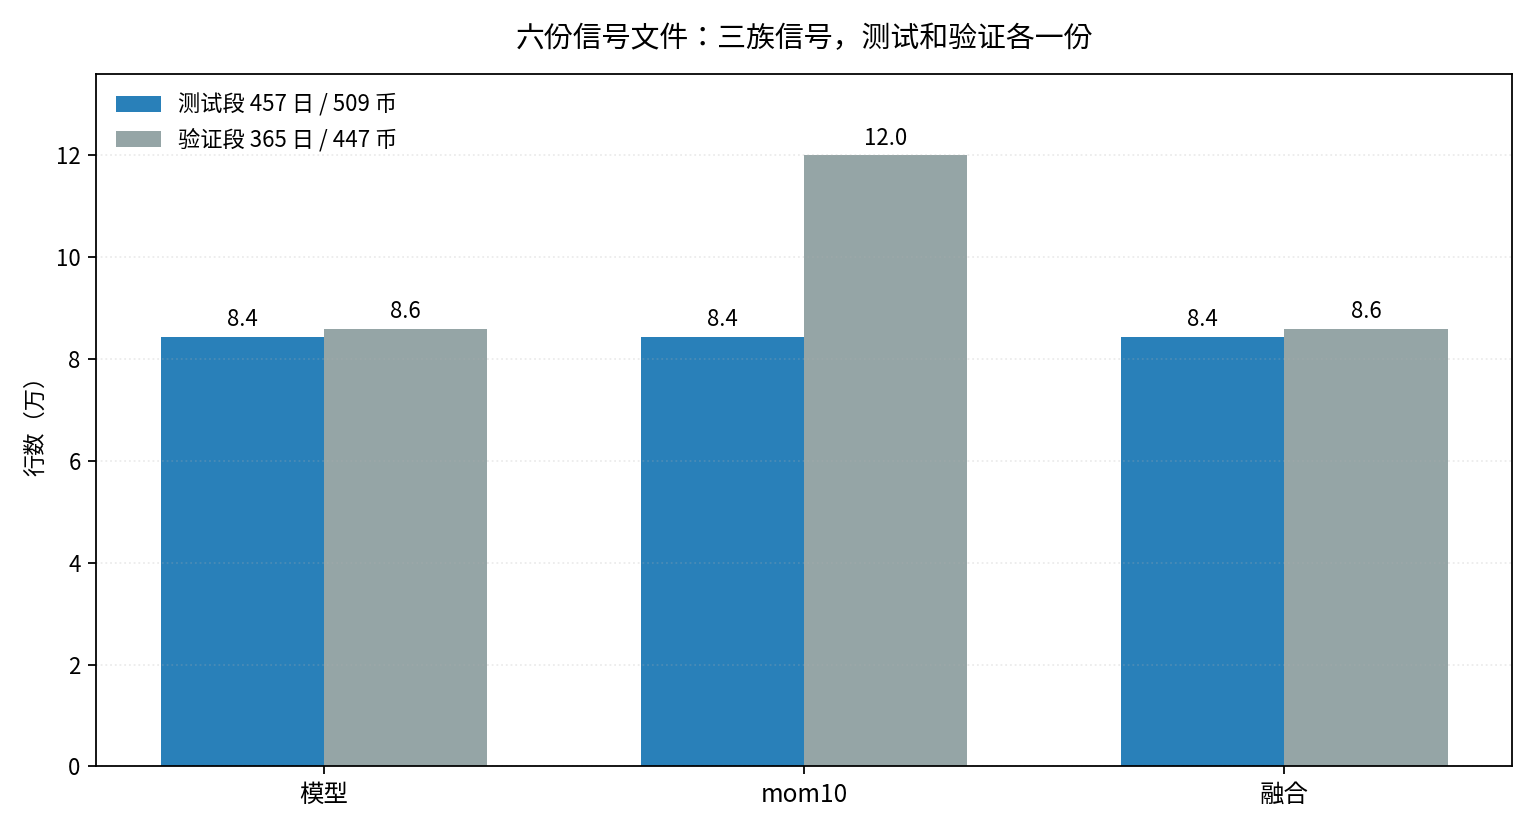
图 1:测试段每份 8.4 万行,验证段的模型和融合是 8.6 万行,mom10 验证段是 12.0 万行。mom10 验证段行数多,不是币更多,是编码口径不同。
四、mom10 的测试段和验证段,不能互换
这是这次最容易踩的坑。
mom10 测试段用的是数据集裁剪过的 `mom_return_10`,范围压在正负 3 之间。mom10 验证段用的是 risk table 里未裁剪的 `mom10`。两个文件看起来是同一个信号,其实编码不一样。
不能互换,也不能拿其中一个重算另一个。跨段比较之前必须先看口径。把两段结果直接拼在一起,看起来都是 mom10,实际上衡量的不是同一件事。
模型验证段还有另一层限制。VALID 参与了每日 IC 早停,所以 `model_valid` 只能算半样本内。这次模型 `best_iteration` 是 290,验证段每日 IC 是 0.0373。这个数字不能当成干净样本外,后面做验证期结论时要打折。
为了保证训练和投影没有漂移,notebook 里加了一道 test parity 闸门:重新预测测试段,和已经保存的 `model_test` 逐行比较,最大绝对差必须小于 `1e-6`。这次实际差值是 0.0。
五、一个 notebook:校验、加载、回测、对账
统一入口是 `strategy_catalog_backtest.ipynb`。四个开关控制运行方式:
- `RUN_SEGMENTS=["test"]`:先只跑测试段
- `FORCE_REBUILD_SIGNALS=False`:信号缺了才重建
- `RETRAIN_MODEL=False`:默认不重训,直接用缓存模型
- `ALLOW_MODEL_MISMATCH=False`:模型对不上就中止,不静默继续
流程分六步:
1. 加载 AlphaLab、CRYPTO.LOCAL 成分和纯加密过滤
2. 校验或生成六份信号
3. 动态导入九个策略模块,组装策略目录
4. 每段加载三族信号和 OHLC,逐个调用回测 runner
5. 写出每个策略的 JSON 指标和逐日净值 parquet
6. 生成对账表,实际值、预期值、差值、通过与否放在一起
回测复用 `risk_guard_ablation.run_config`,不新写 runner。它已经包含止损触发日盈亏替换、次日残余清零、手续费保留和指标重算。如果为了这次目录再写一套回测,两套引擎迟早会跑出两套数字。
对账标准是固定的:
- 收益和最大回撤误差不超过 0.01 个百分点
- 夏普误差不超过 0.001
- Calmar 误差不超过 0.01
- 成交数和止损次数精确相等
这次 9/9 全部通过。每个策略的逐日净值都是 457 行,期末权益等于 1000 万乘以 1 加收益率。三个止损策略的止损次数分别是 121、646、652,和策略端记录的止损次数完全一致。
不是差不多,是逐项对上。
六、九个策略的成绩单
把九个策略放在同一张表里,按收益从高到低:
| 策略 | 信号 | 收益 | 最大回撤 | 夏普 | 成交数 | 止损次数 |
|---|---|---:|---:|---:|---:|---:|
| 融合 top5 | 融合 | +172.93% | -18.44% | 2.076 | 7251 | 0 |
| mom10 top5 多头 buf5 | mom10 | +152.67% | -30.13% | 1.577 | 5879 | 0 |
| 模型 buf4 止损35 | 模型 | +151.47% | -31.42% | 1.635 | 4787 | 121 |
| 模型 buf4 | 模型 | +137.55% | -54.80% | 1.368 | 4745 | 0 |
| mom10 top5 | mom10 | +134.22% | -39.03% | 1.385 | 6201 | 0 |
| 模型 buf4 止损10 | 模型 | +130.86% | -16.25% | 1.906 | 4719 | 646 |
| 模型 多头 buf5 | 模型 | +115.08% | -51.89% | 1.174 | 4855 | 0 |
| 模型 多头 buf5 止损10 | 模型 | +114.01% | -14.39% | 1.846 | 4743 | 652 |
| mom10 top20 多头 buf5 | mom10 | +68.98% | -21.81% | 1.563 | 22474 | 0 |
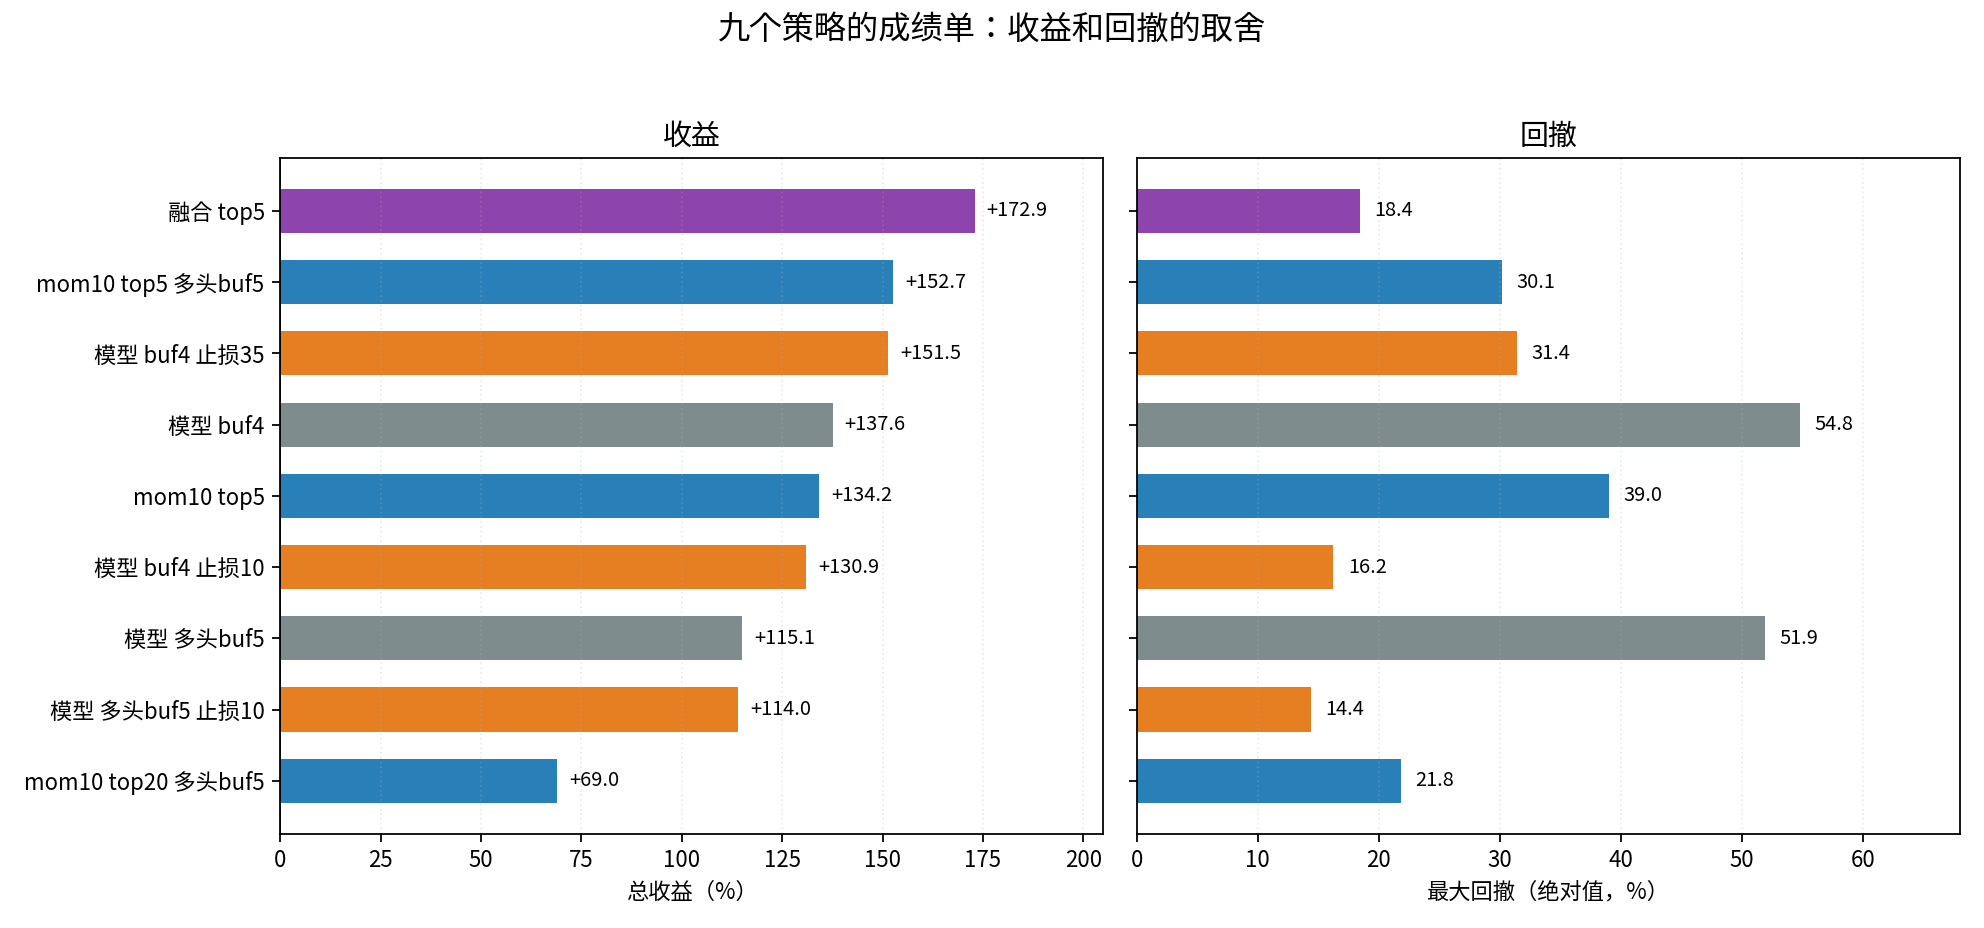
图 2:左边是收益,右边是回撤绝对值,同一个顺序。橙色是带止损的模型策略,灰色是不带止损的模型策略,蓝色是 mom10,紫色是融合。
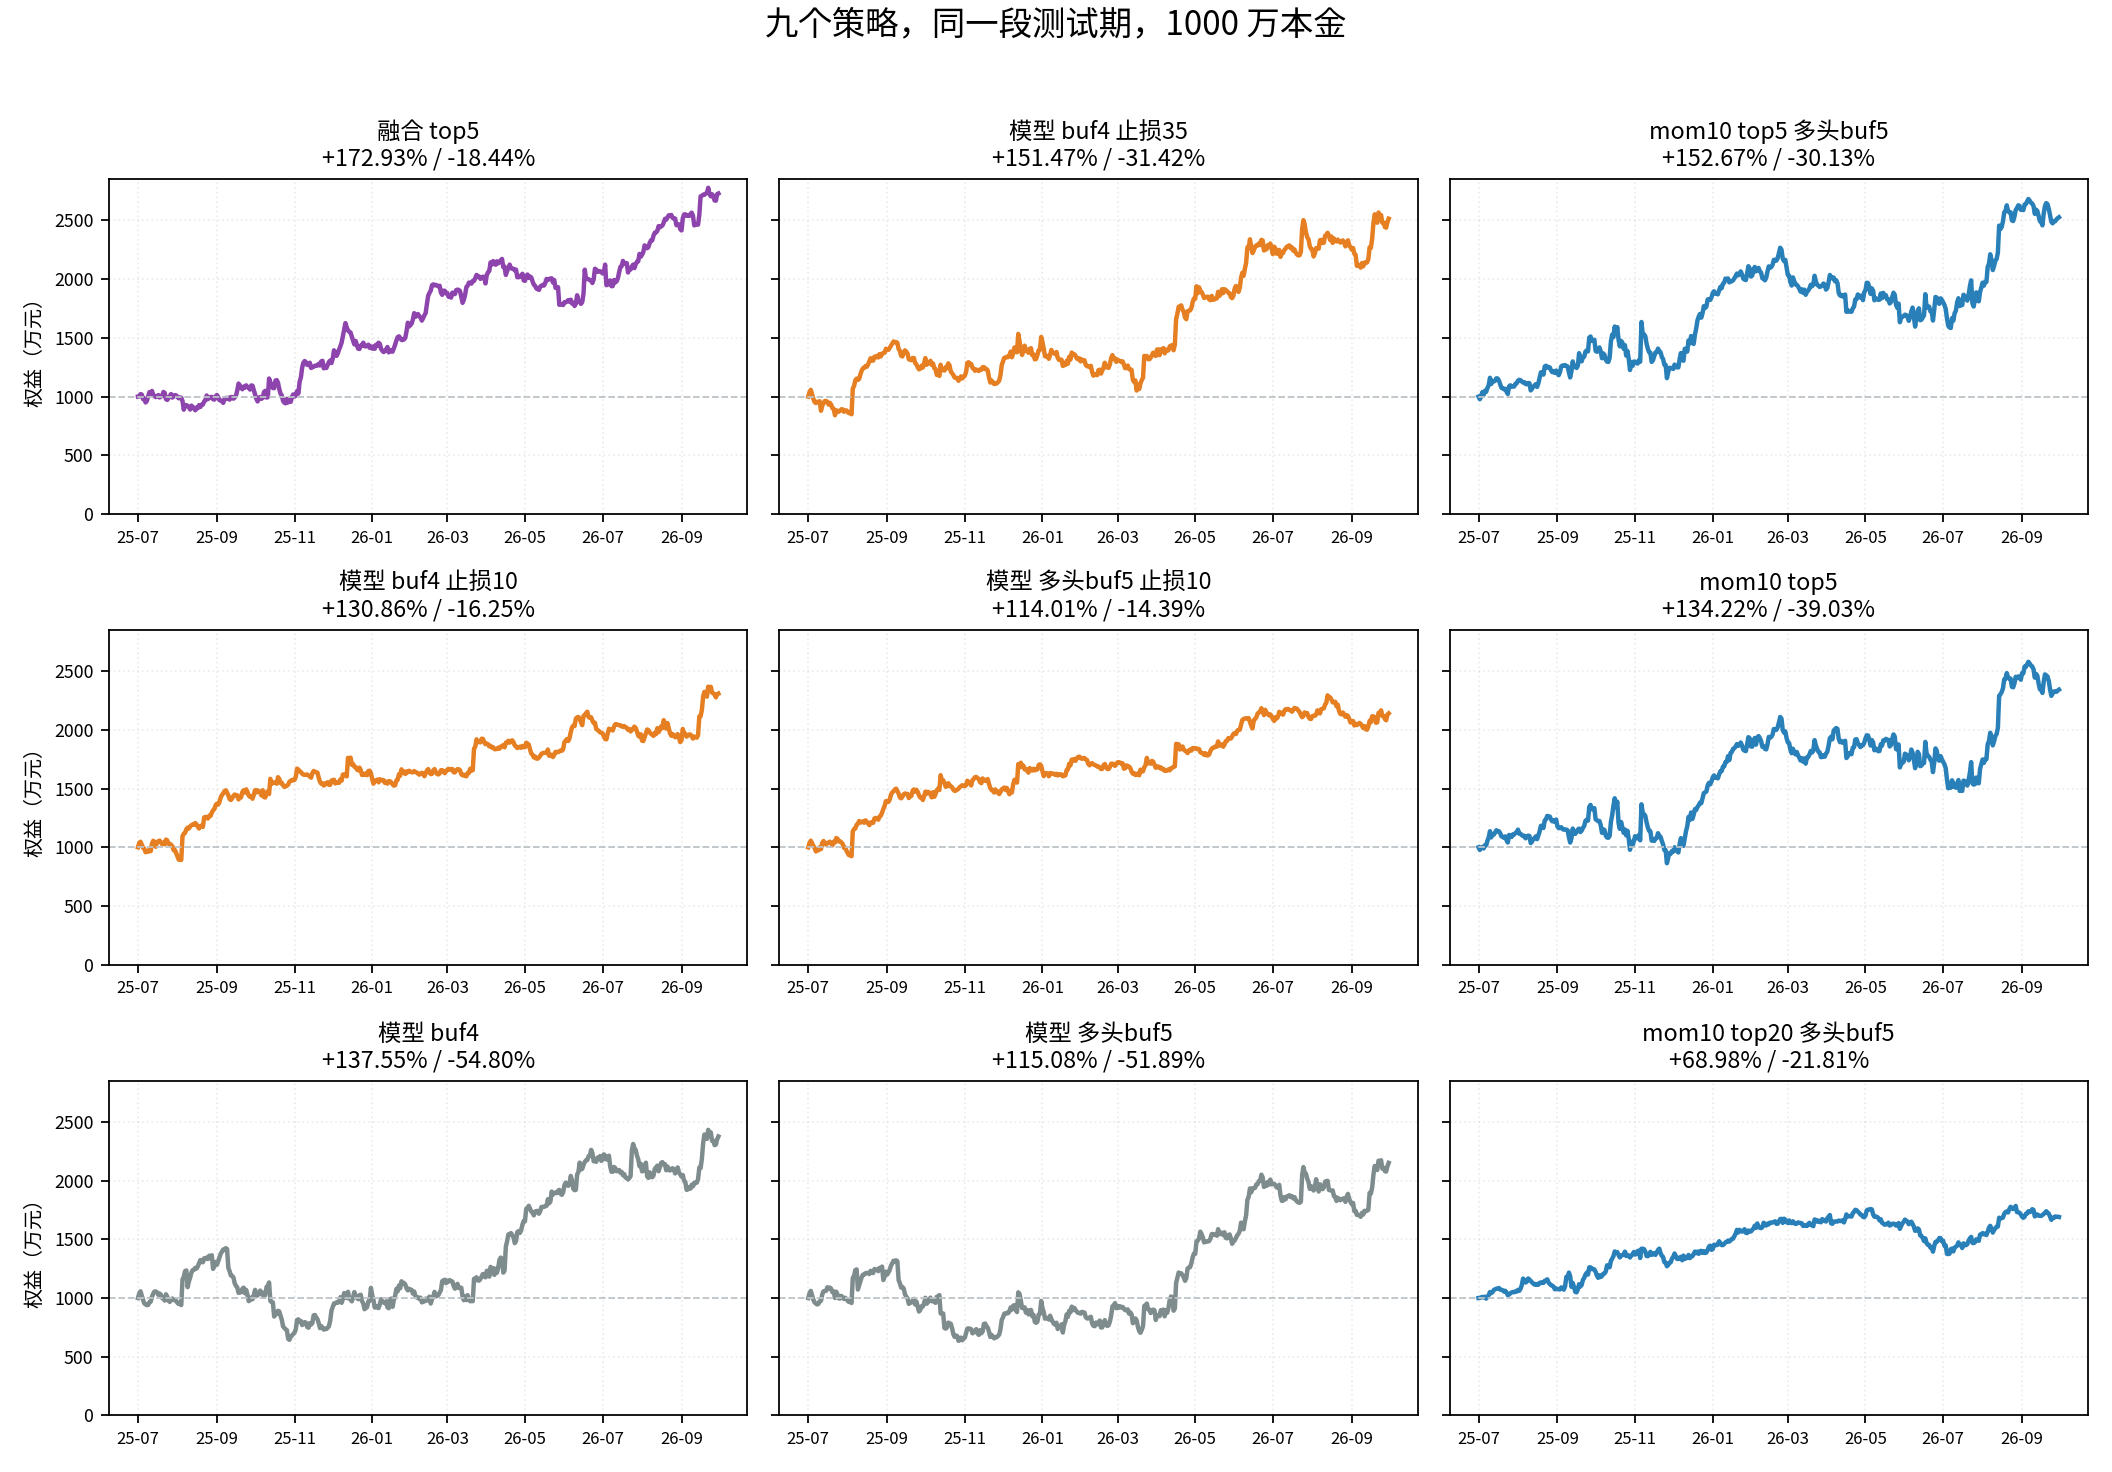
图 3:九个策略在同一段测试期、同样 1000 万本金下的净值曲线,共用纵轴。标题里的两个数字是总收益和最大回撤。
几个观察:
第一,融合仍然是第一。收益 +172.93%、回撤 -18.44%、夏普 2.076,三项都是九个策略里最好的。Calmar 7.49,也是唯一一个收益、回撤、夏普同时跑赢 mom10 最好变体的配置。只和 mom10 top5 比的话,模型 buf4 止损35 也能三项都赢,但它跑不过 mom10 多头 buffer5 的 +152.67%。
第二,止损能压回撤,但不能免费。两个 stop10 变体把回撤压到 -14.39% 和 -16.25%,夏普做到 1.846 和 1.906,但上一期已经验证过,stop10 对滑点极敏感,2% 滑点下收益几乎归零。stop35 收益 +151.47%、回撤 -31.42%,更稳,适合滑点不确定的场景。
第三,模型基线变体的回撤还在 -52% 到 -55%。buffer 把收益从负的做到 +115% 到 +137%,但没有解决尾部风险。收益改善和风险改善是两件事,不能因为收益变正就忽略回撤。
第四,mom10 top20 的收益最低,只有 +68.98%,成交 22474 次,是九个策略里交易最频繁的。持仓放宽不等于更好,交易成本会吃掉一部分收益。这也是后面必须把成本算进去的原因。
这个目录展示的是取舍,不是只有一个赢家。选哪个,取决于资金规模、滑点水平、回撤容忍度和调仓成本。
七、复现记录:commit、版本、hash
每次运行都会在 notebook 里生成一份复现记录,这次的内容是:
- 运行时间:2026-10-20T09:39:45
- git commit:`261a7147ed6810bd4e7a76397a9149f7353a6470`
- 工作区状态:有未提交改动
- Python 3.13.13,polars 1.41.2,lightgbm 4.6.0,vnpy 4.4.0
- 模型 `best_iteration`:290
- 验证段每日 IC:0.03727
- 测试段 parity 最大绝对差:0.0
六份信号的 SHA256 也全部记录:
| 信号文件 | SHA256 前 12 位 |
|---|---|
| model_test | c8e9e5642a78 |
| model_valid | 77e53a0a794b |
| mom10_test | d59cf2be7a10 |
| mom10_valid | 70e25941c252 |
| blend_mom10_test | 1d5b40457ab2 |
| blend_mom10_valid | c379b7b1bab9 |
工作区状态是有未提交改动,这一点要诚实写出来。它意味着这次结果对应的代码不是干净的 commit,严格来说,别人拿到 commit 号还不一定能完全还原。下次跑之前应该先提交,或者把 diff 一起存下来。复现记录的价值不在于好看,而在于把差异留在可追踪的地方。
下次有人问这个数字怎么来的,不用解释,把运行记录、信号 hash 和 notebook 一起给他。
八、边界和下一期
先把水分挤掉。
九个结果全部是测试期单段,2025 年 7 月到 2026 年 9 月,457 天。参数也是在这段测试期里反复选的,不是干净样本外。9/9 复现只证明代码和信号能复现这个数字,不证明这个数字能复现到未来。
模型验证段是半样本内,因为 VALID 参与了早停。mom10 验证段的币池和模型验证段不一样,跨族结果不能直接比较。资金费、强平、真实滑点、新币和低流动性过滤,这次都还没算。
下一期做三件事:把融合信号接上 buffer 和止损,跑验证期,再做 walk-forward。如果验证期站不住,+172.93% 就只是一个好看的测试期数字,得回来改。
复现不是终点,是起点。先把地基打完,再盖楼。
这个量化实验室会继续公开记录,从数据、因子到风控。觉得有用可以收藏,下一期见。