
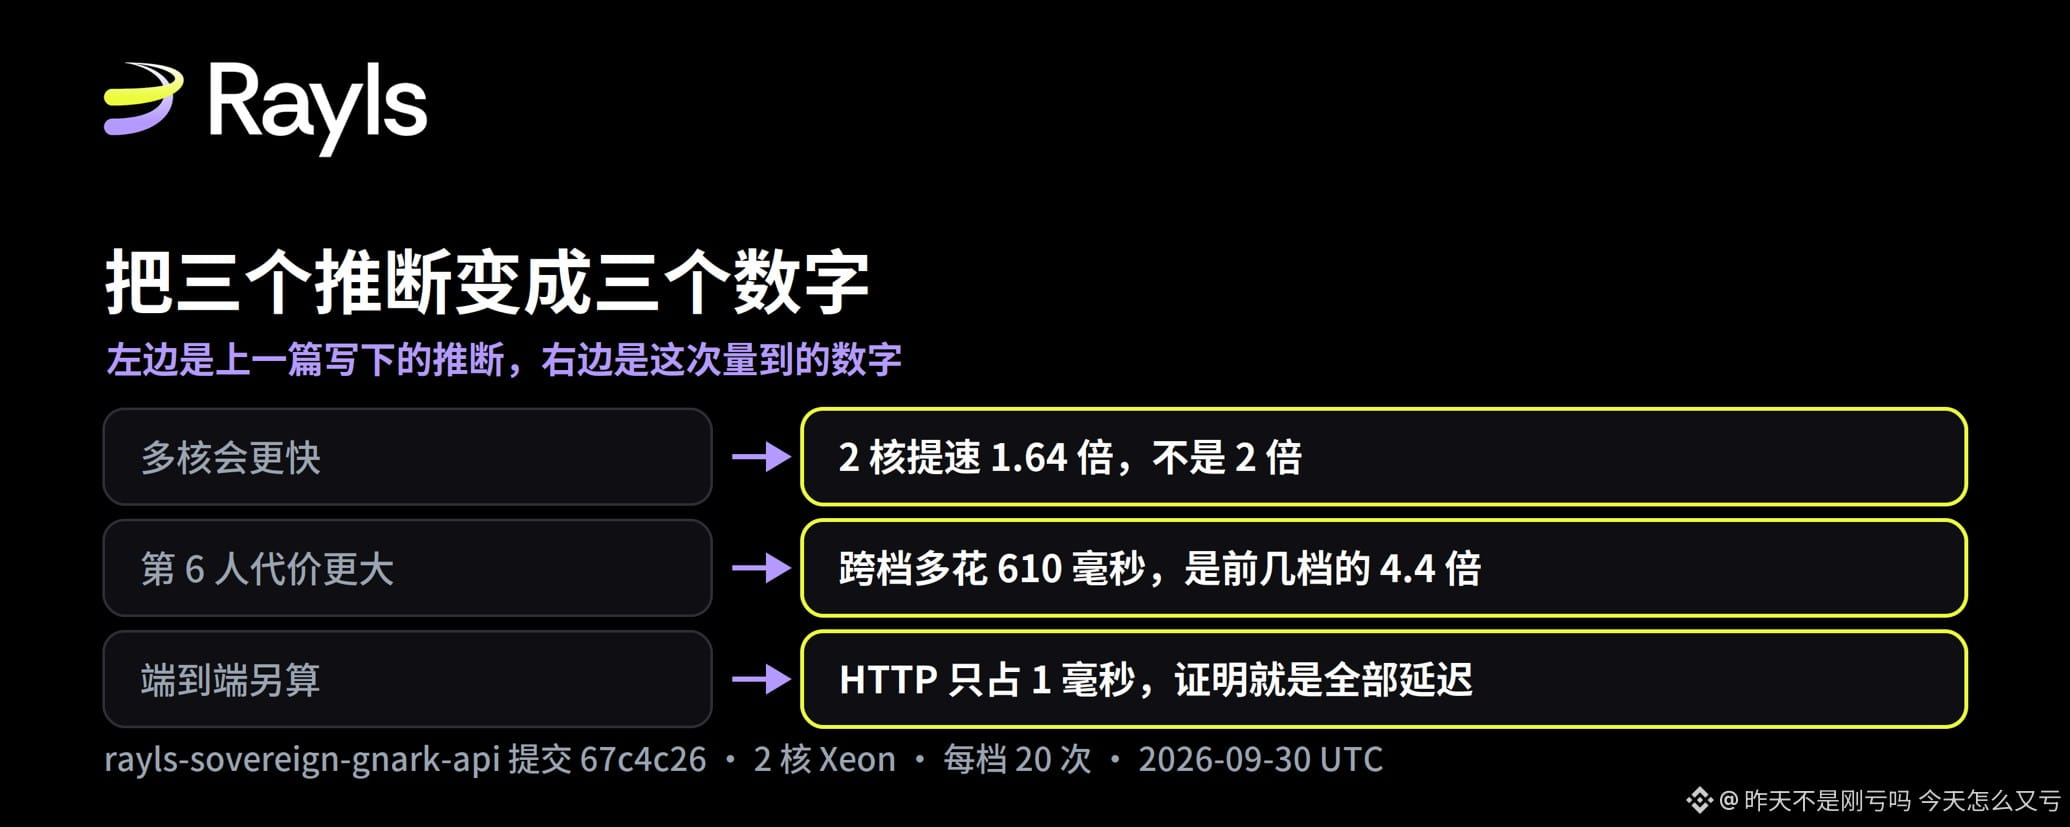
In der vorherigen Arbeit habe ich den von Rayls veröffentlichten Beweiscode einmal durchlaufen lassen und gemessen: Bei einem Anonymitätsset von 6 Personen dauert es pro Beweis 1,96 Sekunden. Aber in dem Artikel gibt es drei Sätze, die eher Schlussfolgerungen als Messungen sind – das weiß ich in meinem Kopf. Diese Woche habe ich die Maschine auf 2 Kerne umgestellt und noch ein paar zusätzliche Messdaten nachgereicht, und bin dadurch zurückgegangen, um diese drei Sätze zu ergänzen.
Zuerst klarstellen, wie diese Arbeit zur vorherigen steht, damit Leser nicht denken, es sei ein erneutes Hochladen desselben Artikels. In der vorherigen Arbeit habe ich die Beweiszeiten in einer Single-Core-Umgebung für die 2-Personen- und die 6-Personen-Stufe gemessen. Diese beiden Zahlen wurden hier erneut gemessen und sind fast unverändert. Alles Neue in diesem Artikel sind genau die drei Dinge, die in der vorherigen Arbeit nicht gemessen werden konnten und nur geschlussfolgert wurden.
Drei Dinge sind es: Wird Multi-Core wirklich schneller? Warum ist der 6. Teilnehmer besonders teuer? Welchen Anteil hat der Beweis in der End-to-End-Latenz? Im Folgenden ist alles, was „vorherige Arbeit geschlossen“ sagt, die Aussage, die ich damals gemacht habe. Was mit „diesmal gemessen“ überschrieben ist, sind die Ergebnisse dieser Arbeit.
Zuerst die Quelle der Messdaten klarstellen
Das Rayls-Repository für den Beweisservice enthält zwar Testdaten, aber nur zwei Gruppen: die 2-Personen- und die 6-Personen-Stufe. In der Mitte fehlen die Stufen 3, 4 und 5. Genau deshalb konnte ich in der vorherigen Arbeit die Zwischenwerte nicht messen. Selbst irgendeinen Wert zusammenzureimen geht nicht. Der Schaltkreis würde das sofort ablehnen; und wenn man es doch irgendwie durchbekäme, gäbe es für Leserinnen und Leser keinen Grund, ihm zu vertrauen.
Daher habe ich einen Generator geschrieben. Die Schaltungsbedingungen sind in common-checks.go im Repository hinterlegt; jede einzelne lässt sich rückwärts ableiten: Der gemeinsam genutzte Geheimschlüssel des Senders ist der Poseidon-Hash der Zufallszahl der vorherigen Runde und des privaten Schlüssels modulo der BabyJubJub-Untergruppenordnung; der öffentliche Schlüssel ist das Hashen des privaten Schlüssels modulo. Im Zufallsfaktor nimmt der Empfänger den negativen Wert des jeweiligen Hashes, während der Sender die Summe dieser Empfangswerte nimmt. Das Transaktions-Commitment ist das Pedersen-Commitment des Betrags und des Zufallsfaktors. Der Generator setzt diese Regeln eins zu eins mit den nativen Funktionen des Repositories um.
Entscheidend ist, wie man beweist, dass dieser Generator keinen Fehler hat. Mein Vorgehen: Ich benutze ihn zuerst, um die beiden Datensätze des offiziellen Projekts zu reproduzieren. Ich setze alle Felder in den offiziellen Daten, die Einschränkungen haben, vollständig auf leer, lasse nur den Seed und die öffentlichen Eingaben der anderen Teilnehmer übrig, und lasse dann den Generator alles neu ausrechnen. Danach vergleiche ich Feld für Feld. Ergebnis: Sämtliche Felder in der 6-Personen-Stufe und in der 2-Personen-Stufe stimmen exakt überein.
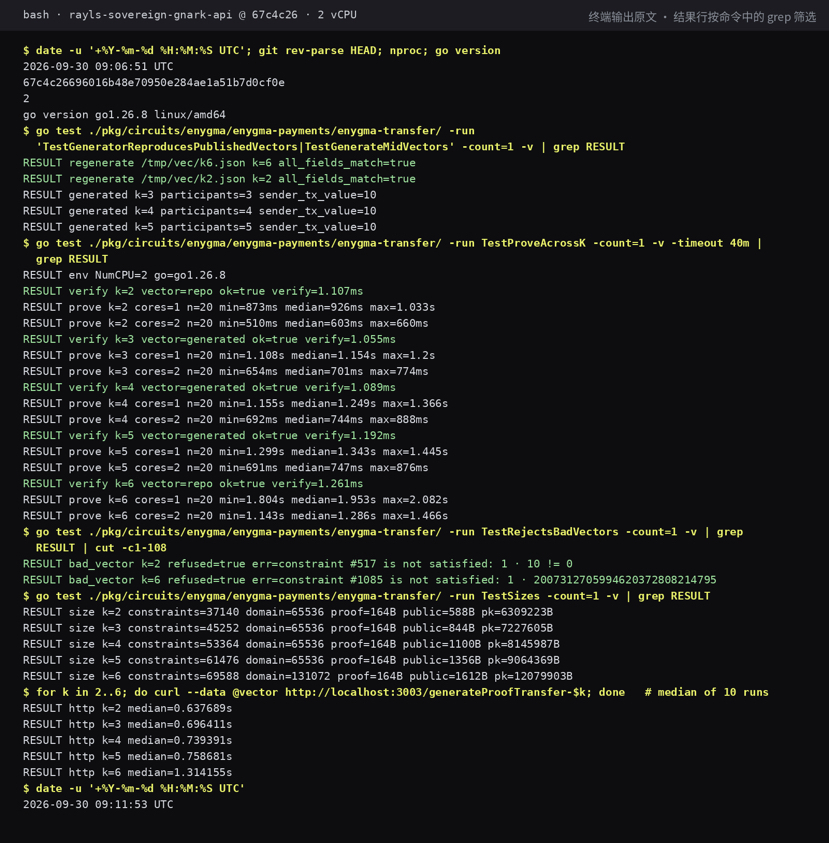
Diese beiden Datensätze wurden jeweils von Rayls unabhängig veröffentlicht. Private Key, Blocknummer, Kontostände und Überweisungsbeträge sind unterschiedlich, können aber dennoch gleichzeitig reproduziert werden – das zeigt, dass der Generator genau die Regeln implementiert, die der Schaltkreis verlangt. Danach habe ich dieselbe Logik verwendet, um aus dem Seed der 6-Personen-Stufe die Stufen 3, 4 und 5 zu erzeugen. Für jede Stufe erstelle ich zuerst den Beweis und prüfe ihn anschließend einmal mit dem jeweils passenden Verifikationsschlüssel; alles läuft durch.
Noch etwas zu erklären: Diese drei Stufen übernehmen die Überweisungsbeträge und beteiligten Parteien aus der 6-Personen-Stufe. Daher messen sie die Kosten derselben einzelnen Transaktion bei unterschiedlichen Größen des Anonymitätssets – nicht drei verschiedene Geschäftsprozesse.
Warum der 6. Teilnehmer so teuer ist
In der vorherigen Arbeit sah ich, dass die Berechnungsgröße der 6-Personen-Stufe 131.072 beträgt, während die Stufen 2 bis 5 jeweils 65.536 sind. Daraus schloss ich, dass der Wechsel von Stufe 5 zu 6 mehr kostet als die Schritte zwischen den vorherigen Stufen. Damals gab es keine Daten zu den Zwischenstufen, also blieb es bei der Schlussfolgerung.
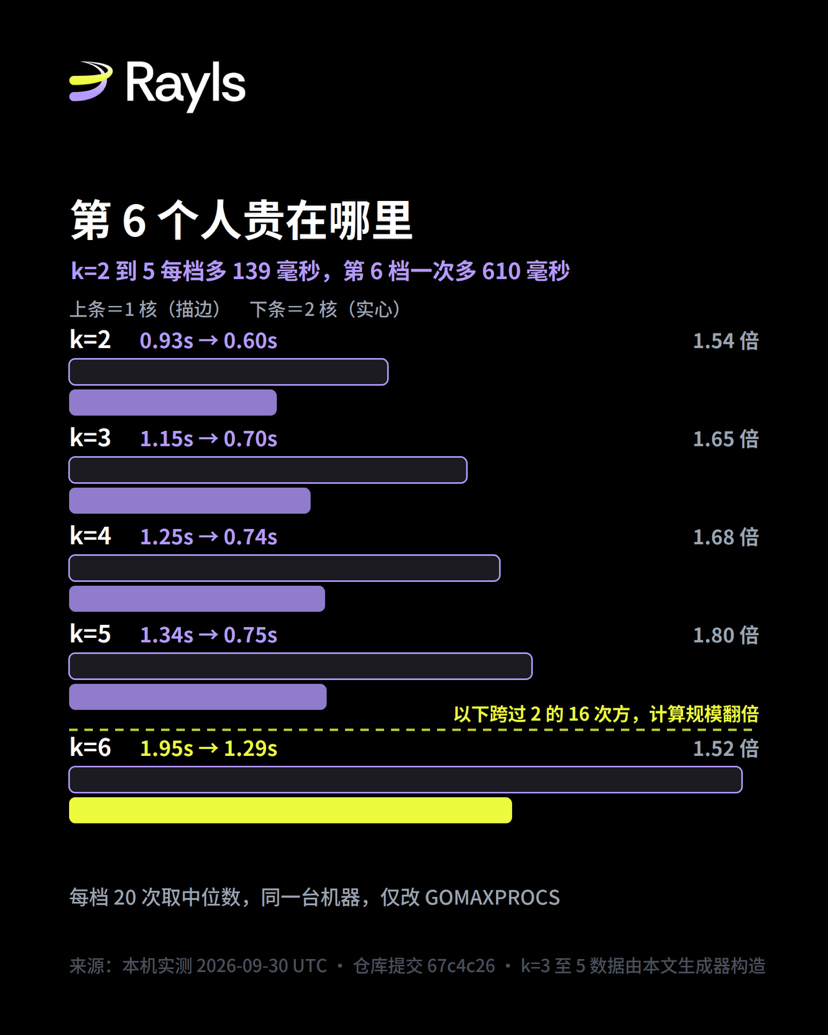
Diesmal sind die Single-Core-Medianwerte: 2 Personen 0,93 s, 3 Personen 1,15 s, 4 Personen 1,25 s, 5 Personen 1,34 s, 6 Personen 1,95 s. Zwischen den ersten vier Stufen steigt der durchschnittliche Mehrwert pro Stufe jeweils um 139 ms; vom 5. zum 6. Schritt kommt einmalig ein Plus von 610 ms dazu, also das 4,4-fache der vorherigen vier Schritte.
Die Größe der Beweisschlüssel liegt auf derselben Stufe: Von Stufe 2 bis 5 steigt jede Stufe stabil um etwa 918 KB; von 5 auf 6 kommt einmalig ungefähr 3,0 MB hinzu. Die Anzahl der Constraints selbst ist völlig gleichmäßig: Pro zusätzlichem Teilnehmer kommen stets 8.112 Constraints dazu, von 37.140 auf 69.588. Auf dieser Linie sieht man keinen Sprung.
Daher liegt der Sprung nicht in der Anzahl der Constraints, sondern in dem Rechenraum, den das Beweissystem dem Schaltkreis zuweist: Es rundet auf Potenzen von 2, und die 6-Personen-Stufe überschreitet genau 65.536. Dass Beweiszeit und Schlüsselgröße an derselben Stelle gemeinsam springen, passt zu dieser Erklärung. Ich schreibe das „konsistent“, nicht „als Beweis“. In dieser Messung habe ich nur Beweiszeit und -umfang gemessen; die internen Aufwände der einzelnen Beweisphasen habe ich nicht separat quantifiziert.
Für Nutzer ist die Bedeutung ziemlich direkt: Wenn die Größe des Anonymitätssets konfigurierbar ist, ist der Schritt zwischen 5 und 6 nicht einfach eine gleichmäßige kleine Stufe. Entweder bleibt man bei 5 stehen oder man akzeptiert einen einmaligen Sprung; dazwischen gibt es keine Kompromissposition.
Multi-Core ist nur 1,64-mal schneller
In der vorherigen Arbeit hatte ich einen Satz geschrieben: Institutionsserver sind typischerweise Multi-Core und die Laufzeit ist niedriger als bei Single-Core. Die Begründung war, dass der gnark-Beweiscode die schwerste Multi-Scalar-Multiplication nach Anzahl der CPU-Kerne aufteilt. Diese Richtung ist richtig, aber damals hatte die Maschine nur 1 Kern, daher konnte ich nicht sagen, wie groß das Vielfache ist.
Diesmal hat die Maschine 2 Kerne. Auf derselben Maschine ändere ich nur GOMAXPROCS; alles andere bleibt unverändert. Die Beschleunigungsfaktoren für die fünf Stufen sind 1,54, 1,65, 1,68, 1,80 und 1,52; im Mittel 1,64. Es kommt nicht auf 2 Faktoren hinaus.
Warum nicht 2-mal: In Code lässt sich ein Teil der Gründe sehen. Die Multi-Scalar-Multiplication wird tatsächlich entsprechend der Kerne aufgeteilt, aber im Beweisprozess gibt es auch Zeugnis-/Witness-Lösungen und einige serielle Schritte, die sich nicht durch mehr Kerne verkürzen. Ich kann nur sagen, dass die beobachteten Ergebnisse mit dieser Erklärung übereinstimmen; ich habe keine detaillierte Verifikation Schritt für Schritt aufgeschlüsselt.
Dieses Vielfache hat Einfluss auf die Deployments-Auswahl, und die Richtung ist sogar umgekehrt zur Intuition. Rechnet man nach der 6-Personen-Stufe, kann ein Single-Core-Rechner pro Sekunde 0,51 Beweise erstellen, ein Dual-Core-Rechner 0,78. Um den gleichen Durchsatz zu erreichen, muss man mit dem Dual-Core-Rechner paradoxerweise mehr Kerne einsetzen, aber die Wartezeit pro Beweis ist um ein Drittel geringer. Wer den Durchsatz optimieren will, stapelt eher Single-Core-Arbeitsmaschinen; wer die Latenz pro Beweis senken will, gibt jedem Beweis mehr Kerne. Beide Ziele kann man nicht gleichzeitig optimal erfüllen.
In der vorherigen Arbeit habe ich nur die Beweisfunktion gemessen und nicht den kompletten Service durchlaufen. Deshalb hatte ich damals JSON-Parsing und Netzwerk-Overhead als nicht gemessen aufgeführt.
Diesmal habe ich den Service tatsächlich richtig kompiliert und zum Laufen gebracht und echte HTTP-Requests per curl gesendet. Der Service misst sich selbst in Zeitabschnitten, die Ausgabe lautet: Request-Bindung 0,1 ms, Parameter-Parsing 0,1 ms, Beweisgenerierung 1.300 ms, Serialisierung nahe 0. Der mit curl gemessene End-to-End-Medianwert beträgt 1,314 Sekunden; intern addiert der Server 1,300 Sekunden. Die Differenz liegt zwischen 1 und 14 ms und macht ungefähr ein Hundertstel des gesamten Requests aus.
Das Fazit ist so schlicht wie folgt: Für diesen Pfad ist die Beweisgenerierungszeit im Wesentlichen gleich der End-to-End-Latenz; die HTTP-Schicht kann man ignorieren. In der vorherigen Arbeit hatte ich beides getrennt als noch zu messende Punkte aufgeführt; jetzt kann man es zusammenführen.
Außerdem habe ich noch etwas gemessen, das die vorherige Arbeit überhaupt nicht erwähnt hat: Cold Start. Der erste Request pro Stufe dauert 2,5 bis 4,5 Sekunden, danach stabilisiert es sich, weil der Service die Beweisschlüssel von 6 bis 12 MB von der Platte in den Speicher einliest und cached. Für ein Deployment mit elastischer Skalierung nach Bedarf muss diese Zeit in die Kapazitätsplanung eingerechnet werden, nicht nur der stationäre Zustand.
Noch eine Ergänzung zum Umfang: Der Beweis selbst ist fix 164 Bytes; alle fünf Stufen haben den gleichen Beweisumfang. Die mit dem Beweis zusammen veröffentlichten öffentlichen Daten wachsen linear: von 588 Bytes bei der 2-Personen-Stufe auf 1.612 Bytes bei der 6-Personen-Stufe. Pro zusätzlichem Teilnehmer kommen jeweils genau 256 Bytes dazu.
Nach der durchschnittlichen Rate innerhalb des Fensters gerechnet: CHAPS hat im Tagesmittel 210.483 Transaktionen, das entspricht 4,87 pro Sekunde. Dafür braucht man mit einem Single-Core-Worker etwa 9,5 Kerne. Fedwire hat im Tagesmittel 869.187 Transaktionen, also 10,97 pro Sekunde – das erfordert etwa 21,4 Kerne. Der im Datensatz der Bank of England verzeichnete CHAPS-Rekord für die Anzahl von Buchungen pro Tag ist 320.034 am 29. März 2018; über dasselbe Zeitfenster entspricht das 7,41 pro Sekunde, also etwa 14,5 Kerne.
Zum Vergleich sieht man, wie wichtig die Definition ist: CHAPS lässt sich nach einer 24-Stunden-Aufteilung mit nur 4,8 Kernen rechnen; bei einem echten 12-Stunden-Fenster sind es 9,5 – also exakt die doppelte Zahl. Fedwire liegt, weil das Zeitfenster ohnehin nahe an einem ganzen Tag ist, bei beiden Algorithmen nur um 9% auseinander.
Noch nicht eingerechnet sind ein paar Punkte; Leser können sie selbst ergänzen: Die Tages-Spitzen innerhalb des Zeitfensters liegen über dem Durchschnitt im Zeitfenster, die Last der einzelnen Institutionen ist nicht gleichmäßig verteilt, und in der Abrechnungskette gibt es noch Schritte außerhalb der Beweisführung. Außerdem wird der Beweis von den jeweiligen Absendern selbst erzeugt, sodass sich die Last natürlicherweise verteilt und nicht auf einer einzigen Maschine konzentriert.
Bestätigt, was genau – und was noch fehlt
Bestätigt wurde: die Beweiszeiten und Verifikationszeiten für die fünf Stufen, die Beschleunigungsraten bei Single- vs. Dual-Core, die Kosten für den Schritt über die Grenze der Berechnungsgröße hinweg, die Differenz zwischen End-to-End und Beweisgenerierung, die Cold-Start-Zeit, die Größe der Beweise und der öffentlichen Daten, dass der Generator die beiden offiziellen Datensätze reproduzieren kann, und dass absichtlich fehlerhaft gemachte Daten abgelehnt werden. Diese Ergebnisse lassen sich alle anhand der in den Screenshots gezeigten Befehle erneut ausführen.
Noch nicht: Ich habe nur das Transaktionsschaltkreis-Transfer-Board getestet; das Einzahlen, Abheben und DvP sind noch andere Kategorien. 2 Kerne sind auch nur ein sehr kleiner Stichprobenumfang; welche Form die Kurven bei mehr Kernen haben, habe ich keine Daten. Ich habe nur auf einem einzigen Rechner gemessen; bei einem Wechsel der Hardwareplattform ändern sich die Ergebnisse. Die Parameter für die drei Stufen stammen gemeinsam aus derselben Transaktion. In der gesamten Abrechnungs-Chain wurden keine Teile außer der Beweisführung angefasst. Zu dem in der vorherigen Arbeit monierten Formulierungspunkt habe ich hier ebenfalls eine Korrektur vorgenommen: Der Geheimschlüssel des Rechners und die offiziellen Build-Artefakte haben die gleiche Größe; was das belegt, ist, dass die kompilierte Größe gleich ist, nicht dass die Schaltlogik gleich ist.
Meine Einschätzung
Der nützlichste Erkenntnisgewinn bei dieser Arbeit ist nicht irgendeine konkrete Zahl, sondern das Ersetzen der drei Hypothesen durch drei reproduzierbare Ergebnisse – wobei eine davon sogar durch die eigenen Messungen korrigiert wurde: Mehrkern ist zwar richtig schneller, aber nur um den Faktor 1,64, nicht um die erwarteten 2 Faktoren.
Für Leser ein überprüfbares Kriterium: Beim nächsten Mal, wenn ihr Leistungszahlen aus irgendeinem Privacy-Ansatz seht, fragt erst drei Dinge: Wie groß ist das Anonymitätsset bzw. die Anzahl der beteiligten Parteien? Auf wie vielen Kernen läuft das? Und bezieht sich die Zahl auf die Beweisführung selbst oder auf End-to-End? Nur wenn alle drei Fragen eindeutig beantwortet werden können, lohnt sich die Verwendung dieser Zahlen für die Kapazitätsplanung. Diese drei Punkte beantwortet der Artikel genau selbst – die Befehle sind in den Screenshots.
Referenzen: GitHub raylsnetwork/rayls-sovereign-gnark-api, Commit 67c4c26 (abgerufen und im Realbetrieb gemessen am 30.09.2026); Rayls offizieller Blog (Privacy has a price: the honest math behind confidential settlement at scale) (19.09.2026); jährliche Statistik des US Federal Reserve Fedwire Funds Service (aktualisiert am 26.01.2026); Bank of England Payment and settlement statistics, (A brief introduction to RTGS and CHAPS) sowie das Konsultationsdokument zur Verlängerung der Abrechnungszeit im Mai 2026.