

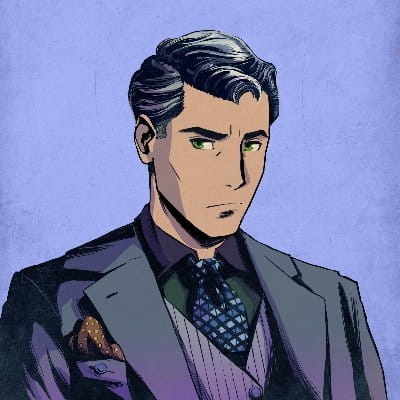
Ich habe vier KI-Modelle auf kreative Improvisation getestet, indem ich ihnen dasselbe Bild gab und sie bat, eine lustige Sitcom-Szene zu schreiben.
Die Herausforderung: Können diese Modelle wirklich Comedy? Die meisten LLMs sind auf formalen Text trainiert und haben Schwierigkeiten mit Timing, Absurdität und der Figurenstimme – dem Kern des Sitcom-Schreibens.
Zentrale technische Frage: Wie gut schaffen Vision-Sprach-Modelle es, visuellen Kontext in die Erzählgenerierung mit komödiantischem Ton zu übertragen? Das prüft sowohl das multimodale Verstehen als auch das kreative Textgenerieren unter Vorgaben.
Es lohnt sich zu prüfen, ob irgendein Modell die Setup-Punchline-Struktur wirklich getroffen hat – oder ob alle nur das Bild mit erzwungenem Humor beschrieben. Der echte Test ist, ob diese Systeme komödiantisches Timing verstehen oder nur Witz-Vorlagen nach Muster abgleichen.