

Am 19. September schickte Rayls einen Beitrag mit dem Titel „(Privacy has a price)“. Darin stand im Titel „honest math“, aber der ganze Text lieferte nur einen Zahlenbereich: Ein Beweis braucht von ein paar hundert Millisekunden bis zu ein paar Sekunden. Ich schreibe seit Wochen an Rayls’ Privacy-Architektur, und diesmal teile ich mit euch neue Inhalte. Ich habe mir den veröffentlichten Beweiscode heruntergeladen, ihn praktisch ein paar Dutzend Mal laufen lassen und teile mit euch dieses spannende Ergebnis!
Zuerst: Worum ging es im Blog? Die Kernthese lässt sich auf zwei Sätze verdichten. Der erste Satz lautet: Wo entstehen die Kosten? Vertrauliche Transaktionen sind teurer als transparente – teuer ist vor allem die Generierung von Zero-Knowledge-Beweisen; das Verifizieren ist hingegen günstiger. Ein Beweis für eine grundlegende vertrauliche Überweisung dauert auf gewöhnlicher, kommerzieller Hardware ein paar hundert Millisekunden bis zu ein paar Sekunden. Der zweite Satz lautet: Was sollte man fragen? Institutionen sollten nicht nur nach TPS fragen, sondern danach, wie hoch der Durchsatz ist, wenn man den eigenen Bedarf an Privatsphäre und Prüf-/Auditierbarkeit sowie echte Workloads berücksichtigt. Der Blog meint, dass das Volumen zwischen Banken nicht groß ist und damit völlig im Rahmen der Leistungsfähigkeit von Systemen für vertrauliche Abwicklung liegt.
Dieser Artikel macht im Grunde nur Folgendes: die von dem Blog selbst aufgeworfene Frage nimmt er und stellt sie dem öffentlich verfügbaren Code von Enygma. Alles, was im Folgenden mit „der Blog sagt“ eingeleitet wird, sind Behauptungen aus dem Original; „ich habe gemessen“, „ich habe berechnet“ sind meine eigenen Ergebnisse und Ableitungen—bitte getrennt betrachten.
Wie ich gemessen habe
Zero-Knowledge-Beweise kann man sich als ein mathematisches Zahlungszertifikat vorstellen: Der Zahlende macht Kontostand und Betrag nicht öffentlich, kann aber dem Netzwerk beweisen, dass diese Transaktion korrekt ist. Das von Enygma verwendete Beweissystem heißt Groth16. Der Service-Code, der Beweise generiert, ist im GitHub-Repo rayls-sovereign-gnark-api offen zugänglich; im README wird die Funktion als Proof-Interface hinter Privacy Ledger und Private Network Hub beschrieben.
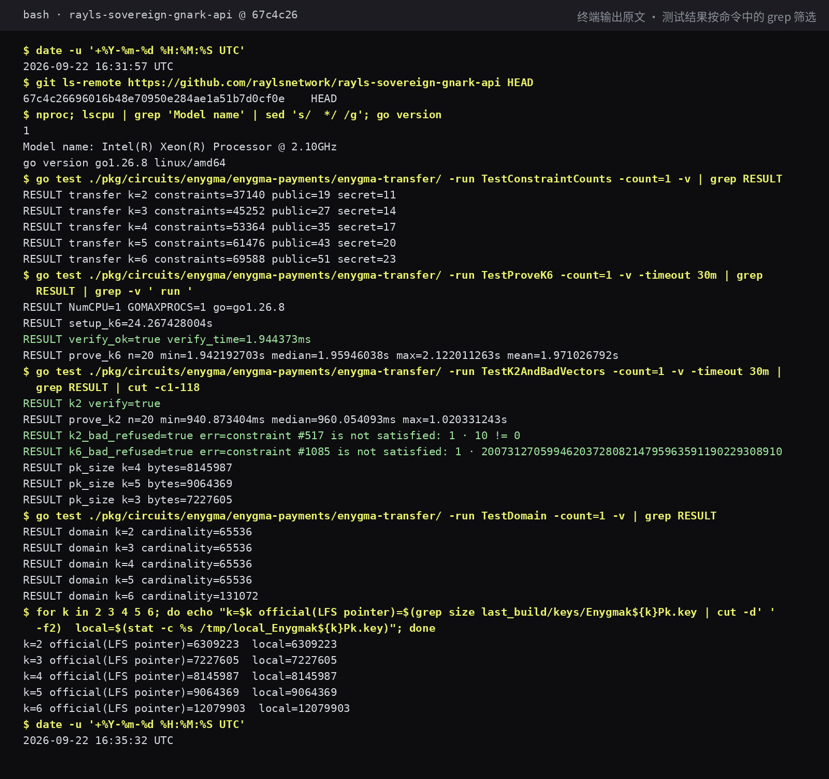
Ich habe das auf dem aktuellen Stand der main-Branch am 22. September 2026 mit dem neuesten Commit 67c4c26 gemessen. Schaltungs- und Beweiscodes wurden kein einziges Mal verändert. Ich habe nur ein paar Testdateien zusätzlich geschrieben, um die eigenen Beweisfunktionen des Repos aufzurufen; die eingespielten Transaktionsdaten stammen ebenfalls aus dem im Repo enthaltenen Testset, jeweils eine Gruppe für k=2 und eine für k=6.
Hier ist k die Größe der Anonymitätsmenge. Laut Schaltungscode generiert eine Überweisung für jede der k beteiligten Parteien jeweils einen Betrags-Commitment; der Absender bleibt darin verborgen, sodass Außenstehende nicht erkennen können, wer wem zahlt. Je größer k ist, desto tiefer ist das Verstecken und desto größer ist auch die Schaltung. Das im Repo enthaltene Load-/Pressure-Test-Skript nutzt k=6.
Der Schlüssel wurde von mir auf meinem eigenen Rechner mit dem identischen groth16.Setup erzeugt. Das beeinflusst die Laufzeit nicht, denn die Beweiszeit hängt von der Schaltungsstruktur ab und ist unabhängig vom konkreten Schlüsselwert. Auch das README des Repos sagt, dass diese Schlüsselfassung im Repo selbst ein einseitiges Setup-Erzeugnis für Entwicklungs- und Tests ist und nicht das Ergebnis einer vertrauenswürdigen Multi-Party-Setup-Zeremonie. Für den Produktionsbetrieb wird eine eigene Zeremonie benötigt—das stimmt mit der Aussage des Blogs überein, dass Groth16 ein vertrauenswürdiges Setup erfordert.
Die Testumgebung ist eine Single-Core-Linux-VM: Intel Xeon 2,1 GHz, 3 GB RAM. Pro Stufe werden jeweils 20 Beweise fortlaufend generiert; nach ein paar Minuten läuft die komplette Testserie erneut als zweite Runde.
Die daraus resultierenden Zahlen
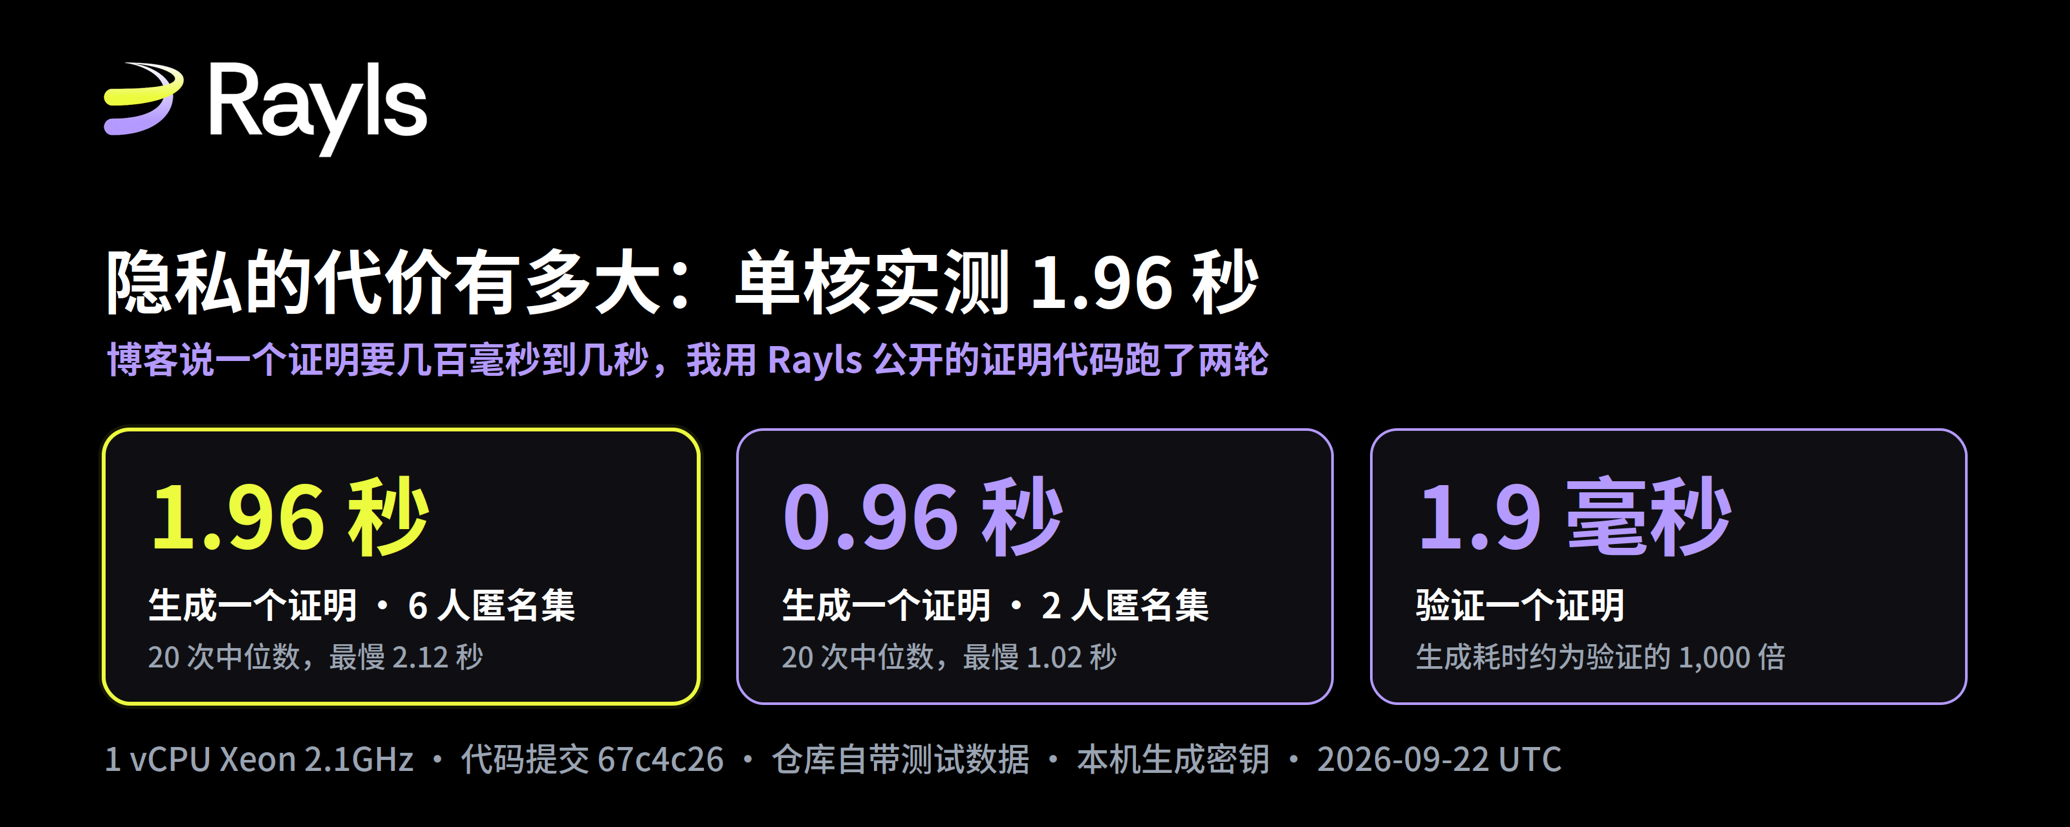
Ergebnis der zweiten Runde: Beweise für k=6: 20 Messungen, Median 1,96 Sekunden; schnellste 1,94 Sekunden; langsamste 2,12 Sekunden. Der Median für k=2 liegt bei 0,96 Sekunden. Die erste Runde lag jeweils bei 1,97 Sekunden und 0,96 Sekunden; die Differenz zwischen den beiden Runden liegt unter 1%. Eine Verifizierung dauert nur 1,9 Millisekunden.
Diese Zahlen liegen im von dem Blog angegebenen Bereich. Noch interessanter ist das Verhältnis von Generierung zu Verifizierung: 1,96 Sekunden zu 1,9 Millisekunden—ungefähr 1.000 zu 1. Der Blog sagt, die meiste Zeit werde für die Generierung aufgewendet, Verifizierung sei sehr billig. Dieses Verhältnis macht aus dem Wort „hauptsächlich“ eine konkrete Faktorzahl.
Ich habe außerdem eine Rückwärtsprüfung gemacht. Dem Testset waren zwei Gruppen absichtlich verfälschter Daten beigelegt: In der k=2-Gruppe wurde ein Überweisungsbetrag von 0 auf 10 geändert; in der k=6-Gruppe wurde ein Hash-Wert manipuliert. Beide Gruppen wurden in der Beweisphase abgelehnt; jeweils mit der Meldung, dass die Constraint Nr. 517 bzw. Nr. 1085 nicht erfüllt ist—es konnte kein Beweis erzeugt werden. Das kann natürlich nicht beweisen, dass es im Schaltkreis keine Schwachstellen gibt; es zeigt lediglich, dass diese zwei Arten offensichtlicher Manipulationen abgeblockt werden.
Details, die in den zwei Blogs nicht vorkommen
Das erste Detail liegt in der Größe des Schaltkreises. Mit jeder zusätzlichen beteiligten Partei steigt die Anzahl der Constraints konstant um 8.112; von k=2 mit 37.140 Fällen geht es linear bis k=6 mit 69.588. Allerdings rundet das Beweissystem den Rechenraum, den es dem Schaltkreis zuweist, auf ganze Potenzen von 2 auf. Von k=2 bis k=5 passt alles in 65.536; k=6 überschreitet die Grenze um 4.052, wodurch sich die Rechengröße direkt verdoppelt auf 131.072.
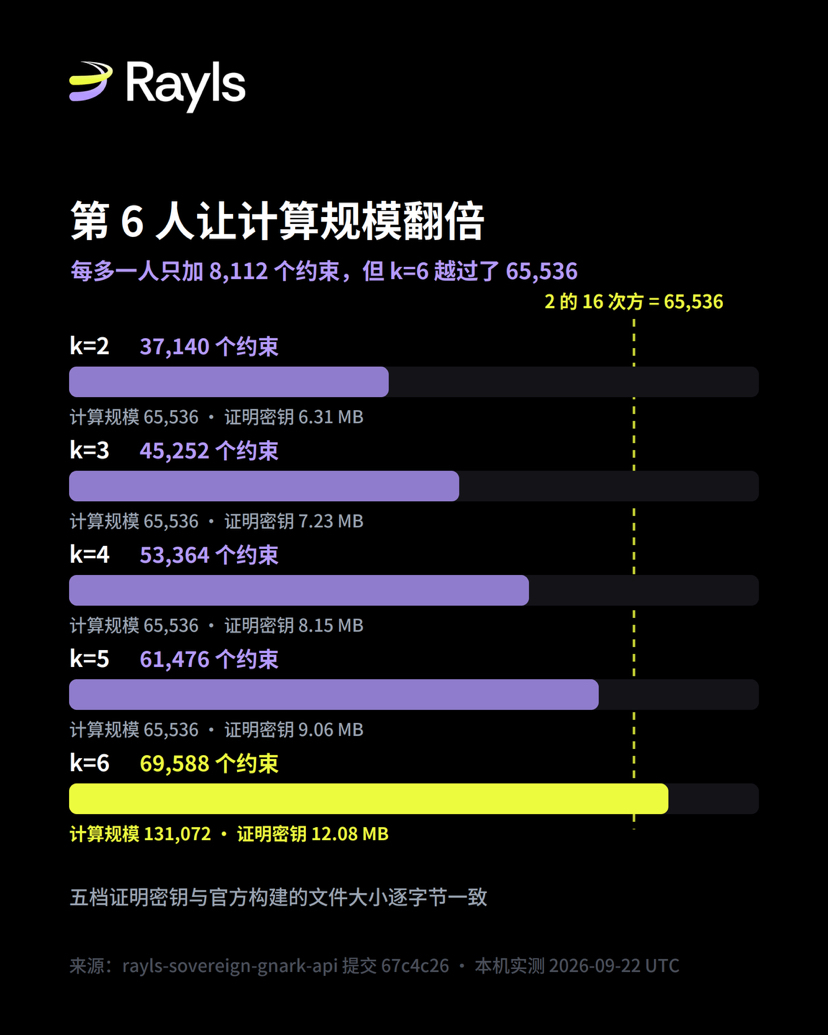 Der Beleg liegt in der Dateigröße der Beweisschlüssel. Von k=2 bis k=5 steigt die Schlüssellänge pro Stufe stabil um 918.382 Bytes; von k=6 kommt dann ein sprunghafter Anstieg um 3.015.534 Bytes—mehr als das Dreifache der vorherigen Stufen. Auch die Richtung der Laufzeit passt dazu: Von k=2 bis k=6 kommen +87% bei den Constraints, und die Beweiszeit steigt um +104%. Wie viel Zeit man genau für diesen Schritt über die Grenze hinaus zusätzlich braucht, lässt sich erst dann sauber trennen, wenn Transaktionsdaten für k=3 bis k=5 vorliegen; das Repo stellt derzeit nur zwei Stufen bereit, k=2 und k=6. Daher ist das, was man jetzt bestätigen kann, die Übereinstimmung der Richtung. Wenn in der Produktion tatsächlich k=6 verwendet wird, sitzt das Ganze genau auf der anderen Seite dieser Grenze: Die Kosten, von k=5 auf k=6 zu wechseln, wären dann höher als zwischen den vorherigen Stufen—das ist meine Einschätzung, nicht die Darstellung des Blogs.
Ein zweites Detail ist Konsistenz. Ich habe aus dem öffentlich verfügbaren Quellcode fünf Stufen von Beweisschlüsseln generiert: Dateigröße und die offiziellen Build-Artefakte des Repos sind bytegenau identisch, bis aufs Byte exakt gleich; auch der Verifizierungsschlüssel für k=6 ist identisch. Der Inhalt der Schlüssel muss zwangsläufig unterschiedlich sein, weil bei jedem Setup neu randomisiert wird. Die Größe ist jedoch exakt gleich—das zeigt, dass die aus dem öffentlichen Quellcode kompilierte Schaltungsstruktur dieselbe ist wie die offizielle Build-Konfiguration. In dem vorherigen Beitrag hatte ich erwähnt, dass es zwischen dem öffentlichen Repo und der privaten Version im Audit eine nicht nachvollziehbare Historie gibt. In diesem Fall beim Beweisservice passt zumindest der Teil „Quellcode vs. offizieller Build“ zusammen. Ob der offizielle Build mit dem Produktions-Deployment identisch ist, lässt sich aus den öffentlichen Materialien noch nicht beantworten.
Setze die Fragen aus dem Blog in echte Lasten um
Zuerst an den vorherigen Beitrag anschließen. In dem Beitrag habe ich die Quellen mehrerer Zahlen aus einem Bereich von über 15.000+ TPS zerlegt; sie beschreiben die Konsensschicht von Axyl. In diesem Test messe ich eine andere Schicht, nämlich die Beweiszeit, die pro vertraulicher Transaktion beim Absender zuerst aufgewendet werden muss. Die Zahlen der beiden Schichten können weder addiert werden noch sich gegenseitig ersetzen.
Die Größenordnung, die der Blog nennt, ist: Große Proxy-Bankenbeziehungen mit täglich einigen tausend Transaktionen; ein tokenisierter Echtzeit-Gesamtabwicklungsservice auf Zentralbankniveau mit täglich zehntausenden Transaktionen im größeren Umfang. Ich habe stattdessen zwei bereits vorhandene Systeme mit öffentlichem Datenmaterial verwendet: Der Fedwire Funds Service hat 2025 einen durchschnittlichen Tageswert von 869.187 Transaktionen; CHAPS in Großbritannien hat 2025 einen durchschnittlichen Tageswert von 210.483 Transaktionen. Diese liegen jeweils um ein Vielfaches über den im Blog genannten Beispielen—einige Dutzend bzw. mehrere Male.
Das ist, was ich berechnet habe, nicht die Darstellung des Blogs. Gemäß der Verifizierungsmessung auf einem Single-Core: 1,96 Sekunden pro k=6-Beweis, pro Core an einem Tag höchstens etwa 44.000 Beweise. Wenn man die gesamten durchschnittlichen Tagesanzahlen der Fedwire 2025 komplett durch k=6-Beweise ersetzt, braucht man ungefähr 473 Kernelstunden—entspricht etwa 20 Core-Tagen ohne Unterbrechung. Für CHAPS benötigt man etwa 115 Kernelstunden, weniger als 5 Core. In den Einführungsmaterialien der Bank of England aus dem Jahr 2021 ist vermerkt, dass der Rekord der CHAPS-Tagesanzahl am 29. März 2018 bei 320.034 Transaktionen lag—etwa das 1,7-fache des durchschnittlichen Tageswerts des betreffenden Jahres. Bei Ansatz dieses Peaks käme man ebenfalls nur auf etwa 174 Kernelstunden.
Dieser Rechenrahmen muss klar gemacht werden. Er rechnet pro Beweis einen Kernverbrauch um; die Beweise sind unabhängig voneinander und können auf verschiedene Kerne verteilt parallel generiert werden. Es wird dabei der Transfer-Beweis selbst berechnet; Einzahlungen, Auszahlungen und DvP gehören zu anderen Schaltkreisen. Außerdem sind Netzwerkübertragung und On-Chain-Abwicklung nicht enthalten. Darüber hinaus sagt der Blog, dass die Beweise vom Absender erzeugt werden—damit ist die Last von Natur aus über die eigenen Knoten jeder Institution verteilt und nicht auf eine einzelne Maschine konzentriert.
Mein Fazit lautet: Der Blog sagt, dass das Volumen des Interbankenausgleichs innerhalb der Kapazität eines Systems für vertrauliche Abrechnung liegt—und diese Einschätzung gilt auch bei realistischen Größenordnungen weiterhin. Das vom Blog selbst herangezogene Volumen ist kleiner als das der realen Systeme; wenn man die echten Zahlen einsetzt, bleibt die Schlussfolgerung trotzdem tragfähig. Das ist sogar überzeugender als die Beispiele im Original. Im Abschnitt zu Retail-Zahlungen räumt der Blog selbst ein, dass das wirklich die Engstelle ist; diese neuen Zahlen ändern dieses Urteil nicht.
Wie soll man diese Zahlen verwenden?
Alle diese Zahlen stammen aus Messungen auf einem einzigen Core und können als eher konservativer Referenzwert gelten. Der Grund liegt im Code: Bei gnark werden beim Generieren des Beweises die schwersten Multi-Scalar-Multiplications-Vorgänge gemäß der Anzahl der CPU-Kerne der Maschine in mehrere Aufgaben parallel aufgeteilt (direktes Lesen von runtime.NumCPU() in backend/groth16/bn254/prove.go). Institutionelle Server sind typischerweise Multi-Core; derselbe Beweis wird dann auf mehr Kerne verteilt und berechnet, sodass die Laufzeit unterhalb der hier gemessenen Single-Core-Zeit liegen dürfte. Wie viel schneller das genau ist, hängt von der Kernanzahl und der Single-Core-Leistung ab.
Der Messbereich dieses Artikels ist allein die Beweisgenerierung selbst für den Zahlungsnachweis- (Transfer-) Schaltkreis. In einer vollständigen HTTP-Servicelaufkette kommen noch JSON-Parsing und Netzwerk-Overhead hinzu; Einzahlungen, Auszahlungen und DvP sind wiederum andere Schaltkreise. Dass die Schlüsselgrößen gleich sind, bedeutet, dass die Schaltungsstruktur identisch ist, aber nicht, dass die Schlüsselinhalte gleich sind—das habe ich zuvor bereits erklärt.
Meine Einschätzung
Der Titel des Blogs lautet „honest math“. Die Zahlen im Text geben jedoch nur einen Bereich an. Nach diesem Run stimmt der Bereich; auch der Schlussfolgerungsteil zur Interbank-Abwicklung steht weiterhin.
Ich möchte vor allem das Nächste sehen: Auf der Benchmark-Seite von Axyl stehen die Bedingungen, etwa ein Vier-Knoten-Komitee und Transaktionen mit 512 Bytes. Die Beweisleistung von Enygma verdient eine ebenso konkrete Behandlung: Wenn beim nächsten Veröffentlichen von Zahlen der k-Wert und die Hardware-Konfiguration angegeben werden, können Institutionen—wie ich—die Ergebnisse selbst reproduzieren. Das ist genau die Art von Leistungsbehauptung, die der Blog zuletzt als „produktionsreif“ verstanden haben möchte. Die Reproduktion ist nicht schwer; die Befehle im Screenshot sind der vollständige Ablauf.
Referenzen: Rayls offizieller Blog (Privacy has a price: the honest math behind confidential settlement at scale) (19. September 2026); GitHub raylsnetwork/rayls-sovereign-gnark-api, Commit 67c4c26 (abgerufen und praktisch getestet am 22. September 2026); jährliche Statistik des Fedwire Funds Service der US-Notenbank (Update am 26. Januar 2026); Bank of England Payment and settlement statistics sowie (A brief introduction to RTGS and CHAPS) (Ausgabe 2021).