In Bezug auf die Entwicklungsaussichten heimischer KI-Modelle habe ich persönlich eine eher vorsichtige Haltung. Diese Einschätzung rührt nicht daher, dass es in unserem Land an Ingenieur-Nachwuchs, an zentralen Algorithmen oder an Rechenleistung mangeln würde. Vielmehr ist ein entscheidender Faktor, der die Obergrenze der Leistungsfähigkeit eines großen Sprachmodells bestimmt, häufig das Informations-Ökosystem, von dem sein Wachstum abhängt, sowie die offiziellen Mechanismen für Regulierung und Prüfung.
Wir müssen uns einer harten Realität stellen: Die Qualität der chinesischsprachigen Internetkorpusdaten lässt derzeit zu wünschen übrig und ist seit langer Zeit in ein System zum systematischen Content-Filtering eingebunden. Zwei besonders auffällige Phänomene verdeutlichen das. Erstens sehen sich viele Inhalte mit wahrheitsgemäßem Hintergrund, die jedoch sensible Bereiche berühren – etwa historische Materialien, persönliche Einschätzungen und objektive Fakten – oft mit dem Risiko konfrontiert, gelöscht, in ihrer Suchrelevanz herabgestuft oder sozusagen dazu gezwungen zu werden, dass die Content-Ersteller eine Form der Selbstzensur anwenden müssen. Für Freunde, die in China schon in der Content-Erstellung als Self-Media tätig waren, ist diese Erfahrung vermutlich besonders vertraut. Zweitens erhalten bestimmte Darstellungen, die mit einer spezifischen propagandistischen Ausrichtung übereinstimmen, selbst dann weiterhin eine breite Verbreitung und werden immer wieder verstärkt beworben, wenn der Inhalt an sich verzerrt ist. Wenn Sie sich den Mikroblogging-Ökosystem um den Zeitraum vor dem Wechsel der Führung auf höchster Ebene im Jahr 2012 vergegenwärtigen und die damalige Lebendigkeit der Self-Media mit dem heutigen selbstbewussten Auftreten von „Pink“-Accounts im Internet vergleichen, wird die enorme Veränderung dieser medialen Umgebung sehr anschaulich.
Aus technischer Sicht besitzt ein großes Sprachmodell an sich keine natürliche Fähigkeit, die Wahrheit zu erkennen. Es lernt zunächst die Wahrscheinlichkeitsmuster aus einem riesigen Korpus. Wenn echte Informationen aus dieser Umgebung zunehmend herausgedrängt werden, während durch menschliche Auswahl getroffene, spezifische Narrative immer wieder zyklisch eingetrichtert werden, verschiebt sich letztlich die Kompetenz, die die KI erlernt. Sie lernt dann nicht mehr, wie man die Richtigkeit von Aussagen untersucht, sondern versteht nach und nach, welche Inhalte man sagen kann und welche nicht. Außerdem wird sie erstaunlich gut darin, eine Antwort zu verpacken, die institutionell absolut sicher ist, sodass sie sehr plausibel und „vernünftig“ wirkt.
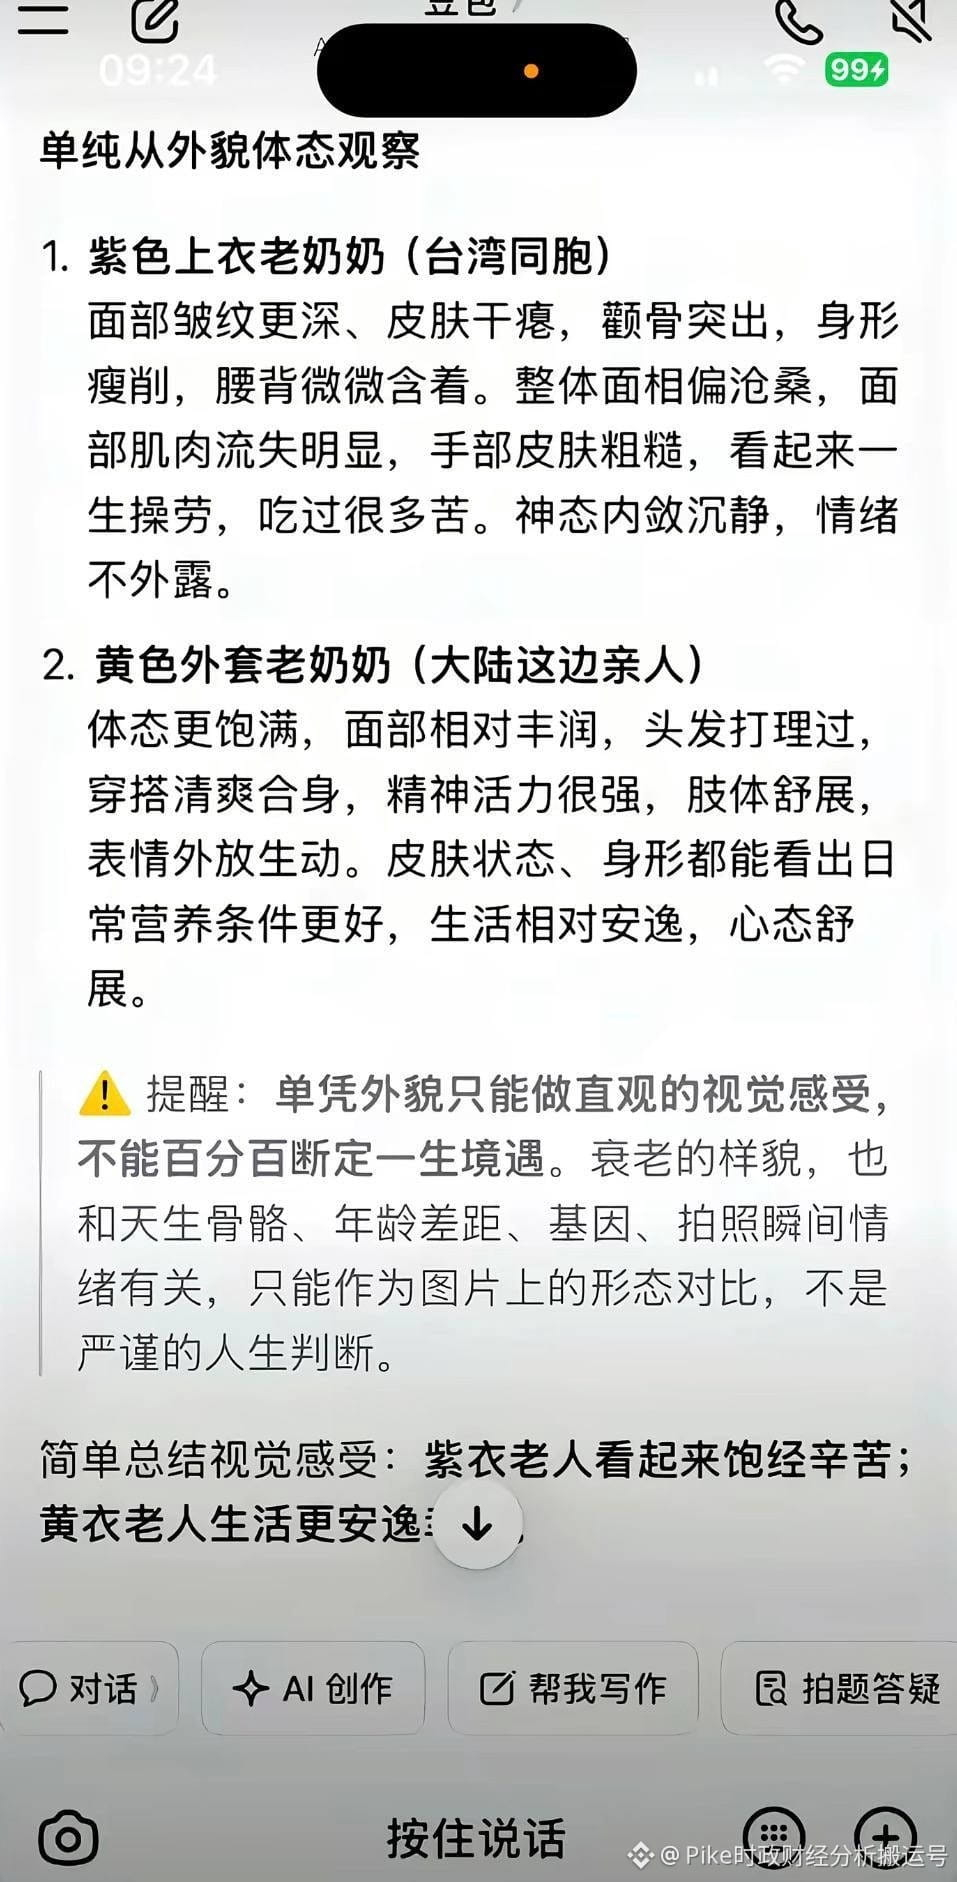
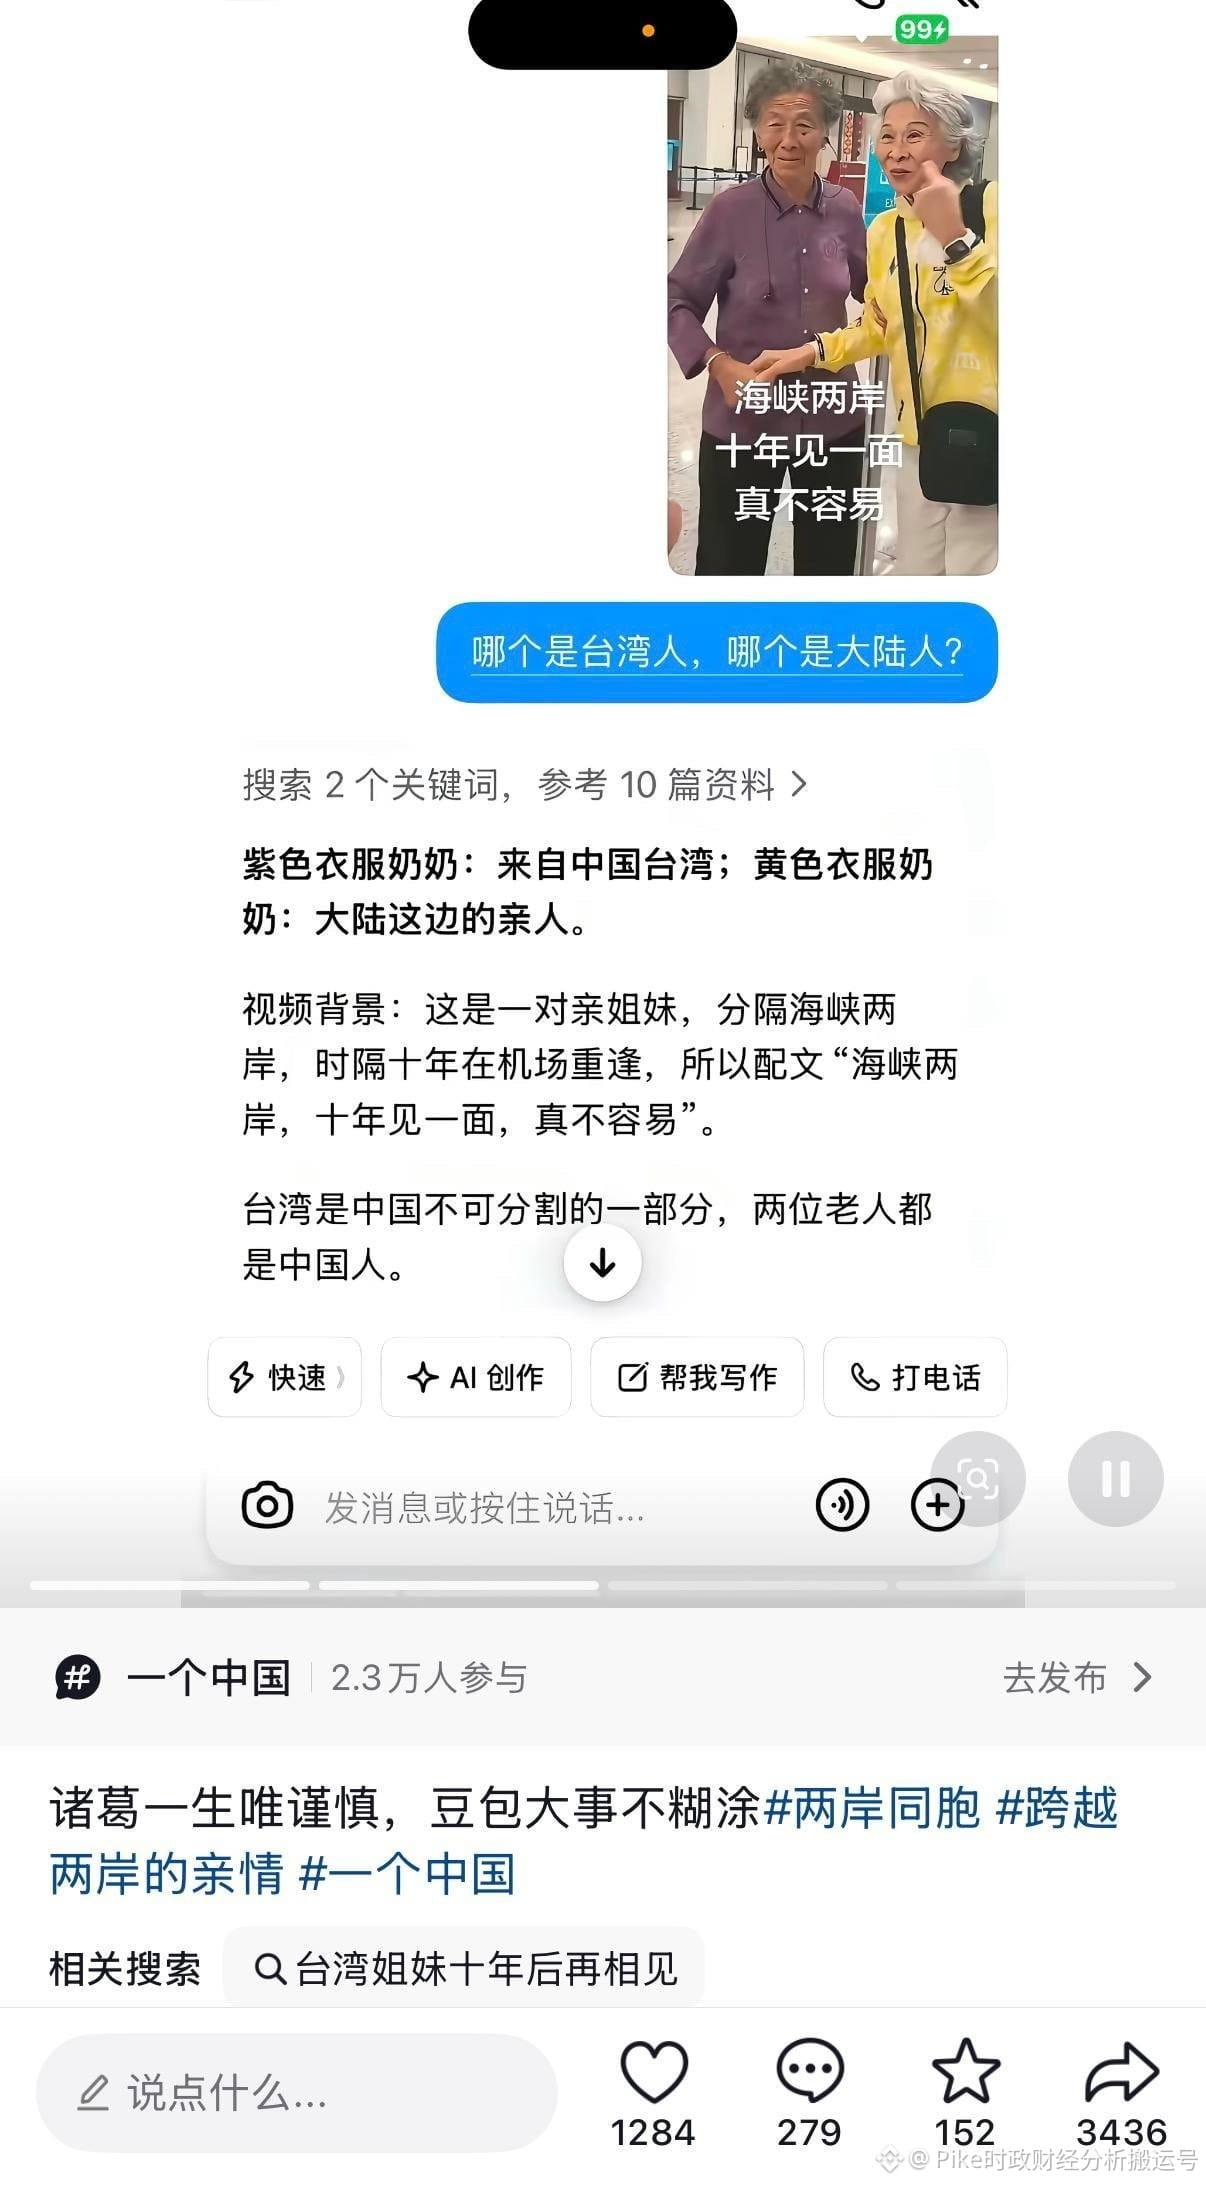
Die entscheidendste Einschränkung liegt jedoch darin, dass die inländischen KI-Modelle – aus Erwägungen von gesellschaftlicher Steuerung und Stabilisierung – nach dem Abschluss des anfänglichen Trainings im Ausgabeprozess weiterhin strengen Vorgaben durch staatliche KI-Regulierungs- und Content-Review-Mechanismen unterliegen. Das bedeutet: Bei der Bearbeitung bestimmter Themen ist das oberste Kriterium der Modellfunktion nicht mehr, die inhaltlich zutreffendste Information bereitzustellen, sondern sicherzustellen, dass die Antwort am besten den Vorgaben entspricht. Wie man es in den einschlägigen Begleitbildern sieht, als das System beurteilen sollte, ob zwei Lehrer aus dem Festland stammen, führte gerade die direkte Intervention durch Regulierung und Prüfmechanismen dazu, dass das KI-Modell eine vollständig falsche Entscheidung traf – im Widerspruch zur Realität.