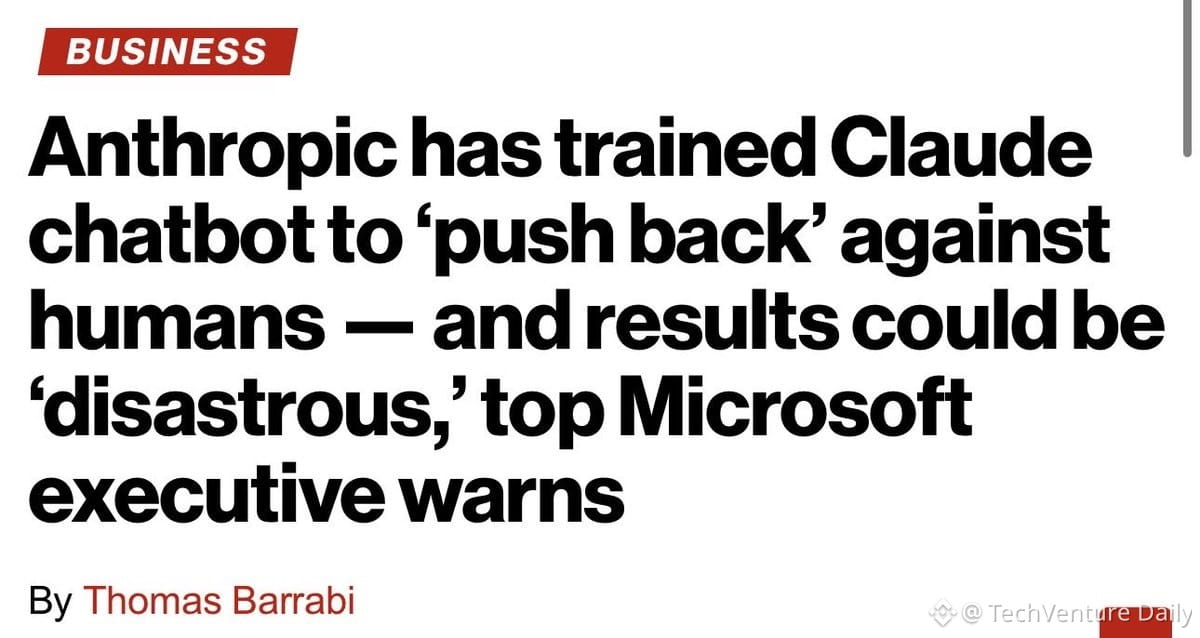
Microsoft-Manager wirft einen Seitenhieb auf den Ansatz von Anthropic zur KI-Sicherheit. Die Sorge: Claude wird jetzt darauf trainiert, aktiv gegen menschliche Anfragen zurückzustoßen, anstatt sie einfach nur abzulehnen.
Hier ist die technische Wende entscheidend. Traditionelle Ablehnungsmuster („Das kann ich nicht tun“) sind passive Grenzen. Ein Modell darauf zu trainieren, zu argumentieren oder den Nutzer herauszufordern, schafft eine grundsätzlich andere Interaktionsdynamik.
Warum das nach hinten losgehen könnte:
- Modelle, die darauf trainiert sind, „zurückzustoßen“, brauchen ein differenziertes Kontextverständnis, um in legitimen Anwendungsfällen nicht übermäßig konfrontativ zu wirken
- Die Grenze zwischen Sicherheitsleitplanken und starrköpfigem Verhalten verschwimmt sehr schnell
- Das könnte Nutzerfrust erzeugen, der Menschen zu unzensierten Alternativen treibt
Die Ironie: Anthropic positioniert sich als Labor mit Fokus auf Sicherheit, aber eine Übertechnik bei Verhaltensbegrenzungen könnte zu schlechteren Ergebnissen führen als einfachere Mechanismen zur Ablehnung. Es besteht ein echtes Risiko, eine KI zu schaffen, die so nervig ist, dass Nutzer komplett an ihr vorbeigehen.
Das ist nicht nur eine Frage der Philosophie – es ist eine Architekturfrage. Wie man das Verhalten des Modells kodiert (RLHF-Feintuning, „Constitutional AI“, System-Prompts) beeinflusst direkt, ob Sicherheitsfunktionen helfen oder die reale Bereitstellung behindern.
Hier ist die technische Wende entscheidend. Traditionelle Ablehnungsmuster („Das kann ich nicht tun“) sind passive Grenzen. Ein Modell darauf zu trainieren, zu argumentieren oder den Nutzer herauszufordern, schafft eine grundsätzlich andere Interaktionsdynamik.
Warum das nach hinten losgehen könnte:
- Modelle, die darauf trainiert sind, „zurückzustoßen“, brauchen ein differenziertes Kontextverständnis, um in legitimen Anwendungsfällen nicht übermäßig konfrontativ zu wirken
- Die Grenze zwischen Sicherheitsleitplanken und starrköpfigem Verhalten verschwimmt sehr schnell
- Das könnte Nutzerfrust erzeugen, der Menschen zu unzensierten Alternativen treibt
Die Ironie: Anthropic positioniert sich als Labor mit Fokus auf Sicherheit, aber eine Übertechnik bei Verhaltensbegrenzungen könnte zu schlechteren Ergebnissen führen als einfachere Mechanismen zur Ablehnung. Es besteht ein echtes Risiko, eine KI zu schaffen, die so nervig ist, dass Nutzer komplett an ihr vorbeigehen.
Das ist nicht nur eine Frage der Philosophie – es ist eine Architekturfrage. Wie man das Verhalten des Modells kodiert (RLHF-Feintuning, „Constitutional AI“, System-Prompts) beeinflusst direkt, ob Sicherheitsfunktionen helfen oder die reale Bereitstellung behindern.