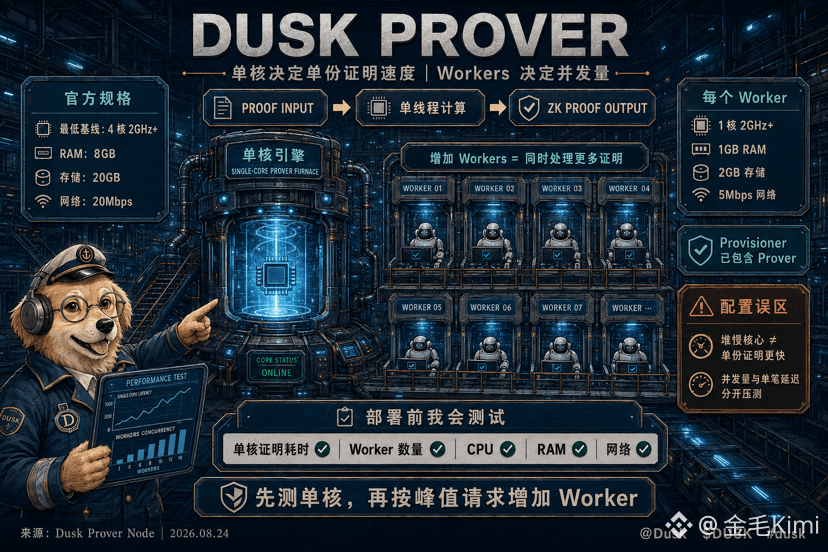
Ich hätte fast bestellt, als ich den Server aufstockte – nach dem Gedanken „Je mehr Kerne, desto schneller der Nachweis pro Auftrag“. Erst nachdem ich die Dusk Prover-Dokumentation @Dusk Dusk Prover durchgelesen hatte, habe ich verstanden: Die Generierung von ZK-Nachweisen ist eine Single-Thread-Aufgabe. Ein einzelner Nachweis nutzt hauptsächlich die Leistung eines einzelnen Kerns. Mehr Worker erhöhen die parallel verarbeitete Menge, aber sie teilen denselben Nachweis nicht auf mehrere Kerne auf, die gleichzeitig laufen.
Ich stelle mir das wie ein Restaurant mit einer kleinen Küche vor, in der nur eine Person an einem Herd steht. Wenn die Hitze stark genug ist, kommt die Nudel schnell fertig; mehrere Herde kann man zwar aufmachen, um mehr Schüsseln gleichzeitig zuzubereiten, aber damit wird die bereits kochende Schüssel im Topf nicht schneller fertig.
Die offizielle minimale Basis liegt bei mindestens 4 Kernen mit 2 GHz oder mehr, 8 GB RAM, 20 GB Speicher und 20 Mbps Netzwerk. Für jeden zusätzlichen Worker muss außerdem nochmal 1 Kern mit 2 GHz oder mehr, 1 GB RAM, 2 GB Speicher und 5 Mbps Bandbreite eingeplant werden.
Das hat mich veranlasst, die ZK-Infrastruktur von Dusk noch einmal genauer zu prüfen. Die Maschinenkonfiguration beeinflusst sowohl die Warteschlangenmenge als auch die Latenz pro einzelnen Auftrag. Der Provisioner selbst beinhaltet bereits den Prover, und die Rollen dürfen nicht vermischt bei der Schätzung betrachtet werden. Wenn ich das wirklich deployen würde, würde ich zuerst den Single-Core-Nachweiszeitraum per Lasttest ermitteln, dann die Anzahl der Worker anhand der Spitzenanfragen berechnen und die Auslastung kontinuierlich im Blick behalten – CPU, Speicher und Netzwerk. Wenn man nur eine Menge langsamer Kerne kauft, sieht das Panel zwar beeindruckend aus, aber wenn Nutzer auf den Nachweis warten, bleibt deren Situation genauso frustrierend.
#dusk $DUSK
Ich stelle mir das wie ein Restaurant mit einer kleinen Küche vor, in der nur eine Person an einem Herd steht. Wenn die Hitze stark genug ist, kommt die Nudel schnell fertig; mehrere Herde kann man zwar aufmachen, um mehr Schüsseln gleichzeitig zuzubereiten, aber damit wird die bereits kochende Schüssel im Topf nicht schneller fertig.
Die offizielle minimale Basis liegt bei mindestens 4 Kernen mit 2 GHz oder mehr, 8 GB RAM, 20 GB Speicher und 20 Mbps Netzwerk. Für jeden zusätzlichen Worker muss außerdem nochmal 1 Kern mit 2 GHz oder mehr, 1 GB RAM, 2 GB Speicher und 5 Mbps Bandbreite eingeplant werden.
Das hat mich veranlasst, die ZK-Infrastruktur von Dusk noch einmal genauer zu prüfen. Die Maschinenkonfiguration beeinflusst sowohl die Warteschlangenmenge als auch die Latenz pro einzelnen Auftrag. Der Provisioner selbst beinhaltet bereits den Prover, und die Rollen dürfen nicht vermischt bei der Schätzung betrachtet werden. Wenn ich das wirklich deployen würde, würde ich zuerst den Single-Core-Nachweiszeitraum per Lasttest ermitteln, dann die Anzahl der Worker anhand der Spitzenanfragen berechnen und die Auslastung kontinuierlich im Blick behalten – CPU, Speicher und Netzwerk. Wenn man nur eine Menge langsamer Kerne kauft, sieht das Panel zwar beeindruckend aus, aber wenn Nutzer auf den Nachweis warten, bleibt deren Situation genauso frustrierend.
#dusk $DUSK