

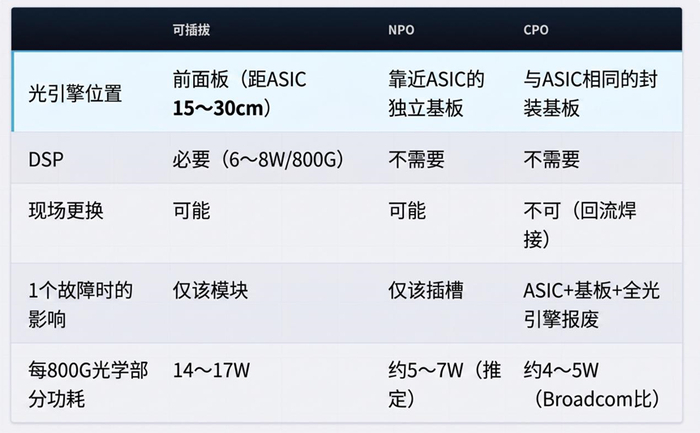
Öffnen Sie das Rechenzentrums-Regal, und Sie können sehen, dass vor dem Switch eine Reihe von optischen Transceivern in Reihen angeordnet ist. In einem KI-Cluster ist es eine gängige Konfiguration, dass ein Switch mit 144 800G-kompatiblen QSFP-DD-Modulen ausgestattet ist. Allerdings weist diese Konfiguration ein strukturelles Problem mit Ineffizienz auf. Der Abstand der Transceiver an der Vorderseite zur Switch-ASIC-Chip liegt bei 15 bis 30 Zentimetern. Wenn ein 200G/Channel-Signal über dieses Kupferkabel übertragen wird, kommt es zu einer erheblichen Dämpfung, sodass am Empfangsende DSP-Chips (Digital Signal Processing) eingesetzt werden müssen, um das Signal wiederherzustellen. Der Leistungsbedarf eines einzelnen 800G-Moduls liegt bei 14 bis 17 Watt, wobei 6 bis 8 Watt auf die DSP-Chips entfallen. Das bedeutet, dass ein beträchtlicher Teil der Leistung in den herkömmlichen steckbaren optischen Modulen nicht direkt für die optoelektronische Umwandlung genutzt wird, sondern für die Aufbereitung, das Equalizing und die Übertragung von Hochgeschwindigkeitselektriksignalen aufgewendet wird.
Das Verkürzen dieser Distanz macht die Nutzung von DSPs überflüssig. Diese Idee tauchte bereits Mitte der 2010er-Jahre auf. Beim gemeinsam verpackten optischen Bauteil (CPO) werden die Licht-Engines (eine Gruppe von Komponenten, die elektrische Signale in optische Signale umwandeln) und das Switching-ASIC-Packing auf derselben Träger-/Substratbasis platziert. Dieses Design verkürzt deutlich die Hochgeschwindigkeits- elektrische Verbindungsstrecke zwischen ASIC und Licht-Engine und reduziert damit signifikant die Verluste durch Kupfer-Interconnects. Broadcom gab bekannt, dass CPO den Stromverbrauch des optischen Systems um 65–70 % senken kann. Nvidias 1,6T-Link-Leistungsaufnahme sank von etwa 30 Watt pro Link auf 9 Watt.
Theoretisch scheint CPO die optimale Lösung zu sein. Das Problem liegt jedoch in der Lücke zwischen Theorie und großskalierter Produktion.
Eine Ausbeute von 9 % enthüllt die Wahrheit
Im CPO-Fertigungsprozess wird die Licht-Engine mithilfe eines Reflow-Lötprozesses (Wärmelöten) auf das ASIC-Packaging-Substrat montiert. Die Ausrichtgenauigkeit der Glasfaser liegt im Submikronbereich. Wenn eine bereits montierte Licht-Engine neu installiert werden muss, muss sie erneut auf 220–260 °C erhitzt werden; die Aufhebestelle liegt wenige Millimeter vom ASIC entfernt, und die Ausrichtgenauigkeit kann eine zweite thermische Beschädigung nicht verkraften. Mit anderen Worten: Wenn bei einem von 32 Licht-Engines ein Defekt auftritt, müssen das ASIC, das Substrat sowie alle verbleibenden Licht-Engines verschrottet werden.
SemiAnalysis ging in seinem Forschungsbericht für Juni 2026 (Powered Down, Lights Off) davon aus, dass die Implementierungs-Yield einer jeden optischen Engine bei 95 % liegt, und berechnete eine Gesamtyield von 0,9532 ≈ 0,1932. Anders gesagt: In dem extrem vereinfachten Modell, in dem 32 optische Engines unabhängig voneinander sind und jede Engine einen Yield von 95 % hat, beträgt die kombinierte Yield, bei der alle 32 Engines erfolgreich durchkommen, ungefähr 19,3 %. Das bedeutet, dass nur ein Fünftel der Engines normal funktionieren kann. Diese Zahl hatte erhebliche Auswirkungen auf den Markt. Am 9. Juni fielen im US-Markt die Aktien von Applied Optoelectronics (AAOI) an einem Tag um etwa 17 %, Lumentum um etwa 8 %, Coherent um etwa 11 % und Marvell um etwa 7,6 %.
GlobalSemiResearch veröffentlichte sofort eine Gegenstellungnahme und wies darauf hin, dass die Berechnung die Yield-Steigerungen durch das Filtern, Sortieren sowie die redundant ausgelegten Engines, die NVIDIA für Spectrum-X entwickelt hat, außer Acht lasse. Morgan Stanley erklärte außerdem in einem Bericht vom 10. Juni, dass man den technischen Roadmap von CPO nicht in Abrede stelle, jedoch die Prognose für die Auslieferungsmenge optischer Engines im Jahr 2027 von zuvor 20 bis 30 Millionen Stück auf 6 bis 7 Millionen Stück reduziert habe.
Der Kern dieser Debatte ist nicht „Ist CPO schlecht?“, sondern „Wann und in welcher Größenordnung lässt sich CPO einsetzen?“ SemiAnalysis hat die Auslieferungsmenge von CPO in der horizontalen Skalierung auf 2027 verschoben und die Vollproduktion auf 2028–2029. Diese zeitliche Anpassung öffnet ein Fenster für die Erforschung anderer Architekturen.
NPO ist rundum durchdacht
Near-Package-Optikbauteile (NPO) liegen zwischen Packaging-Optikbauteilen (CPO) und einer steckbaren Ausführung. Die Licht-Engine ist auf einer separaten Engine-Platine montiert, nicht auf dem Packaging-Substrat des ASICs, und liegt direkt daneben. Wenn die elektrische Kette lang genug kurz ist und die Verluste ausreichend niedrig sind, kann man die Notwendigkeit von DSPs in herkömmlichen steckbaren Optikmodulen zur Kompensation von Verlusten über lange elektrische Strecken reduzieren oder in manchen Architekturen sogar ganz weglassen. Ein entscheidender Unterschied zu CPO besteht jedoch darin, dass die Engine über einen Steckverbinder verbunden ist und vor Ort ein- und ausgebaut werden kann.
Am 10. August fasste SemiAnalysis auf dem X-thread-Forum die drei Vorteile von NPO zusammen: vor Ort wartbar, Fehlerausbreitung (Einflussbereich) auf einen einzelnen Steckplatz beschränkt sowie ein vereinfachter Montageprozess aufgrund der getrennten Verpackung von Licht-Engine und ASIC. Diese Struktur vermeidet Herausforderungen in Produktion und Zuverlässigkeit und behält gleichzeitig die meisten Leistungsvorteile von CPO.
Auf der OFC-Messe im März 2026 veröffentlichte Broadcom seine NPO-Produktlinie auf Basis von 3,2T VCSEL. Laut dem Blog des Unternehmens hat die NPO-Engine eine Energieeffizienz von etwa 1 pJ/bit; im Vergleich zur typischen Energieeffizienz von 5 bis 10 pJ/bit bei der siliziumphotonischen Methode entspricht das einer Verbesserung um das 5- bis 10-fache. Nach der Bereitstellung von 18 Engines übersteigt die ausgeschleuste Bandbreitendichte 0,6 Tbps/mm, die gesamte ausgeschleuste Bandbreite erreicht 73,7 Tbps (128 Gbps/Kanal). VCSEL verfügt über jahrzehntelange Serienproduktionserfahrung; die vor Ort verifizierte Fehlerquote (FIT) liegt unter 0,1.
Die Zahnräder für Standardisierung und Großserienproduktion beginnen sich zu drehen
Selbst bei einer herausragenden Architektur lässt sich eine breite Anwendung ohne Unterstützung durch das Ökosystem nicht erreichen. Am 12. März 2026, genau zum Zeitpunkt der OFC-Konferenz, unterzeichneten sechs Unternehmen – Ciena, Coherent, Marvell, Molex, Samtec und TeraHop – gemeinsam die Open CPX MSA (Multi-Source-Coupled-Encapsulation-Vereinbarung). Die Vereinbarung zielt darauf ab, allgemeine Spezifikationen für steckbare optische Engine-Schnittstellen zu definieren, die sowohl NPO als auch CPO abdecken. Dadurch werden die mechanischen Strukturen der Stecker, das Wärmemanagement, die Anordnung der elektrischen Pins und die Management-Schnittstellen standardisiert, sodass Interoperabilität zwischen Produkten unterschiedlicher Hersteller gewährleistet ist.
Der CEO von LightCounting, Wladimir Kozlov, sagte bei der Ankündigung der Gründung des Unternehmens: „Wir erwarten, dass die jährlichen Auslieferungen innerhalb von fünf Jahren über 100 Millionen Stück liegen werden“, während man für 2025 prognostiziert, dass das Auslieferungsvolumen von CPO/NPO unter 1 Million liegen wird. Ohne Standardisierung ist ein solch enormes Wachstum (sogar über das 100-Fache) nicht möglich.
Auch die Nachfrage verändert sich. Auf einem IPEC-Webinar im Mai 2026 teilte Alibaba mit, dass die Beta-Tests für sein 3,2T NPO abgeschlossen werden sollen und man im dritten Quartal desselben Jahres mit Pilotbetrieben beginnt. Ziel ist es, bis September 2027 die System-Level-Debugging von 6,4T NPO-Alpha-Mustern abzuschließen. Tencent hat außerdem seine Validierung von 3,2T VCSEL NPO und Silizium-Photonik-NPO abgeschlossen und plant eine Pilotbereitstellung im vierten Quartal 2026. Ranovus hat NPO-Module an ein US-Cloud-Unternehmen geliefert, erwartet aber, dass die offizielle Ankündigung erst beim OFC 2027 erfolgt.
Was die Lieferkette betrifft, begann die Interconnect-Technologie von Foxconn spätestens ab Mai 2025 mit der großvolumigen Produktion von lötfreien LGA-to-LGA-Steckdosen und steckbaren Laser-Lichtquellen-Gehäusen für Broadcoms Bailly. Die Laser sind vor allem dafür ausgelegt, außerhalb des Packaging platziert zu werden – unabhängig davon, ob es sich um CPO oder NPO handelt. Das ELSFP-Standarddokument, das OIF im August 2023 festgelegt hat (Hot-Plug-Externer-Laser-Modul), dient dabei als allgemeine Basis.
Warum weist Nvidias CPO Merkmale von NPO auf?
Der NVIDIA Quantum-X Photonics InfiniBand-Switch ist bereits für den Serienstart der Bereitstellung angekündigt. Er bietet 144 800G-Ports, ausgestattet mit 18 Silizium-Photonik-Engines und 18 abnehmbaren externen Laser-Modulen, die als Lichtquelle dienen. NVIDIA nennt dies „CPO“.
Dennoch lassen sich die Engines leicht aus dem Packaging ausbauen, und die Laser können aus der Frontplatte herausgleiten – genau darin sieht SemiAnalysis den Vorteil der Wartbarkeit von NPO. Ein Forschungsbericht von LightCounting im Juli 2026 bestätigt zudem die Branchenansicht, dass CPO und NPO nebeneinander existieren werden, und weist darauf hin, dass sich der Entwicklungszyklus verkürzen würde, falls NVIDIA NPO als Option einsetzt; die ersten Vorbereitungen könnten frühestens im nächsten Jahr zu sehen sein.
Broadcom wird beide Architekturen parallel ausrollen. Der 51,2T-Bailly-CPO-Switch wird seit 2024 in Micas Networks in Serie gefertigt. Der 102,4T-Tomahawk-6-Davisson-Switch begann im Oktober 2025 mit dem Versand an Kunden. Zusätzlich liefert Broadcom separat 3,2T-VCSEL-NPO-Switches aus, um Kunden zu bedienen, die einen hochdichten Switch benötigen, aber keine Lötarbeiten durchführen möchten.
Auch die Zuverlässigkeitsvalidierung bei Meta schreitet stetig voran. In der Hochtemperatur-Laborumgebung von Meta wurde im Broadcom-CPO-System während einer kumulierten Laufzeit von 1 Million Stunden (entspricht der Port-Zeit von 400G-Ports) kein einziges Link-Flimmern (zu kurzen Unterbrechungen) erfasst. Broadcom kündigte dieses Ergebnis im Oktober 2025 an und stellte die Details auf der ECOC desselben Jahres sowie auf der OFC 2026 vor. Auf der OFC 2026 legte Meta die Messlatte fest: Damit die optische Technologie attraktiv ist, muss sie bei Kosten und Energieeffizienz mit elektrischen Lösungen gleichziehen und gleichzeitig Zuverlässigkeit und Leistung liefern.
TSMC’s COUPLE spielt eine Schlüsselrolle
Das Ende der „Übergangsphase“ von NPO hängt in hohem Maße vom Fortschritt der TSMC-COUPE-Plattform (Compact Universal Photonics Engine) ab.
Wie oben beschrieben: Obwohl die Rechenleistung heutiger KI-Chips extrem hoch ist, hängt die Datenübertragung zwischen Chips weiterhin von Kupferleitungen ab. Sowohl die Übertragungsgeschwindigkeit als auch der Energieverbrauch von Kupferleitungen können das Wachstum des Rechenbedarfs nicht mehr Schritt halten. Die Kernidee von COUPE besteht darin, die Datenübertragung auf optische Signale umzustellen und die optisch-elektrische Umwandlung vom entfernten Optikmodul direkt in das Chip-Stack-/Packaging-Inneren zu verlagern. So wird die Länge des Pfads, den das Signal zurücklegen muss, drastisch verkürzt.
COUPE integriert zwei Arten von Chips: Einer ist für die Verarbeitung von elektrischen Signalen zuständig (elektronischer Chip, EIC), der andere für die Verarbeitung von optischen Signalen (Photonik-Chip, PIC). Beide werden mit der 3D-Stacking-Technologie von TSMC direkt übereinander gestapelt und von Angesicht zu Angesicht verbunden, wodurch der Umweg über die Leiterplatte bei herkömmlichen Lösungen und damit verbundene Verluste entfallen.
Taiwan Semiconductor Manufacturing Co. (TSMC) erklärte, dass die direkte Integration der COUPE-Optik in das Packaging-Substrat im Vergleich zu einer steckbaren Lösung auf einer Leiterplatte eine 4-fache Steigerung der Leistungs-/Stromverbrauchseffizienz und eine Reduktion der Latenz um 90 % ermöglicht. Wenn COUPE zusätzlich in die Zwischenschicht (Interposer) verlagert wird, kann die Effizienz auf das 10-fache bei einer Senkung der Latenz um 95 % gesteigert werden.
Die COUPE-Technologie nutzt eine SOIC-Stacking-Bauweise: Elektronische Chips und photonische Chips werden direkt übereinander gestapelt, wodurch der Impedanzwert zwischen den Chips so weit wie möglich reduziert wird. Die erste Generation der steckbaren COUPE wird 2026 in die Serienproduktion gehen. Die zweite Generation von COUPE verwendet ein 6,4T-CPO-Packaging und soll voraussichtlich um 2027 herum in Serie gehen. Die dritte Generation integriert die optischen Komponenten vollständig in das Prozessor-Paketing.
Die COUPE-Bandbreitendichte-Roadmap von TSMC prognostiziert, dass sich die Bandbreitendichte innerhalb von vier Jahren um das Achtfache erhöht: von 0,5 Tbps/mm im Jahr 2026 auf 4 Tbps/mm im Jahr 2030. Wenn dieser Plan umgesetzt wird, beschränkt sich die Rolle von NPO auf eine Übergangsphase von lediglich zwei bis drei Jahren.
Wenn jedoch das von SemiAnalysis vorhergesagte Szenario einer vollständigen Serienproduktion im Jahr 2029 der Realität nahekommt, wird NPO weiterhin den Marktbedarf bis zum Ende der 2020er-Jahre decken. In diesem Fall würde das zusätzliche Belastungen für die photonische Lieferkette bedeuten, die bereits jetzt bei Laser- und Packaging-Kapazitäten knapp ist. Auf dem OCP Asia Pacific Summit merkte Nicole Tien von 日月光 (ASE) an, dass es derzeit noch keine waferbasierten Teststandards und Simulations-Infrastrukturen gibt, um CPO für den Markt vieler Anbieter zu skalieren. Nvidias CPO-Serienproduktion ist das Ergebnis einer tiefgreifenden bilateralen F&E-Zusammenarbeit mit TSMC, und derzeit fehlen die Voraussetzungen, um diese Ergebnisse auf die gesamte Branche zu übertragen.
In der Branche gilt weithin CPO als die ultimative Form optischer Interconnects. Die Frage ist jedoch: Wer wählt diesen Weg, wann wird er umgesetzt und wie skaliert er? Zumindest anhand der aktuellen Produkt-Roadmaps und Kundenvalidierungen bewegt sich NPO derzeit schnell von der technischen Verifizierung hin zu einer skalierbaren Bereitstellung und wird damit zu einer eindeutigeren Antwort.