Ich habe genug Infrastruktur betrieben, um zu wissen, dass die wahren Kosten nicht der Ausfall sind, sondern das, was du danach tust.
Wenn ein Dusk-Node ausfällt oder aus dem Sync fällt, stehen dir zwei Wege offen.
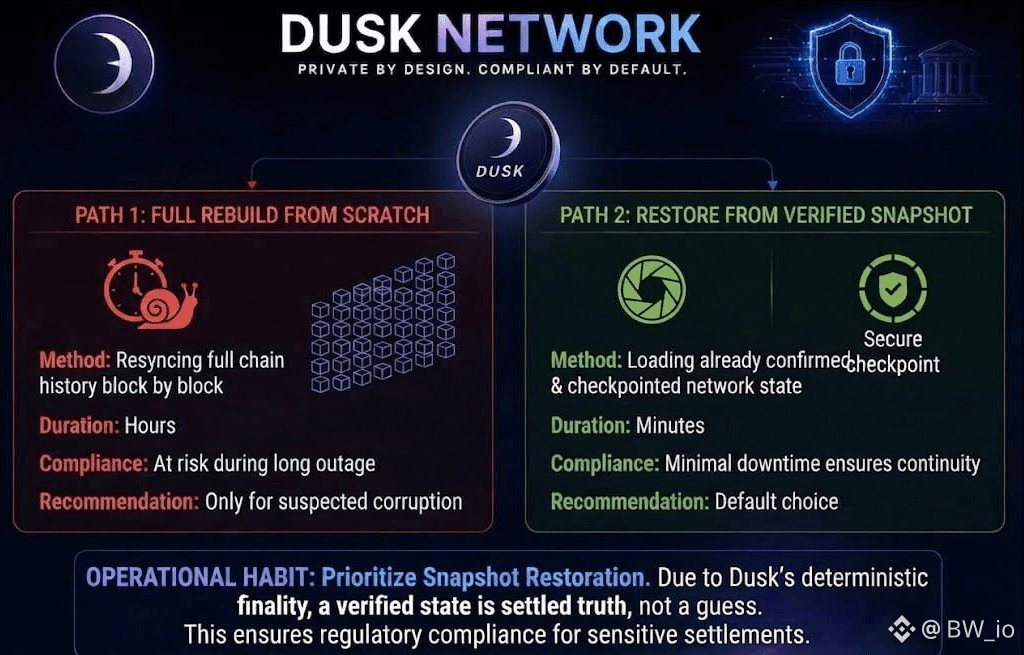
Du kannst von Grund auf neu aufbauen, indem du die vollständige Kettenhistorie Block für Block erneut synchronisierst—das ist sicher, aber langsam und frisst dir Stunden, die du während eines Zwischenfalls nicht hast. Oder du kannst aus einem verifizierten State-Snapshot wiederherstellen—einem, der bereits checkpointed wurde und gegen den Konsens des Netzwerks bestätigt ist—und bist innerhalb eines Bruchteils der Zeit wieder online.
Ich entscheide mich bei jedem Mal für den zweiten Weg, weil Dusk’s deterministische Finalität bedeutet: Ein verifizierter State ist keine Vermutung, sondern eine endgültige Wahrheit, auf die sich das Protokoll bereits geeinigt hat.
Das ist hier wichtiger als in den meisten anderen Chains, da diese Nodes oft geregelte Abwicklungen unterstützen—nicht nur Gas-Transaktionen. Ausfallzeiten in einem Netzwerk, das echte Wertpapiere bewegt, sind nicht nur lästig, sondern eine Compliance-Frage.
Daher ist die operative Gewohnheit, die ich empfehle, ganz einfach: Behandle die Wiederherstellung aus Snapshot nicht als Abkürzung, sondern als den Standard, und behalte einen vollständigen Rebuild nur für den Fall bei, dass du tatsächlich eine Beschädigung vermutest.
Das ist eine kleine operative Entscheidung, aber sie macht den Unterschied zwischen Minuten Ausfallzeit und Stunden.
@Dusk #dusk $DUSK $GPS $STAR
Wenn ein Dusk-Node ausfällt oder aus dem Sync fällt, stehen dir zwei Wege offen.
Du kannst von Grund auf neu aufbauen, indem du die vollständige Kettenhistorie Block für Block erneut synchronisierst—das ist sicher, aber langsam und frisst dir Stunden, die du während eines Zwischenfalls nicht hast. Oder du kannst aus einem verifizierten State-Snapshot wiederherstellen—einem, der bereits checkpointed wurde und gegen den Konsens des Netzwerks bestätigt ist—und bist innerhalb eines Bruchteils der Zeit wieder online.
Ich entscheide mich bei jedem Mal für den zweiten Weg, weil Dusk’s deterministische Finalität bedeutet: Ein verifizierter State ist keine Vermutung, sondern eine endgültige Wahrheit, auf die sich das Protokoll bereits geeinigt hat.
Das ist hier wichtiger als in den meisten anderen Chains, da diese Nodes oft geregelte Abwicklungen unterstützen—nicht nur Gas-Transaktionen. Ausfallzeiten in einem Netzwerk, das echte Wertpapiere bewegt, sind nicht nur lästig, sondern eine Compliance-Frage.
Daher ist die operative Gewohnheit, die ich empfehle, ganz einfach: Behandle die Wiederherstellung aus Snapshot nicht als Abkürzung, sondern als den Standard, und behalte einen vollständigen Rebuild nur für den Fall bei, dass du tatsächlich eine Beschädigung vermutest.
Das ist eine kleine operative Entscheidung, aber sie macht den Unterschied zwischen Minuten Ausfallzeit und Stunden.
@Dusk #dusk $DUSK $GPS $STAR