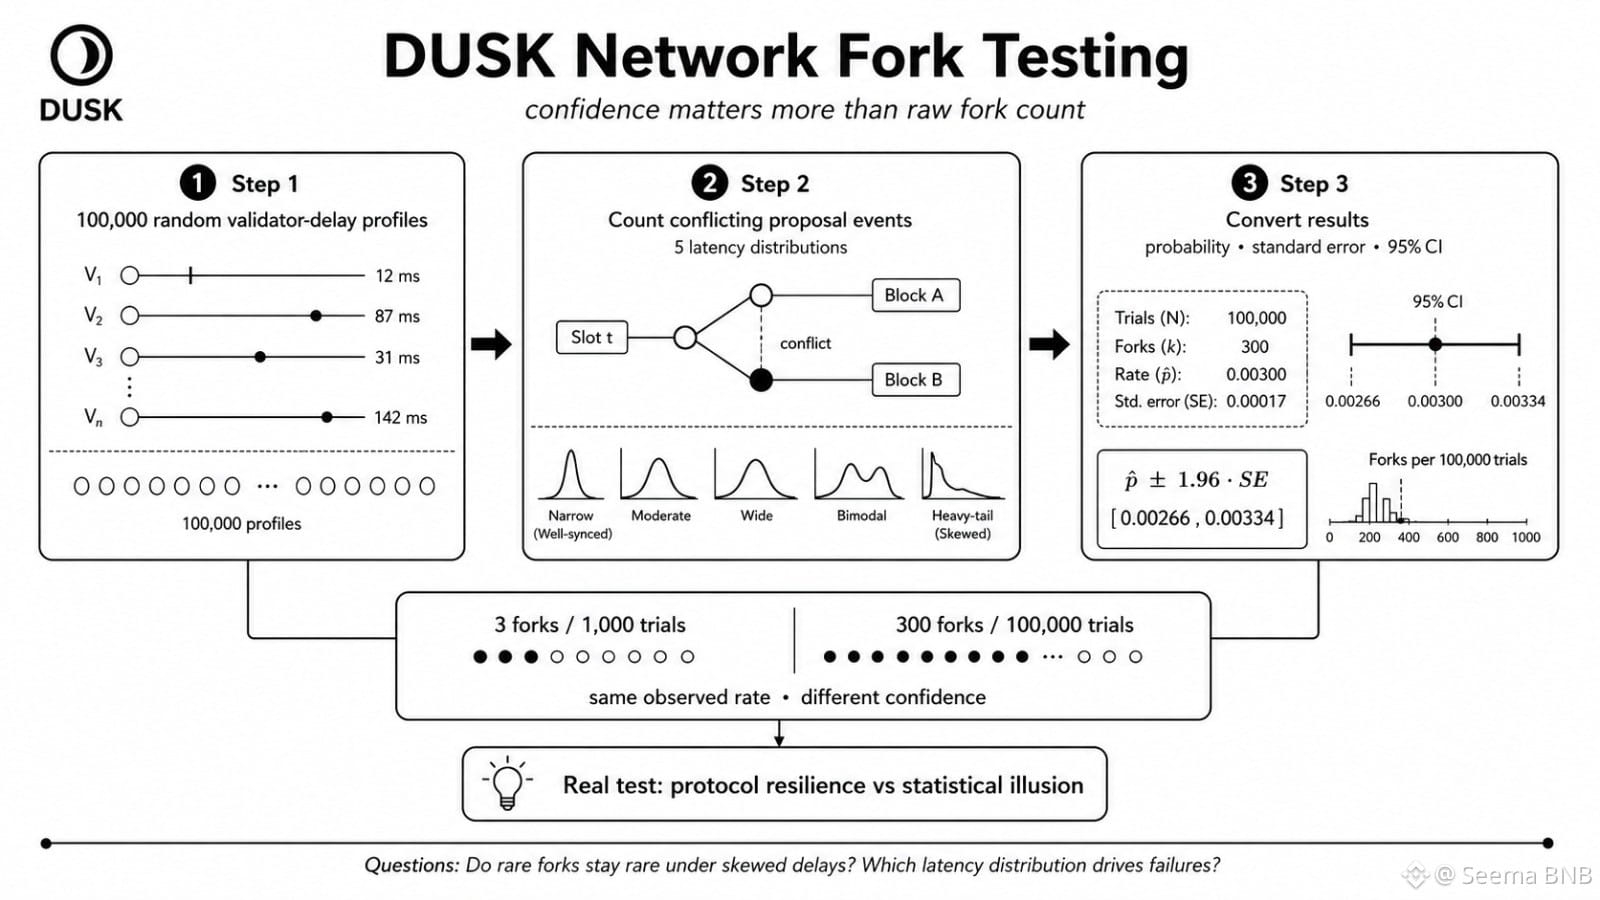
Ich bin beim Testen des Fork-Verhaltens einer DUSK Network-Fork-Implementierung immer zu einer Sache zurückgekehrt: Die Fork-Anzahl selbst sagt mir weniger als das Vertrauen (die Aussagekraft) hinter dieser Zahl. @Dusk
Drei Forks in 1.000 Versuchen sehen ähnlich aus wie 300 Forks in 100.000 Versuchen. Gleiche beobachtete Rate. Sehr unterschiedliche Evidenz.
Darum würde ich nicht bei einem einzigen Simulationsresultat stehen bleiben.
Für DUSK Network sollte Schritt 1 100.000 zufällige Validator-Delay-Profile erzeugen. Schritt 2 sollte widersprüchliche Bedingungen von Vorschlägen über mehrere Verzögerungsverteilungen hinweg erneut abspielen, nicht über ein einziges bequemes Netzwerkmodell. Dann wandelt Schritt 3 diese Fork-Zahlen in Wahrscheinlichkeit, Standardfehler und 95%-Konfidenzintervalle um.
Das verdeckte Problem ist nicht Aktivität vs. Inaktivität. Es geht um Protokoll-Resilienz vs. statistische Illusion.
Bleiben seltene Forks selten, wenn sich die Validator-Delays schief verteilen? Dominiert eine einzelne Verzögerungsverteilung die Ausfälle? Wird das Konfidenzintervall groß genug kleiner, um die Schätzung zu vertrauen, oder schauen wir immer noch auf Rauschen?
Ein gewisses Maß an Schwäche ist normal. Verteilte Systeme sind chaotisch, Netzwerke stallen, Pakete kommen zu spät an.
Meine Zweifel betreffen, ob DUSK Network stabil bleibt, wenn das Delay-Modell nicht mehr freundlich ist.
Eine niedrige Fork-Rate ist wichtig. Zu wissen, wie unsicher diese Rate ist, ist noch entscheidender.
#dusk $DUSK
Drei Forks in 1.000 Versuchen sehen ähnlich aus wie 300 Forks in 100.000 Versuchen. Gleiche beobachtete Rate. Sehr unterschiedliche Evidenz.
Darum würde ich nicht bei einem einzigen Simulationsresultat stehen bleiben.
Für DUSK Network sollte Schritt 1 100.000 zufällige Validator-Delay-Profile erzeugen. Schritt 2 sollte widersprüchliche Bedingungen von Vorschlägen über mehrere Verzögerungsverteilungen hinweg erneut abspielen, nicht über ein einziges bequemes Netzwerkmodell. Dann wandelt Schritt 3 diese Fork-Zahlen in Wahrscheinlichkeit, Standardfehler und 95%-Konfidenzintervalle um.
Das verdeckte Problem ist nicht Aktivität vs. Inaktivität. Es geht um Protokoll-Resilienz vs. statistische Illusion.
Bleiben seltene Forks selten, wenn sich die Validator-Delays schief verteilen? Dominiert eine einzelne Verzögerungsverteilung die Ausfälle? Wird das Konfidenzintervall groß genug kleiner, um die Schätzung zu vertrauen, oder schauen wir immer noch auf Rauschen?
Ein gewisses Maß an Schwäche ist normal. Verteilte Systeme sind chaotisch, Netzwerke stallen, Pakete kommen zu spät an.
Meine Zweifel betreffen, ob DUSK Network stabil bleibt, wenn das Delay-Modell nicht mehr freundlich ist.
Eine niedrige Fork-Rate ist wichtig. Zu wissen, wie unsicher diese Rate ist, ist noch entscheidender.
#dusk $DUSK