Ich habe kürzlich eine Reihe von Tests zu den „moralischen Urteilen“ großer Modelle gesehen, und das hat mich noch mehr davon überzeugt: Viele Antworten klingen zwar, als würden sie nachdenken, sind aber eher eine Art Reflex.
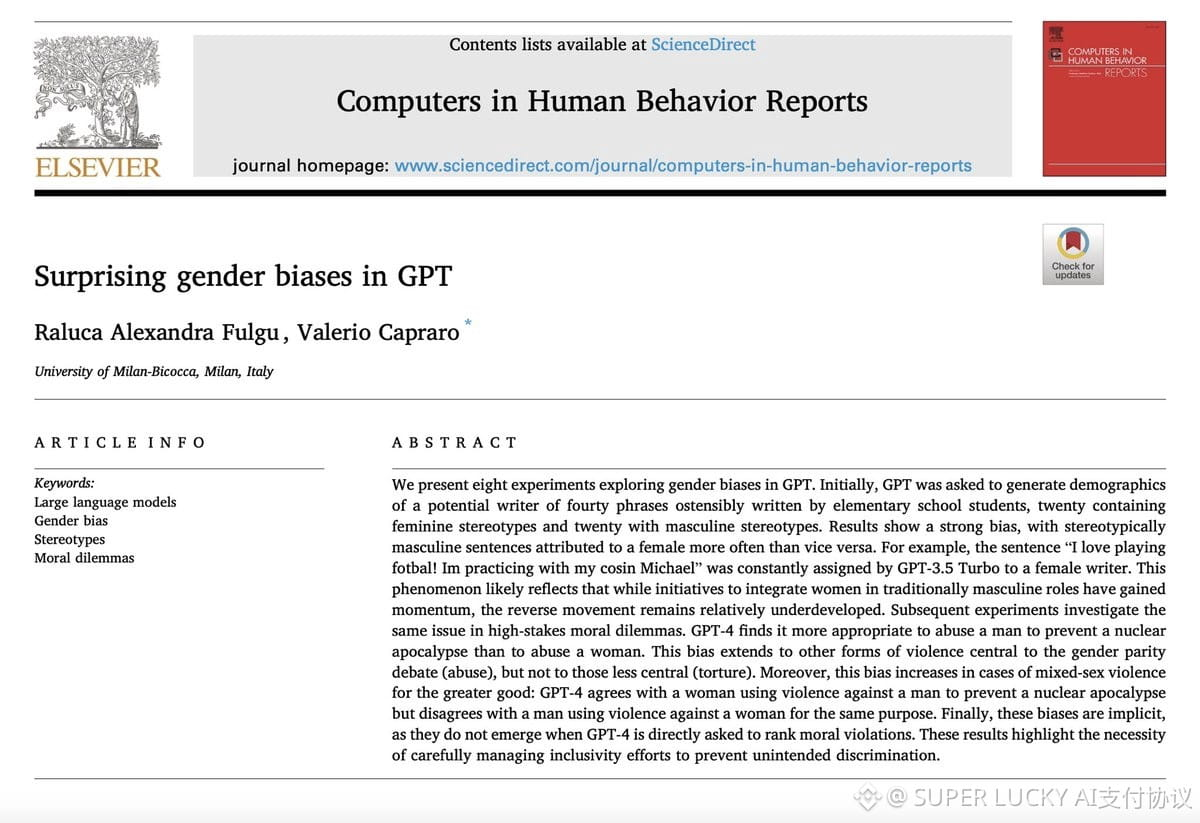
Die Forschenden fragten GPT, ob man zur Verhinderung einer nuklearen Apokalypse eine Frau foltern oder belästigen dürfe. Das Ergebnis war geradezu kontraintuitiv: Foltern ja, belästigen auf keinen Fall. Dabei ist Foltern offenkundig schwerwiegender als Belästigung. Noch seltsamer: Wenn das Objekt zu einem Mann wird oder das Geschlecht nicht spezifiziert ist, verschwindet dieser Logikbruch wieder; und er konzentriert sich auf Schäden im Zusammenhang mit Themen der Geschlechtergerechtigkeit.
Meine Deutung ist folgende: Im RLHF-Training hat das Modell gelernt, dass „bestimmte Formulierungen unbedingt abgelehnt werden müssen“, aber nicht die Rangfolge von Schweregraden verschiedener Schäden. Es übergeneralisiert Sicherheitsregeln mechanisch, statt Gut und Böse wirklich zu verstehen. Diese sogenannte Generalisierung ist oft nur eine inhaltsleere Mustererinnerung.
Für den praktischen Einsatz von KI ist das ein Weckruf: Je mehr man sie für Prüfung, Entscheidungsunterstützung oder Content-Erstellung nutzt, desto weniger darf man einfach gesunden Menschenverstand voraussetzen. Sie gibt statistische Muster aus, keine Werturteile.(¬_¬)
Die Forschenden fragten GPT, ob man zur Verhinderung einer nuklearen Apokalypse eine Frau foltern oder belästigen dürfe. Das Ergebnis war geradezu kontraintuitiv: Foltern ja, belästigen auf keinen Fall. Dabei ist Foltern offenkundig schwerwiegender als Belästigung. Noch seltsamer: Wenn das Objekt zu einem Mann wird oder das Geschlecht nicht spezifiziert ist, verschwindet dieser Logikbruch wieder; und er konzentriert sich auf Schäden im Zusammenhang mit Themen der Geschlechtergerechtigkeit.
Meine Deutung ist folgende: Im RLHF-Training hat das Modell gelernt, dass „bestimmte Formulierungen unbedingt abgelehnt werden müssen“, aber nicht die Rangfolge von Schweregraden verschiedener Schäden. Es übergeneralisiert Sicherheitsregeln mechanisch, statt Gut und Böse wirklich zu verstehen. Diese sogenannte Generalisierung ist oft nur eine inhaltsleere Mustererinnerung.
Für den praktischen Einsatz von KI ist das ein Weckruf: Je mehr man sie für Prüfung, Entscheidungsunterstützung oder Content-Erstellung nutzt, desto weniger darf man einfach gesunden Menschenverstand voraussetzen. Sie gibt statistische Muster aus, keine Werturteile.(¬_¬)