
Früher, wenn alle an Marvell gedacht haben, war die erste Reaktion: KI-ASICs, optische Verbindungen, SerDes, DSP, Silizium-Photonik, DCI.
Diesmal ist der Fokus von Structera X und Structera A jedoch darauf, MRVL in diese zentrale Linie hineinzuziehen – nämlich in den AI-Speicher-Engpass.
Heute ist das teuerste in einem KI-Rechenzentrum nicht nur die GPU.
Der Speicher wird immer teurer.
Lange Kontexte, Multi-Agenten, Inferenz-Services, Vektor-Datenbanken, In-Memory-Datenbanken, Empfehlungsmodelle – all diese Szenarien fressen wahnsinnig viel DRAM.
Die GPU übernimmt die Berechnung.
Der Speicher übernimmt das Merken.
Optische Verbindungen übernehmen den Datentransport.
Wenn der Speicher nicht ausreicht, bleibt auch eine noch so starke GPU stecken.
Das ist die Bedeutung des CXL-Ansatzes von MRVL diesmal.
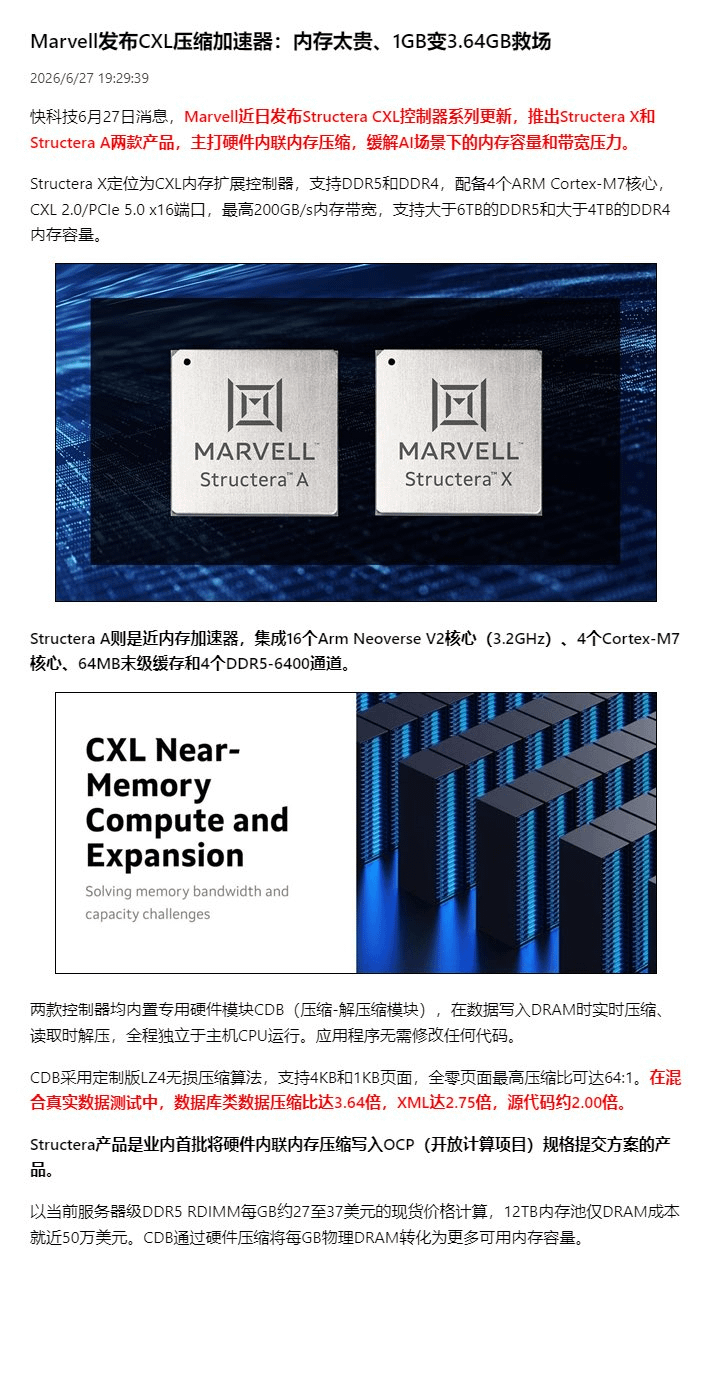
Der Kern von Structera X und Structera A ist nicht einfach das Hinzufügen eines zusätzlichen Memory-Controllers. Stattdessen wird über CXL DRAM von außerhalb des Servers eingebunden, und dann wird per Hardware-Inline-Kompression jede 1 GB physischer Speicher in mehr nutzbare Kapazität umgewandelt.
Laut offiziellen Daten kann der Kompressionsgrad bei Datenbankdaten bis zu 3,64x erreichen.
XML etwa 2,75x.
Quellcode etwa 2,0x.
Natürlich bedeutet das nicht, dass alle Daten von 1 GB auf 3,64 GB „hochkomprimiert“ werden.
Der Kompressionsgrad hängt von den Datentypen ab.
Aber der Schwerpunkt liegt auf:
Wenn Hyperscaler einen Teil der komprimierbaren Daten durch Hardwarekompression in eine effektiv größere Speicherkapazität verwandeln können, dann lässt sich – ohne allzu große zusätzliche DRAM-Einkäufe – die Knappheit beim Speicher und der Kostendruck abmildern.
Dieses Thema ist für Cloud-Anbieter besonders attraktiv.
Denn Server-Grade DDR5 RDIMM ist inzwischen bereits sehr teuer.
Ein 12-TB-Memory-Pool – allein die DRAM-Kosten könnten sich auf nahezu 500.000 US-Dollar belaufen.
Wenn die Ausbaurate der KI-Infrastruktur schneller ist als die Liefergeschwindigkeit der Chipfabriken, ist Speicher nicht mehr nur ein Standardzubehör, sondern eine strategische Ressource.
Das ist die gleiche Logik, die auch aus den jüngsten Finanzberichten von Micron hervorgeht.
KI macht aus Speicher und RAM von zyklischen Produkten wieder einen Infrastruktur-Engpass.
$MU Es geht um die Versorgungsprobleme bei HBM, DRAM und NAND.
$MRVL Bei dieser Lösung geht es um:
Wenn Speicher immer teurer wird, wie lässt sich jede einzelne GB besser nutzen?
Das ist der eigentliche Glanzpunkt von Structera.
Structera X ist eher ein Controller für Memory-Expansion.
Es geht darum, wie sich ein Server-Memory-Pool vergrößern lässt.
Structera A ist eher ein Beschleuniger für Near-Memory-Computing.
Es geht darum, bandbreitenlimitierte Aufgaben zu lösen – kann man die Berechnung näher an den Speicher verlagern?
Ganz in einfachen Worten:
X ist für die Erweiterung zuständig.
A ist für die Beschleunigung zuständig.
Beide zusammen lösen die Memory-Wall in Rechenzentren im KI-Zeitalter.
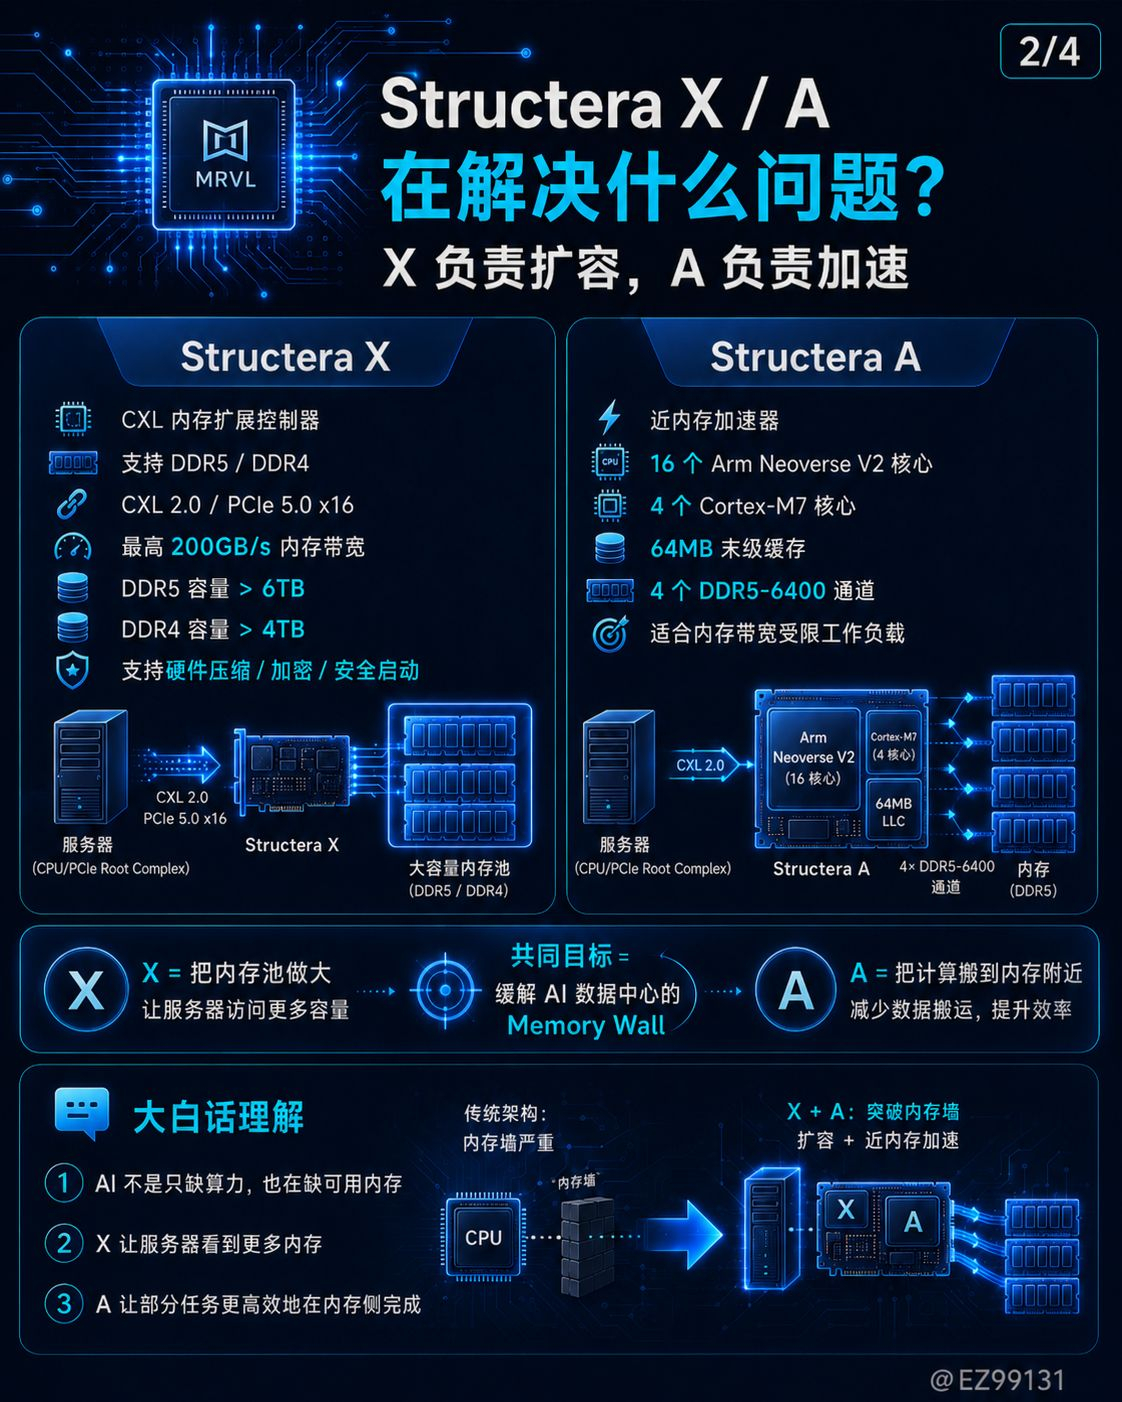
Da die Structera-Produktlinie nicht erst heute auftaucht, wurde sie bereits frühestens 2024 veröffentlicht.
Diesmal wirkt es eher so, als würde Marvell den wirtschaftlichen Wert von „CXL + Hardwarekompression“ wieder stärker in den Vordergrund rücken.
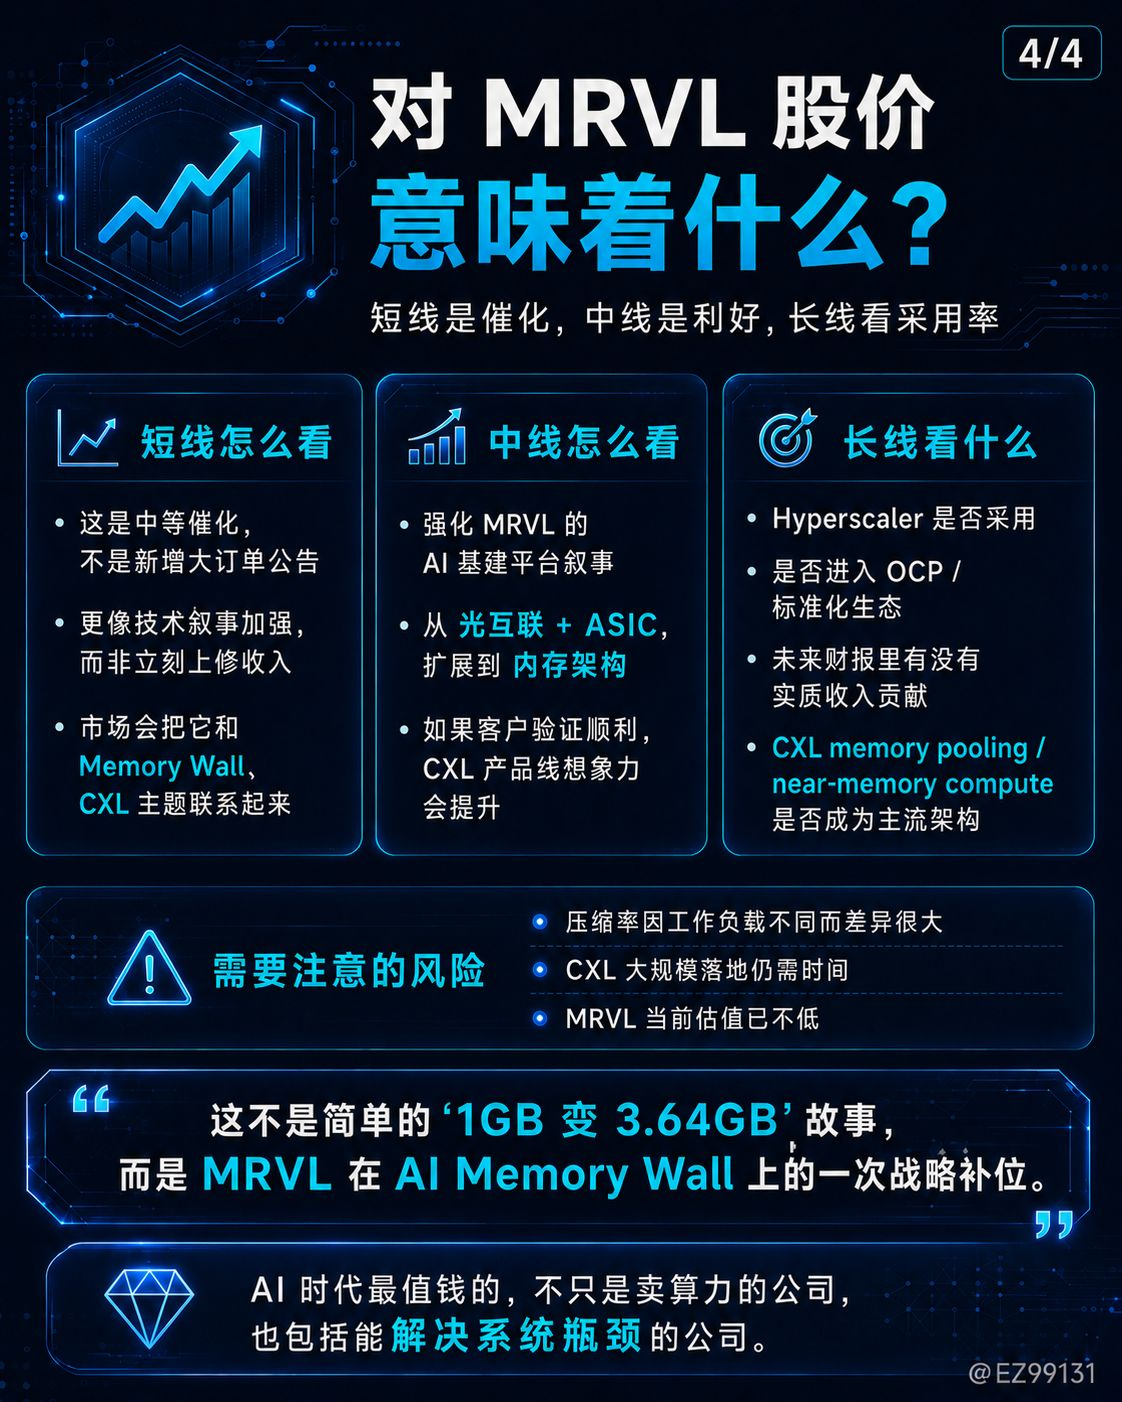
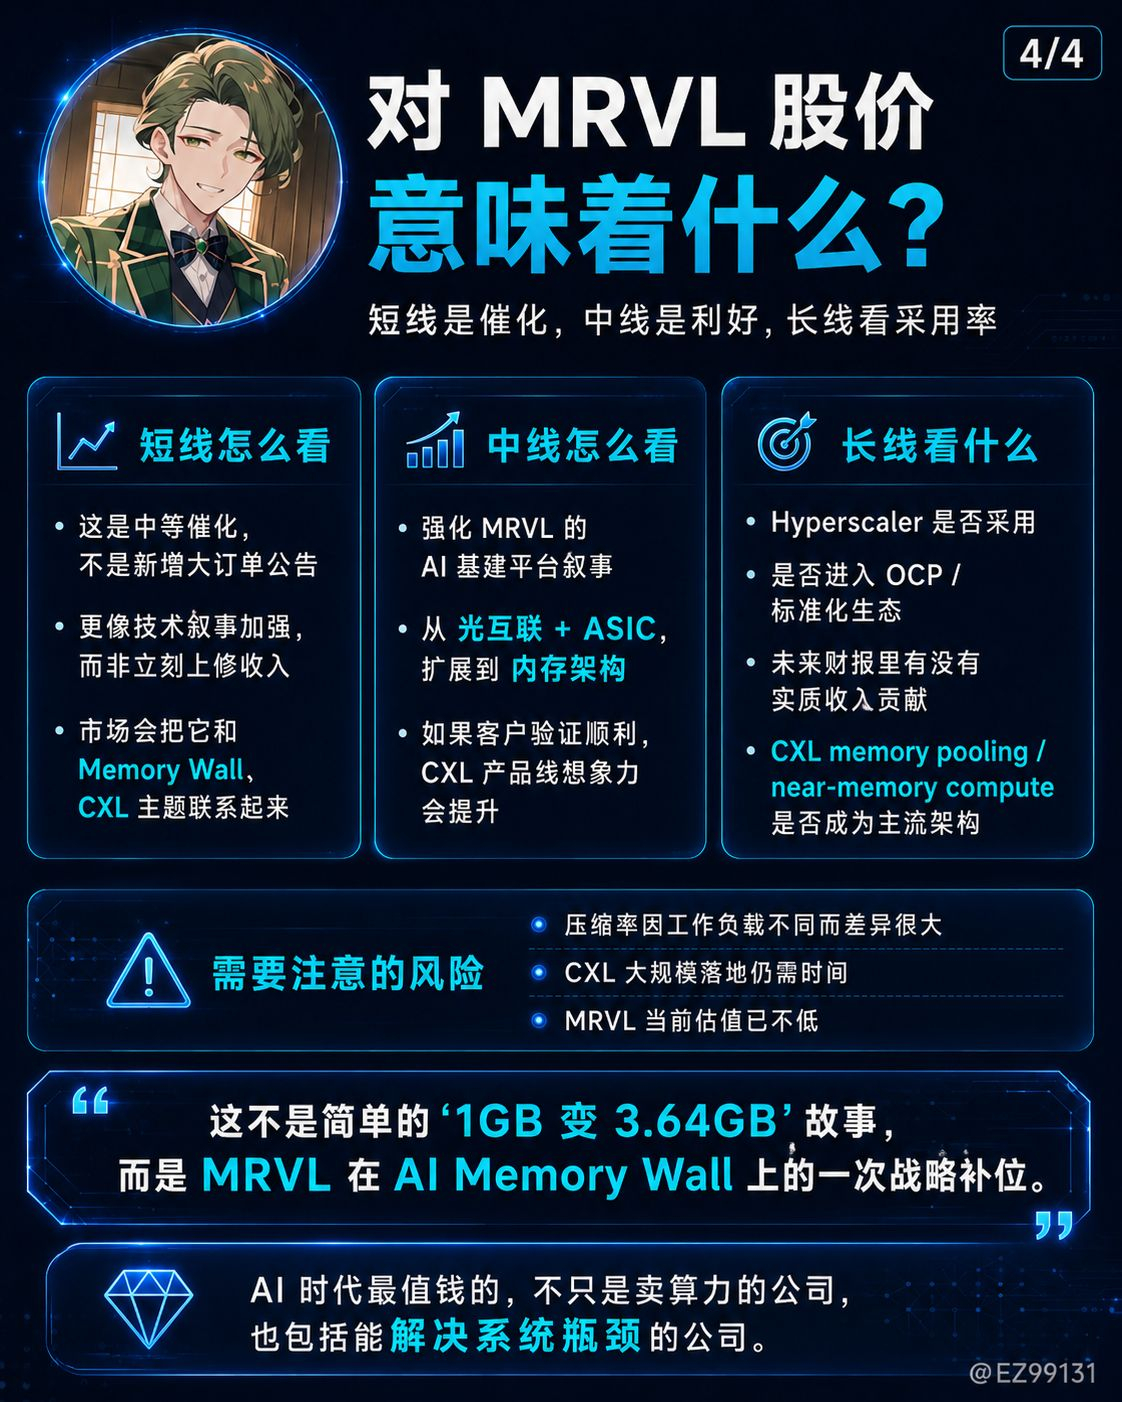
Daher ist es kurzfristig kein positiver Effekt für Bestellungen im traditionellen Sinne.
Langfristig und mittelfristig ist das für die Story von MRVL sehr wichtig.
Weil sich das KI-Infrastruktur-Puzzle von MRVL immer vollständiger zusammensetzt
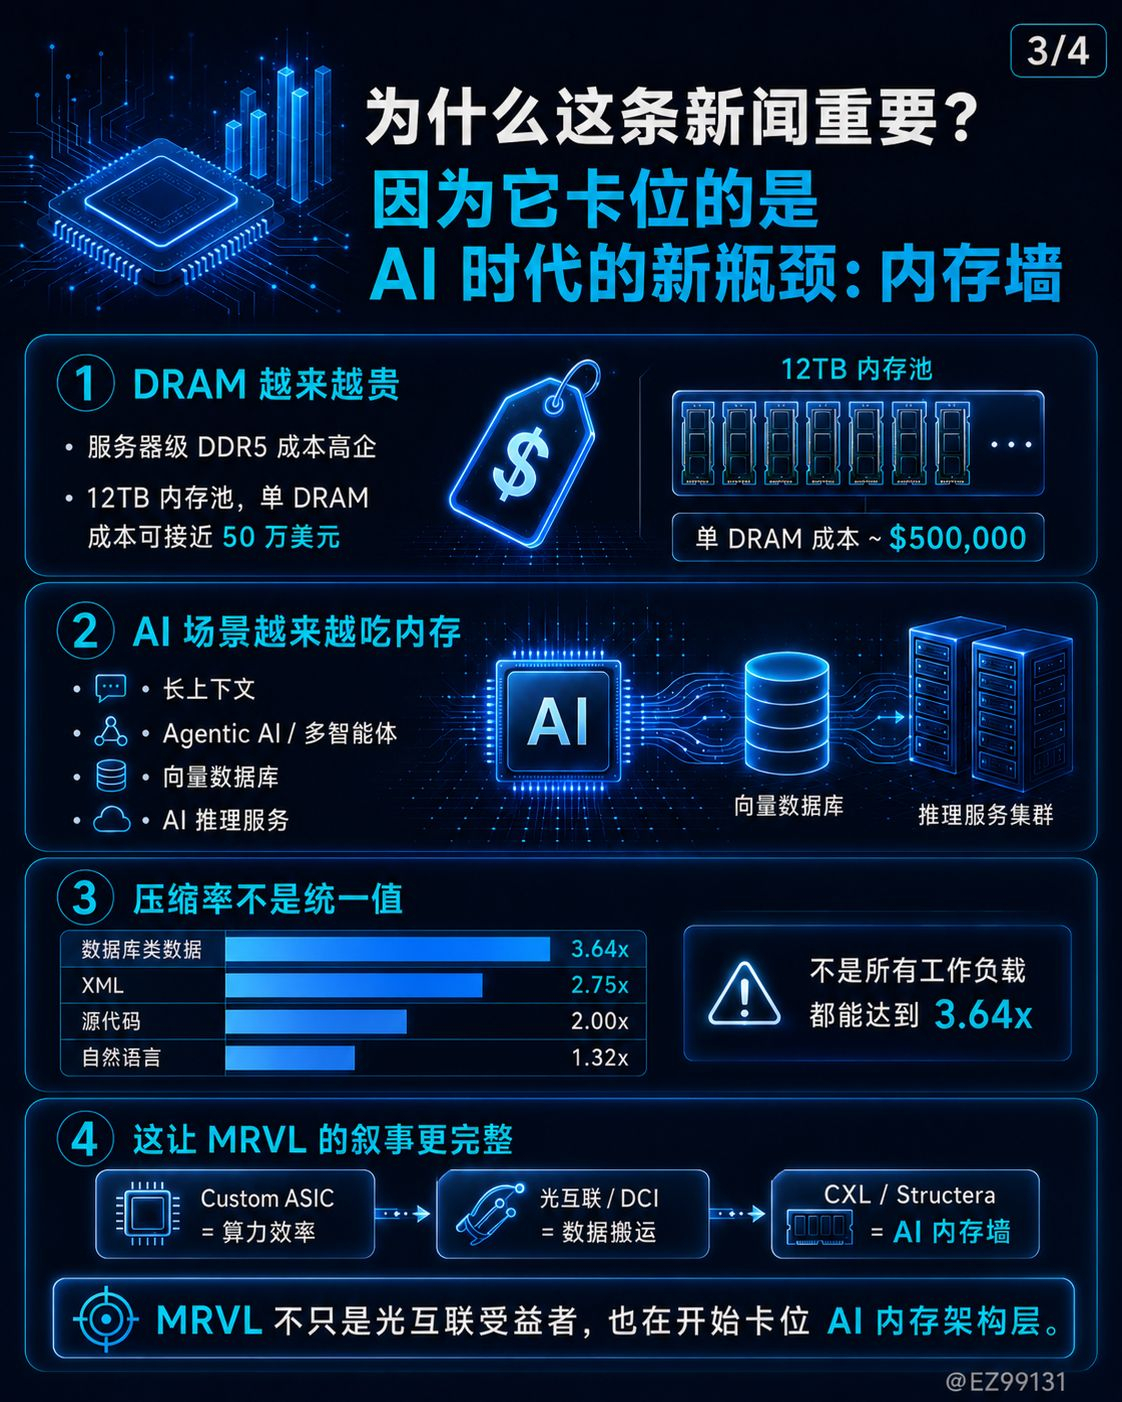
Der erste Baustein ist ein custom ASIC.
Lösung für die Effizienz des KI-Computings
Der zweite Teil ist die optische Interconnect-Verbindung und coherent DCI.
Es löst das Problem des Daten-Transports für KI.
Der dritte Teil ist CXL und die Memory-Expansion.
Es löst die KI-Memory-Wall.
Wenn man noch Celestial AIs photonic fabric hinzunimmt, geht Marvell im Grunde in eine Richtung:
Es verkauft nicht nur einzelne Chips.
Es will zur zentralen Halbleiter-Plattform für die KI-Dateninfrastruktur werden.
Das ist extrem wichtig.
Die nächste Phase der KI-Infrastruktur wird nicht nur darauf schauen, wer GPUs liefern kann.
Entscheidend ist jedoch, wer in der Lage ist, systemweite Engpässe zu lösen.
Rechen-Engpass
Memory-Engpass
Netzwerk-Engpass
Leistungsaufnahme als Engpass
Je größer ein Rechenzentrum ist, desto mehr Engpässe gibt es.
Und genau da sitzt MRVL zwischen vielen Engpässen.
Das zeigt, dass Marvell nicht nur ein Profiteur der optischen Interconnect ist – und auch nicht nur ein Profiteur von reinem ASIC-Geschäft.
Außerdem räumt es sich noch auf der Ebene der Speicherarchitektur Platz ein.
Wenn in Zukunft CXL-Memory-Pooling, CXL-Expansion und Near-Memory-Compute zur Standardarchitektur von Hyperscalern werden, dann wäre Structera eine sehr fantasievolle Produktlinie.
Das Risiko liegt darin, dass:
Erstens: Diese Meldung ist derzeit eher eine Technik- und Produktstory – keine Ankündigung für große neue Bestellungen.
Zweitens: Für eine großflächige Einführung von CXL müssen Kunden das validieren, das Ökosystem muss reifen und die Software muss angepasst werden.
Drittens: Der Kompressionsgrad lässt sich nicht in allen Szenarien auf 3,64x erreichen – die tatsächliche Wirkung hängt vom Workload ab.
Viertens: Die Bewertung von MRVL ist jetzt schon nicht niedrig, der Markt muss sehen, dass diese Produkte am Ende in die Quartalszahlen einfließen – nicht nur, dass sie in Technik-Storys stecken bleiben.
Wenn es von Hyperscalern in großem Maßstab übernommen wird, ist die Bedeutung enorm.
Es stärkt vor allem eine Entscheidungsannahme:
Im KI-Zeitalter wird die Memory-Wall zu einem genauso wichtigen Infrastruktur-Engpass wie die optische Interconnect.
Und Marvell plant gleichzeitig den Ausbau beider „Wände“.
Das ist kein Gag „1 GB werden 3,64 GB“.
Das ist ein strategischer Platzhalter von MRVL in Richtung KI-Memory-Wall.
Wenn die KI-Berechnung weiter expandiert, sind die künftig wertvollsten Unternehmen nicht nur die, die Rechenleistung verkaufen.
Dazu gehören auch Unternehmen, die dafür sorgen, dass Rechenleistung nicht durch Speicher, Netzwerk und Daten-Transport ausgebremst wird.
$MRVL Genau in diese Richtung bewegt es sich.