
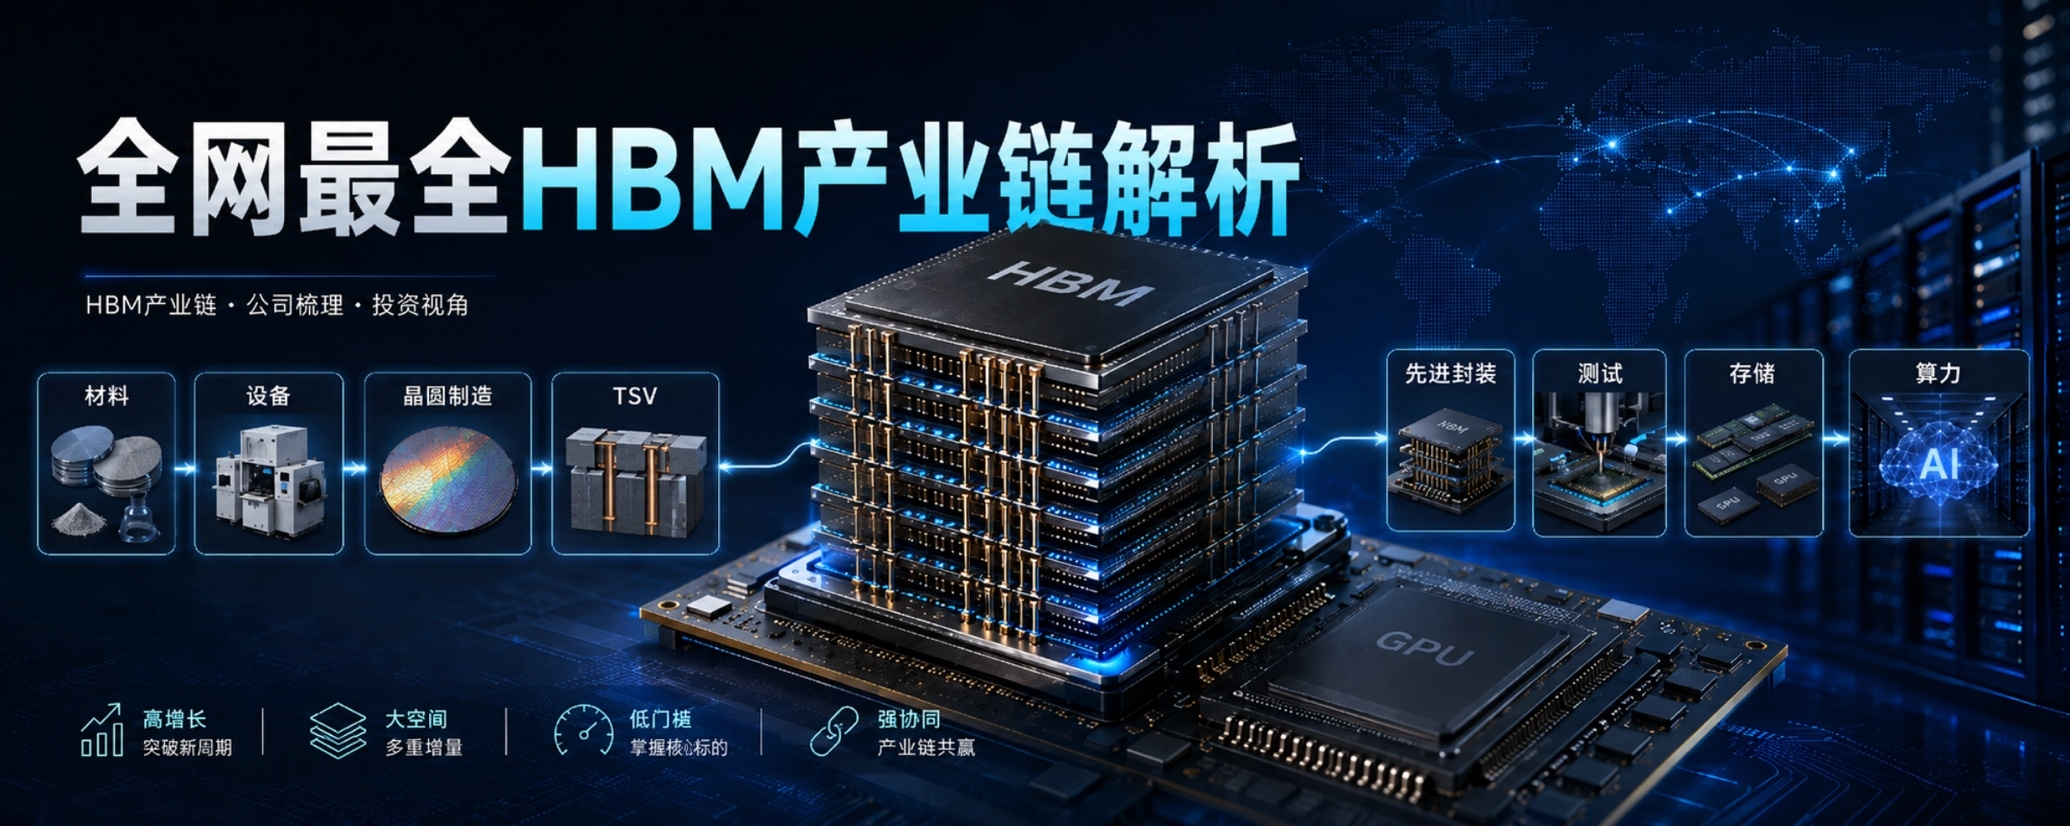
Ich habe mich einmal umgesehen und festgestellt: Es gibt im Grunde nur „Signal Calls“ und „Showcases“ (Kauf-/Erfolgsberichte). Aber niemand erklärt wirklich, wie die gesamte HBM-Branche aufgebaut ist. Nur wenn man die Wertschöpfungskette versteht, kann man wissen, was man kaufen kann und was nicht. Heute räume ich für euch ein bisschen mit dem Nebel auf und mache eine kurze Einführung.
Was ist HBM?
HBM heißt auf Chinesisch „High Bandwidth Memory“ und ist ein Hochbandbreitenspeicher. Durch Silizium-Durchkontaktierungen (TSV) werden mehrere Schichten von DRAM vertikal gestapelt, um eine extrem hohe Speicherbandbreite und eine geringe Latenz zu erreichen. So liefert HBM NVIDIA und anderen KI-GPUs eine enorme Daten- Durchsatzleistung und durchbricht das Flaschenhalsproblem der traditionellen Speicherschnittstelle („Memory Wall“).
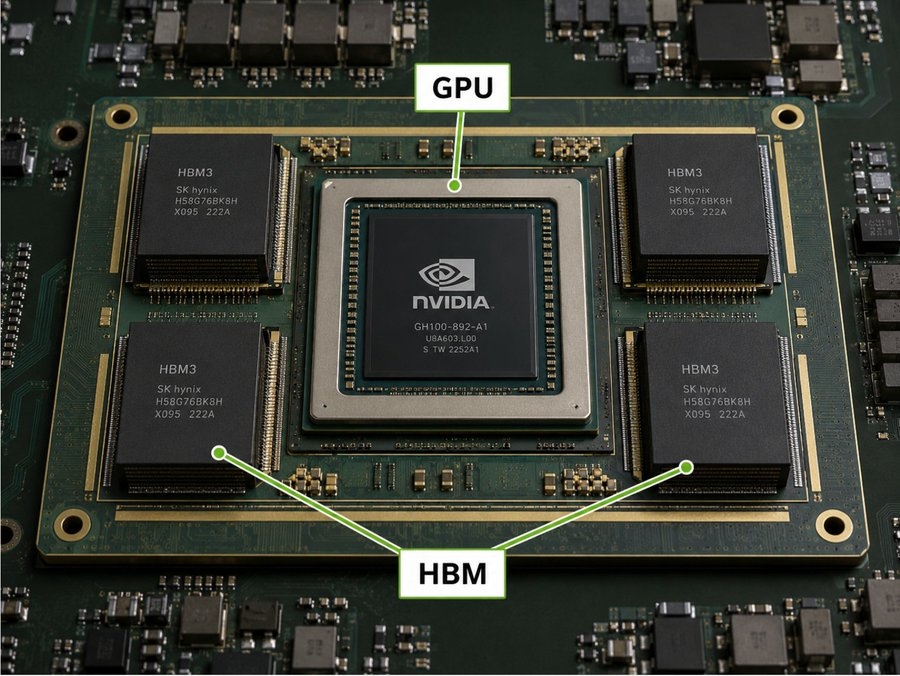
Welche Kerntechnologie steckt hinter HBM?
Ganz einfach: HBM stapelt über die Stapeltechnik mehrere DRAM-Die (nackte Chips) vertikal übereinander. Das Wichtigste dabei ist der Prozess von TSV (Silizium-Durchkontaktierungen). Beim Bohren von TSV geht es nicht nur darum, mit einem Laser Löcher zu bohren, sondern es werden Ätzgase eingesetzt, die die Siliziumschicht nach unten fortlaufend ätzen, um die Chips zu durchbohren und dann Kupfer einzubringen. Anschließend wird das oben mit Kupfer befüllte Areal mit einer Zinnschicht (Mikro-Bumps) überdeckt. Dann können mehrere nackte Chips so übereinander gestapelt werden.
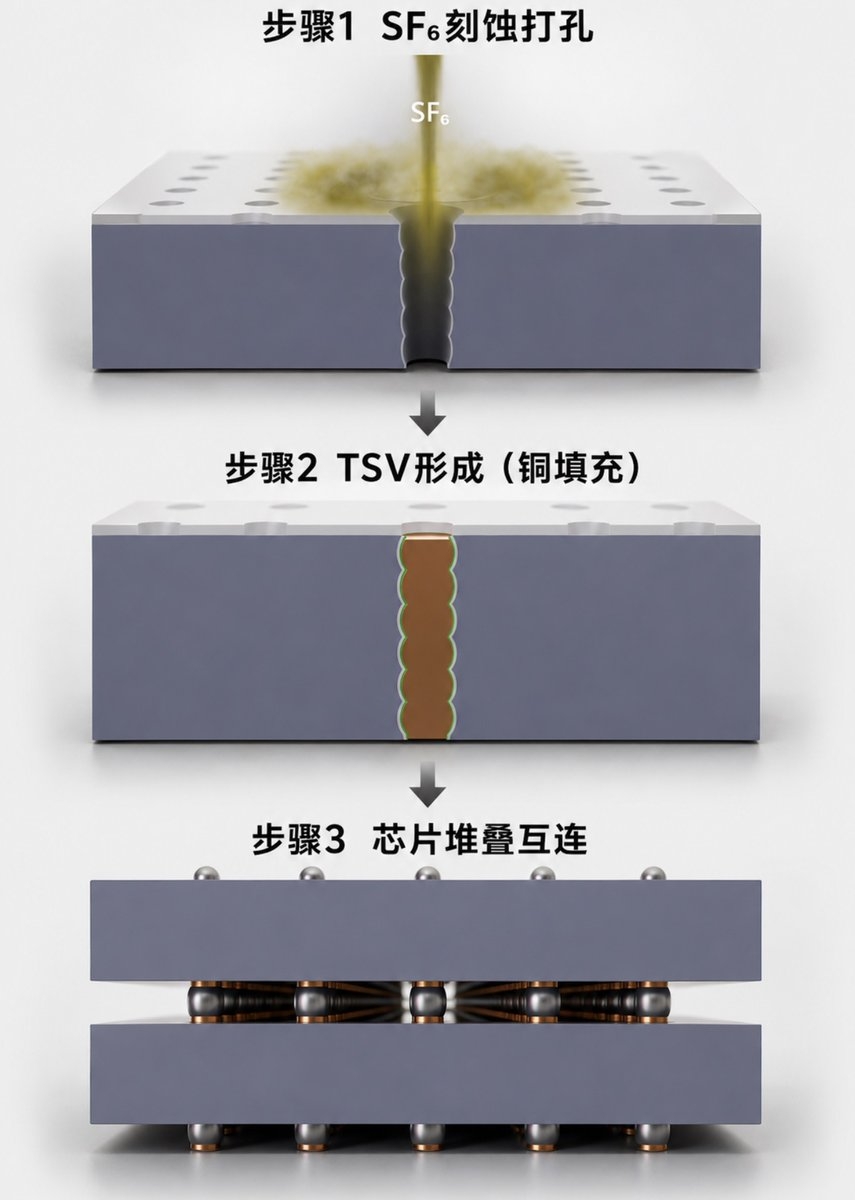
Dabei sind vier Teile am wichtigsten:
HBM-Design und -Herstellung: hergestellt von SK Hynix, Micron und Samsung Electronics selbst.
TSV-Bohrtechnik: Anwendungen von Applied Materials $AMAT und Lam Research $LRCX dominieren
Ätz-/Depositions-/Poliermaterialien: Integret (Entgr.)
$ENTG
HBM-Test-Sondenkarten: FormFactor $FORM (tief integrierter Partner von Hynix)
Aber wenn es nur um Stapeln geht, dann sind außer bei Verbindungen an den Mikrobuck-Punkten alle Stellen frei und daher sehr empfindlich. Um zu verstärken und für die Kühlung, haben die drei größten Hersteller derzeit zwei Lösungen:
SK Hynix stapelt erst alles komplett und legt dann das gesamte HBM in eine Form, in die man flüssiges Epoxidharz hineingießt, um die Lücken zu füllen. Danach erhitzt und beaufschlagt man es mit Druck, damit das Epoxidharz aushärtet.
Samsung und Micron fügen hingegen zwischen zwei Chips eine Schicht aus einem Polymerfilm hinzu. Beim Erhitzen und Andrücken schmilzt der Polymerfilm an den Mikrobuck-Punkten und vervollständigt damit das Löten; nach dem Abkühlen verfestigt sich der Film. Dann geht es im Kreislauf immer wieder nach oben weiter, um fortlaufend zu stapeln.
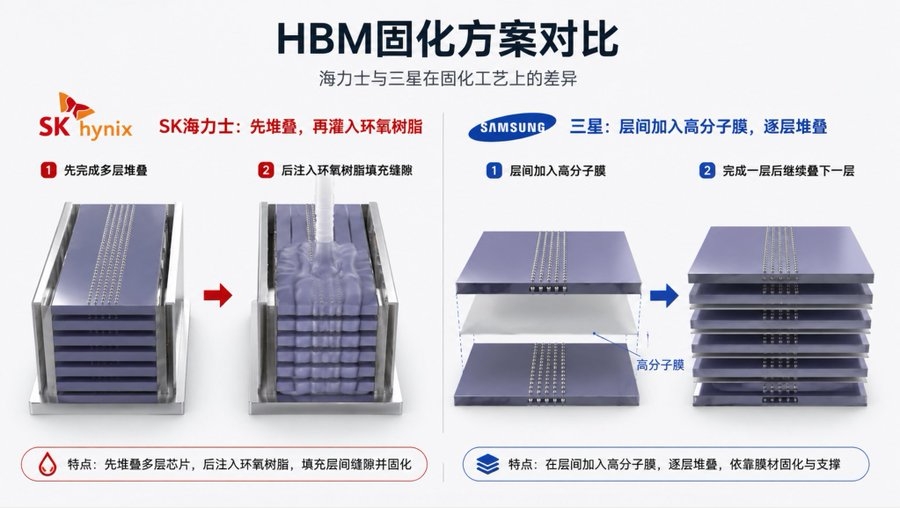
Von diesen beiden Lösungen ist SK Hynix am besten, denn beim Löten an den Mikrobuck-Punkten stört nichts anderes. Dadurch sind Fertigungstempo und Yield deutlich besser.
Bei der Kühlung mischt SK Hynix zudem in das Epoxidharz Partikel mit hoher Wärmeleitfähigkeit. Im Grunde wird das Epoxidharz zu etwas Ähnlichem wie Silikonfett. Die Kühl-Effizienz von SK Hynix ist doppelt so hoch wie die von Samsung. Warum also kann der Marktanteil von Hynix auf 50% kommen?
Also, wenn es sich um einen Hynix-ADR handelt, dann hat man direkt Mu zur Hand—und tauscht es einfach gegen Hynix.
HBM-Integration und -Verpackung — CoWos
Nach der Herstellung von HBM geht es dann um den Teil, der die Verbindung zur GPU herstellt. Bei traditionellen Leiterplatten werden die Verbindungen zwischen Chip und Chip über die Leitungen auf der PCB-Leiterplatte hergestellt. Aber die Kommunikationsleitungen zwischen HBM und GPU sind extrem umfangreich—mit der Leitungsvderdichtung normaler Leiterplatten kann man das gar nicht erreichen. Deshalb
$TSM
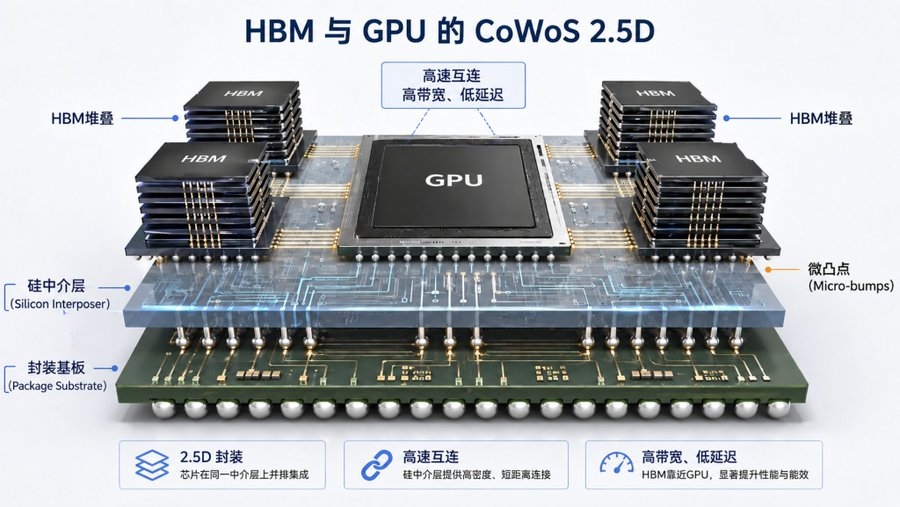
Man hat dann eine 2.5D-Verpackungsform herausgebracht—genannt CoWos.
Das Prinzip besteht darin, mit einer Lithografiemaschine direkt auf einem großen Siliziumwafer die Schaltkreise zu gravieren, die HBM und GPU miteinander verbinden können (der Leitungsabstand kann 0,8 bis 2 μm betragen). Danach werden die beiden Chips direkt zusammen verlötet. So erhält man sowohl eine hohe Bandbreite als auch eine geringe Latenz. Nvidias H100 und B200 nutzen genau diese Methode.
Was ist CoPos denn?
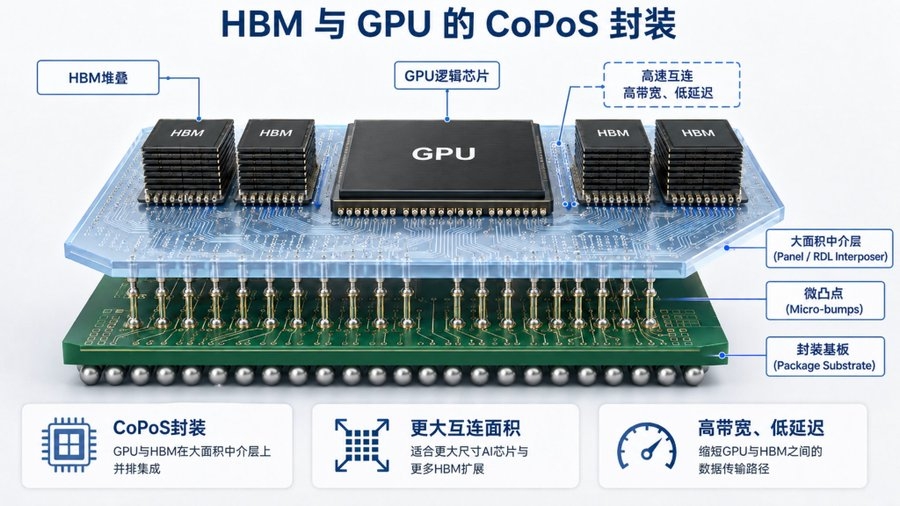
Kurz gesagt: Im Moment sind Silizium-Wafer sehr teuer und zudem meist rund. Die gängigen Chips sind jedoch viereckig—das Zuschneiden runder Wafer ist also sehr verschwenderisch. Daher wurde die Idee geboren, die Chips in einer rechteckigen „Panel-RDL-Ebene“ anzuordnen und damit die ursprüngliche runde Silizium-Zwischenschicht zu ersetzen. Dadurch wird die Konfiguration der Netzwerkanbindungen zwischen unterschiedlichen leitfähigen Schichten und Materialien gestärkt. Durch die Einführung neuer Materialien wie Glas oder Saphir können rechteckige Flächen mehrere Chips verpacken und verschiedene Chips integrieren, auch mit unterschiedlichen Größen. Gleichzeitig unterstützt das größere Retikels/Masken und mildert das Problem, dass größere Chips immer stärker verziehen/verwölben.
Aber die Interconnect-Dichte ist derzeit relativ schwach. Die Toolchains auf Panel-Ebene und der Yield befinden sich noch in Entwicklung—wir sind noch in der Testproduktion/Einführung. Das ist nicht so weit fortgeschritten wie CoWoS, das bereits vollständig ausgereift ist und in der Massenproduktion läuft.
Diese Techniken für fortschrittliche Verpackungen hängen vor allem von TSMC $TSM und $AMKR ab.
Außerdem haben diese beiden Firmen am 16. Juni noch einen 10-Jahres-Langzeitvertrag abgeschlossen, was zeigt, dass die Kapazitäten für diesen Teil tatsächlich nicht ausreichen.
CoWoS ist aktuell der Hauptweg (2.5D). CoPoS plus Glas-Substrat ist die nächste Generation im Bereich großflächiger Größen. $TSM durch die 3DFabric-Plattform lassen sie sich flexibel kombinieren und decken damit umfassend Verpackungsanforderungen von KI bis hin zu mobilen Endgeräten ab.
Aktuell gibt es in Richtung TSV-Bohrtechnik, HBM-Tests und CoWoS noch große Chancen.
Oben nur meine persönliche Analyse, keine Anlageberatung. DYOR~