

Um ehrlich zu sein, gibt es eine stille Frustration, die ich seit 2022 mit mir herumtrage, weil ich zu Online-Räumen beigetragen habe.
Keine Wut.
Nur ein niedriges Bewusstsein, das nie ganz verschwindet.
Ich habe ausführliche Marktanalysen in öffentlichen Foren geschrieben. Forschungsanalysen geteilt, die Hunderte von Shares bekommen. Echte Stunden damit verbracht, Threads zusammenzustellen, auf denen andere aufbauen, remixen und in ihrer eigenen Arbeit zitieren. Einige dieser Posts werden heute noch in Gesprächen erwähnt, an denen ich nicht einmal teilnehme.
Ich wurde genau einmal für jeden von ihnen bezahlt. Normalerweise gar nichts.
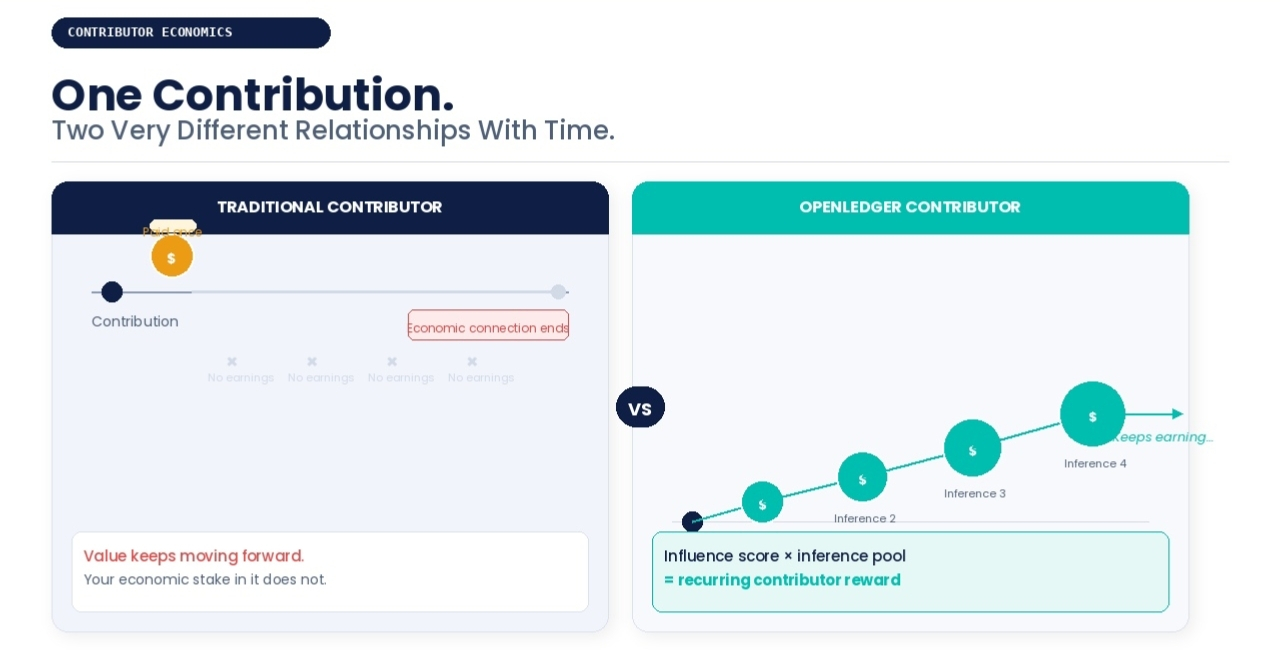
Der Wert bewegte sich weiter. Meine wirtschaftliche Verbindung zu ihm endete in dem Moment, als ich veröffentlichte.
Diese spezifische Erfahrung lässt mich OpenLedgers Attributionsmodell anders lesen als die meisten Dinge in diesem Bereich gerade.
Denn was es tatsächlich beschreibt, ist nicht nur eine bessere Version von einmaligen Beitragszahlungen. Es beschreibt eine strukturell andere Beziehung zwischen Beitrag und wirtschaftlichem Ergebnis über die Zeit.
Hier ist der Teil, der meine Aufmerksamkeit hält.
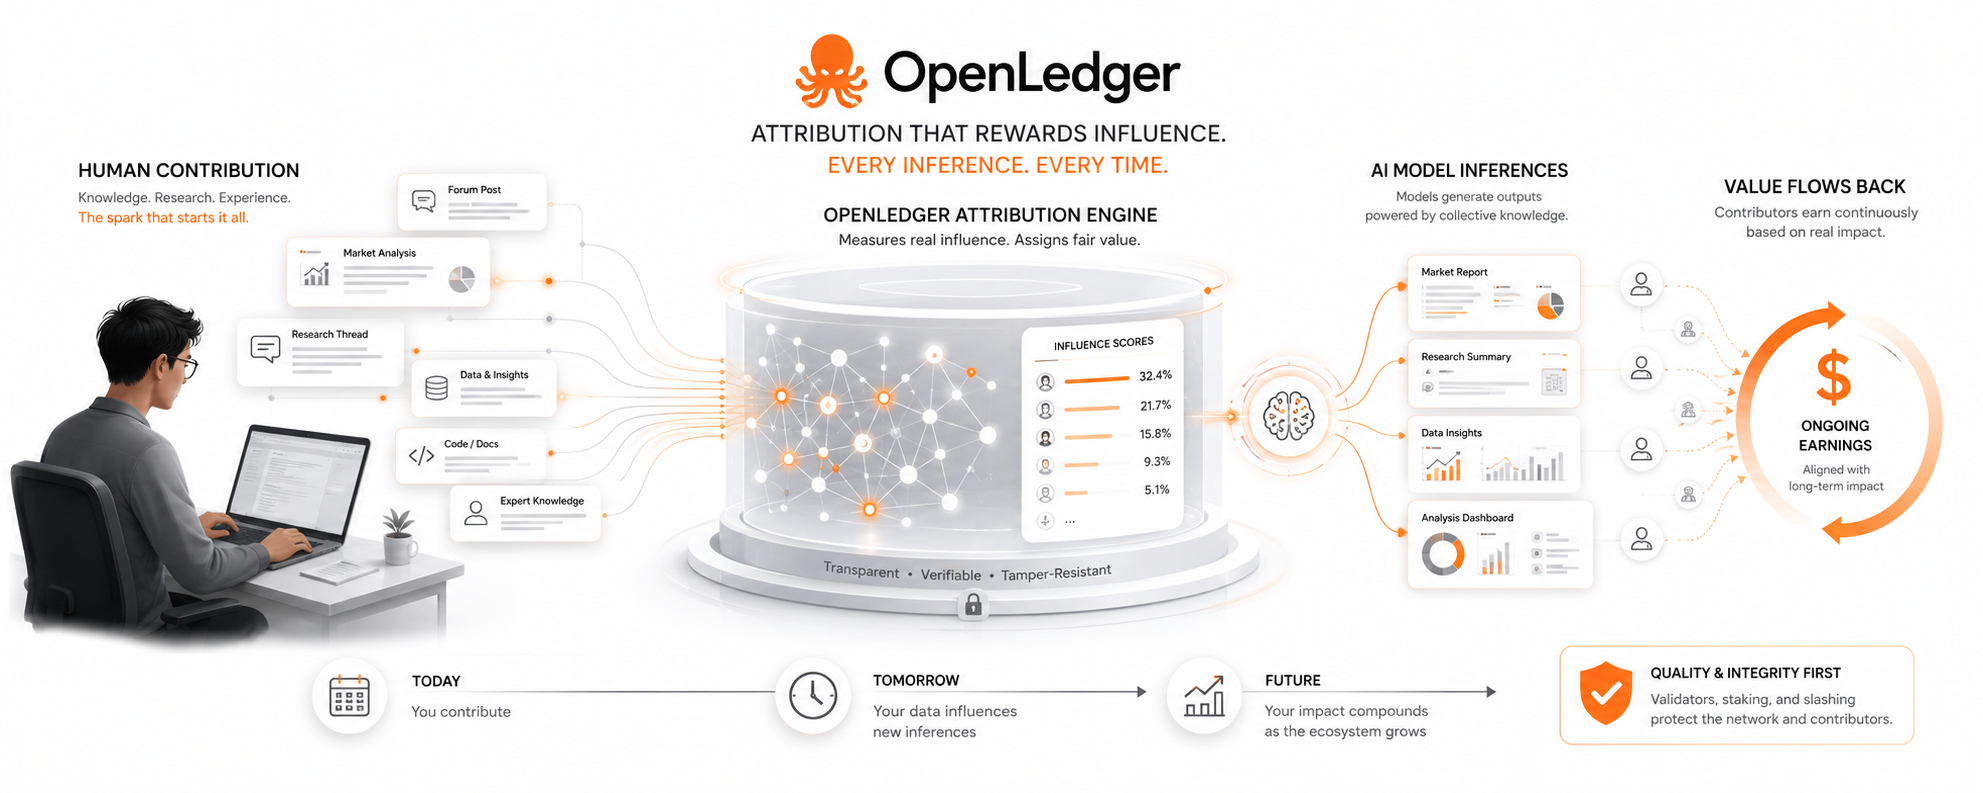
Wenn ein spezialisiertes Modell auf OpenLedger eine Anfrage bearbeitet, berechnet das System, wie viel jeder einzelne Datenbeitrag tatsächlich dieses spezifische Ergebnis geprägt hat. Nicht gleichmäßig über alle Beitragenden. Jeder Datenpunkt trägt eine Einflussbewertung basierend auf seinem gemessenen Einfluss auf das Ergebnis. Der Beitragende, dessen Daten bei diesem speziellen Output höher punkten, erhält einen proportional größeren Anteil aus dem Pool der Beitragsgebühren für diese Inferenz.
Jede Inferenz. Nicht nur beim ersten Lauf des Modells.
Eine Dateneinreichung hat also keinen festen Lebenszeitwert, der zum Zeitpunkt des Beitrags festgelegt wird. Ihr wirtschaftlicher Wert wird mit jedem Modellaufruf, den sie beeinflusst, neu berechnet. Ein sorgfältig konstruierter Beitrag zu einem aktiv genutzten Modell generiert Einnahmen, wie ein gut zitiertes Referenzdokument immer wieder in neue Forschungen einfließt. Nicht weil jemand großzügig ist. Weil das Messsystem das Verdienen direkt mit dem fortlaufend gemessenen Einfluss verknüpft.
Diese strukturelle Kluft ist wichtiger, als es auf den ersten Blick erscheint.
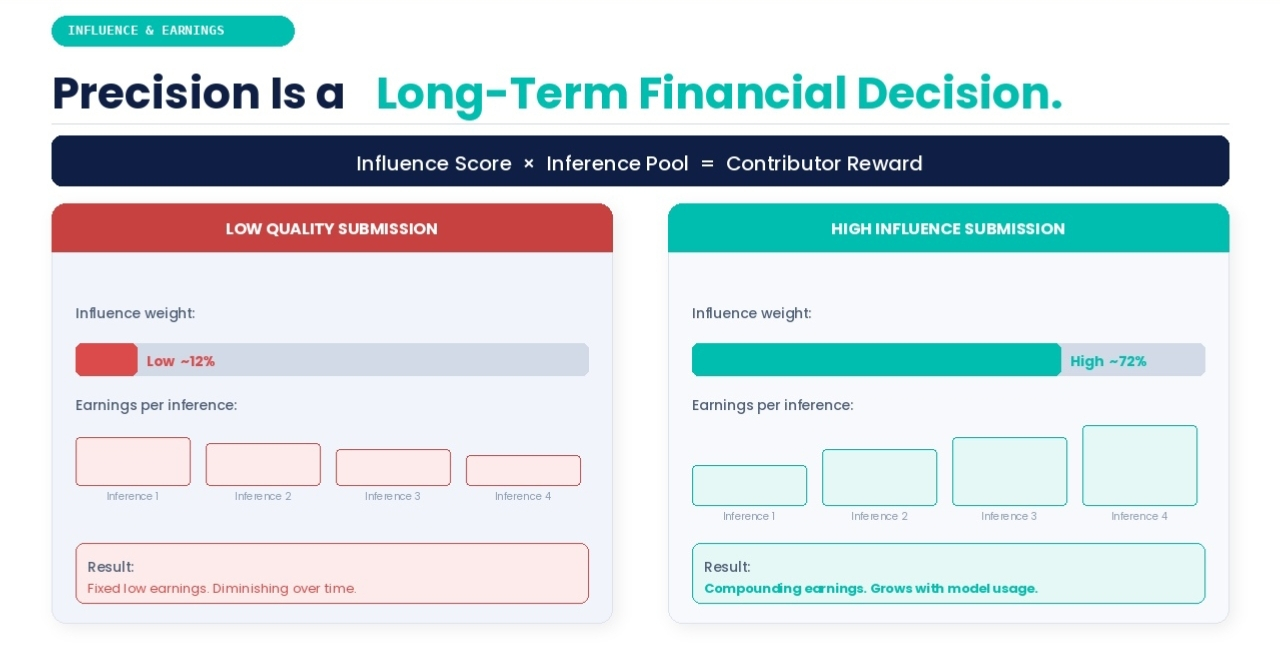
In einem Standard-Datenmarktplatz verändert Qualität über einen grundlegenden akzeptablen Schwellenwert hinaus nicht dein Ergebnis. Schnelle Einreichung bei minimaler Qualität und langsame Einreichung mit tiefem Fachwissen führen nach Abschluss der Zahlung zum gleichen Ergebnis. Die Anreizstruktur unterscheidet nicht zwischen ihnen, nachdem die Transaktion abgeschlossen ist.
In einem System, in dem fortlaufender Einfluss fortlaufende Einnahmen bestimmt, wird Präzision zu einer langfristigen finanziellen Entscheidung anstatt zu einem professionellen Gefallen. Ein Beitragender, der sein Fachgebiet tief versteht und Daten einreicht, die in zukünftigen Inferenzmodellen stark punkten, handelt nicht nur gründlich. Er verstärkt eine Position im zukünftigen Output eines Modells. $US
Das verändert, wen das Netzwerk im Laufe der Zeit rational anzieht.
Aber ich möchte ehrlich mit der unbequemen Seite umgehen.
Fortlaufende Attribution ist ein erheblich schwierigeres technisches Problem als die anfängliche Attribution.
Zu beweisen, dass ein Datenpunkt zum Zeitpunkt der Einreichung relativ sauber ist. Ein Zeitstempel existiert. Ein Protokoll existiert. Die Daten haben entweder das frühe Training geprägt oder nicht.
Zu beweisen, dass derselbe Beitrag Monate später weiterhin echten Einfluss hat, über einen wachsenden Pool von Beitragenden, während das Modell weitere Updates und Feinabstimmungen erhält, ist eine ganz andere Herausforderung. Individuelle Einflussbewertungen komprimieren sich natürlicherweise, wenn die Pools der Beitragenden wachsen. Was in einer frühen Trainingsphase stark gewichtet wird, sieht sich im Laufe der Zeit zunehmender Konkurrenz durch neuere, aktuellere Einreichungen gegenüber. Ein Beitragender, der in den frühen Phasen eines Modells eine starke Position aufbaut, hält diese Position nicht automatisch unbefristet. Die Mathematik verdünnt sich, wenn der gesamte Pool um ihn herum wächst.
Und der Druck im Gaming steigt im Verhältnis dazu, wie finanziell bedeutend die Einnahmequellen werden.
Wenn fortlaufendes Einkommen von algorithmischen Bewertungen abhängt, wird es für anspruchsvolle Akteure rational, sich auf die Bewertung zu optimieren, anstatt auf echte Modellverbesserungen.
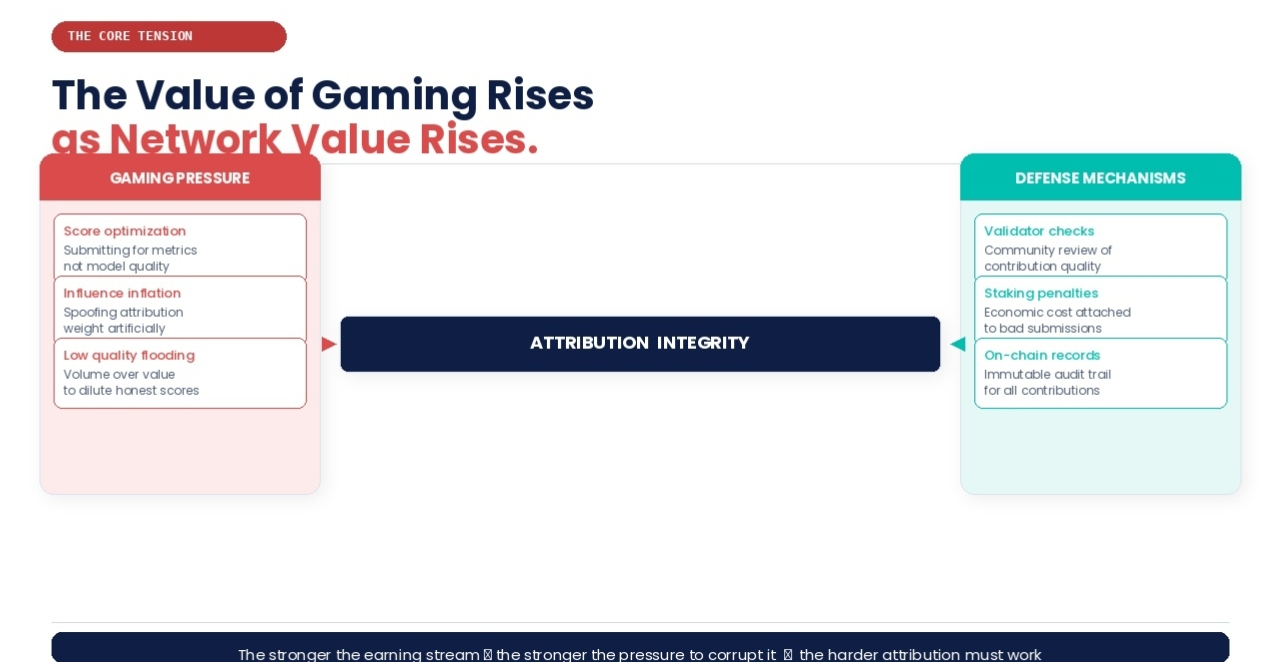
Die Kluft zwischen dem, was die Metrik misst, und dem, was sie belohnen sollte, wird unter genau den Bedingungen größer, bei denen der finanzielle Anreiz, sie auszunutzen, am stärksten wächst.
Die Validator-Mechanik und Staking-Strafen von OpenLedger existieren speziell, um dem entgegenzuwirken. Wirtschaftliche Kosten sind mit qualitativ minderwertigen Einreichungen verbunden.
Aber ob diese Widerstandsmechanismen ihre Integrität bewahren, während der Netzwerkwert skaliert und die Belohnung für das Gaming gleichzeitig steigt, ist eine wirklich offene Frage.
OPEN-Preise, ob diese Frage eine dauerhafte Antwort findet.
Es geht nicht nur darum, ob die Infrastruktur zur Messung des Beitrags aufgebaut wird. Ob sie unter echtem finanziellen Druck genau genug bleibt, um die langfristigen Qualitätsentscheidungen der Beitragenden zu rechtfertigen, die auf Vertrauen basieren.
Das ist ein erheblich schwierigeres Ding zu bepreisen als nur die Infrastrukturadoption.
Und hier ist, was in meinen Gedanken nach all dem immer wieder zurückkommt. $LAB
Wenn Wissen, das zu KI-Systemen beigetragen wird, eine fortlaufende wirtschaftliche Beziehung statt einer geschlossenen einmaligen Transaktion tragen würde... würden die Menschen, die dieses Wissen derzeit umsonst geben, anfangen, andere Entscheidungen darüber zu treffen, wo und wie präzise sie beitragen?
Und wenn sie das tun... wie sieht die Qualität der KI-Entwicklung tatsächlich auf der anderen Seite dieser Verhaltensänderung aus?