
Um ehrlich zu sein, komme ich manchmal immer wieder zu demselben Gedanken über KI zurück, und er geht einfach nicht weg.
Wir reden immer wieder über dieselben Dinge: größere Modelle, schnellere Inferenz, besseres Denken, neue Benchmarks, smartere Agenten. Und ja, all das verbessert sich wirklich. Der Fortschritt ist echt und sichtbar. Aber irgendwo in diesem Wettlauf wird eine sehr einfache Frage oft ignoriert.
Wer schafft eigentlich den Wert hinter all dieser KI?
Denn wenn du langsamer machst und genau hinschaust, wird offensichtlich, dass alles, was KI heute macht, auf einer Sache basiert: Daten. Und nicht nur technische Daten, sondern tief menschliche Daten. Gespräche, die Menschen führen, Dinge, die sie schreiben, Fehler, die sie machen, Code, den sie veröffentlichen, Meinungen, die sie teilen, Korrekturen, die sie später hinzufügen – basically der gesamte Fußabdruck menschlichen Denkens im Internet.
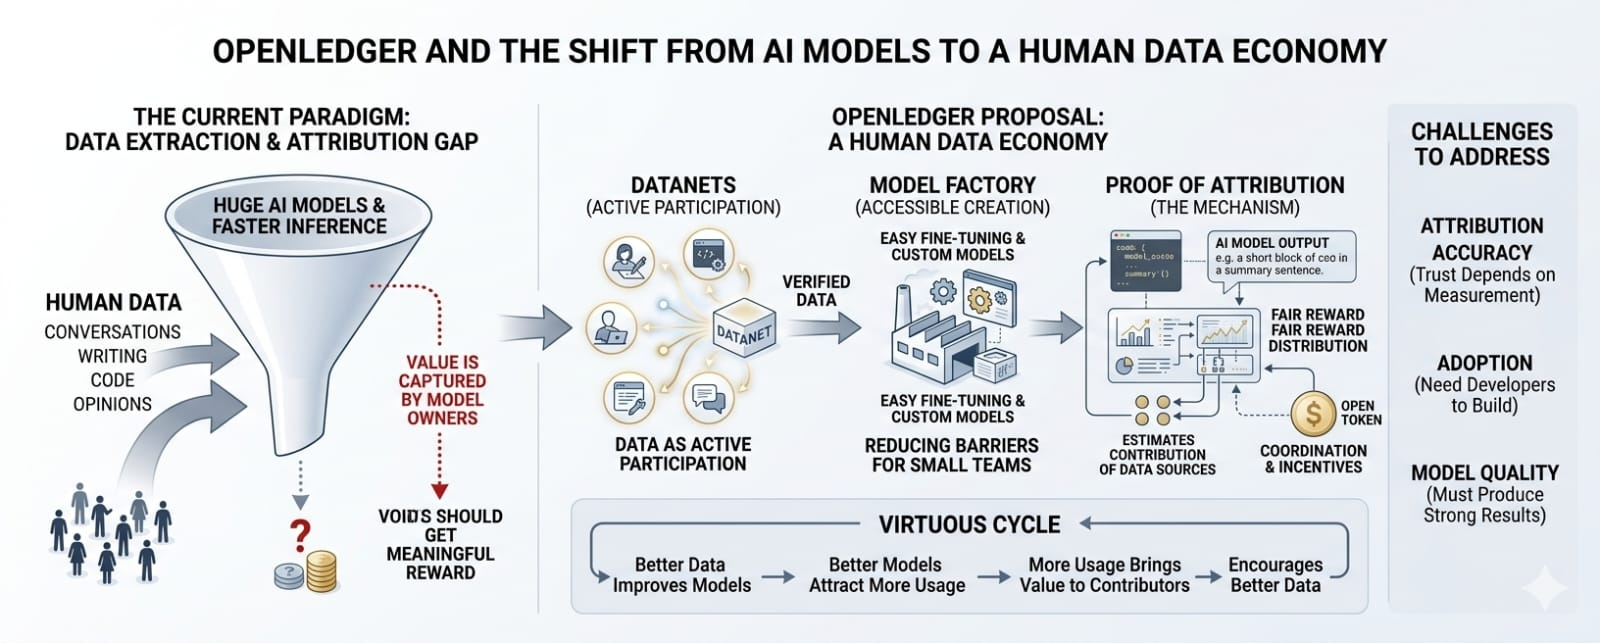
Aber das Seltsame passiert danach. Wenn das alles erst einmal in große Modelle aufgenommen ist, wird der entstehende Wert größtenteils von den Besitzern der Modelle abgeschöpft. Die Menschen, die die ursprünglichen Daten tatsächlich erzeugt haben, bekommen normalerweise nichts Sinnvolles im Gegenzug. Es gibt sehr wenig Anerkennung, und fast keine direkte Belohnung, die an ihren Beitrag gekoppelt ist.
An genau dem Punkt habe ich angefangen, mir Ideen wie OpenLedger anzusehen.
Auf den ersten Blick wirkt es wie einfach nur ein weiteres KI- und Blockchain-Projekt. Und ehrlich gesagt gibt es viele Projekte wie dieses – bei denen „KI + Blockchain“ eher eine Marketing-Schicht ist als eine echte Veränderung. Aber wenn man etwas genauer hinschaut, ist der Blickwinkel hier leicht anders. Es ist nicht wirklich besessen davon, „bessere Modelle“ im traditionellen Sinn zu bauen. Stattdessen stellt es etwas Unangenehmeres und zugleich Wichtigeres in den Mittelpunkt.
Können wir wirklich eine KI-Ökonomie aufbauen, in der Beiträge sinnvoll gemessen und belohnt werden?
Diese Frage verändert die Richtung komplett.
Die Idee der Datanets passt hier hinein. Anstatt Daten so zu behandeln, als wären sie etwas, das man nebenbei abgreift oder sammelt und dann vergisst, werden sie Teil eines strukturierten, fortlaufenden Systems, in dem Menschen Daten für konkrete KI-Anwendungsfälle erstellen, verifizieren und verbessern können. Es klingt einfach, wenn man es so sagt, aber die Konsequenzen sind groß. Denn Daten hören auf, ein stiller Input zu sein, und werden zu etwas, das näher an aktiver Teilhabe an einer Ökonomie liegt.
Dann gibt es die Idee einer Model Factory. Dieser Teil ist leicht zu übersehen, aber er ist enorm wichtig. Aktuell ist der Aufbau oder das Fine-Tuning von KI-Systemen größtenteils noch auf Teams mit starken technischen Ressourcen beschränkt. Wenn du diese Hürde reduzierst und das Erstellen von Modellen zugänglicher machst, öffnest du plötzlich die Tür für eine viel breitere Gruppe von Entwicklern – nicht nur große Forschungslabore, sondern auch kleinere Teams und sogar einzelne Personen, die Ideen haben, aber nicht die Infrastruktur.
Doch das wichtigste und zugleich schwierigste Konzept ist Proof of Attribution.
Ab hier wird es wirklich kompliziert. Denn heute, wenn eine KI einen Output erzeugt, ist alles miteinander vermischt. Es gibt keine klare Möglichkeit zu sagen, welche exakte Datenquelle welchen Teil des Ergebnisses beeinflusst hat. Alles wird in einer mathematisch verteilten Weise in das Modell aufgenommen und praktisch nicht nachverfolgbar gemacht.
Proof of Attribution versucht, das zu ändern, indem geschätzt wird, wie stark unterschiedliche Datenquellen zu einem bestimmten KI-Output beitragen, sodass Belohnungen gerechter verteilt werden können. Wenn so etwas tatsächlich im großen Maßstab funktioniert, würde es die Struktur der KI-Ökonomie komplett verändern. Denn plötzlich sind Datenbeiträge nicht mehr unsichtbar – sie werden Teil eines messbaren Systems zur Wertschöpfung.
Auf technischer Ebene spielt auch die EVM-Kompatibilität eine Rolle bei der Verbreitung. Wenn sie mit Ethereum-Tools und -Infrastruktur in Einklang bleiben, müssen Entwickler nichts von Grund auf neu lernen. Sie können bekannte Wallets, Smart Contracts und bestehende Workflows nutzen. Diese Art von Kompatibilität klingt vielleicht nach Kleinigkeiten, aber in echten Ökosystemen entscheidet sie oft darüber, ob etwas angenommen oder ignoriert wird.
Das $OPEN token wird dann zur Koordinationsschicht für das System. Es geht in diesem Kontext nicht nur ums Handeln oder um Spekulation, sondern darum, Nutzung, Belohnungen, Governance und Anreize in einer einzigen Schleife zu verbinden. Theoretisch fließt, wenn Menschen das System nutzen, der Wert in das System zurück, und die Mitwirkenden werden basierend auf ihrer Teilnahme belohnt.
Aber um ehrlich zu sein: Nichts davon ist einfach.
Es gibt mindestens drei große Herausforderungen, die sofort ins Auge fallen.
Das erste ist die Attribution Accuracy. Wenn das System Beiträge nicht zuverlässig messen kann, dann wird alles, was darauf aufbaut, fragwürdig. Das Vertrauen bricht in solchen Systemen sehr schnell.
Das zweite ist die Adoption. Selbst wenn die Idee stark ist, müssen Entwickler und Nutzer sie tatsächlich umsetzen. Ohne echte Nutzung bleibt es nur eine Idee auf dem Papier.
Das dritte ist die Modellqualität. Am Ende interessieren sich Nutzer nicht für Theorie – sie interessieren sich für Ergebnisse. Wenn das System langsamere oder schwächere Outputs erzeugt, bleiben sie nicht, egal wie fair das Belohnungssystem ist.
Trotzdem ist der spannendste Teil all dessen die Schleife, die es zu erzeugen versucht: Bessere Daten verbessern Modelle, bessere Modelle bringen mehr Nutzung, und mehr Nutzung bringt mehr Wert zurück zu den Beitragsleistenden – was wiederum bessere Daten anregt. Es wird zu einem Kreislauf statt zu einer Einbahn-Pipeline.
Und vielleicht ist genau das die eigentliche Veränderung hier.
Nicht nur intelligentere KI-Systeme zu bauen, sondern langsam neu darüber nachzudenken, wie Intelligenz, Daten und Eigentum überhaupt miteinander verbunden sind.
Man kann schwer sagen, wohin das führt. Eine KI-Ökonomie zu entwerfen ist viel komplizierter, als man sie in der Theorie beschreiben kann. Aber eines wird zunehmend klar: Je mächtiger KI wird, desto mehr hören die Fragen rund um sie auf, nur technische Fragen zu sein.
Sie werden wirtschaftlich und strukturell.
Wer trägt bei? Wer wird belohnt? Und wie definieren wir „fair“, wenn ein System auf kollektiven menschlichen Inputs basiert?
Und vielleicht werden diese Fragen am Ende die nächste Phase von KI prägen – mehr als jedes Benchmark jemals.
