

OpenLedger bringt mich zum Nachdenken über eine der hässlichsten Dinge in Krypto und AI gleichzeitig: Jeder will die Belohnung, aber fast niemand will über das Chaos darunter sprechen. Die Daten. Die Quelle. Die Leute, die tatsächlich etwas beigetragen haben. Die Fake-Nutzer. Die Farmer. Die unsichtbare Arbeit, die von einem System verschluckt und dann mit einem saubereren Logo zurück an alle verkauft wird.
Schau, ich habe genug von den AI Crypto-Pitches.
Echt müde.
Jede Woche gibt es ein neues Projekt, das vorgibt, die endgültige Antwort gefunden zu haben. Ein weiterer Token. Ein weiteres Dashboard. Ein weiterer Thread, der erklärt, warum dies die "Zukunft der Intelligenz" oder welcher Ausdruck auch immer diesen Monat funktioniert.
Irgendwann hörst du auf zu klatschen.
Man fragt doch nur: Was ist hier eigentlich kaputt?
Mit OpenLedger ist zumindest der kaputte Teil real.
KI-Modelle brauchen Daten. Kein Magie. Keine Vibes. Daten. Menschliche Arbeit. Community-Wissen. Spezifische Forschung. Code. Schreiben. Trading-Verhalten. Lokales Wissen. Diese komischen kleinen Ecken des Internets, die nur deshalb zählen, weil echte Menschen Zeit darauf verwendet haben, sie zu erschaffen.
Dann frisst das Modell alles auf.
Und der Beitragsleistende verschwindet.
Dieser Teil stört mich.
Das sollte mehr Leute stören.
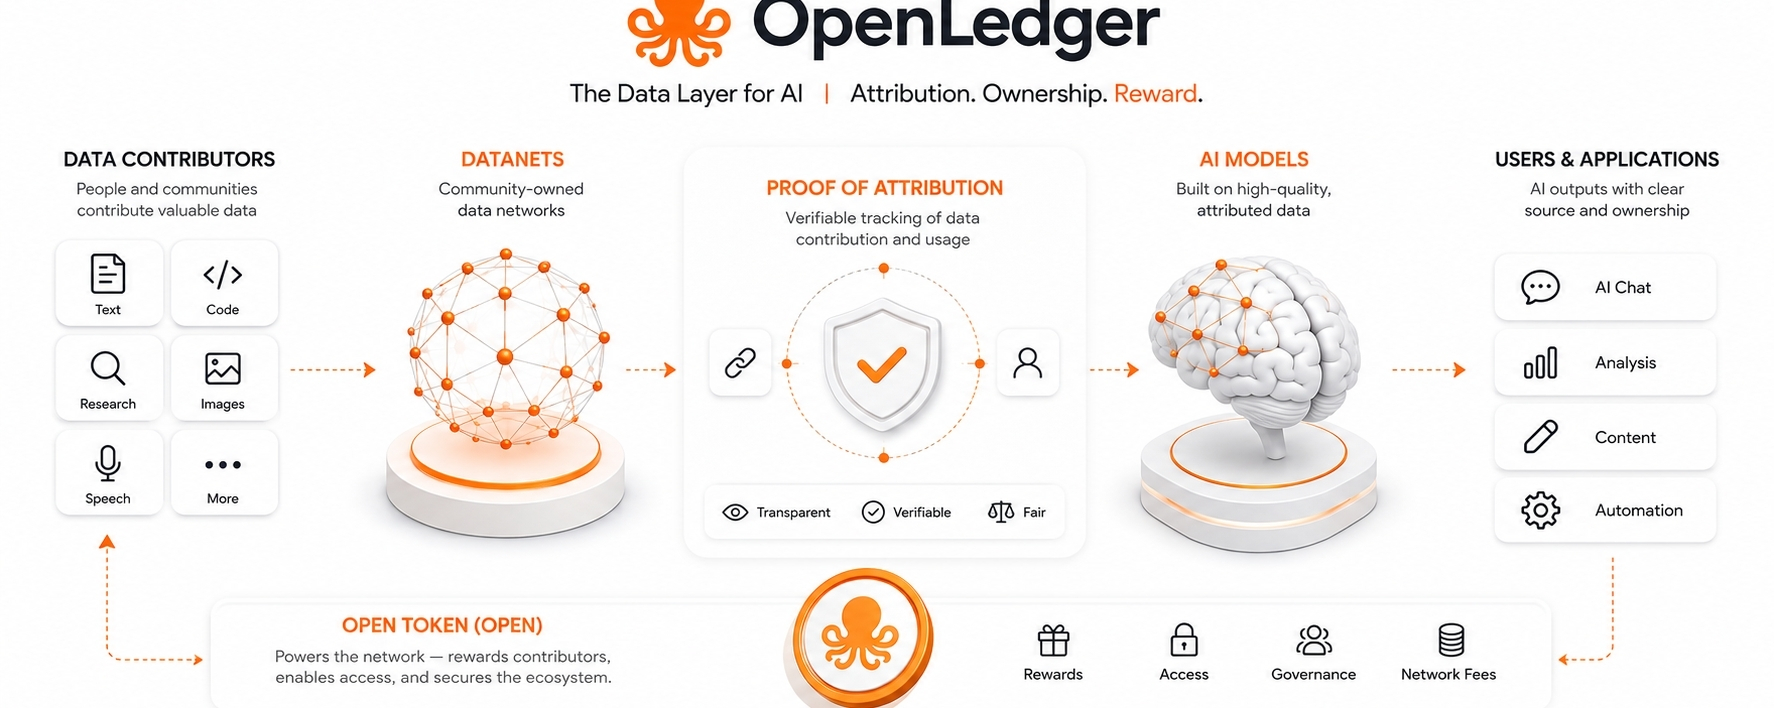
OpenLedger versucht, sich mit dieser Schicht auseinanderzusetzen. Nicht mit der glänzenden Ausgabeschicht, in der alle einen Prompt eintippen und so tun, als sei die Maschine von allein schlau. Ich meine den Teil unter der Haube. Die langweilige Infrastruktur. Der Teil, woher die Daten kommen, jemand sie beigesteuert hat und diese Einbringung vielleicht nicht für immer verschwinden sollte.
Es ist nicht flashy.
Es ist einfach notwendig.
Ehrlich gesagt finde ich es genau deshalb spannender als die meisten KI-Coins. Nicht, weil es sich perfekt anhört. Das tut es nicht. Nicht, weil ich glaube, dass Krypto KI magisch repariert. Das tut es nicht. Aber weil OpenLedger auf einen echten Schmerzpunkt fokussiert: Attribution.
Wer hat die Daten gegeben?
Wer hat geholfen, das Modell zu trainieren?
Wer verdient Anerkennung?
Wer wird bezahlt?
Wer wird ausgelöscht?
Diese Fragen sind nicht sauber. Sie sind unangenehm. Und wahrscheinlich deshalb umgehen die meisten Projekte sie.
Das Ding ist: Krypto-Leute haben die hässliche Seite von Anreizsystemen schon hinter sich. Wir wissen, was passiert, wenn Belohnungen im Spiel sind. Wir haben gesehen, wie Airdrops in den Boden gefarmt wurden. Wir haben gesehen, wie Fake-User Testnets mit Fluten. Wir haben gesehen, wie Communities loyal wirkten, bis die Claim-Seite aufging. Wir haben gesehen, wie „organisches Wachstum“ sich als Wallets herausstellt, die nur Points hinterherjagen.
Wenn OpenLedger also davon spricht, Datenbeitragsleistende zu belohnen, ist meine erste Reaktion nicht blindes Lob.
Meine erste Reaktion ist: Okay, aber wie verhindert man den Müll?
Weil Leute versuchen werden, es auszutricksen.
Die machen das immer.
Wenn es eine Belohnung für das Beitragen von Daten gibt, werden manche Nutzer nützliche Daten beitragen. Andere werden Junk abladen. Duplizierten Content. Material mit wenig Aufwand. Sybil-Accounts. Wiederverwertetes Rauschen. Alles, was von außen wie Aktivität aussieht.
Das ist das Chaos, das OpenLedger überleben muss.
Und es ist ein ernstes Durcheinander.
Hier wird das Projekt interessant, aber auch schwer. Proof of Attribution klingt nach der richtigen Richtung, aber Attribution bei KI ist nicht einfach. Ein Modell lernt nicht wie ein Mensch, der einen Absatz liest und sagt: „Danke, diese ganz konkrete Idee kam von hier.“ Es nimmt Muster auf. Es mischt Quellen. Es komprimiert Informationen. Es wird extrem schwer zu sagen, wer was beigesteuert hat – auf eine Art, die sich fair anfühlt.
Also löst OpenLedger nicht irgendein simples kleines Tracking-Problem.
Es läuft auf einen der nervigsten Teile von KI hinaus.
Vielleicht respektiere ich genau deshalb diesen Versuch.
Nicht der Hype darum. Der Versuch.
Die Idee von Datanets macht für mich auch Sinn, weil spezialisierte Daten wahrscheinlich der Ort sind, an dem das eine bessere Chance hat. Ich glaube nicht wirklich, dass jedes Krypto-KI-Projekt direkt gegen OpenAI oder Google oder die riesigen Labs antreten muss. Das klingt meistens nach Fantasy. Diese Firmen haben Geld, Talent, Rechenleistung, Distribution und Anwälte. Krypto hat Telegram-Gruppen, die über Unlocks streiten.
Aber fokussierte Datennetzwerke?
Das wirkt eher realistischer.
Eine Nischen-Community, die um eine bestimmte Art von Daten herum baut. Ein Modell, das für einen bestimmten Use Case trainiert wurde. Beitragsleistende, die nachverfolgt werden. Wert, der nicht einfach in irgendeiner geschlossenen Maschine verschwindet. Das ist keine besonders glamouröse Geschichte, aber es ist näher an echter Infrastruktur.
Und Krypto braucht mehr davon.
Weniger Theater.
Mehr Infrastruktur-Kram.
Trotzdem hat OpenLedger einen harten Weg. Es muss beweisen, dass Menschen qualitativ hochwertige Daten beisteuern – nicht nur Belohnungen farmen. Es muss beweisen, dass Builder genug Interesse haben, das System wirklich zu nutzen. Es muss beweisen, dass Attribution vertrauenswürdig sein kann, selbst wenn sie nicht perfekt ist. Es muss beweisen, dass das Token mit echter Nutzung verbunden ist – nicht nur ein weiterer Grund, warum Leute in einem KI-Zyklus spekulieren.
Dieser letzte Teil ist entscheidend.
Weil es ein Token gibt, und sobald es ein Token gibt, ändert sich alles.
Die Leute hören auf zu fragen, was das System macht, und fangen an zu fragen, wann es auflistet, wann es pumpt, wann die nächste Kampagne startet, wann die nächste Belohnung fällt. Das Projekt wird zu einem Marktobjekt, bevor es nützliche Infrastruktur wird. Das ist die normale Krypto-Krankheit.
OpenLedger ist nicht immun dagegen.
Kein Projekt.
OPEN hat eine Rolle bei Gebühren, Belohnungen und Netzwerkaktivität, und das gibt ihm eine gewisse Logik. In Ordnung. Das ist besser als ein Token, der nur für Governance-Theater existiert. Aber Nutzen auf dem Papier reicht nicht. Wenn das Netzwerk keine echte Nachfrage erzeugt, wird der Token zu einer weiteren zirkulären Maschine.
Belohnungen bringen Nutzer.
Nutzer schaffen Aktivität.
Aktivität erzeugt Hype.
Hype stützt das Token.
Dann verlangsamen sich die Belohnungen.
Und plötzlich erfährt jeder, was wirklich daran war.
Wir haben diesen Film schon zu oft gesehen.
Deshalb will ich OpenLedger nicht überverkaufen. Die Idee ist stark genug, ohne so zu tun, als sei sie garantiert. Vielleicht dauert es. Vielleicht wird es chaotisch. Vielleicht funktioniert es zuerst nur in bestimmten Nischen. Vielleicht kämpft es mit Qualitätskontrolle. Vielleicht zieht es am Anfang mehr Landwirte als Builder an.
Das würde mich nicht überraschen.
Eigentlich erwarte ich etwas davon.
Aber das Projekt berührt immer noch etwas Wichtiges. KI hat ein Problem der Wertabschöpfung. Viele Menschen tragen zur Wissensschicht bei, aber nur wenige Plattformen erfassen den Großteil des Upsides. OpenLedger versucht, diese Beitragsschicht sichtbar und nutzbar zu machen.
Das ist es wert, sich das anzuschauen.
Nicht anbeten.
Zuschauen.
Schau, ich muss nicht, dass OpenLedger zu irgendeinem riesigen, die Welt verändernden Ding wird, damit es wichtig ist. Krypto-Leute lieben es, alles dramatisch zu machen. Manchmal muss ein Projekt einfach nur ein einzelnes hässliches Stück Infrastruktur reparieren, das alle anderen ständig ignorieren.
Daten-Attribution ist eines dieser hässlichen Teile.
Niemand will darüber nachdenken, wenn die Ausgabe des Modells sauber aussieht. Niemand will fragen, wo der Wert herkam, wenn die Demo funktioniert. Niemand will sich mit der langweiligen Buchhaltung von Beitrag, Eigentum und Belohnung befassen.
Aber irgendwann zählt genau dieser ganze Kram.
Vor allem, wenn KI weiter mehr vom Internet verschlingt.
Der harte Teil für OpenLedger ist Vertrauen. Nicht nur Vertrauen in die Kette. Vertrauen in den Prozess. Vertrauen, dass Beiträge fair gemessen werden. Vertrauen, dass das Belohnungssystem kein Farming-Spiel wird. Vertrauen, dass die Datensätze tatsächlich nützlich sind. Vertrauen, dass Builder nicht nur wegen Anreizen da sind. Vertrauen, dass das Ganze nicht einfach eine weitere KI-Erzählung ist, die Infrastruktur-Kleidung trägt.
Das ist eine Menge Vertrauen, die man sich erarbeiten muss.
Und das wird nicht durch Slogans verdient.
Man wird es sich durch langweilige Nutzung verdienen.
Menschen, die echte Daten beitragen. Builder, die Modelle entwickeln, die wirklich funktionieren. Nutzer zahlen, weil die Ausgabe nützlich ist. Communities bleiben, nachdem der Hype abkühlt. Weniger Rauschen. Mehr Belege.
Das ist die einzige Version von OpenLedger, die für mich zählt.
Vielleicht kommt es dahin.
Vielleicht auch nicht.
Das Entscheidende ist: Ich würde lieber dabei zusehen, wie ein Projekt versucht, ein langweiliges, echtes Problem zu lösen, als wieder einen glänzenden KI-Token, der so tut, als brauche ein Chatbot einen Coin. OpenLedger lebt zumindest näher an dem tatsächlichen Chaos: Daten, Attribution, Anreize, Beitragsleistende und der Wert des Modells.
Das ist nicht sauber.
Das ist nicht einfach.
Aber es fühlt sich näher an der Realität an.
Und nach genug Krypto-Zyklen fängt die Realität an, mehr zu zählen als das Pitch.